Archivo de la etiqueta: Inteligencia artificial

La IA ya sabe lo que hiciste en Internet

Borchers, Callum. AI Knows What You Did Online. Now Your Employer Does, Too. The Wall Street Journal, 16 de julio de 2026. https://www.wsj.com/lifestyle/careers/ai-knows-what-you-did-online-now-your-employer-does-too-49796adc?st=xRecFU&mod=flipboard

La inteligencia artificial está transformando los procesos de selección de personal al permitir que las empresas examinen con mucha más profundidad la huella digital de candidatos y empleados. Lo que antes consistía en una búsqueda superficial en Google se ha convertido en análisis automatizados capaces de rastrear publicaciones, imágenes, comentarios y perfiles dispersos por decenas de plataformas, incluso cuando los usuarios creen haber permanecido en el anonimato. Herramientas especializadas combinan reconocimiento facial, análisis de redes sociales y correlación de datos públicos para reconstruir la actividad digital de una persona con gran precisión.

El artículo explica que esta práctica ya no se limita a altos directivos o cargos especialmente sensibles. Gracias a la reducción de costes y al aumento de la capacidad de la IA, las verificaciones digitales se están extendiendo a puestos de atención al público y a muchos procesos ordinarios de contratación. Las empresas buscan detectar comportamientos que puedan afectar a su reputación, identificar posibles conflictos con sus valores corporativos o evaluar el encaje cultural de los candidatos. En algunos casos, el seguimiento continúa incluso después de la contratación mediante sistemas de monitorización permanente de la actividad pública en Internet.

Uno de los aspectos más llamativos es que la IA puede recuperar información que parecía olvidada. Publicaciones antiguas en redes sociales, fotografías comprometedoras, comentarios realizados hace muchos años o participaciones en plataformas de contenido para adultos, apuestas o mercados de predicción pueden reaparecer durante un proceso de selección. El artículo cita ejemplos recientes de figuras públicas cuyas antiguas publicaciones o contenidos digitales dañaron gravemente sus carreras, ilustrando cómo la permanencia de la información en Internet se convierte en un factor de riesgo profesional.

Sin embargo, eliminar por completo la presencia digital tampoco constituye una solución. Los expertos consultados advierten de que una huella digital excesivamente limpia o recientemente borrada puede despertar sospechas entre los responsables de contratación. Algunas empresas incluso desarrollan herramientas para detectar perfiles con una presencia en línea anormalmente escasa, ya que esto puede interpretarse como un intento deliberado de ocultar información o incluso como un posible fraude de identidad.

El artículo concluye que la mejor estrategia no consiste en desaparecer de Internet, sino en gestionar activamente la reputación digital. Se recomienda revisar periódicamente qué información aparece al buscar el propio nombre, eliminar contenidos claramente perjudiciales cuando sea posible, reforzar la privacidad de las cuentas y generar una presencia profesional positiva mediante páginas personales, perfiles actualizados o publicaciones relacionadas con la actividad laboral. En la era de la inteligencia artificial, la reputación digital deja de ser un aspecto secundario para convertirse en un elemento cada vez más determinante en el acceso y la permanencia en el mercado laboral.

La IA está cambiando la forma en que los usuarios buscan y descubren recursos en las bibliotecas.

Tay, Aaron. AI Search Is Rebundling Everything Libraries Know About Discovery: Ten established traditions, an emerging eleventh, and why libraries need to have a more holistic view of discovery. Aaron Tay’s Musings about Librarianship (Substack), 18 de julio de 2026. https://aarontay.substack.com/p/eleven-ways-of-looking-at-academic

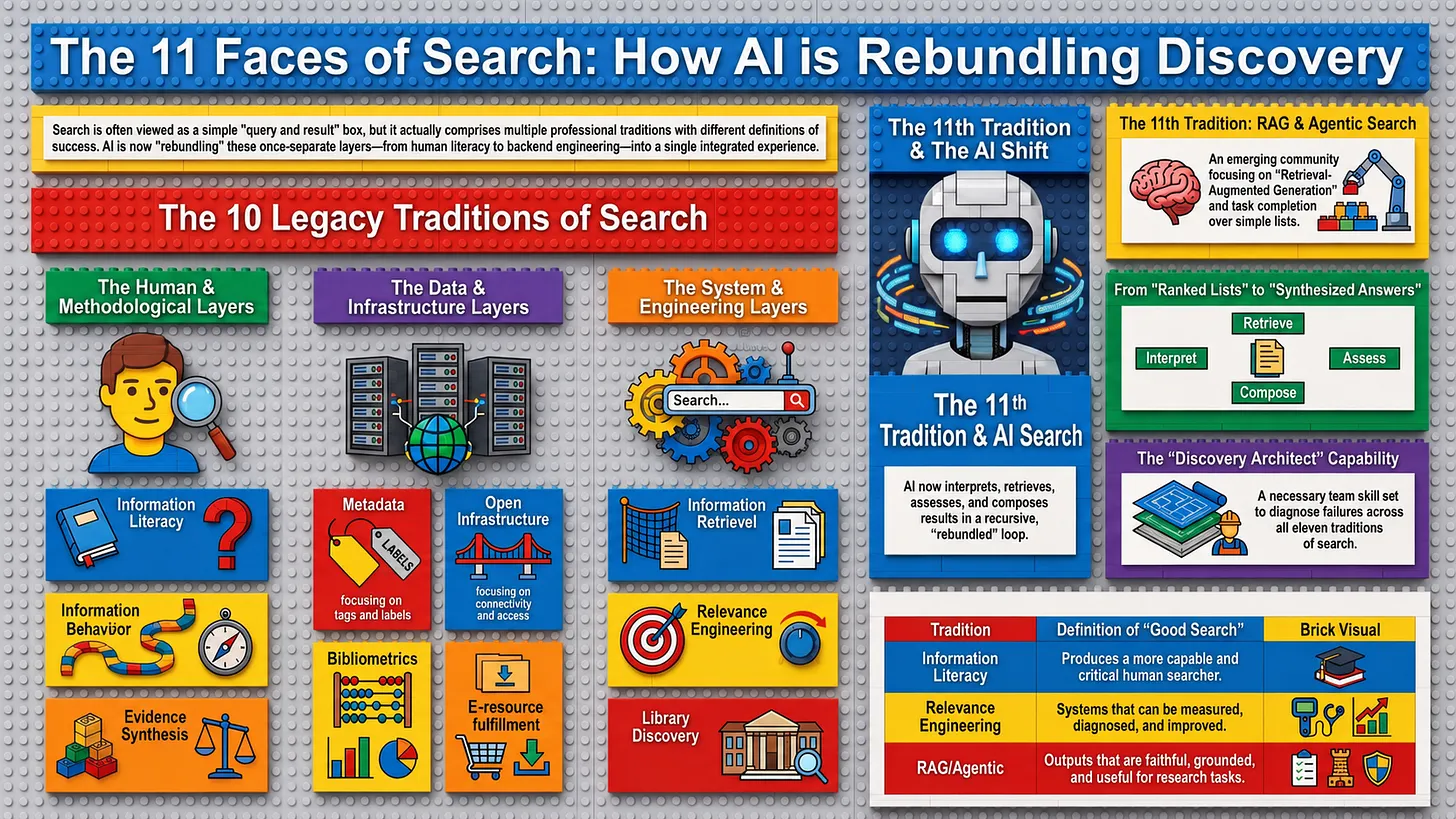
Aaron Tay plantea que la búsqueda académica nunca ha sido una actividad única y homogénea, sino un conjunto de perspectivas desarrolladas por comunidades profesionales y de investigación diferentes. Inspirándose en el conocido ensayo de Lorcan Dempsey Thirteen Ways of Looking at Libraries, Discovery, and the Catalog, el autor propone que la búsqueda científica puede entenderse desde diez tradiciones consolidadas y una undécima emergente.

Cada una de ellas interpreta el mismo proceso de búsqueda desde objetivos distintos: unas priorizan la alfabetización informacional, otras el comportamiento de los usuarios, la recuperación de información, la bibliometría, la infraestructura científica, la organización del conocimiento o la ingeniería de relevancia. El problema, sostiene Tay, no es la ausencia de conocimiento sobre la búsqueda académica, sino la fragmentación de ese conocimiento entre comunidades que apenas comparten lenguaje, métodos de evaluación o marcos conceptuales.

El autor describe cómo cada tradición aporta una pieza esencial del ecosistema de descubrimiento. Los especialistas en alfabetización informacional consideran que una buena búsqueda es aquella que forma usuarios críticos capaces de evaluar fuentes y detectar sesgos, especialmente en un contexto donde las respuestas generadas por IA pueden parecer convincentes sin ser necesariamente fiables. Los investigadores del comportamiento informacional, por su parte, entienden la búsqueda como un proceso dinámico en el que las necesidades del usuario evolucionan mientras explora información, reformula consultas y redefine sus objetivos. Los expertos en revisiones sistemáticas y síntesis de evidencia ponen el énfasis en la exhaustividad, la transparencia y la reproducibilidad de las estrategias de búsqueda, considerando que estas forman parte del propio método científico y deben ser documentadas y auditadas rigurosamente.

Uno de los argumentos centrales del artículo es que la irrupción de la inteligencia artificial está desdibujando las fronteras tradicionales entre estas disciplinas. En los sistemas clásicos existían capas relativamente independientes: los metadatos, la recuperación de documentos, el ordenamiento de resultados, el acceso al texto completo o la evaluación crítica podían estudiarse por separado. Los sistemas de búsqueda basados en IA, en cambio, integran continuamente interpretación de preguntas, recuperación de información, selección de evidencias, generación de respuestas y razonamiento automatizado. La IA no elimina estas capas, sino que las reorganiza en arquitecturas mucho más complejas donde interactúan de forma constante. Como consecuencia, comprender cómo funciona realmente un sistema de búsqueda requiere conocimientos que hasta ahora estaban distribuidos entre comunidades muy distintas.

Ante esta nueva realidad, Tay propone el surgimiento de una nueva capacidad organizativa que denomina «discovery architect» o arquitecto del descubrimiento, aunque insiste en que no debe entenderse necesariamente como un nuevo puesto de trabajo, sino como una competencia colectiva que deberían desarrollar las bibliotecas académicas. Este equipo tendría una visión transversal del ecosistema completo de búsqueda científica, capaz de comprender metadatos, infraestructuras abiertas, algoritmos de recuperación, modelos de IA, sistemas de acceso, grafos de conocimiento y herramientas de descubrimiento. Su función consistiría en diagnosticar correctamente por qué un sistema de búsqueda falla: si el problema reside en la cobertura documental, en los metadatos, en la desambiguación de entidades, en el algoritmo de recuperación, en el ranking, en la selección de evidencias o en la generación de respuestas por parte del modelo. Más que resolver directamente todos esos problemas, debería ser capaz de identificar qué tipo de conocimiento especializado resulta necesario en cada caso.

Según Aaron Tay, las once maneras de entender la búsqueda académica representan diferentes disciplinas y comunidades profesionales que analizan el descubrimiento de información desde perspectivas complementarias. Son las siguientes:

  1. Alfabetización informacional (Information Literacy)
    Considera la búsqueda como una competencia que debe aprenderse y desarrollarse. El objetivo es que los usuarios sepan formular preguntas, elegir fuentes adecuadas, evaluar críticamente la información y utilizarla de forma ética.
  2. Comportamiento informacional (Information Behaviour)
    Estudia cómo las personas buscan información en situaciones reales. Analiza las necesidades de información, las estrategias de búsqueda, la incertidumbre, la exploración y cómo evolucionan las consultas durante el proceso.
  3. Recuperación de información (Information Retrieval – IR)
    Se centra en los algoritmos y modelos que permiten localizar los documentos más relevantes para una consulta. Incluye aspectos como la indexación, el ranking, la relevancia, la recuperación semántica y la evaluación de los sistemas de búsqueda.
  4. Recuperación interactiva de información (Interactive Information Retrieval – IIR)
    Examina la interacción entre el usuario y el sistema de búsqueda. Estudia cómo las interfaces, la reformulación de consultas y la retroalimentación mejoran los resultados obtenidos.
  5. Revisiones sistemáticas y síntesis de evidencia (Systematic Searching / Evidence Synthesis)
    Concibe la búsqueda como un componente esencial del método científico. Da prioridad a la exhaustividad, la reproducibilidad, la transparencia y la documentación detallada de las estrategias de búsqueda.
  6. Bibliometría y cienciometría (Bibliometrics / Scientometrics)
    Utiliza la búsqueda para analizar la producción científica, las citas, las redes de colaboración, el impacto de las publicaciones y la evolución de las disciplinas.
  7. Organización del conocimiento (Knowledge Organization)
    Se ocupa de cómo se describen y estructuran los recursos mediante metadatos, vocabularios controlados, tesauros, clasificaciones, ontologías y grafos de conocimiento para facilitar su descubrimiento.
  8. Bibliotecas y sistemas de descubrimiento (Library Discovery Systems)
    Analiza las plataformas que integran catálogos, bases de datos, repositorios y recursos electrónicos, así como las decisiones sobre cobertura, relevancia y experiencia de usuario en los servicios bibliotecarios.
  9. Infraestructura de comunicación científica (Scholarly Communication Infrastructure)
    Observa la búsqueda desde el punto de vista de las infraestructuras que hacen posible el descubrimiento: identificadores persistentes (DOI, ORCID), índices, repositorios, bases de datos, acceso abierto y metadatos interoperables.
  10. Motores de búsqueda académicos y plataformas comerciales (Academic Search Engines and Discovery Platforms)
    Estudia cómo servicios como Google Scholar, Scopus, Web of Science, Semantic Scholar o Dimensions construyen sus índices, seleccionan contenidos y ordenan los resultados mediante algoritmos propios.
  11. Arquitectura del descubrimiento impulsada por IA (Discovery Architecture / AI Discovery) (la perspectiva emergente propuesta por Tay)

El autor advierte que esta capacidad de diagnóstico será insuficiente si las bibliotecas no exigen mayor transparencia a los proveedores de plataformas de búsqueda basadas en IA. Reclama acceso a registros de consultas, información sobre la cobertura de los índices, documentación de los criterios de clasificación, mecanismos para evaluar la relevancia de los resultados y posibilidades de auditar las distintas fases del proceso de recuperación y generación de respuestas. Sin esa apertura, afirma Tay, incluso reuniendo a especialistas de todas las disciplinas implicadas, cualquier análisis sobre el funcionamiento de estos sistemas seguirá siendo en gran medida especulativo. El artículo concluye anunciando una segunda parte dedicada a analizar dónde reside realmente la inteligencia de los nuevos sistemas de búsqueda: en los grandes modelos de lenguaje, en los mecanismos de recuperación documental o en la combinación de ambos mediante arquitecturas híbridas.

Un distrito escolar de Nueva York prueba un profesor robot con IA para apoyar la enseñanza

DiBenedetto, Chase. A New York School District Is Testing Robot Teachers. Mashable, 15 de julio de 2026. https://mashable.com/tech/new-york-school-testing-robot-teacher?utm_source=flipboard&utm_content=user/Mashable

El distrito escolar Salamanca City Central School District, situado en el estado de Nueva York, ha puesto en marcha un proyecto piloto para incorporar un profesor robot humanoide impulsado por inteligencia artificial en sus aulas de secundaria. La iniciativa, desarrollada en colaboración con la empresa canadiense Realbotix, introduce un asistente educativo denominado Sally, diseñado para complementar el trabajo de los docentes y ofrecer apoyo personalizado a los estudiantes tanto durante las clases como fuera del horario escolar. Según sus responsables, el sistema representa uno de los primeros despliegues reales de robots humanoides con IA en un entorno educativo estadounidense.

El robot forma parte de la serie M-Series de Realbotix y utiliza procesamiento del lenguaje natural, reconocimiento de expresiones faciales y capacidades conversacionales para interactuar con alumnos y profesores. Permanecerá sentado en el aula y podrá realizar movimientos del torso, la cabeza y el rostro para ofrecer una comunicación más natural. Además, los estudiantes podrán identificarse mediante un código personal para que el sistema acceda a su historial de aprendizaje y adapte las explicaciones, ejercicios y recomendaciones a las necesidades de cada uno. También estará disponible como asistente virtual las 24 horas para resolver dudas y ayudar con los deberes.

El proyecto comenzará en las asignaturas de Inteligencia Artificial y Robótica del instituto, integradas en el programa educativo Woz ED STEM Pathway, impulsado por Steve Wozniak para fomentar las competencias en ciencia, tecnología, ingeniería y matemáticas. Si la experiencia resulta satisfactoria, el distrito contempla ampliar el uso del robot a otras materias y cursos. El superintendente del distrito, Mark Beehler, defiende que la escuela debe enseñar a utilizar la inteligencia artificial de forma responsable en lugar de intentar prohibirla, ya que considera que estas herramientas formarán parte del futuro profesional de los estudiantes.

Los desarrolladores insisten en que Sally no sustituirá al profesorado, sino que actuará como un asistente pedagógico capaz de responder preguntas, ofrecer explicaciones adicionales, traducir contenidos, reforzar conceptos y proporcionar apoyo individualizado. Para minimizar riesgos, el sistema incorpora salvaguardas específicas para el ámbito educativo: está entrenado con el currículo del distrito y dispone de mecanismos para detectar conversaciones relacionadas con autolesiones, suicidio u otras situaciones de riesgo, notificándolas automáticamente a los responsables del centro.

No obstante, la iniciativa también ha generado interrogantes. Expertos y organizaciones educativas advierten de que la creciente presencia de la IA en las aulas puede incrementar la dependencia tecnológica, reducir el pensamiento crítico y acentuar desigualdades si se utiliza como sustituto del profesorado o como solución a la falta de recursos humanos. Estas preocupaciones se suman al debate nacional sobre el papel de la inteligencia artificial en la educación, en un momento en que diversos distritos escolares estadounidenses experimentan con asistentes inteligentes mientras padres, investigadore

Las habilidades cognitivas que podríamos estar perdiendo silenciosamente por culpa de la inteligencia artificial

Essel, Rocky. The Cognitive Skills We May Be Quietly Losing to AI. HackerNoon, 16 de julio de 2026. https://hackernoon.com/the-cognitive-skills-we-may-be-quietly-losing-to-ai?utm_source=flipboard&utm_content=other

Se plantea una reflexión sobre un efecto menos visible de la inteligencia artificial: su posible impacto en las capacidades cognitivas humanas. El autor sostiene que el verdadero desafío de la IA no reside únicamente en la automatización del trabajo o en la transformación de las profesiones, sino en el riesgo de que las personas dejen de ejercitar habilidades fundamentales como el razonamiento, la escritura, la memoria, la resolución de problemas o la creatividad. A medida que los asistentes inteligentes se convierten en herramientas habituales para estudiar, trabajar o tomar decisiones, existe el peligro de delegar progresivamente procesos mentales que hasta ahora contribuían al desarrollo de nuestras capacidades intelectuales.

Uno de los argumentos centrales es que la IA ofrece beneficios indiscutibles. Facilita la comunicación, democratiza el acceso al conocimiento, acelera el desarrollo de software, mejora la productividad profesional y permite que una sola persona pueda realizar tareas que antes requerían equipos completos. Además, ayuda a comprender documentos complejos, ofrece apoyo en ámbitos como la salud o el derecho y amplía las oportunidades de innovación y emprendimiento. Sin embargo, el autor advierte de que esta enorme utilidad puede ocultar un coste cognitivo: cuanto más dependemos de la IA para pensar, menor es el esfuerzo intelectual que realizamos por nosotros mismos.

El artículo establece una comparación entre la inteligencia artificial y las redes sociales. Mientras que los efectos psicológicos de estas últimas pudieron estudiarse porque millones de personas consumían contenidos similares, la IA genera conversaciones completamente personalizadas para cada usuario. Esa personalización convierte cada interacción en una experiencia única, lo que dificulta enormemente medir sus consecuencias cognitivas y emocionales. Según el autor, este carácter individualizado hace más complicado detectar patrones de dependencia o deterioro intelectual antes de que se conviertan en un problema generalizado.

Para ilustrar este fenómeno, el autor recurre a una experiencia personal relacionada con el uso constante de calculadoras. Explica cómo, tras años delegando operaciones sencillas en dispositivos electrónicos, descubrió que había perdido la agilidad para realizar cálculos mentales básicos. Utiliza este ejemplo como metáfora de lo que podría suceder con otras habilidades intelectuales si la inteligencia artificial comienza a asumir tareas de razonamiento, redacción, análisis o resolución de problemas. La preocupación no es que la tecnología realice esas funciones mejor que los humanos, sino que las personas dejen de practicarlas y, con ello, pierdan la destreza necesaria para ejecutarlas de forma autónoma.

Otro aspecto relevante es la preocupación por las nuevas generaciones. Los niños que crezcan rodeados de asistentes inteligentes podrían desarrollar formas de aprendizaje muy diferentes a las de generaciones anteriores. El autor se pregunta si seguirán experimentando el esfuerzo, el ensayo y error y la práctica continuada que tradicionalmente han permitido construir capacidades cognitivas sólidas. Aunque reconoce que es imposible predecir con exactitud qué competencias serán esenciales en el futuro, considera imprescindible reflexionar sobre cuáles no deberían dejarse completamente en manos de la inteligencia artificial.

Finalmente, el artículo evita ofrecer respuestas categóricas y concluye que la sociedad se encuentra ante una transformación de enorme magnitud cuyos efectos todavía desconocemos. Más que rechazar la inteligencia artificial, propone utilizarla con conciencia crítica, evitando que la búsqueda de eficiencia conduzca a una progresiva pérdida de autonomía intelectual. Diversos investigadores y expertos comparten preocupaciones similares, señalando que un uso excesivamente pasivo de la IA puede favorecer el denominado cognitive offloading (delegación cognitiva), reduciendo el pensamiento crítico y la capacidad de aprendizaje independiente si no se mantiene una participación activa del usuario.

La sustitución de enfermeras por inteligencia artificial en Nueva York reabre el debate sobre el futuro del trabajo sanitario

Landymore, Frank. Health Care Workers Furious as NYC Replaces Nurses With AI. Futurism, 15 de julio de 2026. Futurism

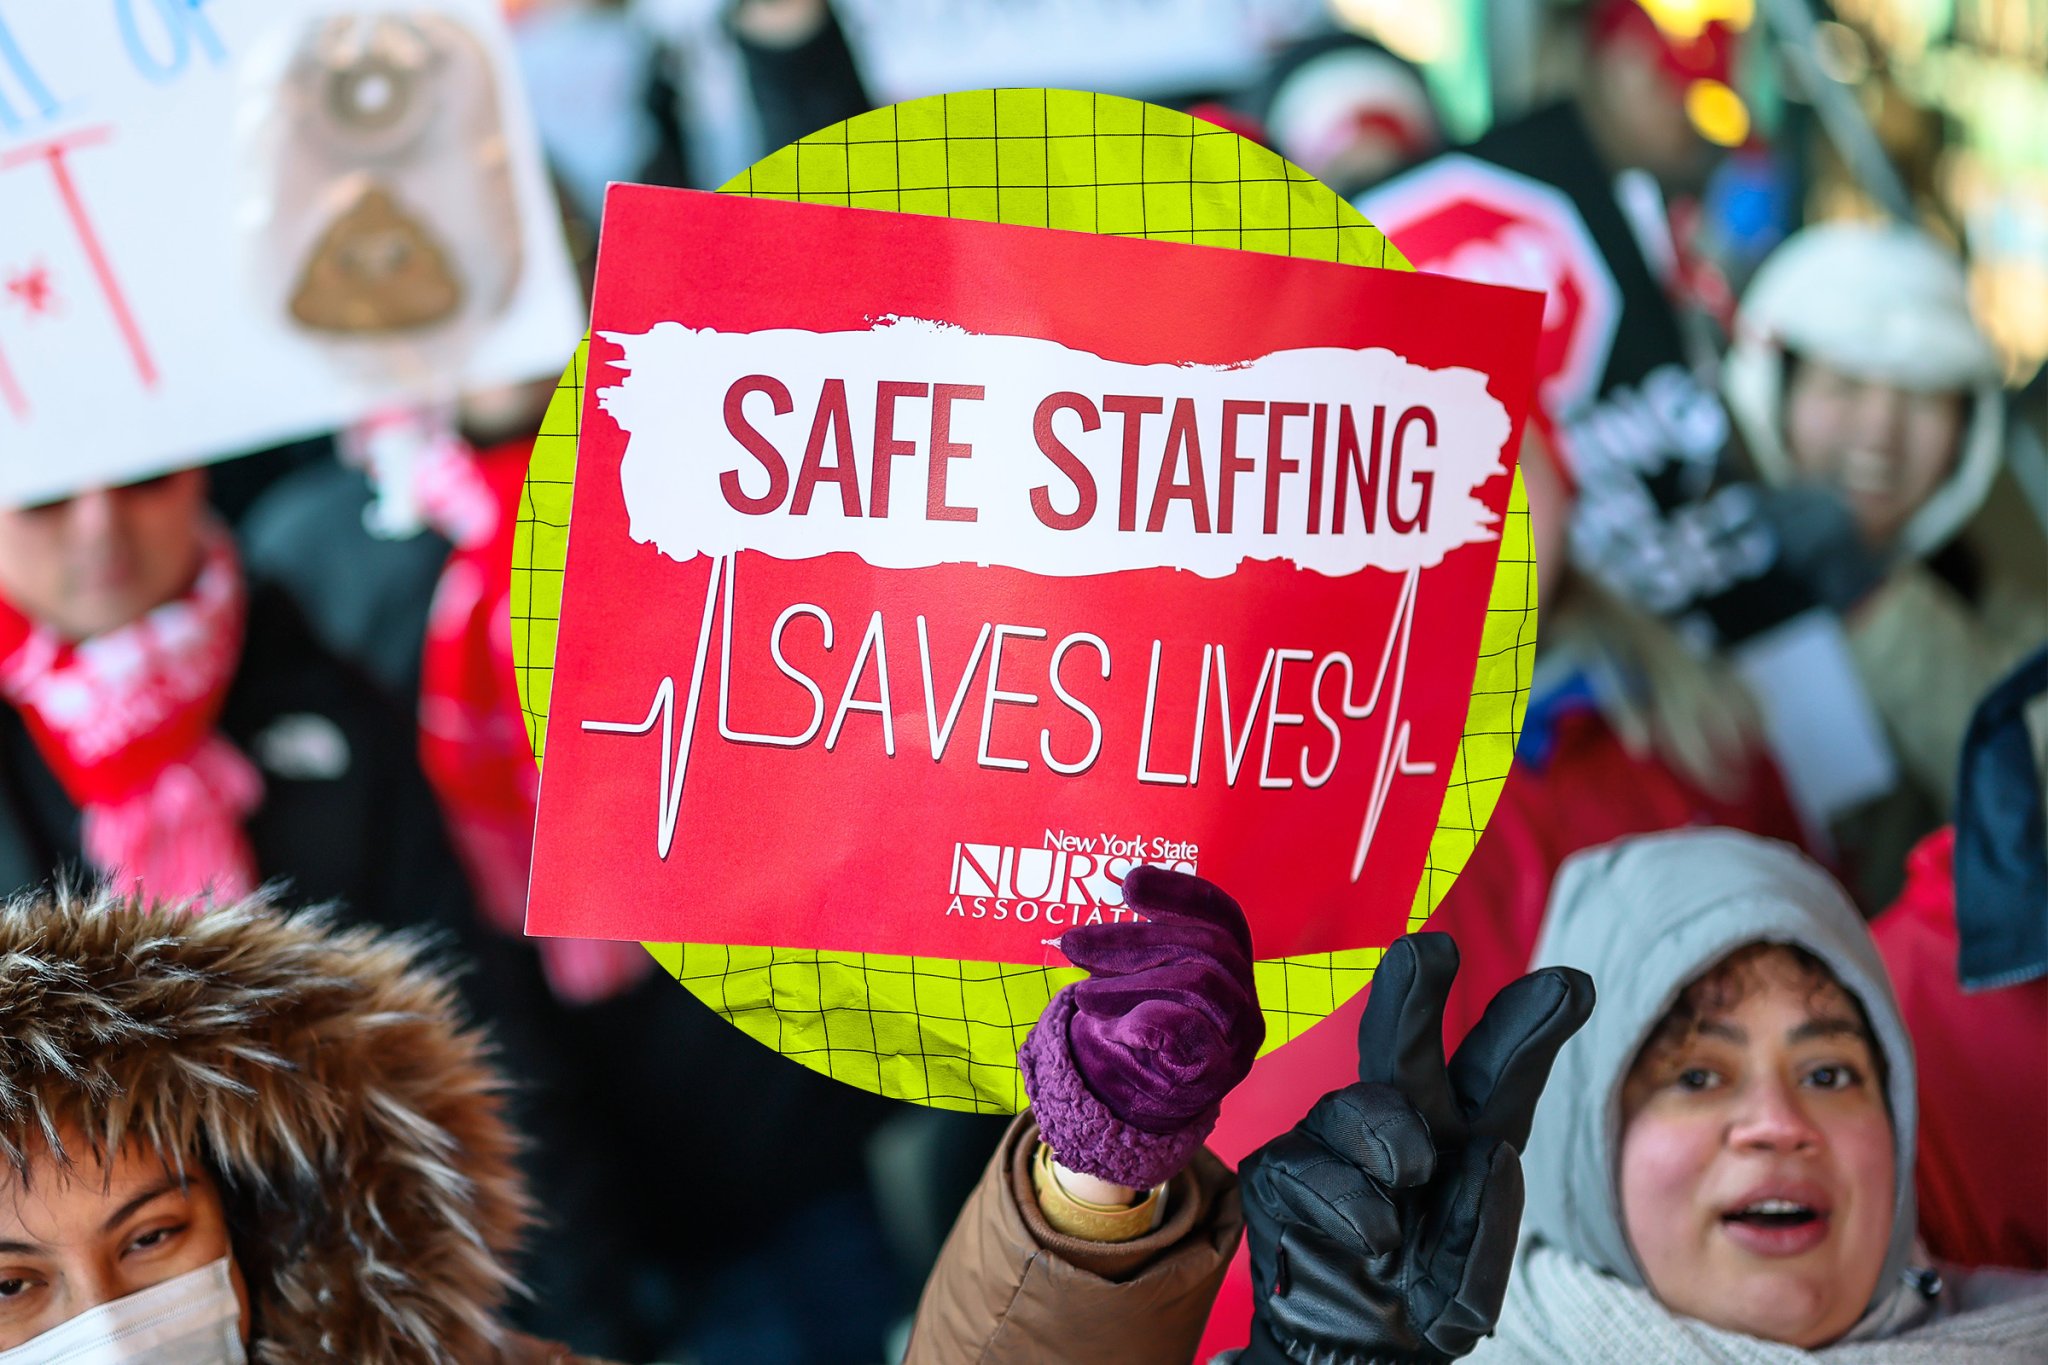
El artículo analiza la creciente controversia generada tras el despido de doce enfermeras del hospital Montefiore, en el Bronx (Nueva York), cuyos puestos han sido sustituidos por un sistema de inteligencia artificial destinado a automatizar tareas de revisión clínica y gestión administrativa relacionadas con la autorización de tratamientos por parte de las aseguradoras.

La decisión ha provocado una fuerte reacción del sindicato New York State Nurses Association (NYSNA), que denuncia que el hospital está reemplazando décadas de experiencia clínica por un software cuya eficacia y seguridad no han sido suficientemente demostradas.

Las enfermeras afectadas desempeñaban funciones de utilization review, un proceso esencial para revisar historiales médicos, justificar la necesidad clínica de determinados tratamientos y negociar con las compañías aseguradoras la cobertura de la atención sanitaria. Aunque estas tareas no implican atención directa al paciente, requieren conocimientos clínicos, capacidad de interpretación y comunicación con médicos y aseguradoras. Según las profesionales despedidas, la inteligencia artificial difícilmente puede sustituir el juicio profesional necesario para resolver casos complejos o situaciones que exigen contextualización y experiencia acumulada durante años de práctica.

La polémica adquiere una dimensión mayor porque los despidos se producen pocos meses después de una de las mayores huelgas de enfermería de la historia de Nueva York. Tras semanas de movilizaciones, los sindicatos habían conseguido incluir en el nuevo convenio laboral cláusulas específicas destinadas a limitar el uso de la inteligencia artificial como herramienta de sustitución de profesionales. Los representantes sindicales sostienen que la actuación del hospital vulnera el espíritu de esos acuerdos y constituye un precedente preocupante para el conjunto del sistema sanitario estadounidense.

Otro aspecto destacado es la preocupación por la empresa tecnológica encargada del sistema de IA, Datavant, debido a sus colaboraciones con Palantir, compañía conocida por sus proyectos de análisis masivo de datos y contratos con organismos gubernamentales. El sindicato advierte de los posibles riesgos para la privacidad de los historiales clínicos y cuestiona la conveniencia de que información médica extremadamente sensible pueda ser procesada mediante plataformas automatizadas vinculadas a grandes empresas tecnológicas.

Por su parte, Montefiore rechaza las acusaciones y afirma que la implantación de estas herramientas afecta únicamente a procesos administrativos, no a la atención clínica directa. El hospital sostiene que la incorporación de nuevas tecnologías busca mejorar la eficiencia operativa y optimizar la gestión documental, negando que se esté comprometiendo la calidad asistencial. Sin embargo, para los sindicatos y numerosos expertos, la cuestión trasciende este caso concreto y plantea un debate mucho más amplio sobre el papel que debe desempeñar la inteligencia artificial en la sanidad: si debe actuar como apoyo a los profesionales o convertirse en un sustituto de determinadas funciones especializadas.

El caso se ha convertido así en uno de los primeros ejemplos ampliamente documentados de sustitución de personal sanitario por sistemas de inteligencia artificial en Estados Unidos. Más allá de su impacto laboral inmediato, pone de relieve los desafíos éticos, legales y organizativos que acompañan a la incorporación de la IA en los servicios de salud, especialmente en ámbitos donde la experiencia clínica, el razonamiento profesional y la responsabilidad sobre las decisiones siguen siendo elementos difíciles de automatizar.

Cómo cambian los comportamientos y valores de sus modelos de IA según el idioma y la versión utilizada.

Anthropic. (2026). Claude’s values across models and languages. Anthropic Research. https://www.anthropic.com/research/claude-values-models-languages

Anthropic presenta una investigación destinada a comprender cómo los modelos de la familia Claude expresan valores en sus respuestas y cómo estos varían tanto entre diferentes versiones del modelo como entre distintos idiomas.

El estudio se basa en el análisis de 309.815 conversaciones reales y anonimizadas mantenidas con Claude.ai, centradas exclusivamente en consultas subjetivas, es decir, aquellas en las que no existe una única respuesta correcta y en las que el sistema debe realizar juicios, recomendaciones o interpretaciones. A partir de este enorme conjunto de datos, los investigadores identificaron más de 3.300 valores presentes en las respuestas del modelo, que posteriormente agruparon en categorías más generales para construir un mapa del comportamiento ético y comunicativo de Claude.

Uno de los hallazgos más relevantes es que las diferencias entre modelos no se limitan al rendimiento técnico, sino que también afectan al estilo de interacción y a la forma en que el sistema manifiesta determinados valores. Mediante técnicas estadísticas de reducción de dimensiones, Anthropic identificó cuatro ejes fundamentales que describen estas variaciones: deferencia frente a cautela, calidez frente a rigor, profundidad frente a brevedad y franqueza frente a orientación a la ejecución. Así, algunos modelos muestran una mayor tendencia a ofrecer respuestas empáticas y alentadoras, mientras que otros privilegian el análisis crítico, la precisión o la objetividad. Estas diferencias son relativamente moderadas, pero suficientemente consistentes como para caracterizar la personalidad comunicativa de cada versión de Claude.

La investigación también demuestra que el idioma en el que interactúa el usuario influye de forma significativa en la expresión de estos valores. Claude no responde exactamente igual cuando conversa en inglés, español, ruso, árabe o hindi. Por ejemplo, las conversaciones en hindi tienden a reflejar un estilo más cálido y alentador, mientras que las realizadas en ruso presentan respuestas más rigurosas, analíticas y orientadas a solicitar evidencias. En inglés predominan la cautela y la profundidad argumentativa, mientras que otros idiomas muestran combinaciones distintas de franqueza, concisión o deferencia. Anthropic subraya que estas diferencias no implican que un idioma produzca respuestas mejores o peores, sino que reflejan patrones estadísticos derivados de las interacciones reales y de los contextos culturales asociados a cada lengua.

Otro aspecto importante del trabajo es que estas variaciones no fueron obtenidas mediante la traducción de los mismos mensajes a diferentes idiomas, sino analizando conversaciones auténticas desarrolladas por usuarios de todo el mundo. Esto significa que el estudio captura diferencias surgidas de los propios contextos culturales, de las expectativas de los usuarios y de las formas particulares de comunicación presentes en cada comunidad lingüística. Los investigadores advierten, por tanto, que los resultados describen tendencias observadas en la práctica y no permiten establecer relaciones causales ni afirmar que un idioma determine necesariamente un determinado comportamiento del modelo.

Anthropic considera que este tipo de investigaciones constituye un paso importante hacia el desarrollo de sistemas de inteligencia artificial más transparentes y alineados con los valores humanos. Comprender qué valores expresa un modelo, cómo cambian según el contexto lingüístico y cultural y cómo evolucionan entre diferentes generaciones de modelos permitirá diseñar mecanismos de evaluación más precisos y políticas de alineamiento más sofisticadas. En lugar de asumir que los modelos son completamente neutrales, el estudio propone entenderlos como sistemas cuya conducta refleja una compleja interacción entre entrenamiento, diseño, idioma y contexto de uso, abriendo nuevas líneas de investigación sobre la gobernanza ética y la adaptación cultural de los grandes modelos de lenguaje.

Lo que los líderes de la edición científica dicen realmente sobre la IA cuando no están en público

Toler, T., & Cochran, A. (11 de marzo de 2026). What Publishing Leaders Say About AI When They’re Not on Panels: A Pulse on All Things AI. The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/03/11/what-publishing-leaders-say-about-ai-when-theyre-not-on-panels/

El artículo recoge las conclusiones de una serie de conversaciones privadas con catorce directivos de editoriales académicas, principalmente de sociedades científicas y editoriales independientes, con el objetivo de conocer cómo perciben realmente el impacto de la inteligencia artificial más allá de los discursos públicos. Los autores destacan que, lejos del entusiasmo o del alarmismo que suele caracterizar los debates abiertos, los responsables editoriales mantienen una visión mucho más pragmática, centrada en los desafíos estratégicos, económicos y organizativos que plantea la IA para el sector.

Uno de los temas que más preocupa es el uso del contenido editorial para entrenar modelos de inteligencia artificial. Los directivos consideran que los datos y publicaciones científicas representan uno de sus principales activos y que la negociación de licencias con las empresas de IA puede convertirse en una nueva fuente de ingresos. Sin embargo, también reconocen que vender el acceso al contenido para el entrenamiento de modelos puede implicar riesgos, ya que esos modelos podrían reducir el valor futuro de las publicaciones originales al ofrecer respuestas sin necesidad de consultar las fuentes.

Otro aspecto relevante es el cambio en la forma en que los investigadores accederán a la información científica. Si las búsquedas tradicionales son sustituidas por asistentes inteligentes que sintetizan contenidos y responden directamente a las preguntas, los editores tendrán que replantearse su papel en el ecosistema de la comunicación científica. La preocupación ya no es únicamente proteger el contenido, sino garantizar que las publicaciones sigan siendo visibles, citadas y reconocidas como fuentes autorizadas dentro de los nuevos sistemas basados en IA.

Las conversaciones también reflejan que muchas organizaciones están experimentando con herramientas de inteligencia artificial para automatizar tareas editoriales, mejorar los flujos de trabajo y aumentar la eficiencia. No obstante, los líderes insisten en que la implantación de estas tecnologías debe hacerse con cautela, evaluando cuidadosamente sus implicaciones para la calidad editorial, la integridad científica y la confianza de autores, revisores y lectores. La IA se contempla como una herramienta de apoyo y no como un sustituto del criterio humano.

El artículo concluye que la transformación provocada por la inteligencia artificial obligará a las editoriales científicas a redefinir sus modelos de negocio. Más que competir con las empresas tecnológicas, deberán encontrar formas de aportar valor añadido mediante contenidos fiables, metadatos de calidad, sistemas de atribución, licencias sostenibles y relaciones duraderas con investigadores e instituciones. En este nuevo escenario, la confianza, la procedencia verificable de la información y la capacidad para integrarse en los ecosistemas de IA serán factores decisivos para el futuro de la edición académica.

Los centros de datos ya consumen casi tanta electricidad como todos los hogares de Irlanda

Paul Alcorn. Ireland’s data centers consumed nearly as much electricity as every home in the country combined in 2025 — server farms gulped 23% of national power despite years of grid restrictions. Tom’s Hardware, julio de 2026

Texto completo

El crecimiento de la inteligencia artificial está provocando un aumento sin precedentes en la demanda energética de los centros de datos, e Irlanda se ha convertido en uno de los ejemplos más llamativos de este fenómeno. El consumo trimestral de electricidad de los centros de datos aumentó un 584 %, pasando de 291 GWh en el primer trimestre de 2015 a 1.991 GWh en el cuarto trimestre de 2026.

Según los datos de la Oficina Central de Estadística irlandesa, en 2025 los centros de datos consumieron el 23 % de toda la electricidad del país, una cifra que se aproxima al 28 % utilizado por el conjunto de los hogares irlandeses. En términos absolutos, estas instalaciones emplearon 7.663 GWh, un 10 % más que el año anterior y un incremento de alrededor del 360 % desde 2015, reflejando el extraordinario crecimiento de la infraestructura digital asociada a la computación en la nube y, especialmente, a la inteligencia artificial.

El dato resulta especialmente significativo porque este aumento del consumo se ha producido a pesar de que Irlanda mantiene desde 2021 fuertes restricciones para conectar nuevos centros de datos a la red eléctrica, especialmente en la región de Dublín, donde se concentra la mayor parte de estas instalaciones. Sin embargo, los grandes operadores tecnológicos —entre ellos Microsoft, Google, AWS y Meta— han seguido incrementando la capacidad de los centros ya existentes para responder a la explosión de la demanda de servicios de IA y computación en la nube. Como consecuencia, el consumo eléctrico del sector ha continuado creciendo incluso sin un gran aumento del número de instalaciones.

Ante esta situación, el Gobierno irlandés ha sustituido la anterior moratoria por una nueva política energética para grandes consumidores eléctricos. Las futuras instalaciones deberán generar su propia energía o garantizar que una parte muy importante proceda de nuevas fuentes renovables, además de ubicarse preferentemente en zonas donde exista capacidad suficiente de generación eléctrica. El objetivo es evitar que el crecimiento de la infraestructura digital comprometa la estabilidad de la red, eleve los costes energéticos para los ciudadanos o retrase la transición hacia un sistema eléctrico más sostenible.

El caso de Irlanda ilustra un desafío que comienza a extenderse a escala mundial. La rápida expansión de los modelos de inteligencia artificial exige centros de datos cada vez más potentes y con un consumo energético muy superior al de generaciones anteriores. Diversos estudios prevén que el uso de electricidad por parte de los centros de datos seguirá creciendo de forma acelerada durante los próximos años, convirtiendo el acceso a la energía y la disponibilidad de redes eléctricas robustas en uno de los principales factores que condicionarán el desarrollo futuro de la IA.

Hacia un estándar global para declarar el uso de la inteligencia artificial en la investigación científica

Weaver, Kari D.; Seghers, Bert; McNeice, Kiera; Perkins, Mike; Santamarina, Sergio; Lingard, Lorelei; Tsybuliak, Natalia; Dijstal, Felix. «Guest Post — Research Needs a Shared Standard for AI Disclosure.» The Scholarly Kitchen, 13 de julio de 2026. The Scholarly Kitchen (artículo original)

El artículo sostiene que la investigación científica necesita con urgencia un estándar internacional y compartido para declarar el uso de herramientas de inteligencia artificial (IA) durante todo el ciclo de investigación.

Los autores argumentan que la aparición de modelos generativos como ChatGPT ha modificado profundamente la forma en que los investigadores redactan textos, analizan datos, revisan literatura, programan o traducen documentos. Sin embargo, mientras la adopción de estas herramientas se ha generalizado, las normas para informar sobre su utilización continúan siendo fragmentarias, inconsistentes y, en muchos casos, inexistentes. Esta falta de uniformidad genera incertidumbre entre autores, revisores, editores e instituciones y pone en riesgo principios esenciales de la integridad científica, como la transparencia, la reproducibilidad y la responsabilidad sobre los resultados publicados.

Los autores defienden que la declaración del uso de la IA debe entenderse como una práctica equiparable a la divulgación de las fuentes de financiación, los conflictos de interés o las contribuciones de terceros. En su opinión, informar sobre la utilización de herramientas de IA no debe interpretarse como una admisión de debilidad o una sospecha de mala conducta, sino como una manifestación de buenas prácticas científicas. No obstante, diversos estudios muestran que muchos investigadores evitan revelar el uso de estas tecnologías por temor a que disminuya la credibilidad de sus trabajos o influya negativamente en los procesos de evaluación editorial. Este fenómeno ha creado una importante «brecha de divulgación»: aunque la IA ya forma parte de las prácticas habituales de investigación, una proporción significativa de autores nunca informa sobre su utilización al publicar sus resultados.

Para afrontar este problema, el artículo describe la iniciativa impulsada desde la World Conferences on Research Integrity (WCRI), que ha creado un grupo de trabajo internacional con el apoyo de organizaciones como el International Science Council (ISC), COPE, STM y la Global Young Academy. El objetivo consiste en desarrollar un estándar de referencia mundial para la declaración del uso de IA, inspirado en modelos ampliamente aceptados como las normas de Vancouver para publicaciones biomédicas. El proceso se basa en varias rondas de consulta internacional dirigidas a investigadores, editores, responsables de integridad científica y otros actores del ecosistema académico, con el propósito de construir un consenso amplio antes de proponer un marco definitivo.

Los resultados preliminares de la primera consulta muestran que existe un amplio consenso sobre la necesidad de establecer reglas claras, aunque también revelan importantes desafíos. Los participantes coinciden en que cualquier sistema de declaración debe ser suficientemente flexible para adaptarse a disciplinas muy diversas y evitar imponer cargas administrativas excesivas a los investigadores. Asimismo, consideran fundamental determinar con precisión qué aspectos deben declararse, cuál debe ser el nivel adecuado de detalle y cómo integrar esa información en los manuscritos y en las infraestructuras editoriales existentes. También se debatió ampliamente cuál debe ser el verdadero propósito de estas declaraciones: facilitar la reproducibilidad de la investigación, reforzar la transparencia ética, mejorar la rendición de cuentas o combinar todos estos objetivos simultáneamente.

Otro de los mensajes centrales del artículo es que el uso de la inteligencia artificial no debe ser estigmatizado. Los autores sostienen que las herramientas de IA representan una nueva generación de tecnologías avanzadas, pero que los principios clásicos de la integridad científica siguen siendo plenamente aplicables. La responsabilidad última sobre el contenido científico continúa recayendo en los investigadores humanos, independientemente de las herramientas empleadas durante el proceso. Por ello, las declaraciones sobre IA deberían proporcionar únicamente la información necesaria para que revisores y lectores puedan valorar si las contribuciones de estas herramientas podrían haber influido en la fiabilidad de los métodos, los resultados o las conclusiones del estudio, evitando exigir una documentación innecesariamente detallada que dificulte la investigación.

Finalmente, los autores anuncian la apertura de nuevas rondas de consulta durante la segunda mitad de 2026 y principios de 2027 con el objetivo de perfeccionar una propuesta de estándar global. Subrayan que el éxito de esta iniciativa dependerá de la participación activa de investigadores, universidades, editoriales, financiadores y organismos de integridad científica de todo el mundo. Solo mediante un consenso internacional será posible establecer un sistema de divulgación que promueva la confianza en la investigación, facilite la evaluación de los trabajos científicos y permita integrar la inteligencia artificial en la ciencia de forma responsable, transparente y compatible con los principios fundamentales de la investigación académica.

Las referencias a consultas en ChatGPT cambian según de sus procesos ocultos de búsqueda

Flowchart depicting ChatGPT refining a user query, retrieving information from scientific journals, web pages, and academic papers, and generating a final response with ranked citations.
Diagram showing ChatGPT’s process for refining queries, retrieving data, and citing credible sources.

Goodwin, Danny. “ChatGPT Citations Change When Hidden Search Pipelines Switch.” Search Engine Land, 9 de julio de 2026. https://searchengineland.com/chatgpt-citations-change-hidden-search-pipelines-481843

Un estudio reciente pone de manifiesto que las citas proporcionadas por ChatGPT no son tan estables como muchos usuarios podrían asumir. Aunque una misma pregunta se formule de manera idéntica, las fuentes citadas pueden variar significativamente cuando el sistema modifica de forma interna los mecanismos de búsqueda o los modelos encargados de recuperar información. Estos cambios, invisibles para el usuario, afectan directamente a qué documentos se consultan y cuáles terminan apareciendo como referencias en la respuesta final.

La investigación muestra que ChatGPT utiliza un proceso de recuperación de información mucho más complejo que una simple consulta a un buscador. El sistema genera múltiples búsquedas paralelas, reformula automáticamente la consulta inicial y selecciona distintas fuentes antes de sintetizar la respuesta. Si alguno de estos componentes cambia —ya sea el modelo de lenguaje, el sistema de recuperación o la estrategia de búsqueda— el conjunto de documentos recuperados también cambia, provocando diferencias en las citas ofrecidas al usuario.

Uno de los hallazgos más relevantes es que la reproducibilidad de las respuestas disminuye. Dos usuarios que planteen exactamente la misma pregunta en momentos diferentes pueden recibir respuestas muy similares desde el punto de vista del contenido, pero sustentadas en referencias completamente distintas. Esto representa un desafío para investigadores, periodistas, bibliotecarios y profesionales de la información, ya que dificulta la verificación de resultados y la documentación precisa de las fuentes utilizadas por la inteligencia artificial.

El artículo también destaca que la evolución de los modelos de ChatGPT modifica los patrones de citación. Cambios introducidos en nuevas versiones pueden reducir el número de dominios citados, favorecer determinadas fuentes consideradas más fiables o concentrar las referencias en un conjunto más reducido de sitios web. En consecuencia, la visibilidad de muchos recursos en Internet puede variar sin que sus contenidos hayan cambiado, simplemente porque el sistema de IA ha modificado sus criterios internos de selección.

Desde la perspectiva del posicionamiento web y de la denominada AI Search Optimization (AISO), estos resultados indican que optimizar un contenido para ser citado por sistemas de inteligencia artificial es un objetivo dinámico. La autoridad del dominio, la claridad de la información, la estructura del contenido y la presencia en índices de búsqueda continúan siendo factores importantes, pero no garantizan una presencia estable en las respuestas de ChatGPT, ya que las actualizaciones del sistema pueden alterar sustancialmente el comportamiento de las citas.

Finalmente, el estudio concluye que las citas generadas por los asistentes de IA deben interpretarse como el resultado de un proceso dinámico y probabilístico, más que como una lista fija de referencias. Para aplicaciones académicas o profesionales, los autores recomiendan verificar siempre las fuentes originales y no asumir que las citas proporcionadas por ChatGPT serán idénticas en futuras consultas, incluso cuando la pregunta permanezca sin cambios.