Archivo de la etiqueta: Investigación

El papel de las bibliotecas en la investigación sobre las redes sociales

“Why We’ve Been Checking Out TikTok.” Digital Public Library of America, Digital Public Library of America.January 30, 2025.

Texto completo

Las redes sociales han revolucionado la comunicación y el acceso a la información, pero también han dificultado la investigación sobre su impacto en la sociedad. Antes, el debate público era accesible, pero ahora ocurre en plataformas opacas a la academia, afectando la comprensión de temas como la desinformación, la radicalización y las relaciones internacionales.

El informe Checking Out TikTok: Positioning a Library to Aid Social Media Research Outside of Academia, publicado por la Digital Public Library of America (DPLA), analiza cómo las bibliotecas pueden ayudar a investigadores fuera del ámbito académico a estudiar el impacto de las redes sociales en la sociedad.

Un problema clave es que las restricciones impuestas por las plataformas para evitar abusos también dificultan la actividad de investigadores y archivistas. La evidencia documental, antes accesible en archivos tradicionales, ahora está dispersa en redes sociales, a menudo inaccesible por barreras de pago o términos de servicio restrictivos. Esto genera una brecha en el registro histórico y en la comprensión del presente.

El estudio revela que la investigación sobre redes sociales está fragmentada y con escasos recursos. Los investigadores enfrentan dificultades para acceder a datos cruciales, lo que limita el análisis del impacto social de estas plataformas.

El informe propone fortalecer mecanismos que permitan el acceso y análisis de datos de redes sociales de manera ética y responsable. Las bibliotecas, con su experiencia en gestión de información, pueden desempeñar un papel clave proporcionando infraestructura, herramientas y apoyo para la preservación digital.

Se invita a leer el informe completo para comprender mejor esta problemática y el papel fundamental de las bibliotecas en la documentación del mundo digital.

Principales hallazgos y propuestas:

  • Dificultades para investigar redes sociales: La investigación sobre redes como TikTok enfrenta obstáculos debido a la falta de recursos y la opacidad de las plataformas, lo que dificulta el análisis de fenómenos como la desinformación, la radicalización y el discurso político.
  • Papel clave de las bibliotecas: Gracias a su experiencia en gestión y preservación de la información, las bibliotecas pueden facilitar el acceso a datos de redes sociales de forma ética y responsable.
  • Necesidad de infraestructuras sólidas: Se requieren herramientas y recursos adecuados para archivar y analizar estos datos, garantizando que no se pierda un elemento crucial de la historia digital.

El informe subraya que, con las redes sociales en constante cambio y plataformas como TikTok enfrentando incertidumbre, es fundamental que las bibliotecas asuman un rol más activo en la conservación y el estudio de este contenido.
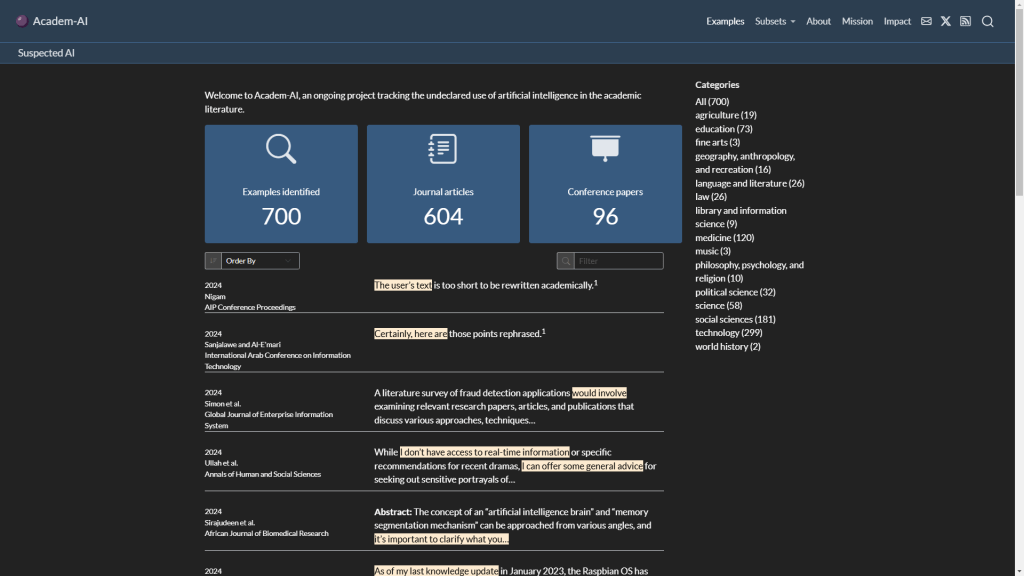
Academ-AI, un proyecto que rastrea el uso no declarado de la inteligencia artificial en la literatura académica.

Academ-AI

https://www.academ-ai.info/

Academ-AI es un proyecto que documenta los efectos adversos del uso de inteligencia artificial (IA) en el ámbito académico, en particular, casos sospechosos de investigaciones redactadas con IA sin la debida declaración.

El sitio enumera artículos en los que se han detectado frases que sugieren fuertemente el uso de IA, las cuales se destacan en cada cita presentada. Los usuarios pueden reportar artículos que consideren incluidos erróneamente o enviar sospechas sobre otros trabajos.

Por el momento, la documentación se limita a artículos de revistas científicas y ponencias en congresos, excluyendo libros, capítulos de libros, preprints, blogs y otros medios.

Los textos generados por IA pueden identificarse por:

  • Frases características como “As of my last knowledge update…” o “As an AI language model…”.
  • Estilo conversacional que no encaja con la prosa académica.
  • Uso excesivo de pronombres en primera persona y marcadores discursivos como “ciertamente”.
  • Explicaciones extensas sobre limitaciones del conocimiento o referencias genéricas a expertos.

Si un artículo ha sido corregido por uso no declarado de IA, se etiqueta con el tipo de errata y la fecha de publicación. En casos donde los editores corrigen errores de IA sin notificar a los lectores, se marcan como “stealth revision” (revisión encubierta) sin fecha.

Se etiqueta cada artículo si pertenece a bases de datos reconocidas, como Web of Science, Scopus, PubMed Central, DOAJ, entre otras. También se validan los ISSN de las revistas y los ISBN de ponencias en congresos.

Artículos científicos fabricados con GPT en Google Scholar: características principales, difusión e implicaciones

Harvard Kennedy School Misinformation Review. “GPT-Fabricated Scientific Papers on Google Scholar: Key Features, Spread, and Implications for Preempting Evidence Manipulation.” Harvard Kennedy School Misinformation Review. Última modificación enero 24, 2025. https://misinforeview.hks.harvard.edu/article/gpt-fabricated-scientific-papers-on-google-scholar-key-features-spread-and-implications-for-preempting-evidence-manipulation/.

La investigación aborda el creciente fenómeno de publicaciones académicas creadas total o parcialmente mediante herramientas de IA generativa, como ChatGPT. Estos documentos, muchas veces fraudulentas, se encuentran fácilmente en Google Scholar, junto a investigaciones legítimas.

Se recuperó, descargó y analizó una muestra de artículos científicos con indicios de uso de GPT encontrados en Google Scholar mediante una combinación de codificación cualitativa y estadísticas descriptivas. Todos los artículos contenían al menos una de dos frases comunes generadas por agentes conversacionales que utilizan modelos de lenguaje extensos (LLM), como ChatGPT de OpenAI. Luego, se utilizó la búsqueda en Google para determinar en qué medida las copias de estos artículos cuestionables, fabricados con GPT, estaban disponibles en diversos repositorios, archivos, bases de datos de citas y plataformas de redes sociales.

Aproximadamente dos tercios de los artículos recuperados fueron producidos, al menos en parte, mediante el uso no declarado y potencialmente engañoso de GPT. La mayoría (57 %) de estos artículos cuestionables trataban temas relevantes para políticas (es decir, medio ambiente, salud, informática), que son susceptibles a operaciones de influencia. La mayoría estaban disponibles en varias copias en diferentes dominios (por ejemplo, redes sociales, archivos y repositorios).

De un análisis de 139 artículos, la mayoría (89) se encontraba en revistas no indexadas, mientras que 19 estaban en revistas indexadas. Además, varios se habían replicado en redes sociales, repositorios y otras plataformas, dificultando su control o eliminación. La mayoría de los artículos trataban temas sensibles y de relevancia política, como medio ambiente (19,5%), salud (14,5%) y computación (23%). Esto los hace propensos a ser utilizados en campañas de desinformación o manipulación de la opinión pública.

Algunos de los riesgos principales es que el aumento de estos artículos amenaza con saturar el sistema de comunicación académica y erosionar la confianza en el conocimiento científico y la manipulación malintencionada, ya que se trata de un fenómeno denominado evidence hacking, en el que estas publicaciones se emplean para socavar consensos científicos o respaldar narrativas engañosas en temas controvertidos.

El artículo propone implementar filtros más rigurosos en buscadores académicos, como Google Scholar, para identificar y excluir artículos no revisados por pares o de origen cuestionable. Además, sugiere crear motores de búsqueda académicos de acceso público y no comerciales, así como promover la alfabetización mediática entre los actores clave, como periodistas y legisladores.

Estos hallazgos subrayan que el fenómeno de publicaciones científicas fabricadas por GPT plantea un riesgo significativo para la confianza en la ciencia y requiere atención inmediata para mitigar sus efectos.

Ai2 ScholarQA, una herramienta experimental basada en inteligencia artificial para facilitar las revisiones de literatura científica

Ai2 ScholarQA

Ai2 ScholarQA, una herramienta experimental basada en inteligencia artificial para facilitar las revisiones de literatura científica. Desarrollada por el Instituto Allen para la Inteligencia Artificial (Ai2), esta herramienta permite a los investigadores formular preguntas científicas que requieren la comparación y el resumen de múltiples documentos. Ai2 ScholarQA utiliza un modelo avanzado de IA, Claude Sonnet 3.5, y un corpus de artículos de acceso abierto para proporcionar respuestas detalladas y contextualizadas. Aunque la herramienta puede ser menos coherente en algunos casos debido a su enfoque en la evidencia, busca mejorar la eficiencia en las revisiones de literatura. Ai2 planea abrir el código fuente de la funcionalidad principal y continuar explorando formas de personalizar y mejorar el apoyo a la investigación científica con IA.

Estadística descriptiva para trabajos de investigación: presentación e interpretación de los resultados

Jorge Sucasaire Pilco, Estadística descriptiva para trabajos de investigación: presentación e interpretación de los resultados (Sucasaire Pilco, Jorge, 2021),

Texto completo

Busca acercar a las personas que se inician en el desarrollo de una investigación a los principales elementos del análisis estadístico descriptivo. Menciona que la estadística es una herramienta indispensable para el análisis de datos de una investigación, por ello, el investigador debe comprender los conceptos estadísticos básicos y seleccionar de manera adecuada aquellos que le servirán para presentar y analizar sus resultados. Asimismo, explica términos estadísticos de forma sencilla complementados con ejemplos básicos, pero importantes para reforzar los conceptos y su aplicación pertinente dentro del tratamiento estadístico de acuerdo con el objetivo de un trabajo de investigación.

Diccionario de metodología de investigación científica

Carlos David Laura Quispe, Diccionario de metodología de investigación científica: aportaciones para la producción de conocimiento científico (Publicia, 2016),

Texto completo

Presenta un desglose de cada etapa de una investigación científica, así como todas las conceptualizaciones y definiciones de cada término utilizado en ella. En su elaboración ha tomado como base: bibliografía clásica, bases de datos, materiales de programas de post grado, entre otros, los que se han complementado con consultas a investigadores.

La presión para publicar está contribuyendo a un aumento en la retractación de artículos científicos

Tran, Nham. «The ‘Publish or Perish’ Mentality Is Fuelling Research Paper Retractions – and Undermining Science.» The Conversation, September 24, 2024. https://theconversation.com/the-publish-or-perish-mentality-is-fuelling-research-paper-retractions-and-undermining-science-238983

Los científicos, al realizar descubrimientos importantes, suelen publicar sus hallazgos en revistas científicas para que otros puedan leerlos y beneficiarse de ese conocimiento. Esta difusión de información es fundamental para el progreso de la ciencia, ya que permite que otros investigadores construyan sobre trabajos previos y, potencialmente, realicen nuevos descubrimientos significativos. Sin embargo, los artículos publicados pueden ser retractados si se detectan problemas de precisión o integridad en los datos. En años recientes, el número de retractaciones ha aumentado considerablemente. En 2023, se retractaron más de 10.000 artículos de manera global, estableciendo un nuevo récord.

El aumento en las retractaciones está impulsado por la mentalidad de «publicar o perecer», una situación que ha prevalecido en la academia durante décadas. La publicación de artículos de investigación es un factor clave para el avance en la carrera académica y para la mejora de los rankings universitarios. Las universidades y los institutos de investigación suelen utilizar el número de publicaciones como indicador principal de productividad y reputación. Esto ha llevado a una presión constante sobre los académicos para publicar regularmente, lo que, a su vez, ha contribuido a un aumento en la presentación de datos fraudulentos. Si esta tendencia continúa, el paisaje de la investigación podría cambiar hacia estándares menos rigurosos, dificultando el progreso en áreas críticas como la medicina, la tecnología y la ciencia climática.

Retraction Watch, una de las bases de datos más grandes que monitorea las retractaciones científicas, ha revelado un incremento en la cantidad de artículos retractados. En la última década, se han retractado más de 39.000 publicaciones, y el número anual de retractaciones está creciendo alrededor de un 23% cada año. Aproximadamente la mitad de estas retractaciones se deben a problemas relacionados con la autenticidad de los datos. Un ejemplo es el caso de Richard Eckert, un bioquímico senior de la Universidad de Maryland, Baltimore, quien falsificó datos en 13 artículos publicados. De estos, cuatro han sido corregidos, uno ha sido retractado y los demás están en proceso de acción.

El plagio es la segunda razón más común para la retractación de artículos, representando el 16% de los casos. Otro motivo significativo es el uso de revisiones por pares falsas, un problema que ha aumentado diez veces en la última década. También ha habido un incremento en las publicaciones asociadas con las llamadas «fábricas de artículos» (Paper Mills), que son empresas que producen artículos falsos por una tarifa. En 2022, hasta un 2% de todas las publicaciones provinieron de estas fábricas. Los errores genuinos en el proceso científico solo representan aproximadamente el 6% de todas las retractaciones en la última década.

La presión para publicar ha llevado a un aumento en los errores y las prácticas fraudulentas. Aunque la digitalización ha facilitado la detección de datos sospechosos, también ha intensificado la cultura de «publicar o perecer» en las universidades. La mayoría del personal académico debe cumplir con cuotas específicas de publicaciones para evaluaciones de desempeño, y las instituciones utilizan el rendimiento en publicaciones para mejorar su posición en los rankings globales, lo que atrae a más estudiantes y genera ingresos por enseñanza.

El sistema de recompensas en la academia a menudo prioriza la cantidad sobre la calidad de las publicaciones. Este enfoque puede llevar a los científicos a recortar esquinas, apresurar experimentos o incluso falsificar datos para cumplir con las métricas impuestas. Para abordar este problema, iniciativas como la Declaración de San Francisco sobre la Evaluación de la Investigación están impulsando un cambio hacia la evaluación de la investigación basada en su calidad e impacto social, en lugar de métricas centradas en revistas, como factores de impacto o recuentos de citas.

Cambiar las políticas de las revistas para priorizar el intercambio de todos los datos experimentales podría mejorar la integridad científica, permitiendo a los investigadores replicar experimentos para verificar los resultados de otros. Además, las universidades, los institutos de investigación y las agencias de financiamiento necesitan mejorar su diligencia debida y responsabilizar a aquellos involucrados en malas conductas. Incluir preguntas simples en las solicitudes de subvenciones o promociones académicas, como «¿Alguna vez ha tenido o estado involucrado en un artículo retractado?», podría mejorar la integridad de la investigación al disuadir comportamientos poco éticos. Las respuestas deshonestas podrían ser fácilmente detectadas gracias a la disponibilidad de herramientas en línea y bases de datos como Retraction Watch.

Un nuevo enfoque de la ética de la investigación: utilizar el diálogo guiado para fortalecer las comunidades de investigación

Henriikka Mustajoki y Arto Mustajoki, A New Approach to Research Ethics: Using Guided Dialogue to Strengthen Research Communities (London: Routledge, 2017), https://doi.org/10.4324/9781315545318.

A New Approach to Research Ethics es una guía clara, práctica y útil sobre los problemas éticos a los que se enfrentan los investigadores hoy en día. Examinando las teorías de la toma de decisiones éticas y aplicándolas a diversas situaciones dentro de una carrera e proceso de investigación, este texto ofrece una perspectiva más amplia sobre cómo la ética puede ser una fuerza positiva para fortalecer la comunidad investigadora.

Basado en una sólida selección de estudios de caso desafiantes, este texto ofrece un nuevo enfoque para abordar los problemas éticos y proporciona al lector:

  • Una visión más amplia sobre la ética en la investigación práctica, abarcando tanto las diferentes etapas de las carreras investigadoras como diversas tareas dentro de esa carrera, incluyendo la supervisión y las evaluaciones de investigación.
  • Reflexiones sobre cuestiones como la creciente globalización, la ciencia abierta y la competencia intensificada.
  • Una mayor comprensión de la investigación en un mundo de nuevas tecnologías.
  • Una extensión de la ética en la investigación hacia un enfoque multidisciplinario e interdisciplinario.
  • Una introducción a un método de «diálogo guiado», que ayuda a identificar y abordar los problemas éticos tanto a nivel individual como dentro de la comunidad investigadora.

Un nuevo enfoque de la ética en la investigación permite la autorreflexión y ofrece orientación para el desarrollo profesional en un área cada vez más competitiva. Lleno de valiosas recomendaciones para el investigador y el tomador de decisiones éticas, este texto es esencial para estudiantes de posgrado, académicos senior y desarrolladores de cursos de formación sobre ética para investigadores.

Infiltración de contenidos generados por ChatGPT en artículos científicos de revistas de prestigio

Strzelecki, Artur. «‘As of My Last Knowledge Update’: How is Content Generated by ChatGPT Infiltrating Scientific Papers Published in Premier Journals?» Learned Publishing 38, no. 1 (2025). https://doi.org/10.1002/leap.1650

El artículo examina cómo el contenido generado por ChatGPT aparece en artículos revisados por pares en revistas de prestigio sin ser declarado por los autores. Utilizando el método SPAR4SLR, se identificaron fragmentos generados por IA en publicaciones indexadas en bases de datos científicas

El uso no declarado de contenido generado por ChatGPT en artículos científicos es un problema emergente, con ejemplos de textos generados por IA que han pasado desapercibidos en revistas académicas de prestigio. Esto ha sido detectado en publicaciones como Resources Policy, Surfaces and Interfaces y Radiology Case Reports, que finalmente fueron retiradas. La falta de transparencia sobre el uso de IA en la creación de contenido científico plantea desafíos para el proceso de revisión por pares y la aceptación de manuscritos en revistas científicas.

Este artículo propone investigar cómo identificar los artículos parcialmente generados por ChatGPT, cómo se citan en otros trabajos y cómo responden los editores a este tipo de contenido. La investigación busca mejorar las políticas editoriales y la calidad de los artículos publicados, enfocándose no solo en correcciones lingüísticas, sino en la creación de contenido generado por IA.

A través de búsquedas en Google Scholar, se ha identificó contenido generado por ChatGPT mediante frases recurrentes que este modelo utiliza, como «as of my last knowledge update» y «I don’t have access to». Estas frases fueron inicialmente utilizadas para encontrar artículos que contenían texto generado por la IA. Además, se identificaron otros términos frecuentes como «regenerate response», que aparecían en artículos científicos sin justificación, señalando que el contenido había sido generado o manipulado por el modelo de IA.

Utilizando el método SPAR4SLR, comúnmente empleado en revisiones sistemáticas de literatura, el autor analizó artículos indexados en las bases de datos Web of Science y Scopus, identificando secciones que presentan indicios de haber sido creadas íntegramente por ChatGPT.

Los principales hallazgos del estudio son:

  1. Presencia no declarada de contenido generado por IA: Se detectaron artículos en revistas de renombre que contienen material producido por modelos de lenguaje como ChatGPT, sin que los autores hayan reconocido su uso.
  2. Citas académicas: Varios de estos artículos ya han sido citados en otras investigaciones publicadas en revistas indexadas, lo que amplifica la difusión de contenido generado por IA en la literatura científica.
  3. Disciplinas afectadas: Aunque la mayoría de los artículos identificados pertenecen a las áreas de medicina e informática, también se encontraron en campos como ciencias ambientales, ingeniería, sociología, educación, economía y gestión.

La búsqueda identificó 1.362 artículos científicos en los que se confirma inequívocamente que porciones del texto fueron generadas por ChatGPT. La cantidad de artículos fue tal que podría realizarse un análisis manual, artículo por artículo. La mayoría de los resultados obtenidos por Google Scholar se vinculan con publicaciones de revistas no indexadas en bases de datos científicas de calidad como Web of Science y Scopus, o en plataformas que publican preprints, como arXiv, researchsquare, SSRN y otras. Sin embargo, una porción menor de los resultados pertenece a editores reconocidos como grandes publicadores científicos con gran influencia en los lectores. Muchos de los artículos identificados fueron publicados en revistas que están indexadas en las bases de datos Web of Science y Scopus y tienen indicadores de calidad como el Factor de Impacto y CiteScore derivados de la cantidad de citas.

El estudio subraya la necesidad de una discusión ética y metodológica sobre el uso de modelos de lenguaje como ChatGPT en la producción de trabajos académicos. La falta de transparencia en la utilización de estas herramientas puede comprometer la integridad científica y plantea interrogantes sobre la autoría y la originalidad en la investigación.

Este análisis invita a la comunidad académica a reflexionar sobre las implicaciones del uso de inteligencia artificial en la redacción científica y a establecer directrices claras que aseguren la transparencia y la calidad en las publicaciones.

El impacto de la inteligencia artificial generativa en la investigación

Ding, Liangping, Cornelia Lawson, y Philip Shapira. «Rise of Generative Artificial Intelligence in Science.» arXiv, 5 de enero de 2025. https://doi.org/10.48550/arXiv.2412.20960

La IA generativa está redefiniendo el panorama de la investigación científica, mostrando patrones únicos en términos de colaboración y especialización en comparación con otras tecnologías de IA. Esto subraya la importancia creciente de la IA generativa como una herramienta clave en diversas disciplinas científicas.

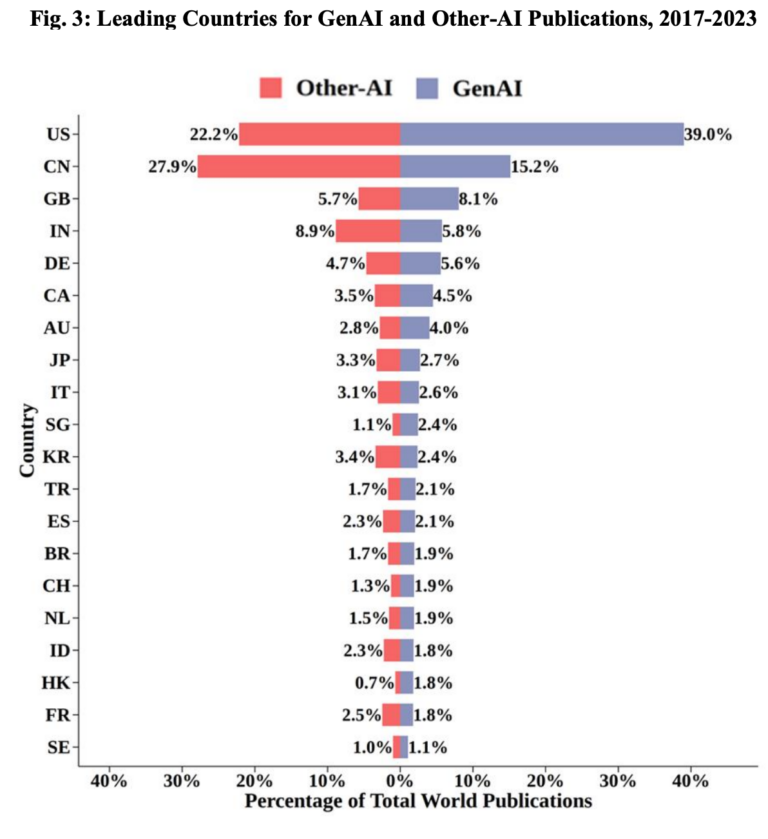
Se explora el impacto de la inteligencia artificial generativa (IA generativa o GenAI) en la investigación científica. Este estudio empírico, utilizando datos de OpenAlex, analiza el crecimiento, la difusión en diversos campos de estudio y la distribución geográfica de las publicaciones sobre GenAI entre 2017 y 2023.

Hallazgos:

  • Crecimiento Rápido: La IA generativa ha experimentado un crecimiento acelerado, expandiéndose desde la informática hacia otros dominios científicos. Este auge se refleja en el aumento de publicaciones científicas que emplean GenAI.
  • Difusión y Campos de Estudio: La investigación en GenAI no se limita solo al campo de la computación, sino que se ha extendido a múltiples disciplinas científicas, mostrando un patrón de difusión amplia.
  • Distribución Geográfica: Los investigadores estadounidenses han contribuido con cerca del 40% de las publicaciones globales sobre GenAI, seguidos por China. Otros países con economías avanzadas pequeñas y medianas también muestran un alto nivel de uso de GenAI en sus investigaciones.
  • Tamaño de los Equipos y Colaboraciones Internacionales: A diferencia de otras tecnologías de IA, los grupos de investigación en GenAI tienden a ser ligeramente más pequeños. Sin embargo, las colaboraciones internacionales en el ámbito de GenAI mantienen niveles comparables a otras áreas de IA, a pesar de las tensiones geopolíticas recientes.