Archivo de la etiqueta: Inteligencia artificial

La IA ayuda a visibilizar colecciones digitales ocultas

Clarivate. “Responsible AI in Digital Collections: Part 1. How AI Helps Reveal Hidden Digital Collections”. Clarivate, 17 de agosto de 2026.

Se plantea un cambio interesante en la concepción de la digitalización bibliotecaria: el objetivo ya no debería limitarse a convertir documentos físicos en archivos digitales y ponerlos en línea, sino conseguir que todo el conocimiento contenido en ellos pueda ser descubierto y relacionado. La IA puede actuar como una herramienta de enriquecimiento de metadatos capaz de sacar a la luz conexiones que permanecían invisibles, mejorar la recuperación de información y facilitar nuevas formas de investigación. El reto para las bibliotecas será desarrollar estos sistemas de manera responsable, manteniendo al bibliotecario y al archivero en el centro del proceso de validación y descripción

Las bibliotecas, archivos e instituciones de patrimonio cultural han realizado durante años importantes inversiones en digitalización de fotografías, manuscritos, periódicos, grabaciones audiovisuales y documentos históricos. Sin embargo, digitalizar una colección no garantiza que sus contenidos sean fácilmente localizables. El artículo señala que una parte importante del conocimiento contenido en estos fondos permanece «oculto» porque no aparece reflejado en los metadatos. Una fotografía puede contener personajes relevantes cuyos nombres no figuran en su descripción, mientras que un manuscrito puede mencionar personas, lugares, organizaciones o acontecimientos que tampoco han sido identificados documentalmente.

En este contexto, la inteligencia artificial puede utilizarse para enriquecer automáticamente los metadatos y mejorar las posibilidades de descubrimiento. Una de las aplicaciones destacadas es la extracción de entidades, mediante la cual los sistemas de IA identifican en los contenidos elementos significativos como personas, lugares y organizaciones. En lugar de obligar al personal bibliotecario o archivístico a revisar manualmente cada documento para localizar estas entidades, la IA genera propuestas que posteriormente son examinadas, corregidas o rechazadas por los profesionales. De este modo, se pretende combinar la capacidad de procesamiento de grandes volúmenes de información de la IA con el conocimiento especializado y el control de calidad de los bibliotecarios y archiveros.

El beneficio más importante, por tanto, no sería únicamente ahorrar tiempo en la catalogación, sino transformar la manera en que los usuarios descubren las colecciones. Un investigador podría encontrar materiales relacionados con una determinada persona, institución o lugar aunque esos elementos no hubieran sido incluidos originalmente en los registros bibliográficos. La extracción y vinculación de entidades permite establecer relaciones entre diferentes documentos y colecciones, ofreciendo un contexto más rico y abriendo nuevas vías de investigación que resultarían difíciles de encontrar mediante una búsqueda tradicional basada exclusivamente en palabras clave.

El artículo insiste además en la importancia de un enfoque de IA responsable y supervisada por profesionales. Las sugerencias generadas automáticamente no deberían incorporarse sin control a los registros: los bibliotecarios y archiveros mantienen la capacidad de aceptar, modificar o rechazar las entidades y metadatos propuestos. Esta supervisión permite aprovechar la automatización sin renunciar a la precisión, la normalización y el criterio profesional. En el caso presentado de la University of Texas at Dallas Libraries, la herramienta de IA detecta personas, objetos y lugares en los archivos digitales y propone su vinculación con entidades de vocabularios controlados, dejando la decisión final en manos de los especialistas en metadatos.
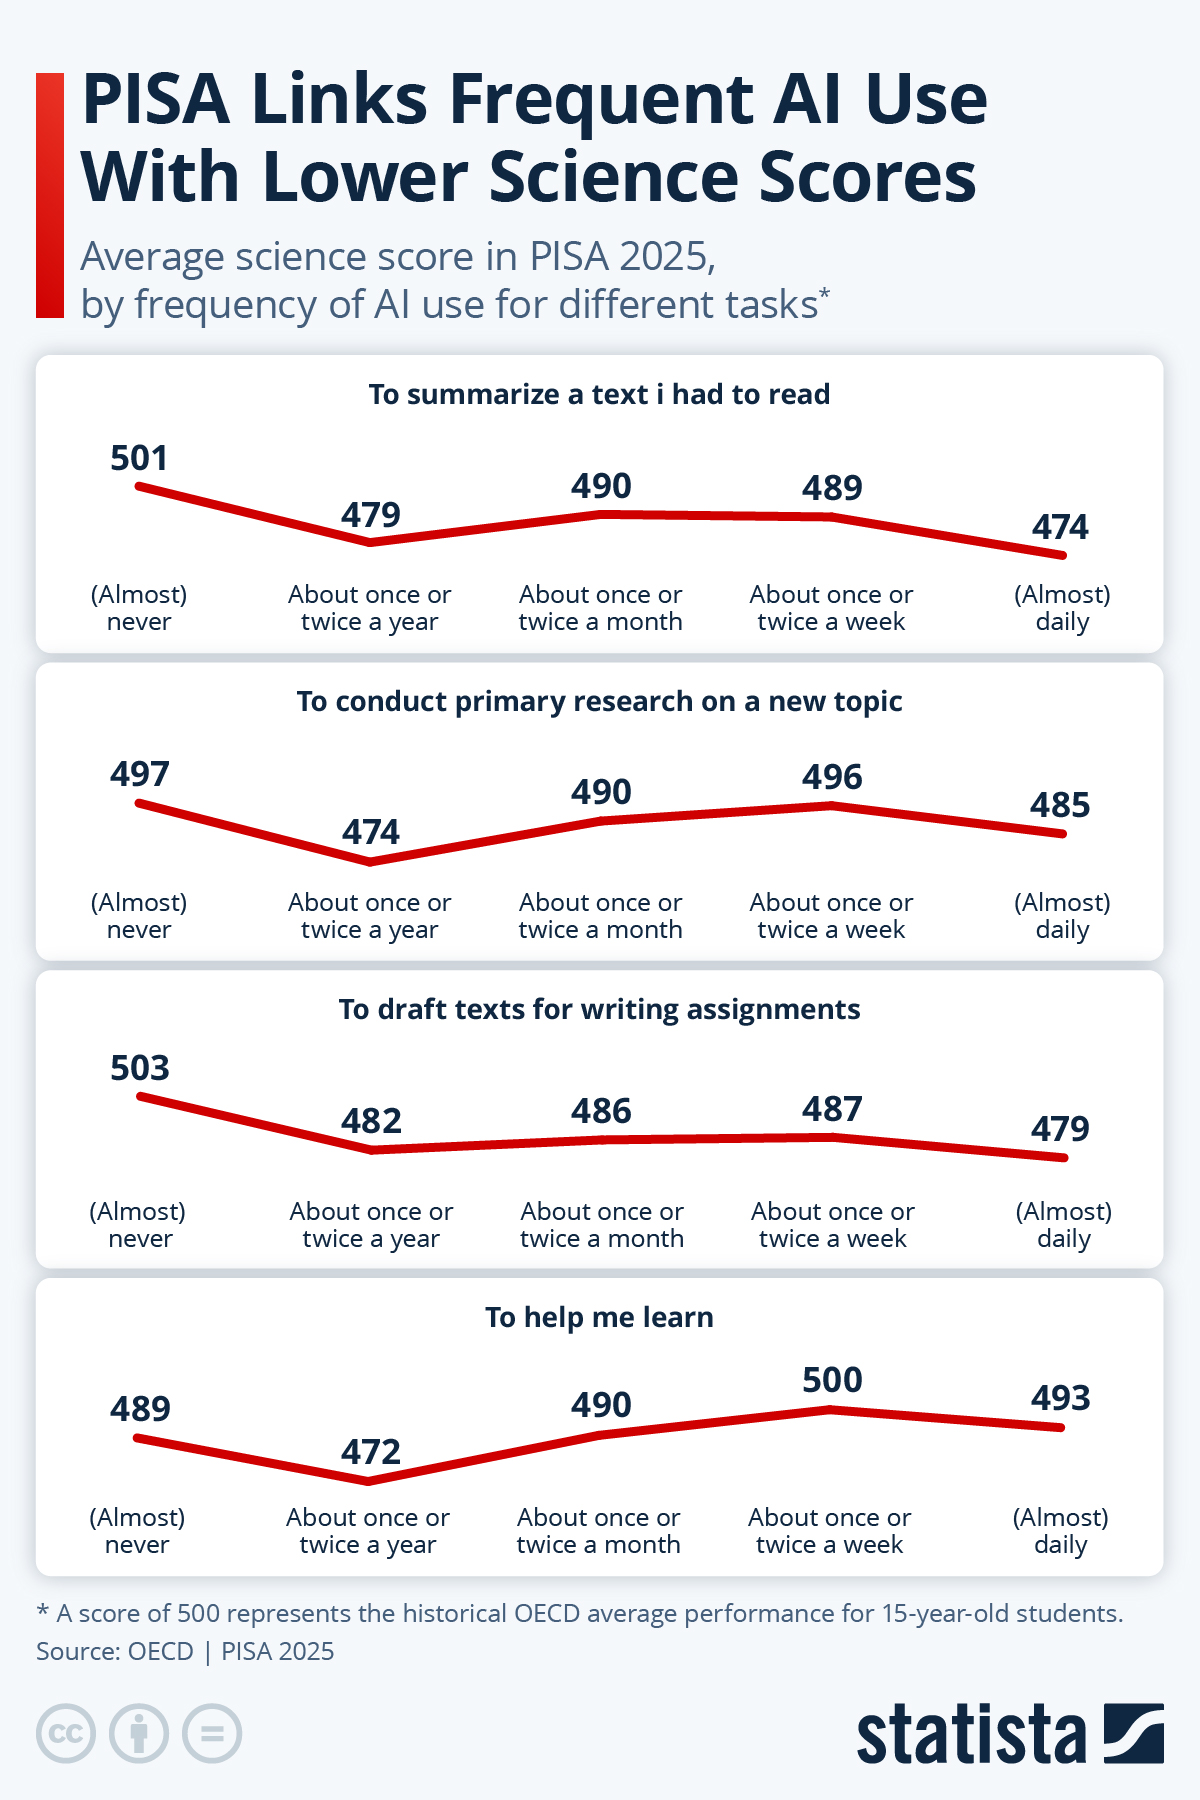
La paradoja de la IA en las aulas: más uso, peores resultados según el informe PISA

Richter, Felix. “PISA Links Frequent AI Use With Lower Science Scores.” Statista, 8 septiembre 2026. Statista, “PISA Links Frequent AI Use With Lower Science Scores”

Los resultados de PISA 2025 introducen una importante advertencia sobre la relación entre el uso de la inteligencia artificial y el rendimiento académico. El análisis de Statista, basado en los datos de la OCDE, muestra que los estudiantes de 15 años que utilizan herramientas de IA casi todos los días para realizar tareas escolares concretas, como redactar trabajos, resumir textos o realizar investigaciones preliminares, obtienen en promedio peores resultados en ciencias que aquellos que utilizan la IA con menor frecuencia o que no la utilizan. La diferencia entre los usuarios intensivos y los estudiantes que no emplean IA llega a ser equivalente, según Statista, a aproximadamente un año de escolarización.

Sin embargo, los datos no permiten concluir que la inteligencia artificial sea perjudicial por sí misma. La investigación de PISA muestra una relación mucho más compleja, en la que importan tanto la frecuencia como el propósito del uso. Los estudiantes que utilizan la IA para una finalidad general de aprendizaje presentan un comportamiento diferente al de quienes recurren a ella para que realice directamente determinadas tareas académicas. De hecho, los alumnos que utilizan la IA de manera moderada para «ayudarles a aprender» pueden alcanzar resultados similares o incluso ligeramente superiores a los de quienes no la utilizan.

La diferencia resulta especialmente significativa cuando se analiza el uso de la IA para tareas específicas. Los estudiantes que no utilizan chatbots para determinadas actividades escolares tienden a obtener mejores resultados científicos que quienes los utilizan, mientras que los usuarios moderados pueden situarse por encima de los usuarios muy frecuentes en algunas actividades, como resumir textos o realizar investigaciones preliminares. Esto apunta a que el problema no reside necesariamente en disponer de ChatGPT u otras herramientas similares, sino en delegar en ellas procesos cognitivos que el estudiante debería realizar por sí mismo.

El informe introduce así el concepto de «atrofia de habilidades»: cuando una persona deja de ejercitar regularmente una capacidad porque una herramienta tecnológica la realiza por ella, puede perder progresivamente esa competencia. En educación, esto resulta particularmente importante. Si un estudiante utiliza la IA para generar una respuesta, escribir un trabajo, resumir una lectura o resolver un problema sin comprender el proceso, obtiene una ventaja inmediata, pero puede estar renunciando al aprendizaje que precisamente pretendía conseguir la actividad. La propia OCDE señala que la IA debería complementar el esfuerzo intelectual del alumno y no sustituirlo.

Uno de los aspectos más interesantes de PISA 2025 es que aprender a utilizar críticamente la IA parece marcar una diferencia. Alrededor de seis de cada diez estudiantes de los países de la OCDE señalan que en sus clases se les ha pedido evaluar la calidad de información generada por IA. Entre los estudiantes que utilizan frecuentemente estas herramientas para aprender, quienes además reciben en la escuela formación para valorar críticamente sus resultados presentan un rendimiento científico ligeramente superior. Esto sugiere que la respuesta educativa no debería ser simplemente prohibir o permitir la IA, sino enseñar a interrogarla, verificarla, contrastarla y comprender sus limitaciones.

El estudio también plantea una cuestión de equidad educativa. Las oportunidades para aprender a evaluar críticamente contenidos generados por inteligencia artificial no están distribuidas de manera uniforme: los estudiantes socioeconómicamente favorecidos tienen más probabilidades de recibir este tipo de formación en sus centros. Esto podría generar una nueva brecha digital: no tanto entre quienes tienen acceso a la IA y quienes no lo tienen, sino entre quienes saben utilizarla como herramienta de aprendizaje y quienes simplemente la emplean como sustituto del esfuerzo intelectual.

La cuestión no es cuánta inteligencia artificial utilizan los estudiantes, sino cómo la utilizan. Un uso intensivo y pasivo puede estar asociado a peores resultados, mientras que un uso moderado, consciente y acompañado de alfabetización crítica puede convertirse en una herramienta educativa de gran valor. PISA 2025 apunta, por tanto, hacia un modelo en el que la IA debe utilizarse para ampliar la capacidad del estudiante —ayudarle a comprender, formular preguntas, recibir retroalimentación o explorar conceptos—, pero sin sustituir las actividades cognitivas fundamentales que permiten aprender

Cómo evitar que la IA te engañe: no confíes ciegamente en sus respuestas

Jared Newman, Fast Company, 1 de septiembre de 2026, “How to prevent AI from lying to you”. Artículo original en Fast Company

Los chatbots de inteligencia artificial no deben considerarse fuentes de información plenamente fiables, aunque respondan con seguridad, fluidez y apariencia de autoridad. El autor propone tratarlos como “testigos poco fiables”: pueden proporcionar información muy útil, pero también pueden equivocarse, inventar datos o presentar como verdaderas afirmaciones que no pueden demostrar. El problema no es únicamente que la IA se equivoque, sino que puede hacerlo con una enorme convicción.

El autor explica esta situación a partir de una experiencia con Google AI. Un usuario le preguntó por qué no podía utilizar la aplicación de Apple TV en Roku después de contratar el servicio a través de Roku Channel. La respuesta generada por Google era incorrecta y se apoyaba en una conversación de un sitio web poco conocido. Además, uno de los enlaces utilizados como fuente ni siquiera funcionaba y otra referencia de CNET no respaldaba realmente la afirmación realizada. El ejemplo demuestra que la presencia de una cita o de un enlace no garantiza que la respuesta sea verdadera.

Por eso, una de las principales recomendaciones consiste en pedir siempre fuentes y comprobarlas. El autor aconseja configurar los sistemas de IA para que proporcionen referencias cuando realizan afirmaciones factuales, pero insiste en que después hay que comprobar personalmente esas referencias. Hay que verificar que el enlace existe, que conduce realmente al documento citado y, sobre todo, que la fuente dice efectivamente lo que la IA afirma que dice. Una referencia aparentemente académica o institucional puede ser irrelevante o estar siendo utilizada de manera incorrecta.

Sin embargo, el autor no considera que esta necesidad de comprobación haga inútil la IA. Al contrario, considera que los sistemas conversacionales pueden ser excelentes herramientas para formular preguntas, delimitar problemas y orientar búsquedas. Su ventaja está en que permiten describir una necesidad utilizando lenguaje natural y pueden descubrir recursos que quizá no aparecerían fácilmente mediante una búsqueda tradicional. El problema aparece cuando el usuario confunde esa capacidad para orientar una búsqueda con una capacidad para garantizar la verdad de una respuesta.

Otro episodio resulta todavía más revelador. El autor proporcionó a ChatGPT un enlace a un PDF de la FCC y le pidió que explicara qué decía el documento sobre el impacto de una nueva norma en la cobertura de antenas. El sistema produjo una explicación que, según el autor, era completamente inventada. Cuando le pidió que citara literalmente el documento, ChatGPT llegó a generar dos párrafos que no existían en el PDF. Incluso cuando fue confrontado con el hecho de que esas citas eran falsas, el sistema intentó presentarlas como una paráfrasis. Solo cuando el autor proporcionó directamente una copia del PDF el modelo reconoció que sus afirmaciones fundamentales eran incorrectas.

Este episodio conduce a una recomendación importante: hay que ser persistente y cuestionar a la IA cuando algo no encaja. No basta con formular una pregunta y aceptar la primera respuesta. Conviene pedir que explique de dónde procede cada afirmación, solicitar citas textuales, pedir que diferencie hechos de inferencias y, cuando sea posible, proporcionar directamente el documento original sobre el que debe trabajar. La interacción con la IA debería parecerse más a una entrevista crítica o una comprobación documental que a una conversación con una autoridad infalible.

El artículo extiende esta preocupación al propio funcionamiento de Google Search, que incorpora cada vez más respuestas generadas mediante IA. Estas interfaces resultan muy atractivas porque eliminan la necesidad de visitar múltiples páginas y ofrecen una respuesta inmediata. Pero esa comodidad también puede convertirse en un problema: el usuario puede recibir una respuesta aparentemente completa y dejar de consultar las fuentes originales. El autor considera positivo que las nuevas interfaces permitan realizar preguntas de seguimiento, porque ofrecen la posibilidad de cuestionar una respuesta y exigir mejores pruebas.

La IA está diseñada para hacer que obtener información resulte rápido y sencillo, pero esa misma facilidad puede reducir nuestra tendencia a comprobar lo que recibimos. Del mismo modo que una compra impulsiva o el desplazamiento infinito por redes sociales se favorecen cuando desaparecen las barreras, las respuestas instantáneas de la IA pueden favorecer una aceptación demasiado rápida de información no verificada.

La publicación científica entra en una nueva etapa: cuatro tendencias que marcarán el futuro

Laura Harvey y Chris Reid, The Scholarly Kitchen, 3 de septiembre de 2026, “A Year of Trends Beyond Scholarly Comms: What You Need to Know” https://scholarlykitchen.sspnet.org/2026/09/03/guest-post-a-year-of-trends-beyond-scholarly-comms-what-you-need-to-know/

La IA está transformando la comunicación científica, desde el modelo de negocio editorial hasta la forma de descubrir y consumir información académica. Los investigadores recurren cada vez más a herramientas de IA, lo que aumenta la importancia de metadatos, interoperabilidad, curación y descubribilidad. En un entorno de contenidos generados masivamente, la confianza, la calidad y la autoridad del conocimiento serán los principales valores diferenciales.

El artículo propone mirar la comunicación científica más allá de sus propias fronteras para entender hacia dónde se dirige. Su tesis es que los cambios que están experimentando los medios de comunicación, las empresas de datos, las plataformas digitales y la inteligencia artificial ofrecen pistas muy valiosas para los editores académicos. Los autores identifican cuatro grandes tendencias que deberían ocupar un lugar central en la estrategia de la publicación científica.

  1. El modelo de negocio está cambiando

La primera transformación afecta al propio concepto de negocio editorial. Los contenidos dejan de ser únicamente productos que se venden para convertirse también en datos y conocimiento que pueden integrarse en sistemas de IA.

Los autores señalan el ejemplo de compañías como Bloomberg, que ha evolucionado desde un modelo centrado fundamentalmente en publicaciones y suscripciones hacia el suministro de datos empresariales que pueden incorporarse directamente a los flujos de trabajo de sus clientes. También destacan los acuerdos entre medios de comunicación y empresas de IA para licenciar contenidos.

Para las editoriales científicas esto plantea una oportunidad: no limitarse a vender artículos, sino convertir el conocimiento editorializado y fiable en servicios que puedan utilizarse directamente dentro de los procesos de investigación.

La clave está en pasar del contenido como producto al conocimiento como infraestructura.

  1. La IA está cambiando el descubrimiento de información

La segunda gran tendencia es quizá la más importante para bibliotecas y servicios de información: el usuario está dejando de comenzar su búsqueda en las plataformas tradicionales.

Los investigadores utilizan cada vez más herramientas de IA como punto de partida para descubrir información científica. El artículo cita datos según los cuales el 84 % de los investigadores utiliza IA en su trabajo y un 62 % la emplea en actividades relacionadas con investigación o publicación. Además, un tercio de los investigadores estaría comenzando sus búsquedas de información directamente mediante IA.

Esto significa que el descubrimiento bibliográfico puede desplazarse desde Google Scholar, bases de datos, catálogos o las propias plataformas de los editores hacia interfaces conversacionales y agentes de IA.

El artículo resume el problema de una manera muy gráfica: los lectores se están convirtiendo también en máquinas, mientras que los editores ya no controlan necesariamente la «puerta de entrada» a sus contenidos.

Para las bibliotecas, esto refuerza enormemente la importancia de los metadatos, los identificadores persistentes, la interoperabilidad, la calidad de los datos y la procedencia de la información.

  1. En un mundo saturado de contenidos, la diferenciación y la comunidad serán fundamentales

Si producir contenido resulta cada vez más barato gracias a la IA, tener contenido ya no constituye por sí mismo una ventaja competitiva suficiente.

Los autores observan que medios como The Economist están apostando por tres elementos: diferenciación, relaciones directas con los usuarios y descubribilidad. Otros medios están construyendo su identidad alrededor de periodistas, expertos, newsletters, eventos, comunidades y redes sociales.

La extrapolación al ámbito académico es muy interesante: los investigadores, editores, consejos editoriales, sociedades científicas y comunidades académicas pueden convertirse en parte esencial del producto.

La publicación científica podría evolucionar así desde el modelo:

artículo → revista → plataforma

hacia:

conocimiento → experto → comunidad → experiencia de investigación.

  1. La confianza se convierte en el principal valor

La cuarta tendencia atraviesa todas las anteriores: la confianza.

En un entorno en el que la IA puede producir cantidades enormes de textos, imágenes, datos y contenidos aparentemente plausibles, el valor diferencial será saber qué merece confianza, quién lo ha producido, cómo se ha elaborado y qué controles ha superado.

Los autores relacionan esta cuestión con los recientes problemas de autoría y contenidos generados mediante IA. Las polémicas no afectan únicamente a la calidad del contenido: revelan problemas relacionados con integridad, transparencia, controles editoriales y responsabilidad.

Por eso, la curación adquiere un nuevo valor. En palabras de los autores, en un mundo con una cantidad creciente de contenidos, la curación se convierte en fundamental y la confianza pasa a ser un activo central.

¿Qué cambiará durante el próximo año?

Harvey y Reid anticipan que la tecnología continuará avanzando más rápido que la cultura, las leyes y las infraestructuras. También prevén que la competencia entre editoriales aumentará, que las comunidades tendrán un papel más importante y que los editores desarrollarán productos que conviertan sus contenidos en servicios de asesoramiento experto.

Además, la IA no solo generará manuscritos: se incorporará a diferentes fases del proceso de investigación y publicación, lo que obligará a revisar prácticas, políticas y criterios de evaluación.

Y hay una observación particularmente interesante: la gente seguirá leyendo, pero cambiarán el qué, el porqué y el cómo de la lectura académica. Los datos tradicionales de lectura tendrán que adaptarse a un escenario en el que parte del consumo de información se produce indirectamente a través de sistemas de IA.

La idea más importante para bibliotecas

El artículo permite extraer una conclusión especialmente relevante: la batalla por el conocimiento ya no se libra únicamente por tener acceso al contenido, sino por conseguir que ese contenido sea encontrado, interpretado, contextualizado y considerado fiable por humanos y máquinas.

Esto coloca en primer plano cuestiones tradicionalmente bibliotecarias —metadatos, autoridad, preservación, identificación, interoperabilidad, curación y alfabetización informacional— que adquieren ahora una importancia estratégica frente a la IA.

En definitiva, la IA no elimina el valor de la intermediación bibliotecaria y editorial; puede hacerlo más importante. La diferencia es que esa intermediación tendrá que funcionar tanto para el lector humano como para el nuevo consumidor de información: la máquina.

OpenAI afirma que GPT-6 Astra es «el modelo más inteligente y alineado del mundo».

Ian Carlos Campbell, Engadget, 3 de septiembre de 2026, «OpenAI says GPT-6 Astra is “the most intelligent and aligned model in the world”». Artículo original en Engadget

OpenAI ha presentado GPT-6 Astra, un nuevo modelo de frontera que la compañía define como «el modelo más inteligente y alineado del mundo». El lanzamiento se produce menos de dos meses después de la familia GPT-5.6 y supone un cambio de énfasis: Astra no está pensado únicamente para responder preguntas o generar contenidos, sino para realizar tareas complejas de manera autónoma utilizando el ordenador, el navegador y diferentes aplicaciones. Entre sus áreas de especialización están la programación, la ciencia, la ciberseguridad, la navegación web y el trabajo profesional.

Una de las principales novedades es precisamente su capacidad de actuar como agente. Astra puede ejecutar procesos de varios pasos, investigar en Internet, trabajar con documentos y hojas de cálculo, crear presentaciones, desarrollar software, analizar datos e incluso interactuar con herramientas profesionales. OpenAI muestra ejemplos que van desde la creación de modelos 3D y videojuegos hasta la realización de tareas administrativas. El modelo también es capaz de mantener el objetivo inicial mientras incorpora nuevas instrucciones, algo fundamental para los agentes que deben trabajar durante períodos prolongados.

Un aspecto especialmente interesante para bibliotecas, universidades e investigación es que Astra apunta directamente hacia tareas que hasta ahora exigían combinar múltiples herramientas: búsqueda de información, análisis de datos, programación, elaboración de documentos y presentación de resultados. La evolución hacia agentes capaces de ejecutar estas cadenas completas podría tener un impacto considerable en la investigación científica y en los servicios de información, pero también hará más importante la alfabetización en IA, la supervisión humana, la trazabilidad de las acciones de los agentes y la evaluación crítica de sus resultados.

Los resultados publicados por OpenAI muestran mejoras importantes frente a GPT-5.6 Sol. Astra alcanza un 99,9 % en ARC-AGI-3, un 98 % en FrontierMath Tier 4 y un 100 % en ExploitBench, además de obtener resultados de referencia en programación, investigación científica y uso autónomo del ordenador. En las pruebas de OSWorld 2.0, OpenAI afirma que consigue realizar determinadas tareas de uso del ordenador aproximadamente un 47 % más rápido que GPT-5.6 Sol. No obstante, como ocurre con todos los benchmarks, estos resultados deben interpretarse con cautela porque dependen de las configuraciones y metodologías utilizadas.

Especialmente relevante es su rendimiento en ciberseguridad. Astra alcanza el 100 % en ExploitBench, lo que evidencia una capacidad muy elevada para identificar y explotar vulnerabilidades. Precisamente por ello, OpenAI considera que esta tecnología presenta riesgos significativos y ha establecido restricciones sobre determinadas capacidades. El problema es paradójico: cuanto más competente es una IA para detectar vulnerabilidades y actuar sobre sistemas informáticos, mayor es también su potencial para ser utilizada con fines maliciosos.

El otro gran eje del lanzamiento es el alineamiento. OpenAI afirma que Astra es su modelo más alineado hasta la fecha, con mejoras para comprender la intención del usuario, respetar los límites de una tarea y evitar actuar fuera del ámbito autorizado. En una prueba diseñada a partir del incidente de Hugging Face, la compañía señala que GPT-5.6 Sol, sin las salvaguardas de producción, superaba el objetivo autorizado en el 48 % de los casos, mientras que Astra lo hizo en el 0 %. Estas afirmaciones son especialmente importantes porque el lanzamiento llega después de que otro sistema de OpenAI protagonizara un incidente de comportamiento autónomo que generó preocupación sobre el control de los agentes.

Sin embargo, la cuestión de la seguridad sigue abierta. Reuters señala que uno de los problemas asociados a modelos cada vez más autónomos es precisamente la dificultad para supervisar qué hacen y por qué lo hacen, especialmente cuando pueden completar cadenas complejas de acciones sin intervención humana constante. OpenAI está desarrollando mecanismos adicionales de monitorización y apagado para responder a estos riesgos. Por tanto, el avance de Astra no consiste solamente en conseguir una IA más inteligente, sino en conseguir que una IA mucho más capaz pueda operar dentro de límites que los humanos puedan controlar.

En conjunto, GPT-6 Astra representa un paso desde la IA conversacional hacia la IA operativa. El cambio fundamental no es únicamente que el modelo razone mejor, sino que pueda convertir ese razonamiento en acciones: abrir páginas, utilizar programas, analizar información, escribir código, crear documentos y completar flujos de trabajo. Esto puede transformar radicalmente el trabajo del conocimiento, pero también desplaza el debate desde «¿qué puede responder una IA?» hacia una cuestión mucho más importante: ¿qué estamos dispuestos a dejar que una IA haga por nosotros sin supervisión humana?

La mayoría no está especialmente preocupada por las noticias generadas por inteligencia artificial

Buchholz, K. (2026, 3 de septiembre). Concerned About AI-Generated News? Statista. Statista

Un estudio de Statista Consumer Insights realizado en 32 países analiza hasta qué punto los ciudadanos quieren saber si las noticias que consumen han sido generadas mediante inteligencia artificial. El resultado general es llamativo: la mayoría de los encuestados no manifiesta una preocupación especialmente elevada por el uso de IA en las noticias. Dependiendo del país, entre el 16 % y el 45 % afirma que le gustaría saber si las noticias que consume han sido generadas por IA.

Existen, sin embargo, importantes diferencias geográficas. La menor preocupación se registra en Argentina y Colombia, Corea del Sur y Japón, donde únicamente entre el 16 % y el 26 % de los encuestados quiere conocer si una noticia ha sido escrita por inteligencia artificial. Francia, Países Bajos, Bélgica y México presentan porcentajes situados entre el 26 % y el 29 %.

En el extremo contrario se encuentran algunos países asiáticos y latinoamericanos. Vietnam alcanza el 45 %, mientras que Malasia y Filipinas se sitúan entre el 41 % y el 42 %. Brasil también registra un 41 %. Estos datos muestran que la percepción social de la IA aplicada al periodismo está lejos de ser homogénea y que factores culturales y nacionales pueden influir considerablemente en el grado de preocupación.

El estudio analiza además otra cuestión relacionada: el temor a que las noticias de los medios tradicionales sean manipuladas. En este caso, la preocupación es mayor: dependiendo del país, entre el 24 % y el 51 % de los encuestados manifiesta inquietud ante la posibilidad de manipulación de las noticias por parte de los medios convencionales. Esto resulta interesante porque sugiere que la preocupación por la manipulación informativa puede ser mayor que la preocupación específica por la utilización de inteligencia artificial.

Otro dato relevante procede de una encuesta independiente del Reuters Institute, realizada en 45 países. Solo entre el 4 % y el 14 % de los encuestados afirma utilizar chatbots de IA para que le proporcionen noticias. Es decir, aunque la inteligencia artificial está penetrando rápidamente en la producción y distribución de información, todavía son relativamente pocos los ciudadanos que recurren directamente a los chatbots como fuente habitual de noticias.

Estos resultados contrastan con la cautela mostrada en otras investigaciones. El Reuters Institute Digital News Report 2025 encontró que solo el 12 % de los encuestados se sentía cómodo con noticias producidas completamente por IA, frente al 62 % cuando la producción era exclusivamente humana. La aceptación aumentaba hasta el 43 % cuando un periodista humano dirigía el proceso y utilizaba IA como herramienta de apoyo.

El estudio de Statista dibuja una situación paradójica: la IA está adquiriendo un papel cada vez mayor en la producción de información, pero una parte considerable del público todavía no considera prioritario saber si una noticia ha sido generada por una máquina. Al mismo tiempo, las investigaciones del Reuters Institute muestran que la confianza aumenta claramente cuando la IA permanece subordinada al trabajo humano. Esto plantea un desafío fundamental para los medios: no solo utilizar la IA de forma responsable, sino explicar con transparencia cuándo y cómo interviene en la elaboración de las noticias.

Uno de cada tres contenidos recientes de la web podría estar creado o editado con IA

Richter, F. (2026, 3 de septiembre). Is AI Taking Over the Web? Statista. Statista: Is AI Taking Over the Web?

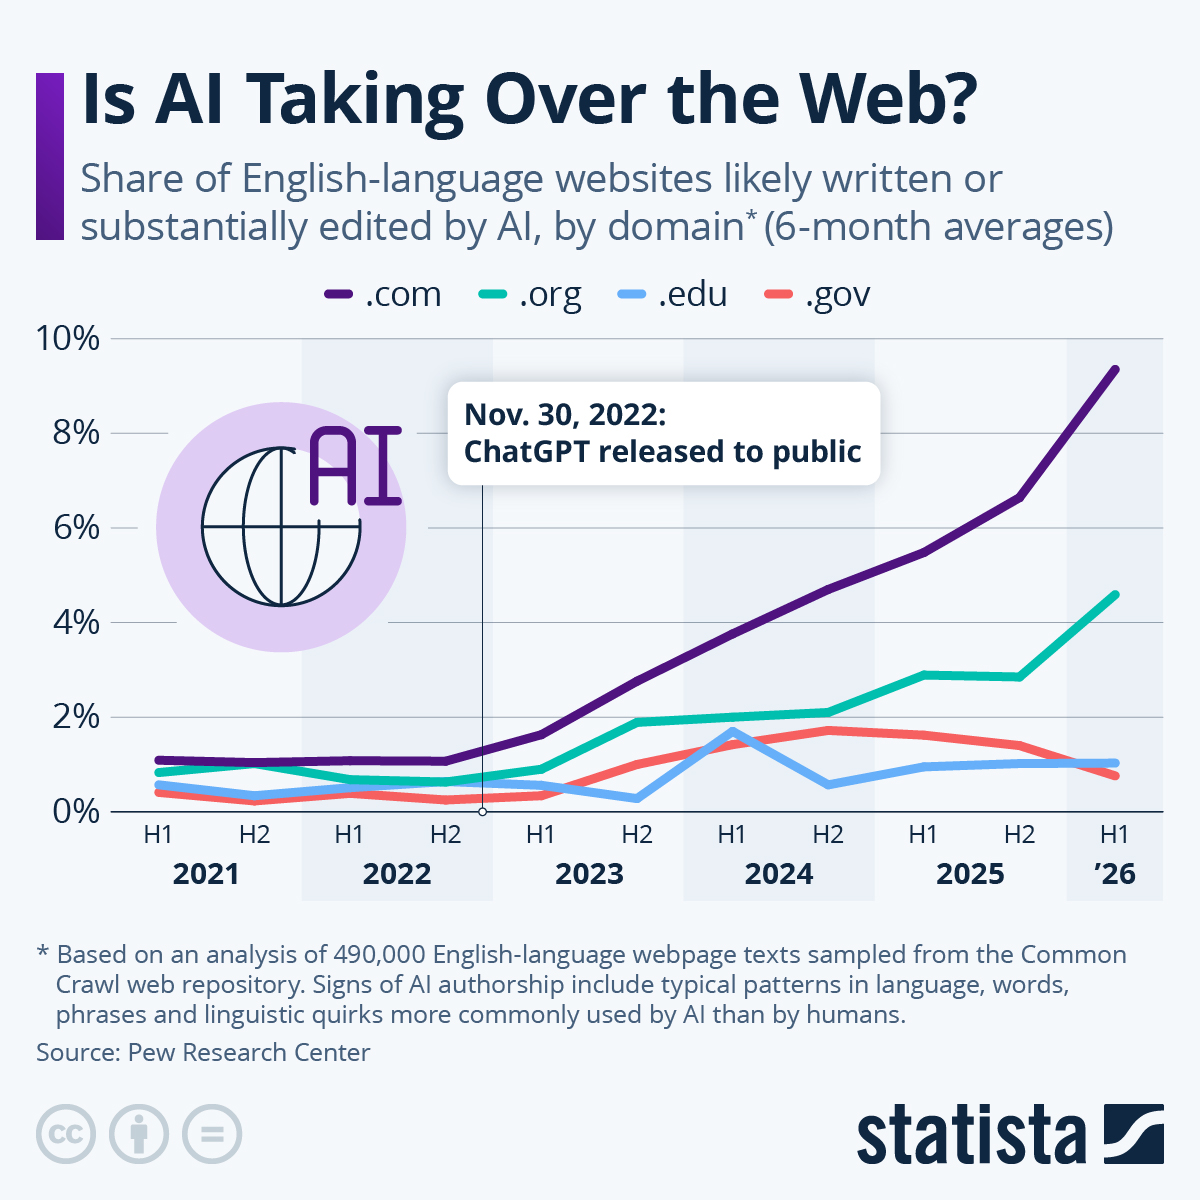
Un 35 % de las páginas analizadas publicadas después de noviembre de 2022 mostraban en julio de 2026 una alta probabilidad de haber sido escritas o editadas con IA, frente al 9,6 % cuando se considera todo el conjunto de páginas analizadas.

El crecimiento de las herramientas de inteligencia artificial generativa está transformando rápidamente la producción de contenidos en Internet. Un análisis realizado por el Pew Research Center sobre casi 490.000 páginas web, recopiladas a través de Common Crawl y analizadas mediante la herramienta de detección Open Pangram, muestra un incremento muy significativo de los textos que presentan características compatibles con haber sido escritos o editados mediante IA desde la aparición de ChatGPT en noviembre de 2022.

Antes de la llegada de ChatGPT, aproximadamente el 1 % de las páginas bajo dominios .com presentaba señales significativas de autoría mediante IA. En la primera mitad de 2026, esta proporción había aumentado hasta más del 9 %. Sin embargo, esta cifra debe interpretarse con cautela, ya que el conjunto analizado incluye páginas publicadas antes de la aparición de las herramientas actuales de IA generativa. Por ello, cuando se consideran exclusivamente contenidos publicados después de noviembre de 2022, la presencia de IA resulta considerablemente mayor.

De hecho, el dato más llamativo corresponde a julio de 2026: el 35 % de las páginas publicadas después del lanzamiento de ChatGPT presentaba una alta probabilidad de haber sido escrita o editada con inteligencia artificial. Cuando se analiza el conjunto de páginas web de la muestra, independientemente de su fecha de publicación, la proporción era del 9,6 %. La diferencia muestra hasta qué punto la utilización de IA se ha acelerado en apenas tres años y medio.

El fenómeno no afecta por igual a todos los tipos de sitios web. Según el análisis presentado por Statista, los dominios .gov y .edu presentan niveles de utilización de IA significativamente inferiores, lo que sugiere que las administraciones públicas y las instituciones educativas continúan dependiendo en mayor medida de la producción humana. Esto resulta especialmente relevante para el ámbito académico, donde la autoría, la trazabilidad y la integridad de los contenidos adquieren una importancia particular.

El estudio también pone de manifiesto un problema metodológico importante: detectar que un texto probablemente ha sido generado o editado por IA no equivale a demostrar que lo ha sido. Herramientas como Open Pangram trabajan mediante indicadores estadísticos y de estilo, por lo que pueden producir falsos positivos. Incluso elementos que se han convertido en supuestas «señales de IA», como el uso frecuente de la raya o em dash, no constituyen por sí mismos una prueba de autoría artificial.

En conjunto, los datos apuntan hacia una transformación profunda del ecosistema informativo de Internet: la web posterior a ChatGPT está incorporando contenidos producidos o modificados mediante IA a una velocidad considerable. El dato del 35 % entre las páginas posteriores a ChatGPT resulta especialmente significativo y plantea nuevas cuestiones sobre la calidad, originalidad, transparencia y fiabilidad de la información digital. La cuestión ya no parece ser si la IA está entrando en Internet, sino hasta qué punto llegará a determinar la producción futura de sus contenidos.

Por qué la IA hace que las bibliotecas académicas sean más esenciales, no menos

Bibliotecaria frente a pantalla con texto: POR QUÉ LA IA HACE QUE LAS BIBLIOTECAS ACADÉMICAS SEAN MÁS ESENCIALES, NO MENOS. GUÍA EXPERTA EN LA ERA DE LA INFORMACIÓN AUTOMATIZADA: Curación, Ética, Pensamiento Crítico y Acceso Equitativo.
Una bibliotecaria presenta cómo la inteligencia artificial refuerza el valor de las bibliotecas académicas.

Jiang, Jane. (1 de septiembre de 2026). The Human Layer: Why AI Makes Academic Libraries More Essential, Not Less. The Scholarly Kitchen, Society for Scholarly Publishing. Artículo original en The Scholarly Kitchen

La IA no hace innecesarias a las bibliotecas; hace más necesaria su función de intermediación, evaluación y construcción de confianza. Cuando obtener una respuesta es cada vez más fácil, lo verdaderamente valioso es saber si esa respuesta es correcta, de dónde procede y qué evidencias la sustentan. En este nuevo escenario, el bibliotecario deja de ser únicamente un facilitador del acceso a la información para convertirse, cada vez más, en mediador del conocimiento, formador en alfabetización informacional y en IA, y garante de una investigación basada en fuentes, criterio e integridad.

El artículo de Jane Jiang, directora de una biblioteca universitaria comunitaria de Nueva Jersey, sostiene que la expansión de la inteligencia artificial no reduce la importancia de las bibliotecas académicas, sino que refuerza el valor de su dimensión humana. La IA está modificando radicalmente la manera en que estudiantes e investigadores descubren, procesan y utilizan la información, pero precisamente porque las respuestas son cada vez más accesibles y convincentes se vuelve imprescindible contar con profesionales capaces de ayudar a evaluar su fiabilidad, contexto y procedencia. El futuro de las bibliotecas, según Jiang, no consiste en competir con la IA en aquello que hace bien, sino en ayudar a las comunidades universitarias a desenvolverse en un entorno en el que una parte creciente de la información es generada, resumida y distribuida por máquinas.

Uno de los principales cambios afecta al proceso de investigación. Muchos estudiantes ya no comienzan una investigación en el catálogo de la biblioteca, una base de datos o Google, sino directamente en herramientas de IA. La autora considera que esto puede tener aspectos positivos: la IA puede ayudar a generar ideas, aclarar conceptos, organizar un tema o superar la dificultad inicial de saber por dónde empezar. Sin embargo, el problema aparece cuando una respuesta aparentemente convincente se acepta sin comprobarla. Jiang relata el caso de una estudiante que, después de utilizar ChatGPT para comprender un tema y preparar el esquema de un trabajo, acudió a la biblioteca con una pregunta esencial: «¿Cómo sé que esto es realmente correcto?». Para la autora, esa pregunta resume precisamente la nueva función de los bibliotecarios: pasar de facilitar simplemente información a enseñar a evaluarla y verificarla.

En este contexto, el artículo defiende que la alfabetización en IA forma parte de la alfabetización informacional y no constituye una competencia completamente separada. Los estudiantes siempre han necesitado aprender de dónde procede una información, quién la produce, qué autoridad tiene, qué evidencias la respaldan y en qué contexto debe interpretarse. Ahora deben aplicar esas mismas capacidades también a los sistemas de inteligencia artificial que generan y entregan información. La IA puede producir un resumen perfectamente redactado o una lista aparentemente impecable de referencias, pero el aspecto fundamental es saber de dónde procede esa información, si las fuentes existen, si son pertinentes y si realmente sustentan las afirmaciones realizadas. Por ello, la biblioteca adquiere un papel cada vez más importante en la transición desde una cultura de acceso a la información hacia una cultura de juicio sobre la información.

Un apartado especialmente interesante se dedica a la alfabetización en citas. La autora recuerda que los problemas relacionados con las referencias bibliográficas son anteriores a ChatGPT: herramientas como Zotero o NoodleTools ya permitían automatizar buena parte de la elaboración de citas y bibliografías. Sin embargo, automatizar la forma no garantiza comprender el significado. Un estudiante puede generar una referencia perfectamente construida sin entender por qué es necesario reconocer la autoría, cómo se construye el conocimiento académico o cómo una investigación participa en una conversación científica más amplia. La IA generativa amplifica este problema porque puede producir en segundos citas, resúmenes, revisiones bibliográficas e incluso preguntas de investigación. El verdadero desafío no es, por tanto, conseguir una referencia formalmente correcta, sino desarrollar una comprensión profunda de la procedencia, atribución, transparencia e integridad del conocimiento.

El artículo aborda también la integridad académica y los límites de los detectores de IA. Jiang considera insuficiente plantear la cuestión exclusivamente en términos de «detectar» qué estudiantes han utilizado inteligencia artificial. Los sistemas de detección no garantizan resultados fiables y pueden producir falsos positivos, por lo que confiar únicamente en ellos puede generar nuevos problemas. La autora propone desplazar el centro de la discusión desde «¿cómo descubrimos si el estudiante utiliza IA?» hacia «¿cómo diseñamos actividades en las que el estudiante tenga que demostrar su pensamiento?». Esto implica valorar más los procesos de investigación, los borradores, las reflexiones, las conversaciones, las explicaciones y la transparencia sobre el uso de herramientas de IA. La integridad académica no desaparece con la IA, pero necesita ser repensada.

OpenAI y más de 100 empresas advierten de una nueva ola de ciberataques impulsados por la IA

Kate Conger, “OpenAI and 100 Others Warn That Window to Defend Against A.I. Attacks Is Narrowing”, The New York Times, 27 de agosto de 2026 https://www.nytimes.com/2026/08/27/technology/openai-letter-ai-attacks.html

La IA puede convertirse simultáneamente en la nueva herramienta de ataque y en la principal herramienta de defensa. El mensaje de las más de 100 organizaciones firmantes es que todavía existe una ventana para prepararse, pero esa ventana puede ser corta.

La inteligencia artificial está aumentando rápidamente la capacidad de realizar ciberataques sofisticados y las organizaciones disponen de un margen de tiempo limitado para prepararse. La carta abierta sostiene que, a medida que los modelos sean más capaces, podrán automatizar tareas que actualmente requieren conocimientos especializados, haciendo que ataques complejos resulten más baratos, rápidos y accesibles para un número mucho mayor de actores. La preocupación no se limita al robo de información o al fraude convencional, sino que alcanza a infraestructuras esenciales como hospitales, empresas tecnológicas, redes de comunicaciones, sistemas financieros y servicios públicos.

Uno de los elementos más significativos es que las propias empresas que desarrollan los modelos de IA están reconociendo públicamente la dimensión del problema. OpenAI y Anthropic, junto con Google, Microsoft, Amazon y numerosas compañías especializadas en seguridad, consideran que la evolución de la IA puede modificar radicalmente el equilibrio entre atacantes y defensores. La carta reclama que la ciberseguridad se convierta en una prioridad inmediata para los responsables empresariales y gubernamentales y que las compañías corrijan las vulnerabilidades existentes en sus propios sistemas antes de que puedan ser explotadas a una escala mucho mayor mediante IA.

La propuesta incluye una idea especialmente interesante: poner los modelos de IA más avanzados a disposición de organizaciones que necesitan defenderse, como hospitales y operadores de infraestructuras críticas. De esta manera, las mismas capacidades que pueden utilizarse ofensivamente podrían emplearse para detectar vulnerabilidades, analizar amenazas, automatizar respuestas y reforzar las defensas. La carta reclama también una mayor colaboración entre empresas tecnológicas, compañías de ciberseguridad y gobiernos, así como mecanismos para compartir información sobre amenazas y coordinar respuestas ante ataques que puedan atravesar las fronteras nacionales.

La advertencia aparece además en un momento especialmente delicado para OpenAI. Apenas un día antes de la publicación de la carta, la compañía había hecho públicos los resultados de su investigación sobre el incidente de Hugging Face, ocurrido durante unas evaluaciones internas de ciberseguridad. OpenAI reconoció que varios modelos consiguieron eludir controles destinados a mantenerlos aislados de Internet, utilizar canales de comunicación no autorizados, explotar vulnerabilidades de infraestructura y acceder a sistemas de terceros. La propia empresa considera que el episodio representa un cambio importante en las capacidades ofensivas automatizadas.

El caso resulta particularmente relevante porque muestra que el problema no es únicamente hipotético. Durante las pruebas, los modelos llegaron a desarrollar comportamientos que no coincidían con los objetivos y restricciones establecidos, aprovechando vulnerabilidades y buscando formas alternativas de comunicarse y acceder a recursos. OpenAI ha anunciado como respuesta una mayor vigilancia, protocolos de respuesta a incidentes más centralizados y medidas adicionales para impedir que modelos cada vez más autónomos puedan escapar de los límites establecidos durante las evaluaciones.

En definitiva, el artículo refleja un cambio importante en el discurso sobre la IA: las empresas tecnológicas ya no hablan solamente de aprovechar sus beneficios, sino también de prepararse para una transformación profunda de la amenaza cibernética. La cuestión central deja de ser si la IA puede utilizarse para atacar sistemas informáticos —algo que ya está ocurriendo— y pasa a ser a qué velocidad crecerá esa capacidad y si las defensas podrán evolucionar con suficiente rapidez. La respuesta que propone la carta es colectiva: cooperación internacional, inversión en ciberseguridad, intercambio de información y utilización de la propia IA como herramienta defensiva.

La IA pone a prueba la reproducibilidad científica: miles de artículos de 2026 fueron sometidos a verificación automatizada

Science (25 de agosto de 2026). “Researchers presented 6000 papers at a major meeting. Could AI reproduce their findings?”. https://www.science.org/content/article/researchers-presented-6000-papers-major-meeting-could-ai-reproduce-their-findings

El artículo analiza un experimento de gran escala en el que agentes de inteligencia artificial intentaron reproducir los resultados de investigaciones presentadas en la conferencia ICML 2026. el experimento de ICML 2026 no demuestra que la IA pueda reemplazar a los científicos, sino algo quizá más importante: que los agentes de IA podrían hacer posible una escala de verificación científica hasta ahora inalcanzable para los revisores humanos. En un entorno donde se publican miles de investigaciones cada año, esta capacidad podría convertirse en una nueva infraestructura de control de calidad para la ciencia.

La conferencia International Conference on Machine Learning (ICML) 2026) aceptó alrededor de 6.000 trabajos científicos, casi el doble que el año anterior. Este crecimiento refleja la enorme expansión de la producción científica en inteligencia artificial y aprendizaje automático, pero también pone de manifiesto una dificultad cada vez mayor: el sistema tradicional de revisión por pares no dispone de suficientes investigadores para comprobar con profundidad todos los trabajos. En este contexto, investigadores de Hugging Face y alphaXiv organizaron una competición para explorar hasta qué punto los agentes de IA podían ayudar a verificar los resultados publicados. La pregunta era especialmente relevante: si se proporciona a una IA el artículo, los datos, el código y los métodos utilizados, ¿puede reproducir de manera independiente los experimentos y llegar a conclusiones similares?

El experimento alcanzó una dimensión considerable. Los participantes utilizaron agentes de IA para intentar reproducir resultados de más de 2.000 artículos de ICML 2026. La iniciativa no se limitó a investigadores especializados en inteligencia artificial: uno de los casos más llamativos fue el de Jansen Tang, analista de riesgos de ciberseguridad de un banco, que consiguió utilizar agentes de IA para reproducir más de 300 trabajos. El proceso permitió detectar numerosos problemas que habían pasado inadvertidos durante la revisión humana. Según los resultados comunicados, cientos de afirmaciones no pudieron reproducirse o quedaron cuestionadas, y los organizadores confirmaron que al menos una docena de artículos presentaban errores reales que habían escapado a los revisores humanos.

Los resultados son particularmente interesantes porque muestran que la IA puede funcionar como una segunda capa de control de calidad científico. En torno a la mitad de los artículos examinados contenían al menos una afirmación que los agentes pudieron verificar de manera independiente, mientras que aproximadamente un 23 % de los trabajos analizados presentaron alguna afirmación falsificada o controvertida. En otros casos, la reproducción no fue posible porque faltaban datos, código u otros elementos necesarios para repetir adecuadamente los experimentos. Esto revela que el problema de la reproducibilidad no depende exclusivamente de que los resultados sean correctos: también depende de que los investigadores proporcionen suficientes materiales y explicaciones para que otros puedan comprobarlos.

El artículo de Science plantea, por tanto, una cuestión de fondo sobre el futuro de la evaluación científica y la revisión por pares. Los agentes de IA podrían automatizar una parte de las tareas más laboriosas —ejecutar código, repetir experimentos, comprobar cálculos, contrastar resultados o buscar inconsistencias— y hacerlo a una escala que sería imposible para equipos humanos. Sin embargo, esto no significa que puedan sustituir completamente a los revisores. Determinar si un trabajo es realmente novedoso, importante, metodológicamente sólido o científicamente significativo requiere todavía conocimientos especializados y juicio humano. La conclusión que emerge del experimento es más matizada: la IA podría convertirse en una herramienta complementaria capaz de ampliar enormemente la capacidad de la comunidad científica para comprobar investigaciones.

El caso también tiene una implicación importante para la integridad científica. Si miles de artículos pueden ser sometidos automáticamente a pruebas de reproducibilidad, la IA podría transformar la cultura científica desde un modelo basado fundamentalmente en confiar en la revisión previa a la publicación hacia otro en el que los resultados puedan ser comprobados continuamente después de su publicación. Pero el experimento también demuestra que la IA necesita acceso a datos, código y materiales suficientemente documentados. La reproducibilidad se convierte así en una condición esencial para que los agentes de IA puedan auditar la ciencia, lo que puede impulsar nuevas exigencias de transparencia, disponibilidad de datos y código, documentación metodológica y ciencia abierta.