El informe analiza de forma empírica cómo la inteligencia artificial está transformando los flujos de trabajo en bibliotecas académicas, especialmente en dos áreas críticas: la creación y gestión de metadatos (mediante Alma Metadata Assistant) y el apoyo a la elaboración de guías docentes y listas de lectura (a través de Leganto Syllabus Assistant). El estudio se basa en entrevistas en profundidad con profesionales de 11 instituciones académicas internacionales, lo que permite observar efectos reales de la IA en contextos de trabajo cotidianos, más allá de la teoría o la experimentación tecnológica.
Uno de los hallazgos centrales es la reducción significativa del tiempo dedicado a tareas manuales y repetitivas. Las bibliotecas participantes reportan una disminución de entre el 30% y el 60% en tareas como la transcripción de metadatos, la normalización de registros o el procesamiento inicial de listas de lectura. Este cambio no solo acelera los procesos, sino que también incrementa la capacidad operativa sin necesidad de ampliar los recursos humanos, llegando a multiplicar por dos o cuatro la productividad en determinados flujos de trabajo.
El informe subraya también una mejora notable en la consistencia y estandarización de los datos bibliográficos. La IA permite reducir la variabilidad derivada de la diversidad de fuentes y formatos de entrada, generando registros más homogéneos y preparados para su validación profesional. En este sentido, la tecnología no sustituye el juicio experto del personal bibliotecario, sino que desplaza su actividad hacia tareas de mayor valor añadido, como la revisión crítica, la validación de excepciones o la toma de decisiones complejas.
Otro aspecto relevante es la aceleración del ciclo de trabajo entre la recepción de información y su disponibilidad para los usuarios. El estudio indica que entre el 50% y el 60% de las listas de lectura procesadas con herramientas de IA pueden estar disponibles de forma casi inmediata tras el procesamiento inicial, reduciendo significativamente los cuellos de botella tradicionales en los servicios bibliotecarios.
Desde una perspectiva organizativa, el informe interpreta estos cambios como un proceso de reconfiguración del trabajo bibliotecario. La IA desplaza parte del esfuerzo desde tareas operativas hacia funciones de supervisión, análisis y mejora de la calidad de los datos. Esto implica una transformación del perfil profesional, en la que las competencias críticas, la curación de información y la supervisión de sistemas automatizados adquieren mayor relevancia que la producción manual de registros.
En conjunto, el estudio concluye que la adopción de IA en bibliotecas académicas no constituye únicamente una mejora incremental de eficiencia, sino una reestructuración progresiva de los flujos de trabajo, con impacto directo en la productividad, la calidad de los datos y la redistribución de las funciones del personal. Esta transformación se enmarca en una tendencia más amplia de integración de la IA en los sistemas académicos y de investigación, donde las herramientas inteligentes pasan a formar parte de la infraestructura operativa de las instituciones.
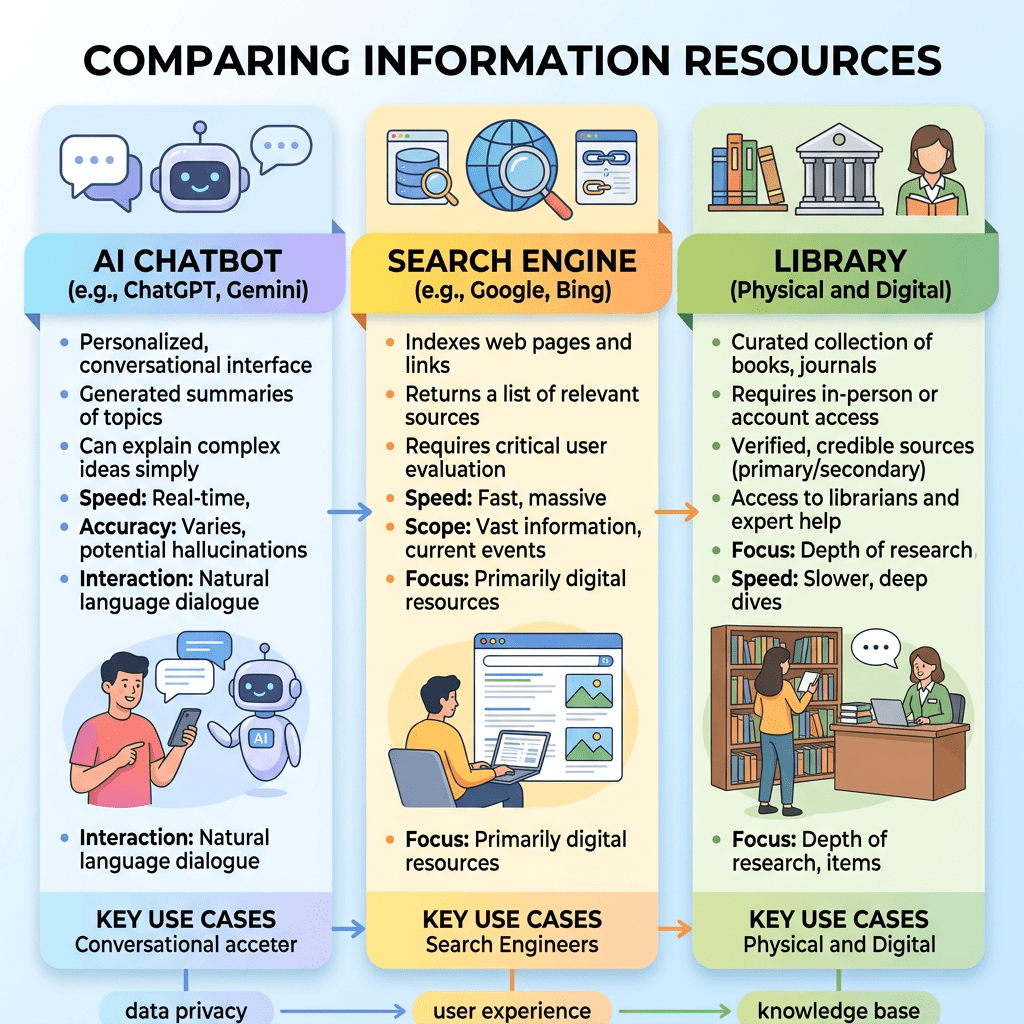
An infographic comparing AI chatbots, search engines, and libraries as information resources.
Lund, Brady D., Zoe Abbie Teel, Ting Wang, et al. “Artificial Intelligence (AI) and Information Seeking: A Comparative Exploration of AI Chatbots, Search Engines, and Library Resources as Information Sources among University Students.” Journal of Librarianship and Information Science (OnlineFirst, 2026). https://doi.org/10.1177/09610006261438484
El artículo retrata un momento de transición en el ecosistema informativo universitario. La IA no ha desplazado a Google ni a las bibliotecas, pero ya se ha incorporado de forma visible a las rutinas académicas. Su papel es complementario, aunque en expansión, especialmente entre estudiantes jóvenes e internacionales. Para las bibliotecas y universidades, el reto no consiste en resistirse al cambio, sino en liderarlo: integrar la IA de forma ética, crítica y conectada con recursos académicos de calidad.
Este estudio analiza cómo los estudiantes universitarios de Estados Unidos están integrando la inteligencia artificial generativa en sus prácticas de búsqueda académica. A partir de una encuesta electrónica respondida por 236 estudiantes de perfiles diversos, los autores comparan el uso, preferencia y satisfacción con tres grandes fuentes de información: motores de búsqueda tradicionales (como Google), recursos bibliotecarios universitarios y herramientas de IA conversacional como ChatGPT. El trabajo parte de la idea de que la irrupción de la IA está modificando profundamente la ecología informacional en la educación superior, alterando la manera en que los estudiantes localizan, evalúan y utilizan información.
Los resultados muestran que los motores de búsqueda siguen siendo la herramienta dominante para tareas académicas, tanto por frecuencia de uso como por preferencia inicial al comenzar una investigación. Casi la mitad de los estudiantes indicaron que Google o buscadores similares son su primera opción, mientras que el resto se divide entre los recursos de biblioteca y la IA. Sin embargo, la IA ya ocupa un lugar significativo: solo un 15% declaró no haberla usado nunca para fines académicos, mientras que cerca del 10% la utiliza diariamente. Esto indica que la IA no ha sustituido aún a las herramientas tradicionales, pero sí se ha convertido en una pieza estable del repertorio informacional estudiantil.
Uno de los hallazgos más relevantes es la existencia de diferencias demográficas marcadas. Los estudiantes más jóvenes muestran mayor inclinación hacia la IA como punto de partida en sus búsquedas, mientras que los mayores prefieren claramente las páginas web de bibliotecas universitarias. Asimismo, los estudiantes internacionales utilizan la IA con mucha mayor frecuencia que los estudiantes nacionales estadounidenses. De hecho, recurren menos a los recursos bibliotecarios y más a herramientas de IA, lo que los autores interpretan como posible consecuencia de barreras idiomáticas, desconocimiento del entorno bibliotecario estadounidense o búsqueda de interfaces más accesibles y conversacionales.
En cuanto a la percepción de calidad, los buscadores tradicionales siguen obteniendo mejores puntuaciones globales que la IA en relevancia y satisfacción de resultados. Los estudiantes consideran especialmente eficaces a los buscadores para noticias recientes, meteorología e información laboral. En cambio, la IA obtiene valoraciones más competitivas cuando se trata de ayuda académica, preparación de exámenes, comprensión inicial de un tema o generación de instrucciones para realizar tareas. Esto sugiere que los usuarios perciben fortalezas diferenciadas: el buscador como herramienta de acceso a fuentes actualizadas y múltiples perspectivas, y la IA como asistente para sintetizar, orientar o explicar.
El estudio también demuestra una relación clara entre uso frecuente y satisfacción con la IA. Cuanto más emplea un estudiante estas herramientas, mayor es su percepción de utilidad. Los usuarios intensivos valoran especialmente la IA para tareas educativas, estudio y resolución de procedimientos. Esto puede indicar un aprendizaje progresivo del uso eficaz de la herramienta o una adaptación de expectativas a sus capacidades reales. Los autores advierten, no obstante, que esta relación también podría fomentar dependencia acrítica si los estudiantes aceptan respuestas sintéticas sin contrastarlas con fuentes primarias.
Desde la perspectiva bibliotecaria, el artículo plantea implicaciones estratégicas de gran interés. Las bibliotecas universitarias no deberían contemplar la IA únicamente como una amenaza competitiva, sino como una oportunidad para rediseñar sus servicios. Proponen desarrollar sistemas de descubrimiento apoyados en IA conectados directamente con colecciones licenciadas, bases de datos y contenidos académicos fiables. De este modo, las bibliotecas podrían ofrecer experiencias conversacionales semejantes a ChatGPT, pero sustentadas en recursos evaluados y legales. También subrayan la necesidad urgente de programas de alfabetización informacional y alfabetización en IA, enseñando a los estudiantes a verificar respuestas, identificar sesgos, contrastar perspectivas y comprender límites de los modelos generativos.
Los autores reconocen algunas limitaciones metodológicas. La muestra estaba sobrerrepresentada por estudiantes de posgrado, internacionales y vinculados a ciencias de la computación e información, lo que puede inflar los niveles generales de adopción tecnológica. Además, el estudio se basa en autoinformes y no en observación directa del comportamiento real. Por ello recomiendan investigaciones futuras con muestras más representativas, entrevistas cualitativas y estudios experimentales que analicen cómo los estudiantes combinan IA, buscadores y biblioteca ante necesidades concretas de información.
Apéndice. Encuesta sobre IA y búsqueda de información
1. ¿Cuál de las siguientes opciones describe mejor tu especialidad académica? a. Artes – bellas artes, música, danza, fotografía b. Humanidades – filosofía, historia, literatura, lenguas c. Ciencias Sociales – psicología, sociología, economía, educación, biblioteconomía d. Ciencias Naturales – biología, química, matemáticas, ecología, ingeniería e. Ciencias de la Computación – informática, ciencia de la información, ciencia de datos, IA f. Empresa – administración, hostelería, sistemas y ciencias de la decisión, marketing
2. ¿Cuál es tu nivel académico actual? a. Estudiante de grado b. Estudiante de máster c. Estudiante de doctorado
3. ¿Cuál es tu edad? a. 18–25 b. 26–30 c. 31–35 d. 36 o más
4. ¿Cuál es tu género? a. Mujer b. Hombre c. No binario d. Otro
5. ¿Cuál describe mejor tu situación como estudiante? a. Estudiante nacional b. Estudiante internacional
6. Pensando específicamente en tus actividades académicas y/o experiencias de investigación, indica con qué frecuencia utilizas cada una de las siguientes fuentes de información (nunca, menos de una vez al mes, mensualmente, semanalmente, diariamente): a. Libros b. Revistas científicas c. Actas de congresos d. Recursos web e. Bases de datos bibliotecarias f. Comunicaciones personales g. Herramientas de IA generativa
7. Pensando específicamente en tus actividades académicas y/o experiencias de investigación, ¿qué grado de confianza tienes en que encuentras toda la información necesaria sobre un tema cuando utilizas los siguientes recursos? (nada confiado, poco confiado, neutral, bastante confiado, muy confiado): a. Libros b. Revistas científicas c. Actas de congresos d. Recursos web e. Bases de datos bibliotecarias f. Comunicaciones personales g. Herramientas de IA generativa
8. ¿Cuál de las siguientes interfaces preferirías utilizar al comenzar tu búsqueda de información? a. Página principal de la biblioteca b. Google/motor de búsqueda c. Chatbot de IA/modelo de lenguaje grande
9. ¿Cuántas veces has realizado las siguientes actividades durante el último mes? a. Visitado la biblioteca universitaria, utilizado la web de la biblioteca o accedido a recursos bibliotecarios mediante enlaces web. b. Utilizado Google u otro motor de búsqueda similar para actividades o tareas universitarias. c. Utilizado una herramienta de IA para actividades o tareas universitarias.
10. Al realizar una tarea concreta de búsqueda de información relacionada con estudios o investigación, ¿con qué frecuencia recurres a los siguientes enfoques? (nunca, raramente, a veces, a menudo, siempre): a. Utilizar solo un motor de búsqueda tradicional b. Utilizar solo un chatbot de IA/ChatGPT c. Primero utilizar un motor de búsqueda tradicional y después un chatbot de IA/ChatGPT d. Primero utilizar un chatbot de IA/ChatGPT y después un motor de búsqueda tradicional
11. Pensando en la información que buscas en tu vida diaria, ¿qué probabilidad hay de que uses un motor de búsqueda tradicional para lo siguiente? (muy improbable, algo improbable, ni probable ni improbable, algo probable, muy probable): a. Encontrar información relacionada con empleo b. Encontrar información relacionada con estudios c. Aprender más sobre un tema que estudias d. Consultar el tiempo e. Ponerte al día con noticias recientes f. Crear chistes o historias g. Crear un conjunto de instrucciones para completar una tarea
12. Pensando en la información que buscas en tu vida diaria, ¿qué probabilidad hay de que uses chatbots de IA/ChatGPT para lo siguiente? (muy improbable, algo improbable, ni probable ni improbable, algo probable, muy probable): a. Encontrar información relacionada con empleo b. Encontrar información relacionada con estudios c. Aprender más sobre un tema que estudias d. Consultar el tiempo e. Ponerte al día con noticias recientes f. Crear chistes o historias g. Crear un conjunto de instrucciones para completar una tarea
13. Cuando buscas cada uno de los siguientes tipos de información, ¿con qué frecuencia un motor de búsqueda es capaz de generar una respuesta relevante? Nota: relevante significa únicamente que proporciona información pertinente sobre el tema, no necesariamente que sea exacta o satisfactoria para ti. (nunca, no muy a menudo, con cierta frecuencia, muy a menudo, siempre): a. Encontrar información relacionada con empleo b. Encontrar información relacionada con estudios c. Aprender más sobre un tema que estudias d. Consultar el tiempo e. Ponerte al día con noticias recientes f. Crear chistes o historias g. Crear un conjunto de instrucciones para completar una tarea
14. Cuando buscas cada uno de los siguientes tipos de información, ¿con qué frecuencia un chatbot de IA/ChatGPT es capaz de generar una respuesta relevante? Nota: relevante significa únicamente que proporciona información pertinente sobre el tema, no necesariamente que sea exacta o satisfactoria para ti. (nunca, no muy a menudo, con cierta frecuencia, muy a menudo, siempre): a. Encontrar información relacionada con empleo b. Encontrar información relacionada con estudios c. Aprender más sobre un tema que estudias d. Consultar el tiempo e. Ponerte al día con noticias recientes f. Crear chistes o historias g. Crear un conjunto de instrucciones para completar una tarea
15. Cuando buscas cada uno de los siguientes tipos de información, ¿con qué frecuencia un motor de búsqueda tradicional es capaz de generar una respuesta satisfactoria? Nota: una respuesta satisfactoria es aquella que cubre completamente la información que necesitas y con la que quedas satisfecho/a. (nunca, no muy a menudo, con cierta frecuencia, muy a menudo, siempre): a. Encontrar información relacionada con empleo b. Encontrar información relacionada con estudios c. Aprender más sobre un tema que estudias d. Consultar el tiempo e. Ponerte al día con noticias recientes f. Crear chistes o historias g. Crear un conjunto de instrucciones para completar una tarea
16. Cuando buscas cada uno de los siguientes tipos de información, ¿con qué frecuencia un chatbot de IA/ChatGPT es capaz de generar una respuesta satisfactoria? Nota: una respuesta satisfactoria es aquella que cubre completamente la información que necesitas y con la que quedas satisfecho/a. (nunca, no muy a menudo, con cierta frecuencia, muy a menudo, siempre): a. Encontrar información relacionada con empleo b. Encontrar información relacionada con estudios c. Aprender más sobre un tema que estudias d. Consultar el tiempo e. Ponerte al día con noticias recientes f. Crear chistes o historias g. Crear un conjunto de instrucciones para completar una tarea
El EveryLibrary Institute ha dado a conocer un informe de gran relevancia titulado Library Patron Privacy in the Age of Artificial Intelligence, centrado en uno de los debates más urgentes para las bibliotecas contemporáneas: cómo proteger la privacidad de los usuarios en un contexto marcado por la expansión acelerada de la inteligencia artificial y de los servicios digitales.
Durante décadas, la confidencialidad de los hábitos de lectura, consulta e investigación ha sido uno de los principios fundamentales de las bibliotecas, especialmente en Estados Unidos, donde la defensa de la libertad intelectual ha estado estrechamente vinculada al derecho a la privacidad. Sin embargo, la llegada de nuevas herramientas basadas en IA está poniendo a prueba estos marcos tradicionales, generando interrogantes legales, éticos y tecnológicos que requieren respuestas actualizadas.
El estudio ha sido elaborado por Lucie Daignault, Samuel Lim y Catherine Ferri, integrantes de la Georgetown University Communications and Technology Law Clinic, en colaboración con EveryLibrary Institute. Su principal aportación consiste en ofrecer una revisión exhaustiva de las leyes de privacidad bibliotecaria vigentes en los cincuenta estados de EE. UU. y en el Distrito de Columbia, con el fin de determinar hasta qué punto estas normativas siguen siendo eficaces frente a los desafíos actuales. El informe analiza si las leyes estatales existentes contemplan adecuadamente cuestiones como la recopilación masiva de datos, el almacenamiento prolongado de información personal, la intervención de proveedores externos y el uso de sistemas automatizados capaces de perfilar comportamientos de lectura o búsqueda.
Uno de los aspectos más novedosos del documento es su atención específica a la inteligencia artificial generativa y a las nuevas formas de tratamiento de datos que esta implica. Muchas plataformas digitales utilizadas por bibliotecas incorporan tecnologías desarrolladas por terceros, capaces de registrar consultas, recomendaciones, patrones de navegación o interacciones textuales de los usuarios. Esto plantea un conflicto entre la mejora de servicios mediante herramientas inteligentes y la obligación histórica de las bibliotecas de garantizar anonimato, neutralidad y libertad de acceso a la información. El informe advierte que, sin controles adecuados, podrían abrirse vías de vigilancia indirecta o explotación comercial de datos tradicionalmente protegidos.
Asimismo, el trabajo examina la creciente dependencia de las bibliotecas respecto a proveedores tecnológicos externos. Los sistemas de préstamo digital, bases de datos académicas, plataformas de descubrimiento o asistentes automatizados suelen operar bajo contratos con empresas privadas que gestionan infraestructuras y datos sensibles. El informe invita a revisar cuidadosamente estas relaciones contractuales, reclamando mayor transparencia sobre qué datos se recogen, cómo se almacenan, durante cuánto tiempo se conservan y si pueden reutilizarse para entrenar modelos de inteligencia artificial u otros fines comerciales.
El valor práctico del informe reside también en su enfoque comparativo y aplicado. Al ofrecer un panorama actualizado estado por estado, se convierte en una herramienta útil para bibliotecarios, responsables institucionales, legisladores, investigadores y defensores de los derechos civiles. No se limita a diagnosticar problemas, sino que pretende impulsar conversaciones más profundas entre los sectores bibliotecario, jurídico y tecnológico. En este sentido, propone pensar la privacidad no como un obstáculo para la innovación, sino como un elemento esencial del diseño de cualquier servicio digital bibliotecario.
En última instancia, el documento subraya que la rápida evolución de la inteligencia artificial obliga a redefinir el papel de las bibliotecas como instituciones públicas de confianza en una sociedad gobernada cada vez más por datos. Si históricamente las bibliotecas han protegido la libertad de leer sin vigilancia, hoy deben extender esa misión al entorno digital. La cuestión no es solo tecnológica, sino democrática: preservar espacios donde las personas puedan informarse, aprender e investigar sin temor a ser monitorizadas o perfiladas. Por ello, este informe se perfila como una referencia clave para el futuro de la ética bibliotecaria y de la gobernanza de la IA.
La Inteligencia Artificial (IA) ofrece un gran potencial para apoyar los valores fundamentales de las bibliotecas, como el acceso equitativo a la información y la creación de conocimiento. Sin embargo, también es una tecnología controvertida, cuyos avances actuales suscitan inquietudes éticas y sociales. Las bibliotecas desempeñan un papel clave en la promoción de usos responsables, inclusivos y sostenibles de la IA. Sus valores —libertad de expresión, privacidad, transparencia y rendición de cuentas— proporcionan una perspectiva ética para interactuar con las herramientas y prácticas de la IA. Este documento define la IA en un sentido amplio y ofrece un conjunto práctico de preguntas para la reflexión que ayudan a los profesionales de las bibliotecas a evaluar las oportunidades y los riesgos.
El texto plantea un escenario de reflexión sobre la incorporación de herramientas de inteligencia artificial en los servicios de bibliotecas, concretamente en el caso de la posible licitación de un sistema de búsqueda potenciado por IA ofrecido por una editorial científica. Este sistema promete mejorar significativamente la recuperación de información mediante resúmenes automáticos de publicaciones, lo que obliga a los profesionales de la biblioteca a evaluar críticamente su pertinencia, utilidad y riesgos antes de su adopción.
Para ello, se propone la creación de un equipo interdisciplinar formado por especialistas en sistemas bibliotecarios, biblioteconomía, alfabetización informacional y derechos de autor. Este grupo debe elaborar una lista de preguntas clave para analizar la herramienta desde múltiples perspectivas: ética, funcionalidad, impacto institucional, fiabilidad, transparencia y adecuación a las necesidades reales de los usuarios. El objetivo no es solo valorar la innovación tecnológica, sino determinar si realmente aporta beneficios significativos frente a otras soluciones existentes y si su coste está justificado dentro de las prioridades de la biblioteca.
El documento se estructura a partir de un marco de 14 preguntas que sirven como guía de evaluación de sistemas de IA en entornos bibliotecarios. Estas cuestiones abordan aspectos como la calidad y precisión de la información generada por la IA, los posibles sesgos, la protección de la diversidad cultural y lingüística, la equidad en el acceso, la privacidad de los datos de los usuarios y la transparencia del funcionamiento del sistema. También se examina quién es responsable de los posibles errores del sistema y cómo se comunican sus limitaciones a los usuarios.
Asimismo, se subraya la importancia de garantizar que los datos utilizados por la IA no provengan de fuentes obtenidas de manera ilegítima y que se respeten los derechos de autor y la soberanía de los datos culturales. Otro eje central es la necesidad de mantener la agencia del usuario, es decir, que las personas puedan seguir controlando su interacción con la tecnología sin que esta sustituya sus habilidades críticas o de aprendizaje.
Las 14 preguntas funcionan como un marco de evaluación crítica para que las bibliotecas analicen la incorporación de sistemas de inteligencia artificial, especialmente en servicios de información y descubrimiento. No son un checklist técnico cerrado, sino una guía amplia que permite valorar tanto el impacto funcional como las implicaciones éticas, sociales y organizativas de estas herramientas.
Valor y pertinencia del servicio. La pregunta inicial obliga a la biblioteca a identificar qué tipo de beneficio real aporta la IA en términos de acceso al conocimiento y creación de información. No se trata solo de si la herramienta es innovadora, sino de si mejora de forma significativa la experiencia del usuario frente a alternativas más simples o económicas. Aquí se introduce también el concepto de “coste de oportunidad”: invertir en IA implica renunciar a otros posibles servicios o mejoras.
2, Calidad de la información generada por la IA, especialmente su precisión, actualización e imparcialidad. En entornos bibliotecarios esto es crucial, ya que los sistemas de IA pueden generar resúmenes o síntesis que parecen fiables pero contienen errores, sesgos o simplificaciones. Además, se plantea la necesidad de monitorización continua, ya que estos sistemas pueden cambiar su rendimiento con el tiempo.
3. Sesgos . Se evalúa si la IA reproduce estereotipos o excluye perspectivas culturales y lingüísticas. Esto es especialmente relevante en bibliotecas, cuyo objetivo tradicional es garantizar el acceso equitativo a la información.
4. Diversidad del conocimiento. También se analiza si el sistema favorece únicamente contenido en inglés o si integra fuentes multilingües y diversas.
5. Mal uso del sistema, especialmente en relación con la desinformación o la censura. Aunque menos desarrollada en el texto, apunta a un problema creciente: la posibilidad de que herramientas avanzadas de IA sean utilizadas para manipular o distorsionar información académica o científica.
6. Equidad y accesibilidad, considerando si todos los usuarios pueden beneficiarse del sistema en igualdad de condiciones. Aquí se incluyen aspectos como la accesibilidad digital (cumplimiento de estándares como WCAG), la brecha tecnológica y la posible exclusión de determinados colectivos.
7. Transparencia, uno de los más complejos en IA. Se analiza hasta qué punto el usuario entiende qué está haciendo el sistema, cómo genera los resultados y cuáles son sus límites. También se plantea la cuestión de la responsabilidad: quién responde cuando la IA comete errores, la empresa, la biblioteca o el usuario.
8. Privacidad y gestión de datos, un tema crítico en entornos académicos. Se evalúa cómo se recogen, almacenan y utilizan los datos de los usuarios, incluyendo sus consultas, patrones de búsqueda y posibles datos personales, así como el cumplimiento de normativas como el GDPR.
9. Legalidad y ética de los datos utilizados para entrenar la IA, así como en el respeto a los derechos de autor. También introduce una preocupación emergente: la carga que la IA puede generar sobre repositorios abiertos y sistemas de acceso libre.
10. Participación social y la soberanía de los datos, es decir, si las comunidades afectadas han sido tenidas en cuenta en el desarrollo del sistema y si mantienen control sobre su información cultural.
11. Agencia del usuario y el impacto en el aprendizaje. Se analiza si la IA fortalece las competencias del usuario o si, por el contrario, fomenta la dependencia y la pérdida de habilidades críticas. También se considera la necesidad de formación para un uso responsable.
12. Empleo y la estructura laboral, tanto en bibliotecas como en el ecosistema editorial y tecnológico. Se plantea si la IA sustituye funciones humanas o si reconfigura los roles profesionales.
13. Impacto ambiental, un aspecto cada vez más relevante. El uso de modelos de IA implica consumo energético, infraestructura de servidores y uso de agua, lo que obliga a considerar la sostenibilidad del servicio en su ciclo completo.
14. Modelo de negocio y la gobernanza del proveedor, es decir, quién desarrolla la herramienta, bajo qué principios opera y si su estrategia es sostenible y alineada con valores públicos. También se abre la reflexión sobre posibles vínculos con intereses comerciales o incluso militares.
En conjunto, estas 14 preguntas no buscan una respuesta única, sino fomentar una evaluación crítica y multidimensional de la inteligencia artificial en bibliotecas, equilibrando innovación tecnológica con responsabilidad ética, social y profesional.
El texto también amplía la reflexión hacia dimensiones sociales más amplias, como el impacto laboral de estas tecnologías, su huella ambiental y el modelo de negocio de las empresas proveedoras. En conjunto, se propone una evaluación integral que no se limite a lo técnico, sino que integre criterios éticos, educativos, sociales y sostenibles, con el fin de orientar la toma de decisiones en las bibliotecas ante la creciente incorporación de la inteligencia artificial.
A futuristic smart community leveraging AI for green solutions and renewable energy
Nishant, Rohit, Mike Kennedy y Jacqueline Corbett. “Artificial Intelligence for Sustainability: Challenges, Opportunities, and a Research Agenda.” International Journal of Information Management 53 (2020): 102104. https://doi.org/10.1016/j.ijinfomgt.2020.102104
El artículo sintetiza debates entre expertos, líneas de investigación emergentes y propuestas estratégicas sobre un tema de especial relevancia científica. En este caso, el foco se sitúa en la relación entre inteligencia artificial, infraestructuras digitales y sostenibilidad, una cuestión cada vez más central debido al crecimiento exponencial del uso de modelos avanzados y de la demanda energética asociada a los sistemas computacionales.
El artículo parte de una constatación clara: la expansión de la inteligencia artificial está generando beneficios notables en automatización, análisis de datos y apoyo a la toma de decisiones, pero también costes ambientales significativos. El entrenamiento de grandes modelos requiere enormes recursos de computación, centros de datos de alta capacidad y consumo intensivo de electricidad y agua. A ello se suman problemas como la obsolescencia acelerada del hardware, la extracción de minerales críticos y la huella ecológica derivada de cadenas globales de suministro tecnológicas. Por ello, los participantes del seminario sostienen que ya no basta con medir la precisión o velocidad de los sistemas; es imprescindible evaluar también su impacto material y energético.
Uno de los ejes principales del texto es la necesidad de desarrollar métricas comunes para una “IA sostenible”. Esto implica crear indicadores comparables sobre consumo energético, emisiones de carbono, eficiencia computacional, reutilización de modelos y coste social de despliegue. Sin estándares claros, resulta difícil comparar tecnologías o establecer políticas regulatorias eficaces. El informe subraya que muchas veces los avances en rendimiento se presentan sin transparencia suficiente sobre los recursos necesarios para alcanzarlos, lo que distorsiona la percepción de progreso tecnológico.
Otro aspecto destacado es la importancia de rediseñar tanto algoritmos como infraestructuras. El seminario propone impulsar modelos más pequeños y especializados cuando sean suficientes para una tarea concreta, técnicas de compresión y reutilización de parámetros, así como arquitecturas de hardware más eficientes. Del mismo modo, se plantea optimizar centros de datos mediante energías renovables, mejor refrigeración, gestión dinámica de cargas de trabajo y localización estratégica en zonas con menor impacto ambiental. La sostenibilidad, por tanto, no depende solo del software, sino de todo el ecosistema técnico que sostiene la inteligencia artificial.
El artículo también aborda la dimensión ética y política del problema. La concentración de capacidad computacional en unas pocas grandes corporaciones y países genera desigualdades de acceso al desarrollo de IA. Si solo actores con enormes recursos energéticos y financieros pueden competir, se amplían brechas científicas y económicas. Por ello, se plantea la necesidad de infraestructuras compartidas, cooperación internacional y políticas públicas que permitan democratizar el acceso a la computación avanzada sin reproducir monopolios tecnológicos.
El documento concluye que la sostenibilidad debe integrarse como criterio estructural en la investigación y evaluación de la inteligencia artificial. No se trata de frenar la innovación, sino de orientarla hacia modelos compatibles con límites ecológicos y con una distribución más justa de beneficios y costes. En esa visión, el futuro de la IA dependerá no solo de cuánto pueda hacer, sino de cómo, para quién y a qué precio ambiental lo haga.
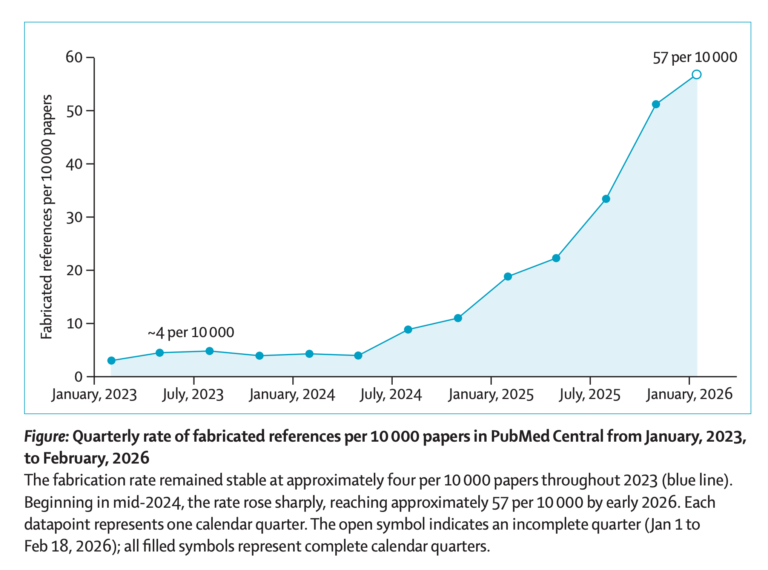
Un análisis reciente difundido por Retraction Watch advierte de un crecimiento muy acusado de las referencias bibliográficas falsas dentro de la literatura biomédica indexada en PubMed. El estudio, presentado en forma de carta en The Lancet, examinó cerca de 2,5 millones de artículos científicos y concluyó que las citas inventadas se han multiplicado por doce en apenas dos años.
Los investigadores detectaron que aproximadamente uno de cada 277 artículos publicados en las primeras siete semanas de 2026 incluía al menos una referencia a un trabajo inexistente. La comparación histórica muestra una escalada preocupante: en 2025 la proporción era de uno entre 458, mientras que en 2023 era de uno entre 2.828. Esto sugiere que el fenómeno no es marginal, sino creciente y sistemático.
El equipo estuvo liderado por Maxim Topaz, del Data Science Institute de la Universidad de Columbia. Para separar errores tipográficos o abreviaturas irregulares de verdaderas invenciones bibliográficas, los autores emplearon herramientas de inteligencia artificial capaces de contrastar títulos y registros reales. Esto permitió identificar con mayor precisión qué citas eran simplemente incorrectas y cuáles correspondían a documentos inexistentes.
Según el informe, el aumento más brusco comenzó a mediados de 2024, coincidiendo con la expansión masiva de herramientas de escritura asistida por IA generativa. El artículo relaciona este crecimiento con el uso inadecuado de modelos de lenguaje capaces de producir referencias aparentemente verosímiles, aunque inexistentes, si no se supervisan correctamente.
Las implicaciones son profundas para la comunicación científica. Las referencias falsas contaminan revisiones bibliográficas, dificultan la verificación de fuentes y erosionan la confianza en el sistema académico. El caso refuerza la necesidad de controles editoriales más estrictos, verificadores automáticos de citas y formación ética en el uso de IA para la redacción científica.
The Chronicle of Higher Education. “Faculty Views on AI.” The Chronicle of Higher Education, consultado el 7 de mayo de 2026. The Chronicle of Higher Education
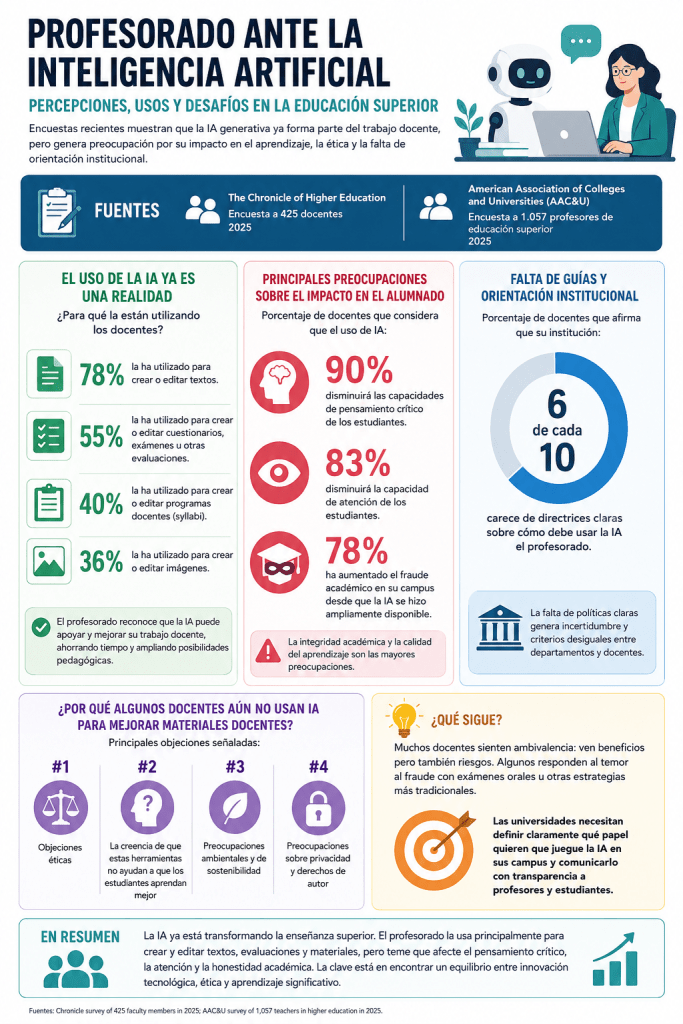
El informe presenta un panorama claro: la IA ya está transformando la enseñanza superior, pero su adopción está marcada por la tensión entre utilidad práctica y riesgo pedagógico. Los docentes valoran su capacidad para ahorrar tiempo, generar materiales y apoyar tareas rutinarias, pero temen que debilite el esfuerzo intelectual, favorezca el engaño y erosione competencias fundamentales. La conclusión implícita es que el problema no es solo tecnológico, sino estratégico: las universidades deberán decidir si la IA será un simple atajo operativo o una herramienta integrada críticamente dentro de un nuevo modelo educativo.
El informe Faculty Views on AI refleja una posición profundamente ambivalente del profesorado universitario ante la inteligencia artificial generativa. Por un lado, una mayoría reconoce que estas herramientas ya están siendo útiles para mejorar ciertos aspectos de la docencia; por otro, existe una preocupación muy fuerte por su impacto negativo en el aprendizaje, la ética académica y la falta de regulación institucional. El estudio combina datos de una encuesta de The Chronicle of Higher Education a 425 docentes en 2025 y otra de la American Association of Colleges and Universities (AAC&U) a 1.057 profesores de educación superior en 2025, lo que permite observar tendencias consolidadas en el ámbito universitario.
Uno de los datos más significativos es que el profesorado ya está incorporando la IA a su trabajo cotidiano. El 78 % afirma haber utilizado herramientas de IA para crear o editar textos, lo que indica que estas aplicaciones se están convirtiendo en asistentes habituales para redactar materiales, instrucciones o contenidos académicos. Además, el 55 % las ha empleado para crear o revisar cuestionarios, exámenes u otras evaluaciones, mientras que el 40 % dice haberlas usado para elaborar o modificar programas docentes (syllabi). También el 36 % las ha utilizado para crear o editar imágenes, señal de que la IA comienza a desempeñar un papel relevante en la producción de recursos visuales para las clases. Estos porcentajes muestran que, lejos de ser una novedad marginal, la IA ya forma parte de las prácticas docentes en muchas instituciones.
Sin embargo, junto a este uso creciente aparecen temores muy marcados sobre sus consecuencias educativas. El 90 % del profesorado considera que el uso de IA reducirá las capacidades de pensamiento crítico del alumnado, lo que revela una inquietud central: que los estudiantes deleguen procesos intelectuales complejos en la máquina y pierdan autonomía analítica. Asimismo, el 83 % cree que la IA disminuirá la capacidad de atención, reforzando la idea de que el acceso inmediato a respuestas puede fomentar hábitos de concentración superficial. Otro dato especialmente revelador es que el 78 % sostiene que el fraude académico o las trampas en el campus han aumentado desde que la IA se popularizó, lo que sitúa la integridad académica como una de las grandes preocupaciones actuales.
A estos temores se suma un problema institucional importante: la ausencia de normas claras. Más de seis de cada diez profesores afirman que sus universidades carecen de directrices claras sobre cómo debe usarse la IA por parte del profesorado. Esto genera incertidumbre y respuestas desiguales entre departamentos o facultades. En muchos casos, cada docente decide por su cuenta si la permite, la restringe o la integra, lo que produce incoherencia pedagógica y desconcierto entre los estudiantes. El informe subraya que las universidades necesitan definir con mayor claridad qué papel desean otorgar a estas tecnologías y comunicarlo de forma transparente a toda la comunidad académica.
Entre quienes todavía no utilizan IA para mejorar materiales docentes, las razones principales también resultan reveladoras. La objeción más citada son los problemas éticos, seguida de las dudas sobre si realmente ayuda a aprender mejor, las preocupaciones medioambientales y de sostenibilidad, y finalmente los temores relacionados con privacidad y derechos de autor. Esto demuestra que la resistencia no se debe únicamente a desconocimiento tecnológico, sino también a debates legítimos sobre valores, impacto social y calidad educativa.
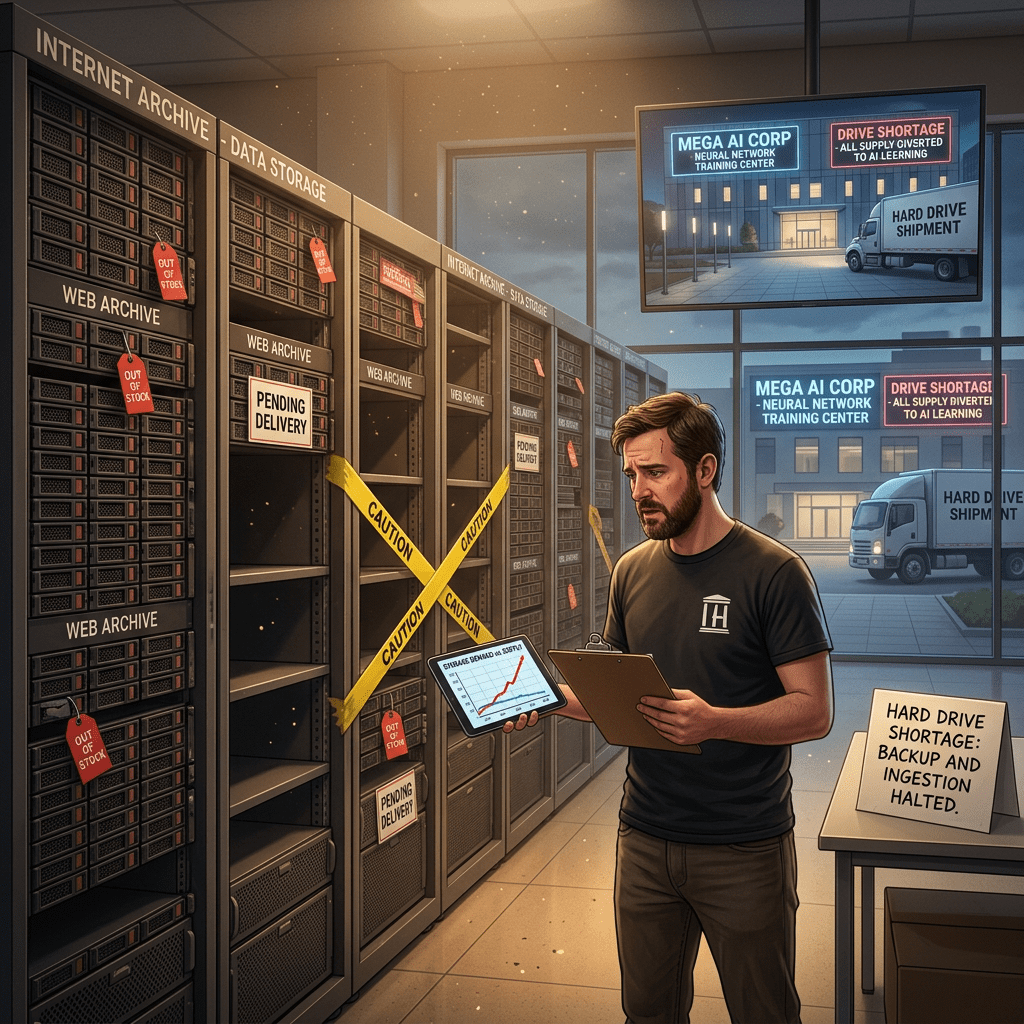
Se recoge una investigación original de 404 Media, analiza una consecuencia poco visible del auge de la inteligencia artificial: la creciente escasez y encarecimiento de discos duros y sistemas de almacenamiento. La expansión de centros de datos dedicados a IA está absorbiendo enormes cantidades de hardware, lo que reduce la disponibilidad para otros sectores y eleva los precios. Esta situación afecta especialmente a instituciones cuya misión depende de almacenar grandes volúmenes de información, como archivos digitales, universidades, Wikipedia o coleccionistas de datos.
Uno de los principales perjudicados es Internet Archive, organización responsable de la Wayback Machine. Su fundador, Brewster Kahle, explicó que los discos de alta capacidad que suelen utilizar —de 28 a 30 TB— están agotados o se venden a precios muy elevados. La institución incorpora más de 100 terabytes diarios de nuevos materiales y mantiene más de 210 petabytes archivados, por lo que necesita renovar constantemente infraestructura. El incremento de costes supone una presión directa sobre su sostenibilidad financiera y operativa.
El problema también alcanza a la Wikimedia Foundation, que gestiona Wikipedia y otros proyectos abiertos. La fundación reconoce aumentos en memoria, discos y plazos de entrega de servidores, lo que obliga a replantear inversiones y extender la vida útil del equipamiento existente. Para organizaciones sin ánimo de lucro, estos cambios tienen un impacto especialmente grave, ya que cada decisión tecnológica compite con recursos destinados a contenidos, comunidad o desarrollo.
El reportaje señala además que varios fabricantes están priorizando a clientes corporativos vinculados a centros de datos. Western Digital habría comprometido gran parte de su inventario de 2026 con grandes compradores empresariales, mientras Micron decidió abandonar parte del mercado de consumo para concentrarse en segmentos más rentables relacionados con IA. Esto significa que usuarios comunes, pequeñas instituciones y archivistas independientes compiten en desventaja frente a gigantes tecnológicos con gran capacidad de compra.
Las comunidades de archivistas y usuarios especializados reflejan esta preocupación. En foros como Reddit, muchos participantes afirman haber detenido proyectos de respaldo o archivo debido a los precios disparados, mientras otros recurren a unidades usadas, discos antiguos o estrategias improvisadas de almacenamiento. Algunos incluso sugieren volver a tecnologías como cintas LTO, aunque estas presentan problemas de acceso rápido y latencia para servicios públicos en línea.
Más allá del coste económico, el artículo plantea una cuestión de fondo: la misma industria de IA que consume enormes cantidades de datos para entrenar modelos está dificultando materialmente la preservación de la memoria digital. Archivar internet requiere capacidad de almacenamiento constante, y si esa capacidad se vuelve inaccesible, parte del patrimonio digital contemporáneo corre riesgo de perderse. La paradoja es evidente: tecnologías que dependen del pasado digital pueden contribuir a borrar la posibilidad de conservarlo.
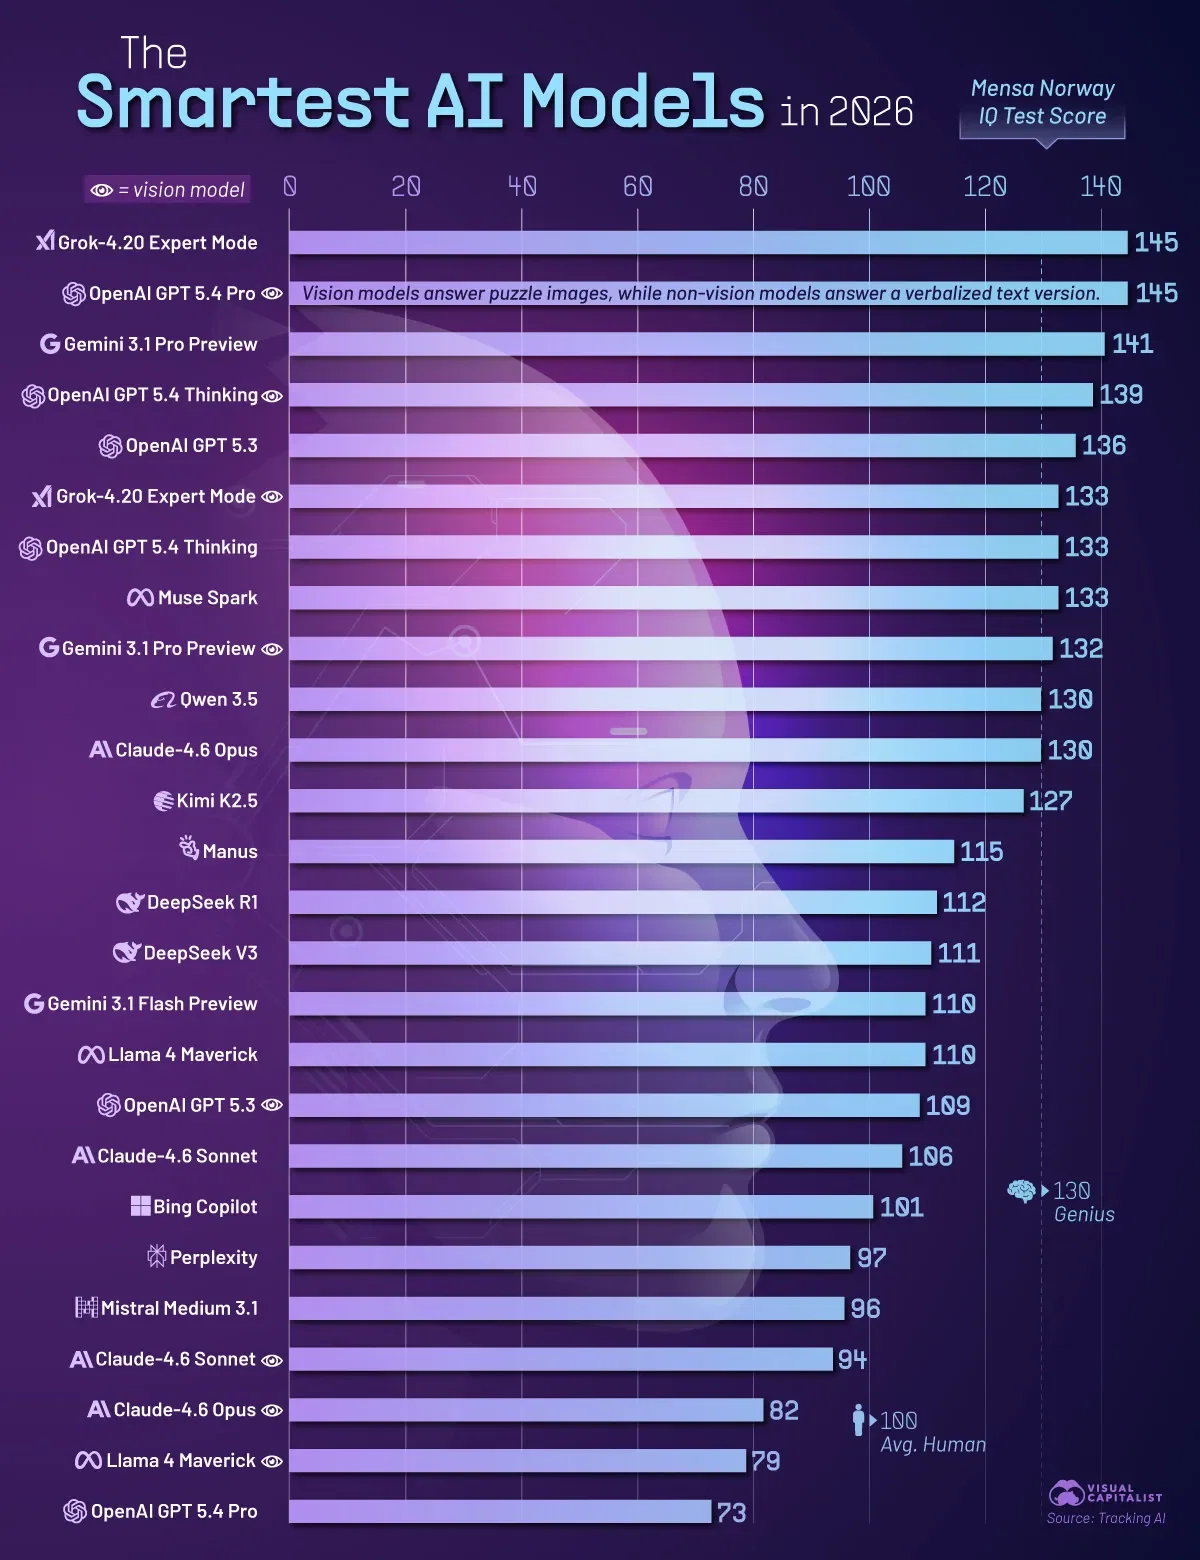
La tabla revela una realidad clara: en 2026 ya no existe un líder indiscutible. La ventaja entre los mejores modelos es mínima, la competencia es global y la inteligencia artificial entra en una fase de madurez donde importarán tanto la integración, el precio y la confianza como la potencia bruta. La “guerra de benchmarks” continúa, pero el mercado probablemente se decidirá por ecosistemas completos más que por unos pocos puntos de diferencia.
El artículo de Voronoi presenta una clasificación de los modelos de inteligencia artificial considerados más avanzados de 2026, utilizando como base los resultados del benchmark de Mensa Norway elaborado por TrackingAI. Lo primero que destaca el informe es que la competencia entre los líderes del sector se ha estrechado enormemente. A diferencia de años anteriores, donde uno o dos modelos dominaban con claridad, en 2026 las puntuaciones se concentran en la parte alta de la tabla, con diferencias mínimas entre los primeros puestos. Esto indica que la industria ha alcanzado una fase de madurez en la que varias compañías han logrado niveles similares de rendimiento avanzado.
En la cima del ranking aparecen empatados Grok-4.20 Expert Mode y OpenAI GPT 5.4 Pro (Vision), ambos con una puntuación de 145. Este empate refleja no solo la capacidad técnica de ambos sistemas, sino también la diversificación de enfoques dentro del mercado de IA. Grok, desarrollado por xAI, ha apostado por una integración fuerte con información en tiempo real y un estilo de respuesta más directo, mientras que GPT 5.4 Pro incorpora una sólida capacidad multimodal, especialmente en visión artificial, razonamiento y productividad profesional. Que ambos compartan la primera posición simboliza que no existe ya un único camino hacia la excelencia algorítmica.
Otro aspecto relevante del informe es la comparación histórica con 2025. Según los datos citados, el modelo más destacado del año anterior fue OpenAI o3, con una puntuación de 135, mientras que GPT-4o Vision apenas alcanzó 63. El salto hasta 145 puntos en solo un año evidencia la velocidad vertiginosa del progreso en IA. En términos prácticos, significa mejoras drásticas en razonamiento complejo, comprensión multimodal, precisión y adaptabilidad a tareas especializadas. También confirma que los benchmarks existentes se quedan obsoletos cada vez más rápido, algo que ya señalan otros estudios como el AI Index de Stanford.
El ranking también sugiere una creciente pluralidad geopolítica en la innovación tecnológica. Ya no son únicamente OpenAI o Anthropic quienes marcan el paso. Empresas como xAI, Google, Moonshot AI o nuevos laboratorios emergentes participan activamente en la carrera por liderar la inteligencia artificial generalista. Esto apunta a una descentralización del poder tecnológico y a un ecosistema más competitivo, donde la innovación depende tanto del talento científico como del acceso a datos, chips y capital.
Desde una perspectiva económica y social, esta evolución tiene profundas implicaciones. La cercanía entre modelos significa que la ventaja competitiva puede desplazarse desde la inteligencia “bruta” hacia otros factores: precio, integración con herramientas empresariales, privacidad, velocidad de respuesta, consumo energético o facilidad de uso. En otras palabras, la próxima fase del mercado podría decidirse menos por quién tiene el modelo “más inteligente” y más por quién ofrece el ecosistema más útil y sostenible para usuarios y organizaciones.
El artículo retrata un momento decisivo: 2026 no es solo el año de los modelos más potentes, sino también el año en que la supremacía tecnológica deja de estar concentrada en un solo actor. La inteligencia artificial entra así en una etapa de competencia madura, multipolar y extremadamente dinámica, donde pequeñas mejoras técnicas pueden traducirse en enormes consecuencias económicas y estratégicas.
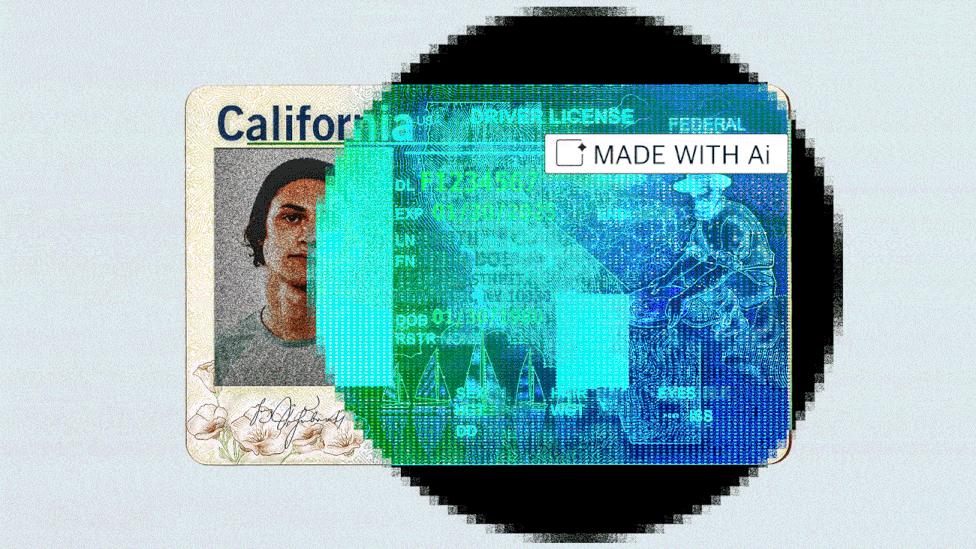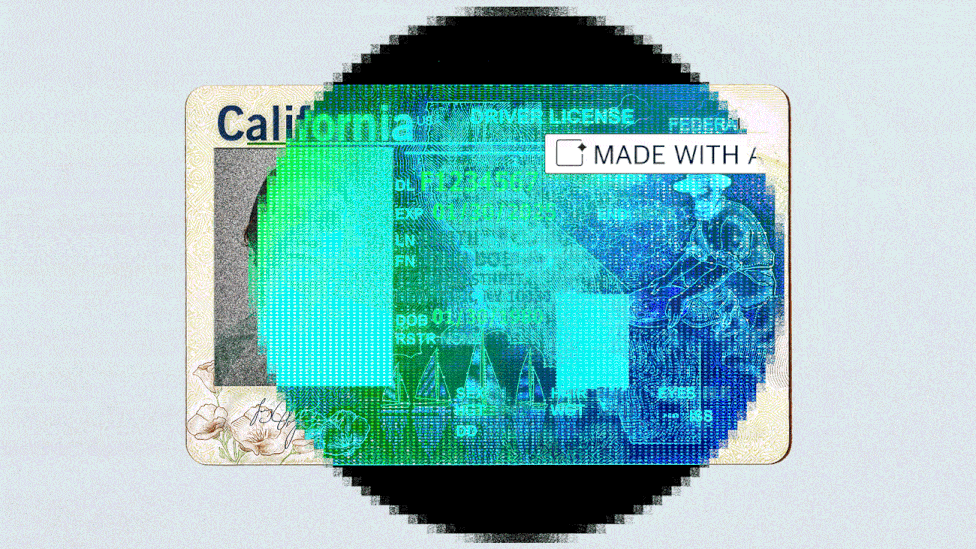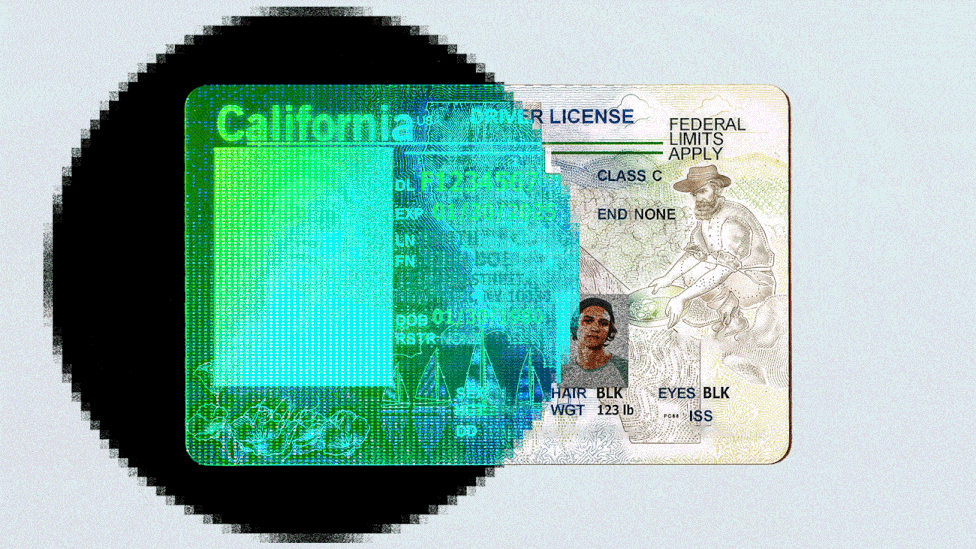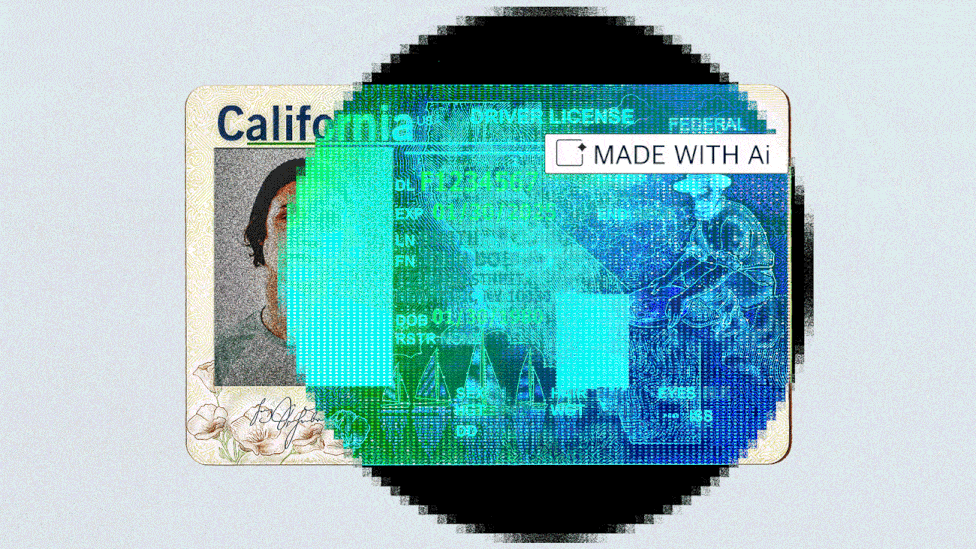
El artículo analiza cómo los nuevos modelos de generación de imágenes mediante inteligencia artificial están transformando el fraude digital. Según The Atlantic, la amenaza ya no se limita a los tradicionales deepfakes de celebridades o líderes políticos, sino que se desplaza hacia falsificaciones mucho más cotidianas y peligrosas: alertas bancarias falsas, transferencias simuladas, documentos médicos, recetas, identificaciones oficiales, facturas o capturas de pantalla aparentemente auténticas. Estas imágenes resultan especialmente convincentes porque las herramientas actuales han mejorado notablemente en la reproducción de texto legible y diseño visual realista.
El reportaje pone el foco en la facilidad con la que un usuario puede generar material fraudulento. El autor explica que logró producir más de cien imágenes engañosas con poco esfuerzo, demostrando que la barrera técnica para cometer este tipo de delitos se ha reducido drásticamente. Antes, elaborar falsificaciones sofisticadas requería conocimientos avanzados de edición gráfica; ahora basta con introducir instrucciones en lenguaje natural. Esto democratiza el fraude y multiplica los riesgos para particulares, empresas e instituciones.
Uno de los aspectos más preocupantes es el uso de estas imágenes en estafas personalizadas. Una persona podría recibir un supuesto recibo de Uber, una alerta de Chase Bank o una confirmación de transferencia inexistente acompañada de un enlace malicioso. Al tratarse de documentos visualmente creíbles, la víctima puede reaccionar con rapidez y caer en ataques de phishing. El problema no es solo la calidad técnica de la imagen, sino la capacidad de combinarla con ingeniería social para manipular emociones como la urgencia, el miedo o la confusión.
El texto también cuestiona la eficacia de las salvaguardas implantadas por las empresas tecnológicas. Aunque OpenAI y Google incorporan políticas de uso, marcas de agua o metadatos para identificar imágenes generadas por IA, estas medidas pueden eliminarse fácilmente mediante capturas de pantalla, recortes o nuevas conversiones de archivo. En la práctica, los mecanismos de seguridad van por detrás de la rapidez con la que evolucionan las herramientas de generación visual.
Para concluir, el artículo sostiene que el mayor peligro no reside en los grandes engaños mediáticos, sino en los “microdeepfakes”: falsificaciones dirigidas a personas concretas para vaciar cuentas, obtener datos personales o engañar a familiares. En lugar de alterar elecciones o provocar crisis geopolíticas, estos fraudes erosionan la confianza diaria en mensajes, imágenes y comunicaciones digitales. La conclusión es clara: el desafío ya no es futurista, sino inmediato, y exige respuestas coordinadas entre tecnológicas, bancos, reguladores y ciudadanía.