
«La inteligencia artificial no va a reemplazar a los humanos, pero los humanos que usen IA reemplazarán a los que no lo hagan.»
Garry Kasparov. Campeón de ajedrez
«La inteligencia artificial no va a reemplazar a los humanos, pero los humanos que usen IA reemplazarán a los que no lo hagan.»
Garry Kasparov. Campeón de ajedrez

Davis, Lauren. “Tales of Merlin and King Arthur Resurface After 750 Years, Hidden in a Bookbinding.” Gizmodo, April 4, 2019. https://gizmodo.com/tales-of-merlin-and-king-arthur-resurface-after-750-years-inside-a-bookbinding-2000581309
Un equipo interdisciplinar de la Universidad de Cambridge descubrió un raro fragmento del ciclo artúrico reutilizado en la encuadernación de un documento del siglo XVI. Gracias a técnicas de imagen avanzadas y métodos de análisis digital —incluyendo herramientas de inteligencia artificial— lograron desenrollar virtualmente el manuscrito sin dañarlo
Un equipo interdisciplinar de académicos de la Universidad de Cambridge hizo un hallazgo extraordinario que reavivó el interés por las leyendas artúricas. Durante una revisión de documentos antiguos en la biblioteca universitaria, encontraron un fragmento casi ilegible de un manuscrito medieval de más de 750 años de antigüedad. Lo sorprendente es que este valioso texto no se hallaba archivado como tal, sino que había sido reutilizado en el siglo XVI como parte de la encuadernación de un registro de propiedades. Esta práctica era común en esa época: dado que muchos manuscritos antiguos se consideraban obsoletos o sin valor práctico, se desmembraban y se reciclaban como refuerzos estructurales para nuevas encuadernaciones. Sin embargo, este caso demostraba que, aunque olvidado y oculto, un fragmento de la historia literaria europea había sobrevivido a través de los siglos.
El texto resultó ser un pasaje de la Suite Vulgate du Merlin, parte del Ciclo Vulgata o Ciclo Lancelot-Graal, una de las versiones más influyentes de las leyendas del rey Arturo, escrita originalmente en francés antiguo durante la primera mitad del siglo XIII. El pasaje narra eventos posteriores a la coronación del rey Arturo, incluyendo un episodio bélico en el que el caballero Gauvin (o Gawain) lidera a las tropas cristianas hacia la victoria sobre los sajones, blandiendo la espada Excalibur. También aparece una escena más mística y simbólica: la irrupción de un Merlín disfrazado durante una celebración en la corte, vestido con una túnica de seda adornada con oro y piedras preciosas que iluminaban toda la sala. Estos relatos forman parte del núcleo simbólico y narrativo de la literatura medieval europea, donde confluyen la épica caballeresca, el misticismo cristiano y la fantasía heroica.
El valor del descubrimiento es doble: por un lado, se trata de un testimonio rarísimo, ya que existen menos de 40 copias conocidas de esta parte específica del ciclo artúrico, y cada una presenta diferencias notables debido a que los manuscritos medievales eran copiados a mano. Este fragmento concreto, decorado con iniciales rojas y azules, ha sido datado entre los años 1275 y 1315. Por otro lado, el hallazgo es un hito en las metodologías de preservación y acceso a textos antiguos. Tradicionalmente, estudiar un manuscrito encuadernado de esta forma implicaba forzosamente desmontar y dañar tanto el fragmento como el libro que lo contenía. Sin embargo, el equipo de Cambridge logró una solución innovadora.
Aplicando técnicas de imagen avanzadas —como fotografía multispectral, escaneo en 3D, uso de espejos, prismas y otros recursos ópticos— los investigadores crearon una réplica digital de la encuadernación. Esto les permitió “desplegar” virtualmente el manuscrito sin afectar su estado físico. Cada imagen fue cuidadosamente ensamblada como si se tratara de un rompecabezas, permitiendo reconstruir digitalmente el contenido del fragmento y estudiar su caligrafía, su estructura textual y su ornamentación. Gracias a este proceso, no solo se conservó el texto medieval, sino también la integridad del documento del siglo XVI, considerado a su vez un testimonio histórico importante de las prácticas archivísticas de la época.
La especialista francesa Irène Fabry-Tehranchi, participante en el proyecto, subrayó la relevancia de conservar el fragmento in situ, es decir, dentro del documento que lo contiene. A su juicio, hace treinta años se habría priorizado el texto antiguo, desmantelando sin contemplaciones el libro moderno para extraerlo. Pero hoy, el enfoque ha cambiado: se reconoce el valor cultural e histórico tanto del manuscrito medieval como del contexto material en que fue hallado.
Más allá del caso puntual, el equipo de Cambridge destacó que su objetivo era también establecer una metodología replicable. Muchos archivos y bibliotecas del mundo poseen documentos encuadernados con materiales de siglos anteriores, y enfrentan el mismo dilema entre preservación y acceso. La técnica desarrollada en este proyecto ofrece una vía no invasiva para rescatar textos ocultos sin comprometer el estado físico de los volúmenes.
Este descubrimiento confirma que los manuscritos medievales siguen guardando secretos. Lo que una vez fue considerado “material de desecho” para encuadernar otros libros, puede resultar ser un auténtico tesoro histórico y literario. Setecientos cincuenta años después de ser escrito, este fragmento de las leyendas de Merlín y el rey Arturo vuelve a ver la luz gracias a una combinación de erudición, tecnología avanzada y sensibilidad patrimonial. El proyecto es, sin duda, una inspiración para futuras investigaciones y una prueba de que los libros aún pueden sorprendernos.
Lim, Aaron Tay. “Testing AI Academic Search Engines (1).” Musings about Librarianship (blog), March 2025. https://musingsaboutlibrarianship.blogspot.com/2025/03/testing-ai-academic-search-engines-1.html
Este artículo es el primero de una serie dedicada a desarrollar un marco para evaluar motores de búsqueda académicos impulsados por inteligencia artificial (IA). El autor destaca que, antes de establecer métodos de evaluación, es esencial definir claramente qué se entiende por “motor de búsqueda académico con IA”. Sin una definición precisa, las comparaciones entre herramientas pueden resultar vagas o engañosas.
Los motores de búsqueda académicos con inteligencia artificial (IA) son herramientas diseñadas específicamente para facilitar el acceso, la comprensión y la organización del conocimiento científico. A diferencia de los buscadores tradicionales que se limitan a localizar documentos mediante coincidencias literales de palabras clave, estos motores aplican tecnologías avanzadas de IA para ofrecer resultados más pertinentes y comprensivos, adaptándose mejor a las necesidades de investigadores, estudiantes y profesionales académicos.
Estos motores integran IA de diversas formas, incluyendo:
Una de sus principales características es la búsqueda semántica, que permite interpretar la intención detrás de una consulta más allá de las palabras exactas empleadas. Esto significa que pueden entender sinónimos, relaciones conceptuales y contextos temáticos, lo que mejora significativamente la relevancia de los resultados. Además, muchos de estos sistemas utilizan técnicas como RAG (Retrieval Augmented Generation) para generar respuestas directas a preguntas específicas, acompañadas de citas de fuentes relevantes, lo cual agiliza el proceso de revisión de la literatura.
Otra capacidad destacada es la de elaborar resúmenes automáticos de artículos académicos, extrayendo la información clave de textos largos y complejos para facilitar su comprensión rápida. También pueden sintetizar hallazgos de múltiples estudios en tablas comparativas o matrices, lo cual es especialmente útil para revisiones sistemáticas o estudios de meta-análisis. Por último, estos motores son capaces de identificar autores influyentes, artículos fundamentales y tendencias emergentes en distintas áreas del conocimiento, contribuyendo así a una mejor navegación por el creciente universo de la literatura científica.
El autor propone clasificar las herramientas en cuatro grandes grupos.
Descripción de cada herramienta:
Elicit: Un asistente de investigación que ayuda a analizar y sintetizar información de artículos académicos, acelerando tareas como la extracción de datos y la creación de revisiones sistemáticas.
Scite Assistant: Una herramienta que contextualiza citas académicas, destacando si apoyan o contradicen un argumento, ideal para revisiones de literatura.
Consensus: Un asistente que utiliza IA para responder preguntas basadas en evidencia científica, extrayendo información de artículos académicos.
Scopus AI: Basado en la base de datos Scopus, esta herramienta genera resúmenes y revisiones de literatura académica.
Primo Research Assistant: Aunque no encontré información específica, parece ser un asistente enfocado en la investigación académica.
Perplexity.ai: Un motor de búsqueda que utiliza IA para responder preguntas con explicaciones claras y referencias.
ChatGPT: Un modelo de lenguaje desarrollado por OpenAI que puede generar texto, responder preguntas y realizar tareas creativas.
Microsoft Copilot: Tu compañero de IA creado por Microsoft, diseñado para ayudarte en tareas de productividad, creatividad y aprendizaje.
Geinmi: La propuesta de Meta para la IA
Claude: Un asistente de IA desarrollado por Anthropic, enfocado en conversaciones naturales y tareas complejas.
DeepSeek: La web de IA China
Grok: modelo de inteligencia artificial generativa (IA) creado por xAI, la empresa de Elon Musk, que se utiliza como un asistente de IA en X.
Connected Papers: Una herramienta para explorar conexiones entre artículos académicos y descubrir investigaciones relevantes.
ResearchRabbit: Ayuda a encontrar y organizar artículos académicos relacionados con un tema específico.
Litmaps: Una herramienta para visualizar y rastrear la evolución de la investigación académica a través de mapas de citas.
Citation Gecko: Permite explorar redes de citas para encontrar artículos relevantes.
Inciteful: Una herramienta para analizar redes de citas y descubrir investigaciones relacionadas.
Keenius: No encontré información específica sobre esta herramienta.
Jenna.ai: Jenni AI es una herramienta de inteligencia artificial que asiste en la redacción académica
Lens.org: Una plataforma para buscar y analizar patentes y literatura académica.
OpenAlex: Una base de datos abierta que proporciona información sobre artículos académicos, autores e instituciones.
González-Espinoza, Alfredo, Dom Jebbia, y Haoyong Lan. «Metadata Augmentation Using NLP, Machine Learning and AI-Chatbots: A Comparison.» arXiv, abril 25, 2025. https://arxiv.org/abs/2504.17189
El estudio ofrece un análisis exhaustivo sobre el uso de herramientas de inteligencia artificial (IA) y aprendizaje automático para la tarea de recogida de metadatos, especialmente en el contexto de bibliotecas universitarias. Los avances recientes en estas tecnologías han permitido que tareas repetitivas, como la clasificación de documentos y la curación de datos, sean más automatizadas, lo que puede optimizar significativamente los flujos de trabajo en instituciones como las bibliotecas. Sin embargo, el desarrollo y la integración efectiva de estas herramientas en entornos de trabajo reales aún enfrentan desafíos importantes.
Los autores, Alfredo González-Espinoza, Dom Jebbia y Haoyong Lan, quienes son parte del equipo de Bibliotecas Universitarias en la Universidad Carnegie Mellon, realizan un estudio comparativo entre diferentes enfoques para la extracción de metadatos. En particular, se enfocan en el uso de chatbots comerciales basados en IA y su capacidad para realizar tareas de clasificación de documentos con datos limitados. Además, comparan estos resultados con los obtenidos mediante métodos tradicionales de aprendizaje automático y procesamiento de lenguaje natural (PLN), como XGBoost y el ajuste fino de BERT.
El análisis revela que, aunque los chatbots de IA muestran un rendimiento similar entre ellos, superan a los métodos de aprendizaje automático que fueron probados, especialmente cuando los chatbots se entrenan utilizando datos locales. Este hallazgo es significativo, ya que sugiere que, en situaciones con datos limitados, las soluciones basadas en IA pueden ser más efectivas que los enfoques tradicionales. Sin embargo, los autores también subrayan que, a pesar de su facilidad de uso en comparación con los métodos de programación tradicionales, los chatbots aún presentan retos para los usuarios en términos de obtener resultados útiles. A pesar de que la interacción con los chatbots puede parecer más accesible, los resultados no siempre son confiables y pueden requerir ajustes adicionales.
Un hallazgo preocupante del estudio fue la identificación de errores conceptuales alarmantes en algunos chatbots, tales como la incapacidad de contar correctamente el número de líneas de los textos de entrada. Curiosamente, algunos chatbots justificaron estos errores como «errores humanos», lo que resalta la necesidad de mejorar la precisión y la comprensión de estos sistemas. Este tipo de error pone en duda la fiabilidad de los chatbots de IA para tareas que requieren una precisión absoluta, como la clasificación de metadatos en bibliotecas, donde los detalles son cruciales.
A pesar de estos problemas, los autores concluyen que la información proporcionada en su estudio es valiosa para bibliotecarios y curadores de datos que deseen explorar el uso de herramientas de IA en la curación de datos o en el aumento de metadatos. Aunque los resultados no son concluyentes sobre la eficacia total de los chatbots de IA para la clasificación de metadatos, el artículo ofrece una visión importante sobre las ventajas y limitaciones de estas herramientas emergentes. En este sentido, el estudio puede servir como base para futuras investigaciones y como guía para los profesionales que están considerando integrar estas tecnologías en sus prácticas diarias.
Wheatley, Mike. “OpenAI Says It Would Jump at the Chance to Buy Chrome from Google.” SiliconANGLE, April 22, 2025. https://siliconangle.com/2025/04/22/openai-says-jump-chance-buy-chrome-google/?utm_source=flipboard&utm_content=other
Nick Turley, jefe de producto de OpenAI, declaró ante un juez en el juicio antimonopolio contra Google que su empresa estaría muy interesada en comprar el navegador Chrome si se diera la oportunidad. El Departamento de Justicia de EE.UU., tras la condena de Google por mantener un monopolio ilegal en el sector de búsquedas, propone como remedio que se obligue a la compañía a vender Chrome, argumentando que es clave en su conducta anticompetitiva.
Durante la fase de propuesta de remedios en el juicio antimonopolio que enfrenta Google en Estados Unidos, Nick Turley, jefe de producto de OpenAI, sorprendió al declarar ante el juez Amit Mehta que su empresa estaría muy interesada en adquirir el navegador Chrome si se forzara su venta. Esta afirmación se produce en un contexto en el que el Departamento de Justicia (DOJ) ha planteado medidas drásticas para reducir el poder de Google en el mercado de las búsquedas online, tras haber sido declarada culpable de prácticas monopolísticas.
Una de las medidas más polémicas sugeridas por el DOJ es precisamente la venta forzosa de Chrome, el navegador más utilizado del mundo, con cerca del 67 % del mercado y unos 3.000 millones de usuarios. El argumento del Departamento de Justicia es que Chrome actúa como una pieza fundamental en el ecosistema de servicios de Google, canalizando a los usuarios hacia su motor de búsqueda, su correo electrónico, sus servicios en la nube y sus herramientas de inteligencia artificial, lo cual refuerza su dominio del mercado y limita la competencia.
Turley, en su declaración, afirmó que OpenAI —creadora del popular modelo de lenguaje ChatGPT— no solo estaría interesada en adquirir Chrome, sino que ve en ello una oportunidad para transformar radicalmente la experiencia de navegación web, integrando de forma nativa la inteligencia artificial. Según él, ChatGPT podría incorporarse al propio navegador para asistir al usuario en sus tareas cotidianas, optimizando búsquedas, automatizando acciones o incluso generando contenido directamente desde la interfaz del navegador.
La compra de Chrome no solo permitiría a OpenAI competir en mejores condiciones con Google, sino que le brindaría acceso a una enorme base de usuarios y a valiosos datos de navegación. Estos datos, según Turley, serían fundamentales para entrenar nuevos agentes de IA capaces de operar en tiempo real sobre la web.
Además, OpenAI ya ha dado pasos en esta dirección: en noviembre contrató a Ben Goodger y Darin Fisher, antiguos ingenieros de Google que participaron en la creación y diseño de Chrome. Esto ha alimentado las especulaciones sobre el desarrollo de un navegador propio basado en Chromium, el motor de código abierto sobre el que también se construye Chrome.
No obstante, el juez Mehta ha expresado dudas sobre la viabilidad de obligar a Google a desprenderse de un producto tan central en su ecosistema. Otra posibilidad sería escindir Chrome como empresa independiente, aunque Google ha insistido en que el navegador no podría sostenerse sin su infraestructura.
Por otro lado, el DOJ también propuso como remedio que Google se vea obligada a compartir sus datos de búsqueda con competidores. Turley reveló que OpenAI intentó alcanzar un acuerdo con Google para acceder a su API de búsqueda, pero fue rechazado sin discusión. Según él, esa información permitiría a empresas emergentes como OpenAI crear productos más competitivos y acelerar la innovación en el sector.
La decisión final del juez Mehta podría marcar un hito en la regulación de los gigantes tecnológicos, reconfigurar el panorama de los navegadores web y abrir nuevas puertas para la integración entre navegación e inteligencia artificial. Mientras tanto, OpenAI se posiciona como uno de los actores más ambiciosos dispuestos a liderar ese cambio.
«En una sociedad inundada de información, confusión generada por la inteligencia artificial, desinformación y noticias falsas, los bibliotecarios son la primera y mejor línea de defensa: navegantes de confianza que nos ayudan a encontrar el sentido, la relevancia, las pruebas y el conocimiento práctico a partir de fuentes fiables.»
Abram, Stephen. “Save the Librarians.” The Lens, 2024. https://stephenslighthouse.com/2025/04/22/academic-database-comparisons/
Stephen Abram es bibliotecario y director de Lighthouse Consulting Inc. y director ejecutivo de la Federación de Bibliotecas Públicas de Ontario.
Edwards, Benj. 2025. «AI Search Engines Cite Incorrect News Sources at an Alarming 60% Rate, Study Says.» Ars Technica, March 13, 2025. https://arstechnica.com/ai/2025/03/ai-search-engines-give-incorrect-answers-at-an-alarming-60-rate-study-says/
Un estudio reciente del Tow Center for Digital Journalism de la Columbia Journalism Review ha revelado que los motores de búsqueda basados en inteligencia artificial citan incorrectamente las fuentes de noticias en más del 60 % de los casos.
El análisis se realizó con ocho herramientas de búsqueda impulsadas por IA, a las que se les pidió identificar título, editor, fecha y URL de artículos reales. Los resultados mostraron errores sistemáticos en la atribución de fuentes.
Los investigadores Klaudia Jaźwińska y Aisvarya Chandrasekar señalaron que aproximadamente uno de cada cuatro estadounidenses ya usa estos modelos como alternativa a los buscadores tradicionales, lo que agrava la preocupación sobre su fiabilidad. Entre las herramientas analizadas, Grok 3 tuvo la tasa de error más alta (94 %), mientras que ChatGPT Search falló en el 67 % de los casos y Perplexity en el 37 %. En total se realizaron 1.600 pruebas.
Una práctica común de estos modelos fue responder con seguridad aunque no tuvieran información confiable, generando respuestas plausibles pero erróneas, conocidas como confabulaciones. Además, las versiones de pago como Perplexity Pro y Grok 3 Premium cometieron errores con más frecuencia, ya que evitan negarse a responder.
El estudio también detectó que algunas herramientas ignoraron los protocolos de exclusión de robots (robots.txt), accediendo a contenidos que los editores habían solicitado explícitamente no fueran rastreados, como en el caso de National Geographic. Además, muchas veces los enlaces proporcionados llevaban a versiones sindicadas (por ejemplo, Yahoo News) en lugar del sitio original, o eran URL inventadas que conducían a páginas de error, como ocurrió en 154 de 200 enlaces proporcionados por Grok 3.
Estos problemas ponen a los editores en una situación difícil: bloquear los rastreadores puede suponer perder visibilidad, pero permitirlos implica la reutilización masiva sin retorno de tráfico.
Mark Howard, director de operaciones de Time, expresó su preocupación por la falta de control y transparencia, aunque confía en que el producto mejorará con el tiempo. También advirtió a los usuarios: “Si alguien cree que estos productos gratuitos son 100 % precisos, es culpa suya”.
OpenAI y Microsoft reconocieron la recepción del informe, pero no abordaron directamente los problemas señalados.
Bao, Honglin, Mengyi Sun, y Misha Teplitskiy. 2025. “Where There’s a Will There’s a Way: ChatGPT Is Used More for Science in Countries Where It Is Prohibited.” Quantitative Science Studies, 1–23. https://doi.org/10.1162/qss_a_00368.
El estudio demuestra que las prohibiciones geográficas no están logrando limitar el uso de ChatGPT en la producción científica. Las herramientas de inteligencia artificial están siendo ampliamente utilizadas incluso en contextos donde su uso está regulado o restringido, lo que plantea importantes desafíos para el diseño de políticas eficaces en el ámbito de la gobernanza tecnológica global. Además, pone de relieve la creciente dependencia de los investigadores en estas tecnologías para la redacción y difusión de su trabajo.
Se analiza críticamente la eficacia de las restricciones geográficas impuestas al acceso de modelos de inteligencia artificial como ChatGPT en el ámbito científico. El caso de estudio se centra en países donde el acceso a ChatGPT está oficialmente bloqueado, como China, Rusia, Irán y otros.
El estudio parte de una pregunta clave: si estas restricciones fueran realmente efectivas, ¿se detectaría un menor uso de ChatGPT en la producción científica de dichos países? Para responder a esta cuestión, los autores desarrollaron un sofisticado clasificador capaz de identificar textos redactados con asistencia de ChatGPT, utilizando como base ciertas elecciones lingüísticas características de sus primeras versiones, como el uso de palabras específicas (“delve”, “remarkably”, entre otras).
Este clasificador, entrenado con resúmenes de artículos científicos anteriores y posteriores a la aparición de ChatGPT, demostró ser más preciso que herramientas populares como GPTZero y ZeroGPT, e incluso fue validado con artículos en los que los autores habían declarado explícitamente el uso de IA.
Al aplicar este modelo a más de 170.000 preprints de plataformas de investigación como ArXiv, BioRxiv y MedRxiv, los investigadores encontraron que, para agosto de 2023, aproximadamente el 12,6% de los artículos científicos presentaban indicios de uso de ChatGPT. Sorprendentemente, el uso fue un 7,7% más alto en los países donde la herramienta estaba oficialmente restringida. Esta diferencia se produjo antes de que estuviera disponible en el mercado el primer modelo de lenguaje de gran escala desarrollado en China, lo que sugiere que los investigadores de estos países estaban utilizando métodos alternativos (como VPNs) para acceder a ChatGPT.
Además, los autores exploraron la hipótesis de si esta alta demanda de herramientas de IA en ciencia —especialmente en países asiáticos donde el inglés no es lengua oficial— podría haber impulsado un uso aún mayor en ausencia de restricciones. Los resultados confirmaron que el uso de ChatGPT era más elevado precisamente en aquellos países donde el acceso estaba prohibido, lo que refuerza la idea de que las restricciones no son efectivas y que los científicos están dispuestos a sortear los obstáculos para beneficiarse de estas herramientas.
Otro hallazgo interesante fue que el uso de ChatGPT correlacionaba con un mayor número de visualizaciones y descargas de los artículos, lo cual sugiere que podría estar influyendo en la claridad, presentación o atractivo del contenido. Sin embargo, este uso no mostró correlación con un mayor número de citas ni con una mejor colocación en revistas académicas de alto impacto.
Wiggers, Kyle. «Law Professors Side with Authors Battling Meta in AI Copyright Case.» TechCrunch, April 11, 2025. https://techcrunch.com/2025/04/11/law-professors-side-with-authors-battling-meta-in-ai-copyright-case/
Un grupo de profesores especializados en derecho de autor ha presentado un informe amicus curiae en apoyo de los autores que están demandando a Meta, acusando a la empresa de entrenar sus modelos de inteligencia artificial Llama con libros electrónicos sin permiso.
El informe, presentado el viernes en el Tribunal de Distrito de los EE.UU. para el Distrito Norte de California, sostiene que la defensa de «uso legítimo» de Meta representa una solicitud exagerada de privilegios legales que nunca se han otorgado a los autores humanos.
Según el informe, el uso de obras con derechos de autor para entrenar modelos generativos no es «transformador», ya que no se diferencia de usar las obras para educar a autores humanos, que es uno de los propósitos originales de esas obras. Además, se argumenta que el uso tiene un propósito comercial, ya que permite la creación de trabajos que compiten directamente con las obras originales.
La Asociación Internacional de Editores Científicos, Técnicos y Médicos, junto con la Copyright Alliance y Association of American Publishers., también presentaron informes de apoyo a los autores.
En el caso Kadrey v. Meta, los autores Richard Kadrey, Sarah Silverman y Ta-Nehisi Coates acusan a Meta de violar sus derechos de propiedad intelectual al utilizar sus libros electrónicos para entrenar modelos y eliminar la información de derechos de autor para ocultar la infracción. Meta, por su parte, argumenta que su uso es legítimo y que el caso debe ser desestimado por falta de legitimación activa de los autores.
El juez del Tribunal de Distrito de EE. UU. Vince Chhabria permitió que el caso siguiera adelante, aunque desestimó parte de la demanda, señalando que la alegación de infracción de derechos de autor es suficiente para que los autores tengan legitimación para demandar.
METR. «Measuring AI Ability to Complete Long Tasks.» METR, March 19, 2025. https://metr.org/blog/2025-03-19-measuring-ai-ability-to-complete-long-tasks/?utm_source=superhuman&utm_medium=newsletter&utm_campaign=claude-finally-gets-search&_bhlid=a3d8e301d66bd7aba2dd5de5253b42c092fb3f57
Este enfoque destaca la necesidad de medir la capacidad de la IA no solo en términos de sus habilidades de predicción o conocimiento, sino también en la capacidad para realizar tareas complejas a lo largo del tiempo. Los resultados de este estudio tienen implicaciones significativas tanto para las predicciones sobre el futuro de la IA como para la gestión de riesgos asociados a su adopción.
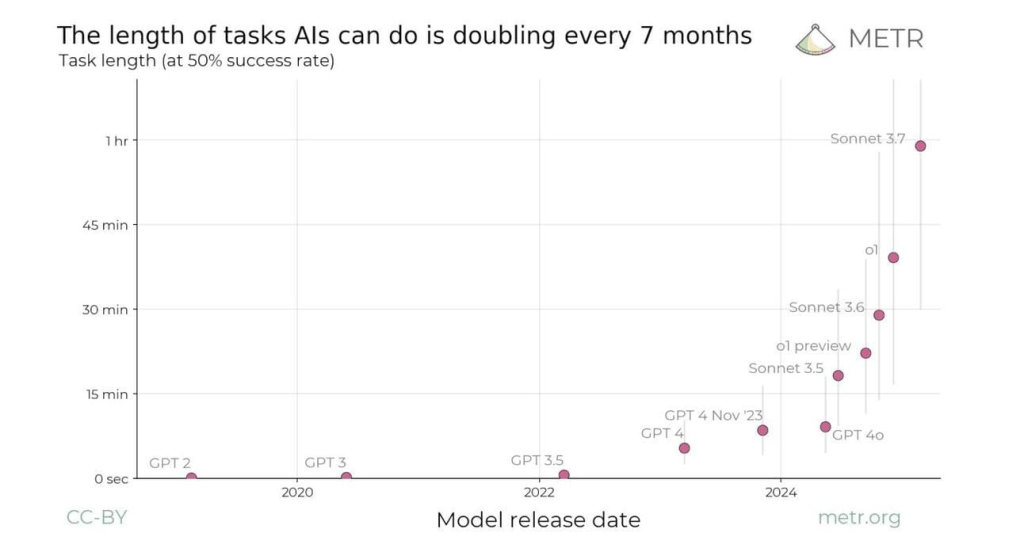
Un estudio reciente ha revelado que los modelos de inteligencia artificial (IA) de vanguardia podrían estar mejorando a un ritmo mucho más rápido de lo que se pensaba. El grupo de investigación METR ha descubierto que el tiempo que los Modelos de Lenguaje Grande (LLMs) pueden abordar tareas parece duplicarse cada siete meses, lo que es incluso más rápido que la Ley de Moore, que establece que la capacidad de los chips se duplica aproximadamente cada dos años.
Para ponerlo en perspectiva, el modelo Claude Sonnet 3.7 ahora puede realizar tareas que a los humanos les tomarían una hora, mientras que modelos como el GPT-4 de 2023 solo podían realizar tareas de cinco minutos, como buscar un hecho específico en la web. Modelos anteriores como el GPT-3.5 de 2022 solo podían hacer tareas que nos tomarían menos de un minuto, como recordar algo previamente conocido.
Si esta tendencia continúa, en uno o dos años los modelos de IA podrían ser capaces de realizar tareas de cuatro horas. Se espera que para 2029 la IA sea capaz de realizar tareas que le tomarían a los humanos un mes entero, como iniciar un negocio o hacer un nuevo descubrimiento científico. Sin embargo, dado que los LLMs son relativamente nuevos, solo se dispone de cuatro o cinco años de datos, por lo que estos resultados deben tomarse con cautela.

