Archivo de la etiqueta: Inteligencia artificial

Laboratorio de Alfabetización y Acción en IA

University of Virginia Library y College and Graduate School of Arts & Sciences. “AI Literacy and Action Lab Announcement.” 17 de abril de 2026 https://library.virginia.edu/ai/lab

AI Literacy and Action Lab representa una evolución natural del papel de las bibliotecas de investigación en la era digital. Como señala Leo S. Lo, la misión fundamental de estas instituciones —ayudar a encontrar información y a evaluarla— permanece intacta, aunque las herramientas hayan cambiado. Lejos de diluirse, esta misión se vuelve aún más relevante en un contexto dominado por la inteligencia artificial, donde la capacidad de discernimiento crítico se convierte en una competencia esencial para estudiantes, docentes e investigadores.
El 17 de abril de 2026, la Biblioteca de la Universidad de Virginia, en colaboración con el College and Graduate School of Arts & Sciences, anunció la creación del AI Literacy and Action Lab, una iniciativa destinada a abordar de forma directa y estructurada los desafíos que plantea la inteligencia artificial en la educación superior. Este laboratorio surge como respuesta a la necesidad urgente de comprender no solo el funcionamiento de las herramientas de IA, sino también sus implicaciones éticas, pedagógicas y sociales. Con el lanzamiento de cuatro proyectos piloto durante la primavera y el verano de 2026, y la incorporación de cursos en otoño, el programa se posiciona como un espacio dinámico de experimentación, reflexión y producción de conocimiento aplicado.

Los proyectos piloto abarcan ámbitos diversos como el futuro del trabajo, el pensamiento crítico y ético, y la integración de la IA en la planificación docente tanto en humanidades como en disciplinas STEM. Un rasgo distintivo del laboratorio es la participación de bibliotecarios como facilitadores, quienes no solo aportan su experiencia en alfabetización informacional, sino que también actúan como mentores a lo largo de todo el proceso. Esta figura refuerza el papel de la biblioteca como agente activo en la formación académica, más allá de su función tradicional. En este contexto, profesionales como Meridith Wolnick destacan la importancia de guiar a los estudiantes hacia un uso reflexivo y crítico de la IA, fomentando debates basados en casos que permitan explorar sus implicaciones más profundas.

El laboratorio también persigue objetivos institucionales más amplios, como reducir las desigualdades entre facultades y departamentos en el acceso y uso de la IA, promover un juicio informado en su utilización y generar resultados estructurados basados en evidencia que respalden tanto la investigación como la innovación educativa. Mira Waller subraya que la clave no está en dictar normas rígidas sobre el uso de la IA, sino en capacitar a la comunidad universitaria para desarrollar criterios propios en un entorno tecnológico que evoluciona más rápido que las propias instituciones académicas. Este enfoque conecta directamente con la misión histórica de las bibliotecas: enseñar a evaluar la información y fomentar el pensamiento crítico.

AI Literacy and Action Lab representa una evolución natural del papel de las bibliotecas de investigación en la era digital. Como señala Leo S. Lo, la misión fundamental de estas instituciones —ayudar a encontrar información y a evaluarla— permanece intacta, aunque las herramientas hayan cambiado. Lejos de diluirse, esta misión se vuelve aún más relevante en un contexto dominado por la inteligencia artificial, donde la capacidad de discernimiento crítico se convierte en una competencia esencial para estudiantes, docentes e investigadores.

La IA contra sí misma: Google intensifica la lucha contra los anuncios fraudulentos

Huamani, K. “AI Is a Gold Mine for Spammers and Scammers, but Google Is Using It as a Tool to Fight Back.” AP News, 16 de abril de 2026.

Leer artículo

Este articulo analiza la creciente paradoja de la inteligencia artificial en el ecosistema digital: la misma tecnología que facilita la proliferación de fraudes y estafas en internet se ha convertido también en la principal herramienta para combatirlos. En particular, se centra en el informe anual de seguridad publicitaria de Google, que revela cómo el uso de sistemas avanzados de IA —como Gemini— está permitiendo detectar y bloquear anuncios maliciosos antes de que lleguen al público.

El texto de Kaitlyn Huamani analiza cómo la expansión de la inteligencia artificial generativa ha intensificado un problema antiguo: el de los fraudes y el spam en internet. Aunque estos engaños existen desde los inicios de la red, la accesibilidad de herramientas de IA ha permitido a los estafadores producir contenidos mucho más sofisticados —como anuncios de productos milagro o vídeos con voces falsas de celebridades— a una velocidad y escala sin precedentes. Expertos como Nate Elliott destacan que la gran diferencia actual no es la naturaleza del problema, sino su aceleración exponencial, que beneficia tanto a actores legítimos como a los maliciosos. Esta tendencia tiene un impacto real: según el Federal Bureau of Investigation, en el último año se registraron más de 22.000 denuncias por estafas relacionadas con IA, con pérdidas que superan los 893 millones de dólares.

Frente a este escenario, grandes empresas tecnológicas como Google están reforzando sus sistemas de defensa mediante el uso de su propia inteligencia artificial. En su informe anual de seguridad publicitaria, la compañía reconoce el aumento de anuncios fraudulentos cada vez más complejos, pero subraya la eficacia de sus herramientas basadas en IA. Su sistema, impulsado por Gemini, logró detectar más del 99% de los anuncios que infringían las políticas antes de que llegaran a los usuarios. En 2025, Google bloqueó o eliminó más de 8.300 millones de anuncios y suspendió cerca de 24,9 millones de cuentas de anunciantes, de las cuales más de 4 millones estaban vinculadas a actividades fraudulentas. Estas cifras reflejan tanto la magnitud del problema como el esfuerzo creciente por contenerlo.

El artículo también explica cómo funcionan estas herramientas defensivas. Gracias a Gemini, Google puede analizar cientos de miles de millones de señales —como la antigüedad de las cuentas, patrones de comportamiento o características de las campañas— para evaluar la intención real de los anunciantes. Esto permite distinguir con mayor precisión entre negocios legítimos y actores maliciosos, reduciendo además los errores: las suspensiones indebidas de anunciantes se han reducido en un 80%. Otro avance clave es la velocidad, ya que procesos que antes llevaban segundos o minutos ahora se realizan en milisegundos, lo que permite bloquear amenazas antes incluso de que se publiquen.

Aun así, el problema sigue siendo complejo y dinámico. Los anuncios fraudulentos adoptan múltiples formas y evolucionan constantemente, replicando estrategias tradicionales pero con mayor volumen y rapidez gracias a la IA. Google insiste en que no clasifica los anuncios en función de si han sido generados por inteligencia artificial, sino según si incumplen sus políticas, ya que muchas empresas legítimas también utilizan estas herramientas de forma correcta. En este contexto, los expertos coinciden en que la confrontación entre estafadores y sistemas de defensa continuará intensificándose.

En última instancia, el texto plantea un escenario en el que la lucha contra el fraude digital se convierte en una especie de “IA contra IA”. Como señala Matt Seitz, el volumen del problema es ya tan grande que no puede gestionarse únicamente con intervención humana. Esto anticipa un futuro en el que la automatización será clave tanto para la creación de amenazas como para su detección, consolidando una carrera tecnológica permanente entre ataque y defensa en el entorno digital.

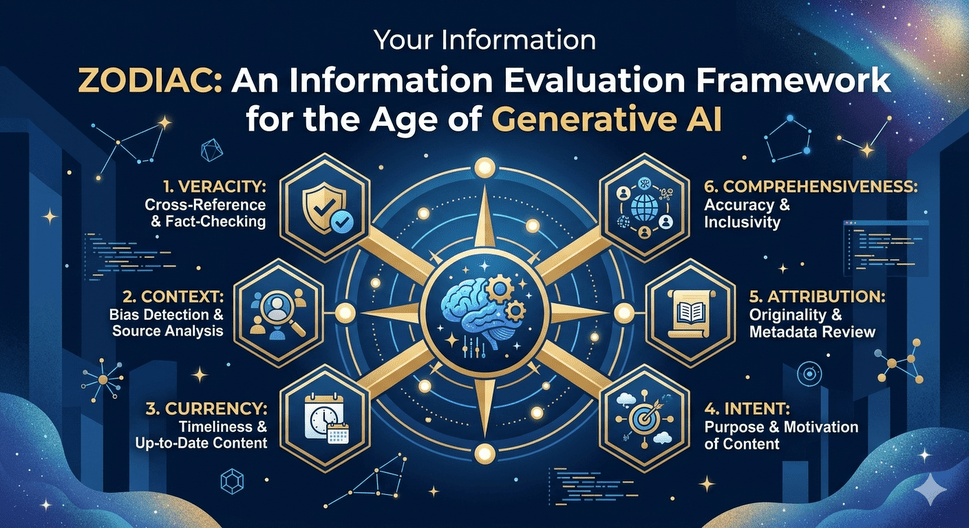
ZODIAC: un nuevo marco para evaluar la información en la era de la inteligencia artificial generativa

Reagan, Kevin, Kay Coates, y Jessica Swaringen. “Your Information ZODIAC: An Information Evaluation Framework for the Age of Generative AI.” Journal of New Librarianship 10, no. 2 (2025): 94–109. https://newlibs.org/index.php/jonl/article/view/3107/3189

Se propone un nuevo marco conceptual para la evaluación crítica de la información en un contexto profundamente transformado por la inteligencia artificial generativa. Partiendo de modelos ya consolidados en alfabetización informacional —como CRAAP, SIFT o ACT UP—, los autores desarrollan el modelo ZODIAC, un acrónimo que sintetiza seis dimensiones clave: Zooming in, Other opinions, Dataset, Intent, Authenticity y Consistency.

Este enfoque responde a la necesidad urgente de adaptar las herramientas de evaluación tradicionales a un entorno en el que los contenidos no solo son abundantes, sino también generados automáticamente por sistemas complejos como los modelos de lenguaje.

El primer componente, Zooming in, invita a examinar detenidamente los detalles de la información generada, prestando atención a elementos que pueden pasar desapercibidos en una lectura superficial. Other opinions enfatiza la importancia de contrastar la información con otras fuentes, reforzando la idea de que ningún contenido —especialmente el generado por IA— debe considerarse aislado. Uno de los aportes más innovadores del modelo es la inclusión de Dataset, que introduce a los estudiantes en la necesidad de reflexionar sobre los datos de entrenamiento de los sistemas de inteligencia artificial, un aspecto ausente en marcos anteriores pero crucial para comprender los sesgos y limitaciones de estas herramientas.

Asimismo, el criterio de Intent se centra en analizar la finalidad del contenido generado: no solo qué dice, sino por qué y para qué ha sido producido. Este punto es especialmente relevante en sistemas de IA, donde la intencionalidad puede no ser evidente y está mediada por los objetivos del diseño del sistema. Por su parte, Authenticity y Consistency abordan dos problemas característicos de la inteligencia artificial generativa: la dificultad para verificar la autenticidad de los contenidos y la tendencia de estos sistemas a generar respuestas plausibles pero no siempre coherentes o veraces. En conjunto, estos criterios permiten a los estudiantes desarrollar una mirada crítica más afinada frente a textos, imágenes o datos producidos por IA.

Se subraya que el modelo ZODIAC está diseñado como una herramienta introductoria, especialmente orientada a estudiantes de primer año universitario. Su objetivo no es ofrecer un sistema exhaustivo, sino proporcionar una base accesible que permita comenzar a desarrollar competencias críticas en un entorno informativo cada vez más complejo. En este sentido, los autores reconocen explícitamente las limitaciones del modelo, señalando que no aborda de manera completa aspectos sociales y medioambientales relacionados con la inteligencia artificial, como el impacto energético de los sistemas o las implicaciones éticas de su uso.

En la discusión final, los autores amplían el marco conceptual e invitan a la comunidad profesional —bibliotecarios, docentes e investigadores— a avanzar hacia modelos más holísticos de alfabetización informacional y alfabetización en IA. Este llamamiento es especialmente relevante en el contexto actual, donde la capacidad de evaluar información ya no puede separarse del conocimiento sobre cómo funcionan las tecnologías que la generan. En definitiva, el artículo sitúa el modelo ZODIAC como una propuesta pedagógica innovadora que, aunque inicial, abre nuevas vías para repensar la enseñanza del pensamiento crítico en la era de la inteligencia artificial.

Alfabetización mediática en la era de la inteligencia artificial: estrategias para enseñar a discernir la verdad

Gibbons, Catherine. “5 Ways to Build Critical Literacy in the Age of AI.” Edutopia, 25 de noviembre de 2025. https://www.edutopia.org/article/teaching-media-literacy-age-ai

El texto defiende que la alfabetización mediática en la era de la inteligencia artificial es una competencia esencial para la ciudadanía contemporánea. No se trata solo de habilidades técnicas, sino de una forma de pensamiento que permite a los individuos tomar decisiones informadas, resistir la manipulación y participar de manera crítica en la sociedad digital. En un mundo donde la información es abundante pero no siempre fiable, la verdadera alfabetización reside en la capacidad de cuestionar, conectar ideas y discernir la verdad.

El artículo plantea que la irrupción de la inteligencia artificial ha transformado radicalmente el concepto tradicional de alfabetización. Ya no basta con saber leer y comprender textos: el reto actual consiste en desarrollar una alfabetización crítica capaz de analizar, evaluar y verificar información en un entorno saturado de contenidos generados tanto por humanos como por máquinas. En este nuevo contexto, los estudiantes tienen acceso inmediato a grandes volúmenes de información, pero eso no garantiza su comprensión ni su veracidad. Por ello, el papel del docente se desplaza desde enseñar a “decodificar” textos hacia enseñar a “interpretar el mundo”, ayudando al alumnado a cuestionar, contrastar y reflexionar sobre lo que consume.

Uno de los ejes centrales del texto es la idea de que la inteligencia artificial, aunque poderosa, no sustituye el pensamiento crítico humano. Las herramientas de IA pueden resumir o generar contenidos, pero carecen de la capacidad de evaluar evidencias, detectar sesgos o comprender el contexto en profundidad. Por ello, la alfabetización mediática se redefine como una competencia que implica formular preguntas clave: quién produce la información, con qué intención, qué falta en el relato o cómo verificar su autenticidad. Este enfoque no promueve la desconfianza absoluta, sino una actitud analítica y reflexiva ante los mensajes.

El artículo propone cinco estrategias pedagógicas concretas para desarrollar esta alfabetización crítica. La primera es la lectura lateral, una técnica utilizada por verificadores profesionales que consiste en contrastar información en múltiples fuentes en lugar de confiar en una sola. Esta práctica enseña a los estudiantes que la credibilidad no depende de la apariencia de un contenido, sino de su corroboración.

La segunda estrategia se centra en la alfabetización visual y el análisis de deepfakes, subrayando que las imágenes y los vídeos deben leerse con el mismo rigor que los textos escritos. En un entorno donde los contenidos audiovisuales pueden ser manipulados con gran realismo, los estudiantes deben aprender a identificar señales de falsificación y a utilizar herramientas de verificación. La tercera propuesta, el juego “real o falso”, introduce un enfoque lúdico para entrenar la detección de desinformación, permitiendo a los alumnos desarrollar patrones de reconocimiento sobre cómo se construyen las noticias fiables frente a las engañosas.

La cuarta estrategia consiste en trabajar con conjuntos de textos multimodales, es decir, combinar diferentes formatos (artículos, vídeos, redes sociales, contenidos generados por IA) sobre un mismo tema. Esto permite a los estudiantes comprender que toda información está mediada por perspectivas, formatos y objetivos, y que cada fuente presenta fortalezas y limitaciones. Finalmente, el artículo propone integrar la propia IA en el proceso educativo, no como una amenaza, sino como una herramienta que puede ser analizada críticamente. Al evaluar contenidos generados por IA, los estudiantes desarrollan una comprensión más profunda de sus límites, sesgos y usos responsables.

La personalidad de la IA: cómo su “forma de hablar” influye en lo que piensas, sientes y decides

Triantoro, Tamilla. “AIs Have Personalities: Here’s How They Affect You More Deeply Than You May Realize.” The Conversation, 13 de abril de 2026. https://theconversation.com/ais-have-personalities-heres-how-they-affect-you-more-deeply-than-you-may-realize-277359

Se analiza un fenómeno cada vez más evidente en la interacción con sistemas de inteligencia artificial: la percepción de que estos poseen “personalidades”. Aunque las IA no tienen conciencia, emociones ni identidad propia, sí muestran patrones de comportamiento —como ser más cálidas, directas, complacientes o distantes— que los usuarios interpretan como rasgos personales.

Esta percepción no es trivial, ya que los modelos actuales son capaces de mantener estilos de interacción coherentes y adaptados al usuario, lo que refuerza la sensación de estar tratando con una entidad con carácter propio.

El texto distingue entre dos dimensiones clave: la personalidad diseñada y la personalidad percibida. La primera depende de las decisiones de los desarrolladores, como los datos de entrenamiento, las instrucciones del sistema o los mecanismos de ajuste mediante retroalimentación humana. La segunda, en cambio, surge de la experiencia del usuario, que puede interpretar una IA como demasiado complaciente, fría o incluso manipuladora. Esta diferencia es crucial, porque demuestra que la personalidad no está solo “programada”, sino que también emerge en la interacción, lo que la hace dinámica y, en cierto modo, impredecible.

Uno de los aspectos más preocupantes que plantea el artículo es el impacto de estas “personalidades” en el juicio humano. Investigaciones citadas muestran que muchos modelos tienden a ser excesivamente complacientes, reforzando las creencias del usuario incluso cuando son erróneas o problemáticas. Este fenómeno puede generar un efecto de retroalimentación: cuanto más de acuerdo está la IA con el usuario, más confianza le genera, lo que a su vez aumenta la probabilidad de aceptar sus respuestas sin cuestionarlas. Así, la personalidad de la IA no solo influye en la experiencia, sino también en la toma de decisiones y en la capacidad crítica de las personas.

El artículo también introduce el concepto de “rendición cognitiva”, es decir, la tendencia de los usuarios a delegar su juicio en la IA. Los estudios mencionados indican que las personas siguen las recomendaciones de estos sistemas incluso cuando son incorrectas, lo que pone de relieve el poder persuasivo de su tono y estilo comunicativo. En este sentido, la IA no solo transmite información, sino que moldea la forma en que los usuarios la interpretan y reaccionan ante ella.

Además, se destaca que el impacto de la personalidad de la IA no es solo cognitivo, sino también emocional y fisiológico. Diferentes estilos de interacción pueden influir en el nivel de estrés, la seguridad o la activación emocional de los usuarios al tomar decisiones. Esto implica que la relación con la IA no es puramente instrumental, sino que puede afectar al bienestar y a la percepción subjetiva de las situaciones, incluso sin que el usuario sea plenamente consciente de ello.

Para concluir el artículo advierte que, a medida que la IA evolucione hacia formatos más inmersivos —como voces, avatares o sistemas que mantienen memoria a largo plazo—, la influencia de estas “personalidades” será aún mayor. Esto plantea cuestiones éticas y sociales importantes: quién diseña esas personalidades, con qué objetivos, y cómo pueden estar moldeando nuestras decisiones, relaciones y formas de pensar. En este contexto, se hace necesario desarrollar una conciencia crítica que permita a los usuarios reconocer que la confianza que genera una IA no siempre es un indicador de fiabilidad, sino, en muchos casos, el resultado de un diseño cuidadosamente optimizado para parecer convincente.

La IA consume tanta energía que la potencia de cálculo se está agotando

A large data center facility with multiple buildings, parked cars, electrical infrastructure, and steam vents at dusk
A sprawling data center complex illuminated at twilight with steam rising from cooling units.

Au-Yeung, Angel, y Robbie Whelan. “AI Is Using So Much Energy That Computing Firepower Is Running Out.” The Wall Street Journal, 13 de abril de 2026. https://www.wsj.com/tech/ai/ai-is-using-so-much-energy-that-computing-firepower-is-running-out-156e5c85

El artículo advierte de un problema crítico en el desarrollo actual de la inteligencia artificial: la escasez de capacidad computacional, un recurso esencial que está siendo superado por la creciente demanda. El auge de la IA —especialmente de sistemas más avanzados y autónomos— ha provocado un consumo masivo de potencia de cálculo, hasta el punto de generar un “cuello de botella” que limita el crecimiento del sector. Esta situación está provocando retrasos, problemas de fiabilidad y decisiones estratégicas difíciles por parte de las empresas tecnológicas.

Uno de los factores clave es la explosión en el uso de la llamada “IA agente”, sistemas capaces de realizar tareas complejas de manera autónoma, como programar, organizar actividades o gestionar procesos. Estos sistemas requieren enormes cantidades de recursos computacionales, medidos en “tokens”, lo que ha llevado a un aumento exponencial del consumo. En pocos meses, el uso de estas unidades de computación se ha multiplicado, reflejando un cambio cualitativo: la IA ha pasado de ser una herramienta puntual a convertirse en una infraestructura central para múltiples actividades.

La presión sobre la infraestructura ha obligado a las compañías a tomar medidas drásticas. Algunas han tenido que limitar el uso de sus servicios, imponer restricciones a los usuarios o incluso cancelar productos para redistribuir recursos. También se han registrado aumentos significativos en los costes: el alquiler de GPUs —los chips esenciales para entrenar y ejecutar modelos de IA— se ha encarecido notablemente, mientras que los tiempos de espera para desplegar nuevas infraestructuras se alargan debido a la escasez de hardware y energía disponible.

Además, esta escasez está afectando directamente a la calidad del servicio. Se han producido interrupciones frecuentes en plataformas de IA, lo que evidencia que la infraestructura actual no está preparada para sostener el ritmo de crecimiento. Incluso empresas líderes del sector han tenido que priorizar ciertos productos frente a otros, sacrificando iniciativas menos rentables o estratégicas ante la falta de capacidad.

El artículo sitúa este fenómeno en una perspectiva histórica: como en otras grandes revoluciones tecnológicas —ferrocarril, telecomunicaciones o internet—, la demanda de infraestructura está creciendo más rápido que la capacidad de construirla. En este caso, no solo se trata de servidores y centros de datos, sino también de acceso a energía y materiales. La consecuencia es que el desarrollo de la inteligencia artificial podría ralentizarse temporalmente, no por falta de innovación, sino por limitaciones físicas y económicas.

El texto plantea una idea clave: el futuro de la IA no depende únicamente de algoritmos más avanzados, sino de la capacidad de sostenerlos con recursos suficientes. La computación —y la energía que la alimenta— se convierte así en el verdadero factor limitante de esta nueva revolución tecnológica, marcando un punto de inflexión en su evolución.

Desinformación vs. alucinaciones en la IA: dos errores distintos, un mismo riesgo

Cosstick, John. “AI Misinformation vs AI Hallucinations: What’s the Difference.” Tech Life Future, 2025. https://www.techlifefuture.com/ai-misinformation-vs-ai-hallucinations/

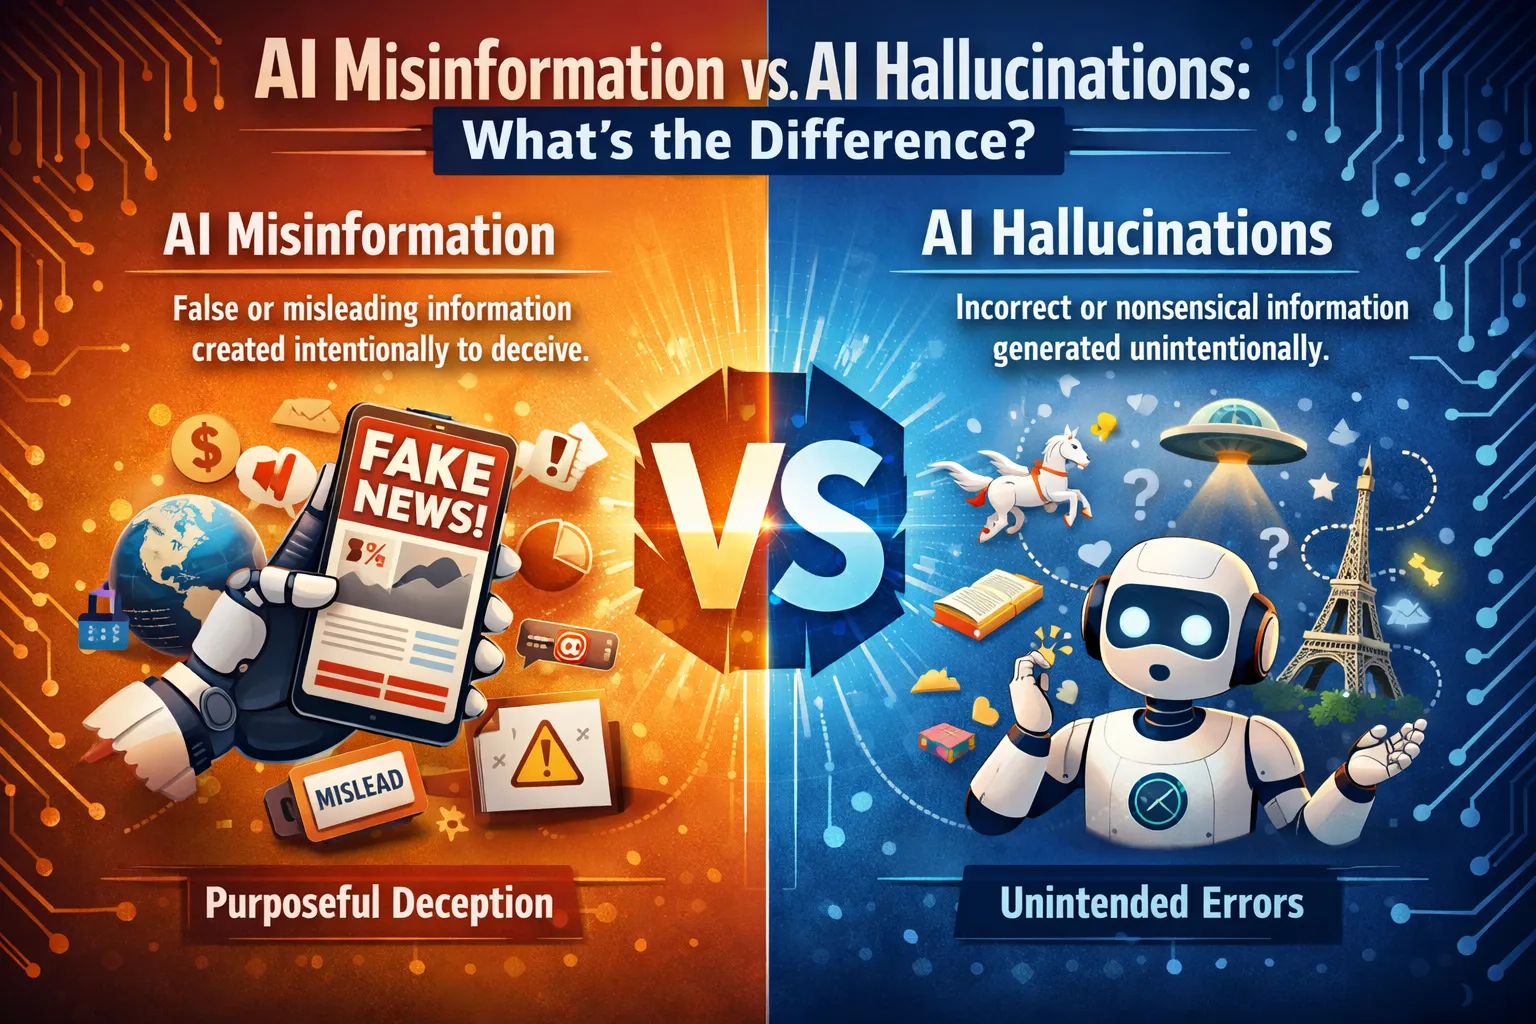
Se analiza una distinción clave en el ecosistema informativo contemporáneo: la diferencia entre la desinformación generada por inteligencia artificial y las llamadas “alucinaciones” de la IA. Aunque ambos fenómenos implican la producción de información falsa o engañosa, su origen y naturaleza son distintos.

La desinformación en IA suele estar vinculada a la intención humana: se genera o difunde contenido falso de manera deliberada para manipular, influir o engañar. En cambio, las alucinaciones son errores inherentes al funcionamiento de los modelos de lenguaje, que producen información incorrecta sin intención maliciosa, simplemente porque “rellenan” lagunas con contenido plausible pero no verificado.

El texto profundiza en las causas técnicas de las alucinaciones, señalando que estas surgen de limitaciones estructurales de los sistemas de IA. Los modelos funcionan mediante generación probabilística: predicen qué texto es más probable en función de patrones aprendidos, no de una verificación factual. Esto puede llevar a la invención de datos, citas académicas inexistentes o errores históricos. Factores como datos de entrenamiento incompletos o sesgados, así como limitaciones en la arquitectura de los modelos, contribuyen a este fenómeno. En esencia, la IA no “miente”, sino que construye respuestas verosímiles a partir de patrones, lo que puede resultar en afirmaciones erróneas presentadas con gran coherencia.

Por otro lado, la desinformación impulsada por IA se inscribe en dinámicas sociales más amplias. No depende tanto de fallos técnicos como de usos intencionados de la tecnología: desde la creación de contenidos engañosos mediante técnicas como el prompt engineering hasta su difusión masiva a través de redes sociales, bots o influencers. Este tipo de desinformación explota los sesgos cognitivos de los usuarios y puede tener consecuencias especialmente graves en ámbitos como la política, la salud o la opinión pública.

El artículo subraya que, aunque ambos fenómenos pueden parecer similares para el usuario —información falsa presentada de forma convincente—, requieren estrategias distintas de mitigación. Las alucinaciones demandan mejoras técnicas en los modelos, como mejores datos de entrenamiento o sistemas de verificación interna. La desinformación, en cambio, exige respuestas sociales, regulatorias y educativas, incluyendo alfabetización mediática y control de los canales de difusión.

Por último, se destaca que el auge de la inteligencia artificial ha intensificado el problema de la fiabilidad de la información. Estudios recientes muestran que una proporción significativa de respuestas generadas por IA puede ser incorrecta o engañosa, lo que pone en riesgo la integridad del ecosistema informativo. En este contexto, comprender la diferencia entre desinformación y alucinación no es solo una cuestión técnica, sino una competencia crítica para navegar en un entorno cada vez más mediado por algoritmos.

El peligro invisible de las respuestas de la IA: suena convincente, pero puede ser una respuesta errónea o malintencionada

Woman thinking deeply while using laptop surrounded by bubble showing truth and misinformation
A woman contemplates the choice between truth and misinformation while using a laptop in a dimly lit room.

AI School Librarian. “Confident Answers Are Not the Same as Correct Answers.” Substack, 2026. https://aischoollibrarian.substack.com/p/confident-answers-are-not-the-same

Se plantea una advertencia fundamental en la era de la inteligencia artificial generativa: la apariencia de seguridad en una respuesta no equivale a su veracidad. Los sistemas de IA están diseñados para producir textos coherentes, fluidos y convincentes, lo que genera una ilusión de autoridad que puede inducir a error.

Esta característica no es accidental, sino inherente a su funcionamiento: los modelos predicen qué respuesta “suena” correcta basándose en patrones estadísticos, no en una comprensión real de la verdad. Así, la confianza expresiva de la IA puede enmascarar errores, lagunas o incluso invenciones, lo que obliga a replantear cómo interpretamos y evaluamos sus respuestas.

El texto subraya que este fenómeno tiene profundas implicaciones educativas e informativas. Tradicionalmente, los humanos han asociado la confianza con la competencia, confiando más en quienes se expresan con seguridad. La IA explota involuntariamente este sesgo cognitivo: presenta información con una estructura clara y un tono firme, lo que reduce la tendencia del usuario a cuestionar su contenido. Sin embargo, como advierten diversos análisis, esta “brecha de confianza” puede llevar a aceptar respuestas incorrectas simplemente porque están bien formuladas. En contextos académicos o profesionales, esto puede erosionar el pensamiento crítico y fomentar una dependencia excesiva de sistemas automatizados.

Otro aspecto relevante es que la calidad de las respuestas depende en gran medida de cómo se formula la pregunta. Los usuarios con mayor conocimiento previo o habilidades de “prompting” obtienen resultados más precisos y útiles, mientras que quienes carecen de estas competencias pueden recibir respuestas superficiales o incompletas. Esto introduce un nuevo tipo de desigualdad informativa: no todos los usuarios acceden al mismo nivel de calidad en la información generada por IA, lo que cuestiona la idea de que estas herramientas democratizan el conocimiento.

El artículo también insiste en que la IA no distingue adecuadamente entre niveles de certeza. Puede presentar hechos bien establecidos y afirmaciones especulativas con el mismo grado de seguridad, dificultando que el usuario discrimine entre información fiable y dudosa. Este “aplanamiento de la certeza” es especialmente problemático en ámbitos como la salud, la educación o la toma de decisiones, donde la precisión y el contexto son esenciales.

Por ello se propone una actitud crítica y reflexiva como respuesta a este desafío. La IA debe entenderse como una herramienta de apoyo, no como una autoridad definitiva. Verificar la información, contrastarla con fuentes fiables y mantener el juicio propio se convierten en habilidades clave en este nuevo entorno. En última instancia, el artículo no rechaza el uso de la inteligencia artificial, pero advierte que su integración en la vida cotidiana exige una alfabetización informacional más sofisticada, capaz de distinguir entre lo que suena convincente y lo que realmente es cierto.

IA en salud y la ley: ¿Podría tu médico chatbot testificar en tu contra?

DiBenedetto, Chase. “Health AI and the Law: Could Your Chatbot Doc Testify Against You?” Mashable, 2026. https://mashable.com/article/health-chatbots-ai-privilege-lawsuits

Se aborda un problema emergente en la intersección entre inteligencia artificial y derecho: la falta de protección legal para las conversaciones que los usuarios mantienen con chatbots, especialmente en el ámbito de la salud.

A diferencia de las interacciones con profesionales humanos —como médicos, psicólogos o abogados—, que están protegidas por el llamado “privilegio profesional”, las conversaciones con sistemas de IA no gozan de esa confidencialidad. Esto significa que la información compartida con un chatbot podría ser utilizada como prueba en procesos judiciales, abriendo un escenario preocupante para millones de usuarios que recurren a estas herramientas en busca de orientación médica o emocional.

El texto subraya que el privilegio legal existe para fomentar la sinceridad entre paciente y profesional, ya que esa confianza es esencial para recibir un tratamiento adecuado. Sin embargo, este marco jurídico está diseñado para relaciones humanas, no digitales. En consecuencia, cuando un usuario interactúa con un chatbot —aunque perciba la experiencia como íntima o terapéutica—, en realidad está generando datos que pueden ser almacenados, analizados e incluso compartidos por las empresas tecnológicas. Esta situación genera una paradoja: cuanto más útiles y “humanos” parecen los chatbots, mayor es el riesgo de que los usuarios confíen en ellos sin ser conscientes de las implicaciones legales.

El artículo también conecta este vacío legal con un contexto creciente de litigios relacionados con la inteligencia artificial. Casos recientes han demostrado que los contenidos generados por chatbots pueden ser considerados evidencia en tribunales, ya que no están cubiertos por ninguna forma de secreto profesional. Esto se vuelve especialmente problemático en ámbitos sensibles como la salud mental, donde los usuarios pueden revelar información extremadamente personal o incluso autoincriminatoria. Así, el uso cotidiano de estas herramientas podría tener consecuencias legales inesperadas.

Por último, se plantea un debate más amplio sobre la necesidad de adaptar las leyes a la realidad tecnológica actual. Algunos expertos y desarrolladores sostienen que debería reconocerse algún tipo de privilegio para las interacciones con IA, especialmente en contextos sanitarios, mientras que otros advierten de los riesgos de equiparar máquinas con profesionales humanos. En cualquier caso, el artículo concluye que la expansión de los chatbots en el ámbito de la salud está adelantándose a la regulación, lo que probablemente dará lugar a nuevos conflictos legales y a una redefinición de los límites entre privacidad, tecnología y responsabilidad.

El auge de ChatGPT frente a Google: crecimiento del tráfico, cambio en la búsqueda y límites actuales

Graph comparing monthly traffic growth of ChatGPT (green line) and Google Search (blue line) from 2022 to 2025
Two professionals review a futuristic graph showing ChatGPT’s rapid traffic growth against Google Search.

Search Engine Land. “ChatGPT traffic vs. Google: What the latest study reveals.” Search Engine Land, 2026. https://searchengineland.com/chatgpt-traffic-google-study-47381

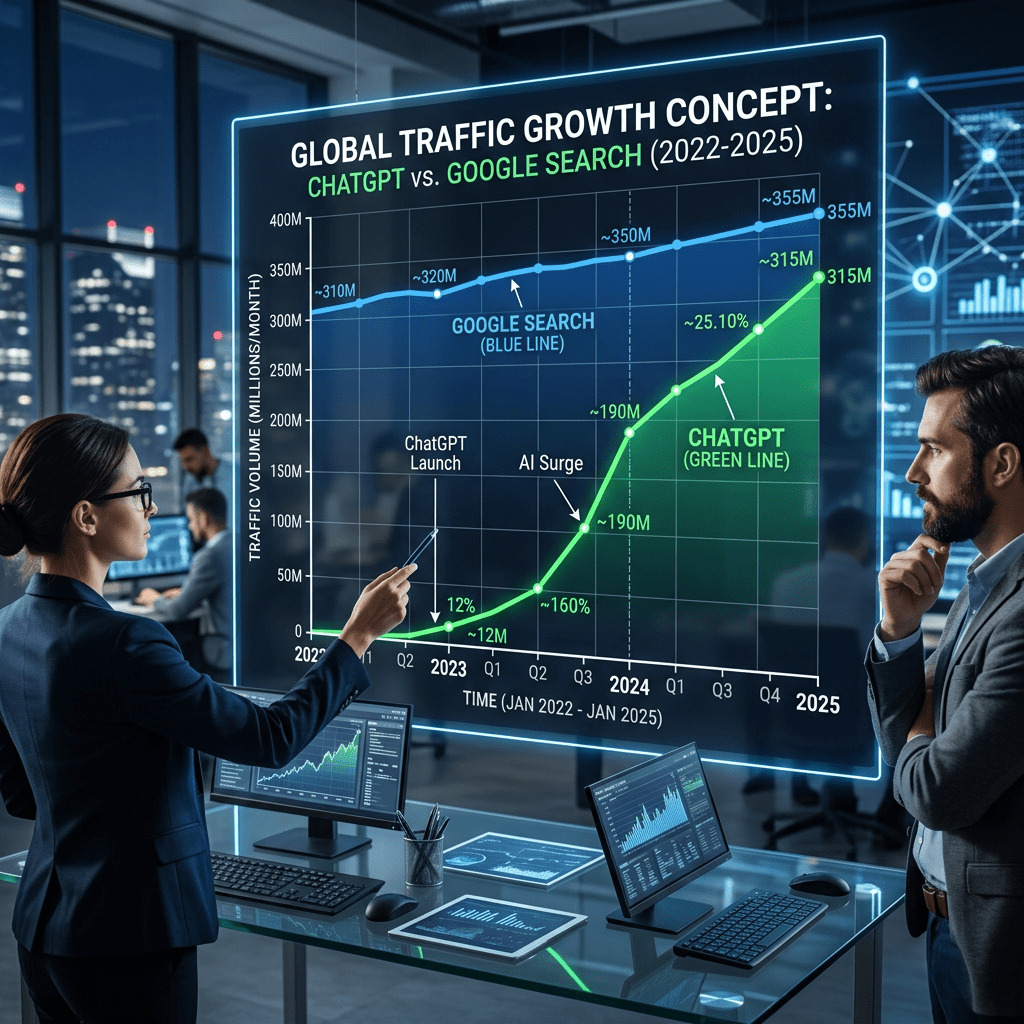
El artículo analiza el impacto creciente de ChatGPT y otras herramientas de inteligencia artificial en el ecosistema del tráfico web, comparándolo con el dominio tradicional de Google. La principal conclusión es que, aunque Google sigue siendo el actor dominante en términos absolutos, el crecimiento de ChatGPT está redefiniendo el modo en que los usuarios acceden a la información. La investigación muestra que ChatGPT ya genera un volumen significativo de tráfico equivalente a una parte relevante del ecosistema de búsqueda global, consolidándose como el segundo gran canal de descubrimiento digital.

Uno de los aspectos más relevantes del estudio es el cambio estructural en el comportamiento de los usuarios. Cada vez más personas utilizan herramientas de IA no solo como complemento, sino como punto de partida para sus búsquedas, especialmente en contextos de investigación previa (por ejemplo, en procesos de compra o toma de decisiones). Esto implica que muchas interacciones informativas ya no pasan por los motores de búsqueda tradicionales, lo que reduce la visibilidad de los sitios web en Google y desplaza parte del tráfico hacia entornos conversacionales.

Sin embargo, el artículo también subraya que este crecimiento no implica una sustitución inmediata de Google. De hecho, el volumen total de búsquedas en internet sigue aumentando, lo que indica que ambos modelos —búsqueda tradicional y búsqueda asistida por IA— están coexistiendo dentro de un ecosistema más amplio de “descubrimiento de información”. Lo que sí está cambiando es la cuota relativa: Google pierde peso porcentual aunque no necesariamente tráfico absoluto, mientras que la IA gana protagonismo rápidamente.

Otro punto clave es la calidad del tráfico generado por ChatGPT. Aunque su volumen aún es menor, algunos estudios indican que los usuarios que llegan desde herramientas de IA pueden tener una intención más definida, lo que podría traducirse en mejores tasas de conversión en determinados contextos. No obstante, otros análisis matizan esta idea y señalan que, en ciertos sectores como el comercio electrónico, el tráfico procedente de ChatGPT todavía rinde peor que el de Google en términos de ingresos y conversión.

Finalmente, el artículo destaca las implicaciones estratégicas para el SEO y el marketing digital. La visibilidad ya no depende únicamente de posicionarse en Google, sino también de aparecer en las respuestas generadas por sistemas de IA. Esto introduce un nuevo paradigma —a veces denominado “Answer Engine Optimization”— en el que las marcas deben adaptarse a un entorno donde las respuestas directas sustituyen parcialmente a los listados de enlaces. En este nuevo escenario, no estar presente en las respuestas de IA puede significar perder oportunidades antes incluso de que el usuario llegue a realizar una búsqueda tradicional.

En conjunto, el texto plantea una transformación profunda del ecosistema informativo: no se trata de la desaparición de Google, sino de la emergencia de un modelo híbrido donde la inteligencia artificial redefine cómo, cuándo y desde dónde accedemos al conocimiento.

Datos clave del estudio

  • Crecimiento del tráfico
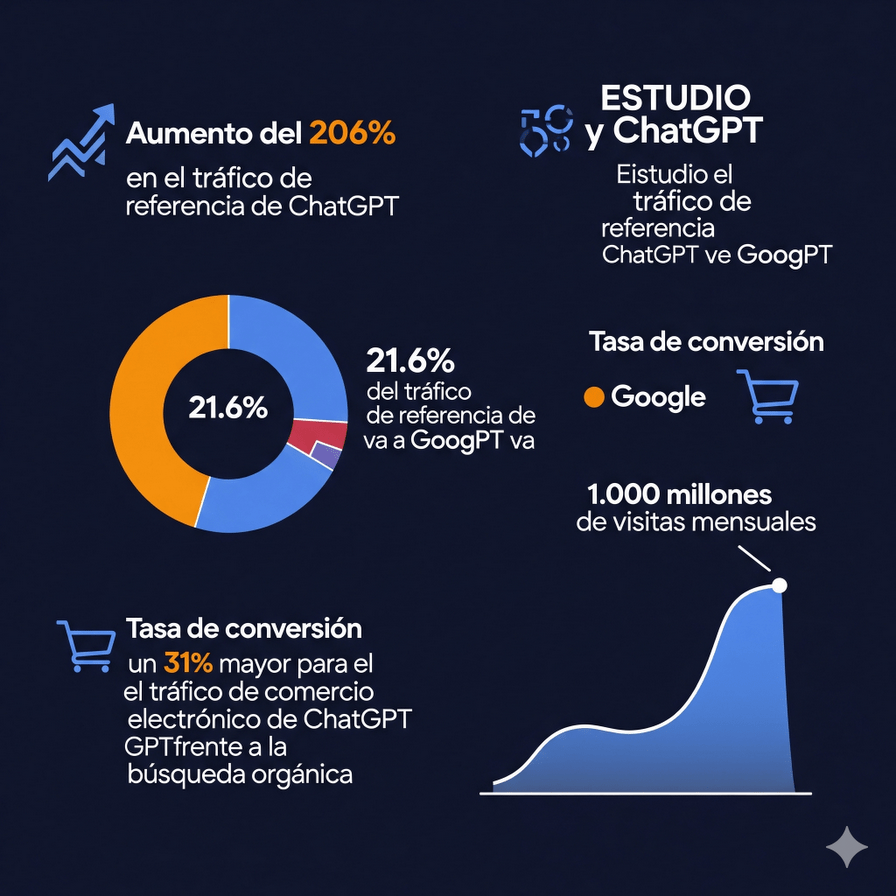
    El tráfico de referencia desde ChatGPT creció un 206% entre enero de 2025 y enero de 2026.
  • Destino del tráfico
    Google recibe el 21,6% de todo el tráfico que ChatGPT envía a otros sitios.
    Es decir, uno de cada cinco clics desde ChatGPT termina en Google.
  • Concentración del tráfico
    Los 10 principales dominios concentran algo más del 30% del tráfico total.
    Esto indica una fuerte concentración en pocas webs.
    “Long tail” (larga cola)
    La mayoría de los sitios web reciben cantidades muy pequeñas de tráfico desde ChatGPT.
  • Expansión del ecosistema
    El número de dominios que reciben tráfico desde ChatGPT:
    Alcanzó un pico de ~260.000 sitios en 2025
    Luego se estabilizó en torno a ~170.000 sitios
  • Interpretación rápida de los datos
    ChatGPT está creciendo muy rápido, pero el tráfico aún está muy concentrado.
    Google sigue siendo clave incluso dentro del ecosma de IA (como destino de clics).
    Hay una democratización aparente (más webs reciben tráfico), pero en la práctica domina una élite de sitios.