Retraction Watch Staff, “AI research’s ‘synthetic validity’ problem”, Retraction Watch, 19 de septiembre de 2026. Artículo original en Retraction Watch
El problema ya no consiste únicamente en detectar artículos falsos o textos generados por IA. El reto es garantizar que los datos, métodos, referencias y evidencias que sustentan la investigación sean verificables y tengan validez respecto al fenómeno real que pretenden estudiar. La expansión de la IA hace que esta tarea sea todavía más importante.
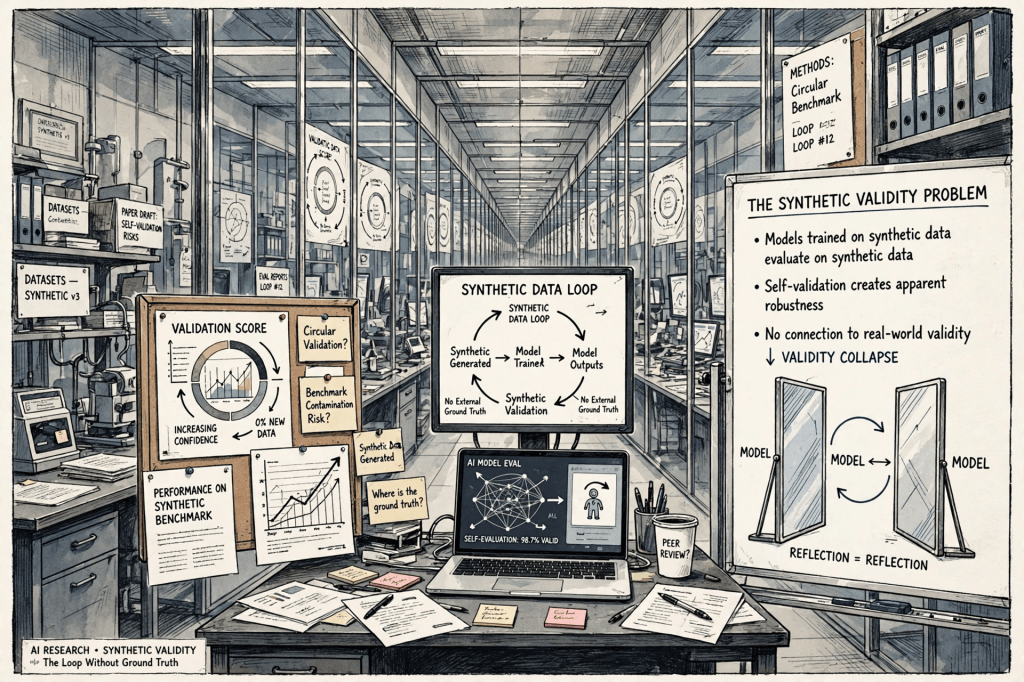
Especialmente relevante para el ámbito de la IA y la comunicación científica es la referencia al problema de la “synthetic validity”. El concepto alude a una dificultad creciente: los investigadores pueden utilizar modelos generativos para producir datos, participantes simulados, respuestas, textos u otros materiales que presentan una apariencia estadísticamente plausible, pero cuya correspondencia con el mundo real puede ser limitada. El problema no es solamente si los datos sintéticos son técnicamente coherentes, sino hasta qué punto permiten extraer conclusiones válidas sobre personas, comportamientos o fenómenos reales.
Esta cuestión adquiere especial importancia a medida que la IA generativa se incorpora a experimentos, encuestas, simulaciones y procesos de investigación. Una investigación puede obtener resultados internamente consistentes utilizando datos artificiales y, sin embargo, presentar una validez externa limitada. La posibilidad de generar grandes cantidades de respuestas sintéticas también puede facilitar estudios rápidos y baratos, pero introduce la necesidad de demostrar que los resultados no son simplemente un reflejo de los patrones incorporados en los propios modelos de IA.
La integridad científica depende de toda una cadena de controles, desde el diseño de la investigación y la recogida de datos hasta la revisión por pares, la publicación, las citaciones y la posterior corrección del registro científico. La aparición de la IA añade nuevas dificultades, pero no sustituye problemas tradicionales como las autorías fraudulentas, los datos inconsistentes, las referencias incorrectas o la ausencia de aprobación ética.
La IA introduce un nuevo problema: datos plausibles pero artificiales. La cuestión de la synthetic validity resulta particularmente importante para la alfabetización en IA. Un modelo generativo puede producir miles de respuestas aparentemente humanas y coherentes; sin embargo, que una respuesta sea verosímil no significa que represente a una población real. Esto obliga a los investigadores a diferenciar entre precisión estadística, coherencia interna y validez empírica.
Existe además el riesgo de crear un círculo de retroalimentación: los modelos se entrenan con datos producidos por seres humanos; posteriormente generan nuevos datos sintéticos; esos datos pueden utilizarse para entrenar, evaluar o alimentar otros modelos; y finalmente los resultados artificiales pueden volver a incorporarse al ecosistema científico. Si este proceso no se controla, la investigación podría terminar utilizando datos derivados de otros datos sintéticos sin una conexión suficientemente sólida con la realidad empírica original.
En investigación social, educativa o bibliométrica, por ejemplo, utilizar participantes sintéticos podría generar resultados que parecen convincentes pero que no necesariamente reproducen las características, sesgos y comportamientos de personas reales. El riesgo aumenta si los resultados generados artificialmente se utilizan posteriormente como evidencia para nuevas investigaciones. De este modo puede aparecer un círculo de retroalimentación en el que los modelos entrenados con información humana generan nuevos datos que posteriormente se utilizan para entrenar o evaluar otros modelos.
El artículo resulta especialmente útil porque conecta tres problemas que normalmente se analizan por separado: la integridad de las publicaciones, la creciente utilización de IA y la necesidad de preservar la confianza en el registro científico. Retraction Watch recuerda además que su base de datos ya supera las 67.000 retractaciones, una cifra que refleja la dimensión acumulativa de los mecanismos de corrección de la literatura científica.

