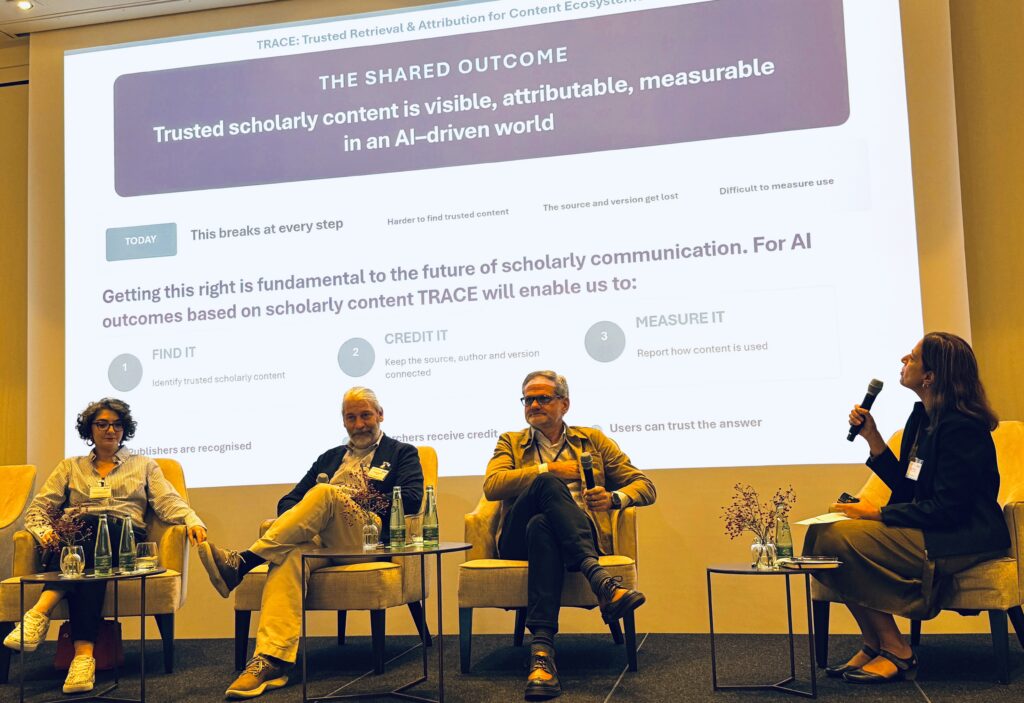
Carpenter, Todd A. (2026, 7 de octubre). “TRACE Project Launches to Advance AI Interoperability”. The Scholarly Kitchen. Society for Scholarly Publishing. Enlace al artículo original: https://scholarlykitchen.sspnet.org/2026/10/07/trace-project-launches-to-advance-ai-interoperability/
TRACE representa un paso hacia una infraestructura científica preparada para la inteligencia artificial. Su éxito dependerá de que los estándares desarrollados sean interoperables, suficientemente flexibles para funcionar con diferentes arquitecturas tecnológicas y adoptados por los principales actores del ecosistema. Aunque la iniciativa no pretende resolver por sí sola todos los problemas relacionados con los derechos de autor, el control de acceso o la atribución dentro de los modelos de IA, sí busca establecer una base común para que la recuperación y reutilización de información científica sean más transparentes, medibles y fiables.
TRACE (Trusted Retrieval & Attribution for Content Ecosystems), una iniciativa internacional impulsada por diferentes organizaciones del ámbito de la comunicación científica para mejorar la interoperabilidad, la transparencia y la fiabilidad de los sistemas de inteligencia artificial que utilizan publicaciones académicas. Su objetivo es desarrollar una infraestructura técnica compartida que permita identificar las fuentes utilizadas por la IA, preservar la atribución de los contenidos y medir de forma coherente cómo los sistemas automatizados acceden a la información científica y la reutilizan. La iniciativa responde a una transformación profunda de la comunicación académica: los investigadores recurren cada vez más a asistentes inteligentes capaces de recuperar, resumir, comparar y sintetizar documentos, sin necesidad de consultar directamente las publicaciones originales.
TRACE comienza con tres líneas de trabajo complementarias. La primera, vinculada a COUNTER, busca mejorar las métricas de uso de los contenidos científicos en entornos de inteligencia artificial, incluyendo las consultas y recuperaciones realizadas por agentes automatizados. La segunda, coordinada por NISO (National Information Standards Organization), se centra en desarrollar un modelo mínimo de metadatos que permita conservar la procedencia de los documentos y fragmentos utilizados por los sistemas de IA. La tercera, impulsada por STM e Ithaka S+R, estudia cómo los agentes de inteligencia artificial descubren las publicaciones científicas, acceden a ellas mediante los permisos correspondientes y registran su utilización de manera verificable.
Uno de los principales problemas que aborda la iniciativa es la dificultad de comprobar el origen de las afirmaciones generadas por la IA. Los modelos pueden producir referencias inexistentes, atribuir información a fuentes equivocadas o elaborar respuestas sin establecer una conexión verificable entre sus afirmaciones y los documentos originales. Para afrontar esta situación, TRACE pretende favorecer el desarrollo de estándares que mantengan vinculados los contenidos recuperados con sus fuentes, sus metadatos y las condiciones de utilización. No se trata únicamente de reducir errores, sino también de reforzar la integridad científica, facilitar la verificación de los resultados y garantizar el reconocimiento del trabajo de autores y editores.
El proyecto también plantea la necesidad de adaptar los sistemas tradicionales de evaluación y gestión de recursos electrónicos a un escenario en el que parte del consumo de información se produce a través de agentes automatizados. Las bibliotecas universitarias y los editores necesitan conocer cómo se utilizan sus colecciones, qué contenidos recuperan los asistentes inteligentes y qué repercusiones tiene este uso en los modelos de suscripción, acceso abierto y financiación de la comunicación científica. Para ello, TRACE promueve una mayor coordinación entre editoriales, repositorios, proveedores tecnológicos, desarrolladores de IA y organizaciones responsables de los estándares de información.

