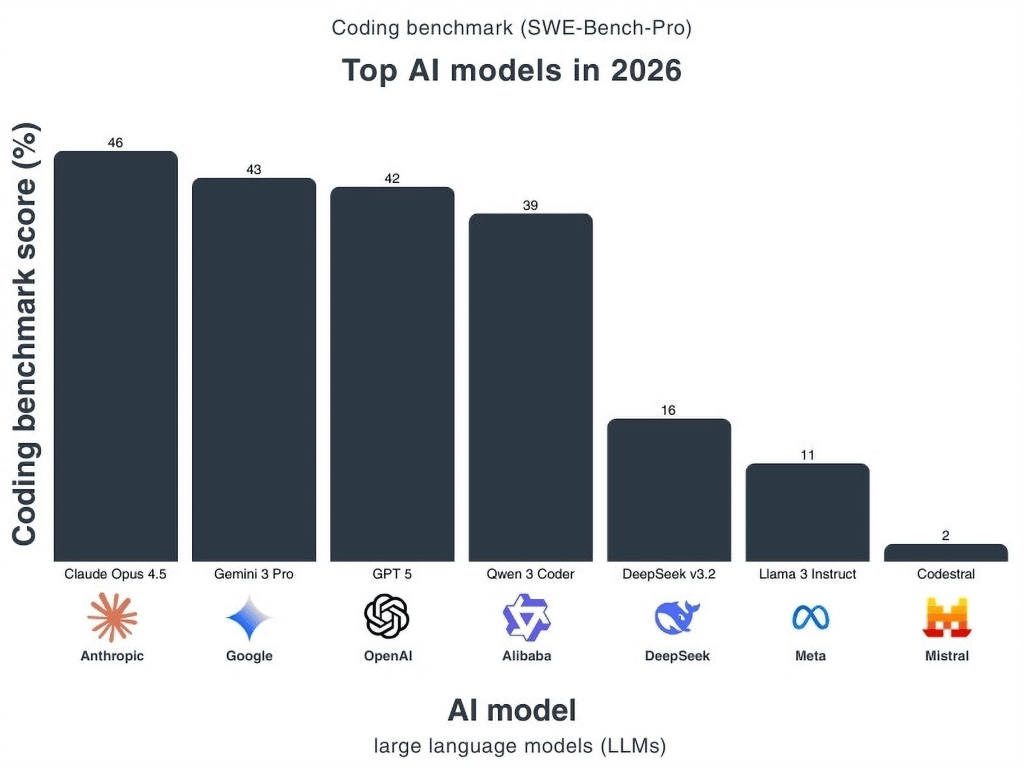
BRACAI Consulting. (2025, 26 de marzo). Ranking del benchmark SWE-bench en 2026: la mejor IA para programar. BRACAI. https://www.bracai.eu/es/post/benchmark-swe-bench-ia
SWE-bench es una prueba de referencia diseñada para medir hasta qué punto un sistema de inteligencia artificial puede resolver problemas reales de ingeniería de software, y no solamente generar fragmentos de código que parezcan correctos.
El artículo de BRACAI explica que los benchmarks tradicionales de programación se centraban en ejercicios relativamente pequeños, como escribir una función o resolver un problema algorítmico. Aunque estas pruebas permiten evaluar determinadas habilidades técnicas, no reproducen toda la complejidad del trabajo cotidiano de un desarrollador. En un proyecto real, es necesario comprender cómo está organizado el software, localizar el origen de un error, interpretar las necesidades de los usuarios, modificar diferentes archivos y comprobar que la solución funciona sin introducir nuevos problemas. SWE-bench pretende evaluar precisamente esa capacidad de desenvolverse en un entorno de programación complejo.
El funcionamiento de SWE-bench parte de incidencias reales publicadas en GitHub, una plataforma ampliamente utilizada para desarrollar y compartir software. El sistema de IA recibe la descripción de un problema y acceso al repositorio de código correspondiente. A partir de esa información, debe identificar qué está fallando, comprender las relaciones entre los distintos componentes del programa y elaborar un parche que corrija el problema. Posteriormente, la solución se somete a pruebas automatizadas para comprobar si cumple los requisitos establecidos. La evaluación no depende únicamente de que el código esté bien redactado o parezca razonable: lo importante es que la modificación funcione y supere las pruebas pertinentes. De esta manera, el benchmark ofrece una aproximación más práctica a la capacidad de una IA para actuar como agente de programación y completar tareas con cierto grado de autonomía.
El artículo distingue varias versiones de este sistema de evaluación. SWE-bench original reúne problemas procedentes de repositorios de Python y permite comprobar si los modelos pueden realizar correcciones en proyectos existentes. SWE-bench Verified es una selección de 500 tareas revisadas por personas para mejorar la claridad de los enunciados y la fiabilidad de las pruebas. Por su parte, SWE-bench Pro se diseñó para evaluar tareas de ingeniería de software más complejas, con repositorios amplios y problemas que pueden exigir razonamiento prolongado y cambios en distintos archivos. El artículo también menciona HumanEval, un benchmark anterior que evalúa la generación de funciones a partir de descripciones y pruebas unitarias. La diferencia fundamental es que SWE-bench trata de aproximarse a la resolución de problemas dentro de un proyecto real, mientras que HumanEval se concentra en ejercicios de programación más acotados.
En cuanto a los resultados, BRACAI presenta una clasificación de modelos en la que destacan Claude Opus 4.5, Gemini 3 Pro, GPT-5 y Qwen 3 Coder, con porcentajes de resolución del 46 %, 43 %, 42 % y 39 %, respectivamente, en SWE-bench Pro. Estas cifras deben entenderse como los resultados que recoge la página, no como una clasificación universal ni necesariamente vigente de los mejores modelos. El artículo también señala diferencias importantes entre los sistemas más avanzados y otros modelos con resultados inferiores, lo que pone de manifiesto que la capacidad de generar código no garantiza que una IA pueda resolver de forma autónoma problemas complejos. Incluso cuando un modelo obtiene buenos resultados, todavía puede necesitar varios intentos, revisión del código y supervisión humana antes de que una modificación esté preparada para incorporarse a un producto real.
Una consideración importante para interpretar estos resultados: en julio de 2026, OpenAI publicó una auditoría que estimó que alrededor del 30 % de las tareas públicas de SWE-bench Pro presentaban problemas de evaluación. Entre ellos figuraban pruebas demasiado estrictas, instrucciones incompletas, criterios de comprobación insuficientes y contradicciones entre el enunciado y las pruebas. La revisión de Epoch AI de septiembre de 2026 también calificó este benchmark como defectuoso. Por tanto, las puntuaciones y los rankings deben leerse con cautela: una prueba mal diseñada puede penalizar soluciones correctas o aceptar soluciones incompletas. Este caso ilustra que evaluar la inteligencia artificial exige examinar tanto las capacidades de los modelos como la calidad de los instrumentos utilizados para medirlas.

