Charlie Rapple. (4 de febrero de 2026). “Responding to the Threat of Zero-Click Search and AI Summaries: How Do We Tame the Crocodile?”. The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/02/04/responding-to-the-threat-of-zero-click-search-and-ai-summaries-how-do-we-tame-the-crocodile/
La visibilidad de una publicación ya no garantiza que los usuarios accedan a ella. En la era de los resúmenes generados por IA, las editoriales y las instituciones científicas necesitan nuevas formas de medir el impacto, preservar la atribución y mantener la confianza en las fuentes originales. Este fenómeno obliga a reconsiderar cómo se evalúa el uso de los recursos electrónicos, cómo se enseña a verificar las fuentes citadas por sistemas de IA y cómo se mantiene el acceso a los documentos originales. Para las bibliotecas, resulta fundamental fomentar una alfabetización informacional que enseñe a distinguir entre una respuesta sintetizada y la consulta directa de la evidencia científica que la sustenta.
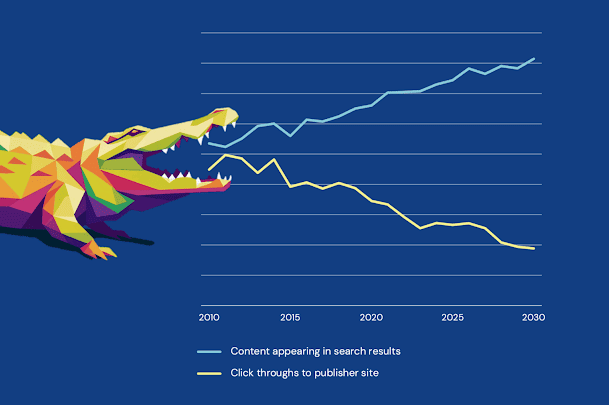
Se analiza una transformación que afecta directamente a la publicación científica: el crecimiento de las búsquedas sin clic (zero-click search), en las que los usuarios obtienen respuestas directamente en la página de resultados de un buscador, sin acceder al sitio web que contiene la información original. Esta tendencia se ha intensificado con los resúmenes generados mediante inteligencia artificial, los paneles de respuestas y los navegadores que sintetizan información procedente de múltiples fuentes. La autora denomina a este fenómeno Crocodile Effect o «efecto cocodrilo», una metáfora que describe la separación creciente entre las veces que un contenido aparece en los resultados de búsqueda y las visitas que recibe la página original. Aunque los contenidos continúan teniendo visibilidad, cada vez menos usuarios pueden llegar a consultarlos directamente.
El fenómeno supone un desafío económico para las editoriales académicas. Las visitas y las descargas se utilizan habitualmente para demostrar el valor de las publicaciones, justificar renovaciones de suscripciones y acreditar el interés de los lectores. Si los usuarios reciben respuestas resumidas sin visitar las páginas originales, disminuye el tráfico y puede debilitarse la capacidad de las editoriales para demostrar el impacto de sus contenidos. La autora menciona como ejemplo las declaraciones de John Campbell, de Oxford University Press, quien atribuyó a las búsquedas sin clic una reducción del 19 % en las visitas a sus contenidos de referencia académica. También recoge un estudio publicado en octubre de 2025 según el cual más de la mitad de las búsquedas en Google terminaban sin que el usuario abandonara la página de resultados. Estas cifras ilustran la magnitud potencial del cambio, aunque no deben interpretarse como una medida uniforme aplicable a todos los sitios o disciplinas.
Más allá de la cuestión económica, Rapple advierte de las consecuencias para la integridad científica y la transparencia informativa. Los resúmenes generados por IA pueden combinar publicaciones revisadas por pares con fuentes de calidad desigual, informaciones incorrectas o contenidos engañosos. Al reformular la información y eliminar parte de su contexto, estas respuestas pueden hacer que afirmaciones discutibles parezcan tan fiables como los resultados científicos contrastados. Además, las referencias a las fuentes originales pueden aparecer de manera poco visible o incompleta. En algunos casos, los sistemas pueden ofrecer citas imprecisas o inexistentes, dificultando que el lector compruebe la procedencia de una afirmación y evalúe la calidad de la evidencia. La autora considera que esta pérdida de contexto y atribución amenaza la confianza en la comunicación científica.
El artículo plantea que las editoriales corren el riesgo de convertirse en proveedores invisibles de contenidos para plataformas de inteligencia artificial. Sus publicaciones aportan información valiosa a los sistemas que generan respuestas, pero las organizaciones responsables de producirlas pueden perder el contacto directo con sus lectores y una parte de los beneficios económicos y reputacionales derivados de su utilización. Rapple compara esta relación con la de un organismo que alimenta a otro hasta poner en peligro su propia supervivencia: los sistemas de IA necesitan fuentes fiables, pero si el uso de esas fuentes reduce los incentivos para mantenerlas, se puede comprometer la sostenibilidad del ecosistema de conocimiento.
Para responder a este desafío, la autora propone varias líneas de actuación. Una consiste en desarrollar estándares para medir y comunicar el uso de contenidos que se produce fuera de las plataformas editoriales tradicionales. Otra pasa por revisar la manera en que autores e instituciones valoran las publicaciones, de modo que las métricas convencionales de visitas y descargas no sean los únicos indicadores de impacto. También plantea explorar modelos de licencias y remuneración para los contenidos derivados, así como establecer estándares que permitan a las herramientas de IA identificar, clasificar y atribuir correctamente las publicaciones revisadas por pares. Estas medidas requerirían colaboración entre editoriales, plataformas tecnológicas, bibliotecas y organizaciones de normalización, dado que ninguna institución puede resolver el problema de forma aislada.
Una estrategia adicional consiste en mejorar la optimización para motores de respuesta y sistemas generativos, conocida como Answer Engine Optimization (AEO) o Generative Engine Optimization (GEO). Se trata de adaptar los contenidos, sus metadatos y su estructura para facilitar que los sistemas de IA los localicen, interpreten y citen adecuadamente. Las editoriales pueden experimentar con resúmenes estructurados, información contextual más clara, metadatos de calidad y mecanismos que faciliten el acceso desde las respuestas automatizadas hasta las publicaciones completas. Sin embargo, la autora considera necesario investigar qué prácticas funcionan realmente y analizar el comportamiento de los usuarios: en qué circunstancias deciden consultar la fuente original, qué confianza depositan en las respuestas generadas y qué características favorecen una visita posterior al sitio editorial.
Rapple sostiene que el efecto cocodrilo no es únicamente un problema de posicionamiento web o de pérdida de tráfico, sino una transformación de la manera en que se descubre, distribuye y consume el conocimiento. La respuesta exige nuevas métricas, mecanismos de atribución más sólidos, modelos de relación con las plataformas de IA y estrategias de visibilidad adaptadas a los buscadores generativos. El objetivo debería ser construir una relación sostenible entre los productores de conocimiento y los sistemas que lo reutilizan, evitando que la facilidad de obtener respuestas termine debilitando las fuentes que las hacen posibles.

