Archivo de la categoría: Investigación

Las citas son la moneda de la ciencia, luego están los falsificadores.

Citations Are the Currency of Science

Citations Are the Currency of Science
Then there are the counterfeiters.

Sibrandes Poppema
THE SCIENTIST.  Dec 1, 2020

Texto completo

Los documentos científicos son los que registran los avances en la investigación. Cada año los investigadores publican millones de artículos en más de 30.000 revistas. La comunidad científica mide la calidad de esos trabajos de diversas maneras, entre ellas la calidad percibida de la revista (reflejada por el factor de impacto de la revista) y el número de citas que acumula un trabajo específico. Las carreras de los científicos y la reputación de sus instituciones dependen del número y el prestigio de los trabajos que producen, pero aún más de las citas que atraen esos trabajos.

En los últimos años se han producido varios episodios de fraude científico, entre los que cabe citar datos completamente inventados, figuras manipuladas o adulteradas, múltiples publicaciones con los mismos datos, robo de artículos completos, plagio de textos y autoplagio. Algunos científicos han encontrado otra forma de aumentar artificialmente el número de citas de su trabajo.

Los cárteles de citas, donde revistas, autores e instituciones conspiran para inflar los números de citas, han existido desde hace mucho tiempo. En 2016, los investigadores desarrollaron un algoritmo para reconocer patrones de citación sospechosos, incluyendo grupos de autores que se citan desproporcionadamente entre sí y grupos de revistas que se citan frecuentemente para aumentar los factores de impacto de sus publicaciones. Recientemente, me encontré con otra expresión de este comportamiento depredador: el llamado servicio de apoyo.

Las consultoras que prestan apoyo lingüístico y editorial de otro tipo a los autores individuales y a las revistas aconsejan a veces a los colaboradores que añadan varias citas a sus artículos y a los artículos de sus colegas. Algunas de estas consultorías también se dedican a organizar conferencias y pueden aconsejar que se añadan citas a las actas de las conferencias. De esta manera, un solo editor puede impulsar cientos de citas en dirección a sus propios artículos o a los de colegas que puedan estar en su círculo.

La llegada de la publicación electrónica y la necesidad de los autores de encontrar salidas para sus artículos dio lugar a miles de nuevas revistas, a menudo con el sello de «internacional» y promesas de acceso abierto y amplia circulación. El nacimiento de revistas depredadoras no se quedó atrás. Recientemente un grupo de autores publicó una definición consensuada de esas publicaciones: «Las revistas y editoriales predatorias son entidades que dan prioridad al interés propio a expensas de la erudición y se caracterizan por la información falsa o engañosa, la desviación de las mejores prácticas editoriales y de publicación, la falta de transparencia y/o el uso de prácticas de solicitación agresivas e indiscriminadas».

Estas revistas pueden actuar como vacas lecheras en las que cada artículo de un número puede citar un artículo específico o una serie de artículos. A veces las citas son más o menos sobre el tema, pero en otros casos no hay absolutamente ninguna relación entre el contenido del artículo y las citas. Lo peculiar es que la revista para la que supuestamente trabaja el editor no se beneficia en absoluto, sino que sólo proporciona citas a otras revistas. Es bastante fácil de detectar si alguien en la revista prestara atención. Tales prácticas pueden llevar a que un artículo acumule más de 150 citas en el mismo año en que fue publicado.

¿Hasta qué punto es pernicioso este tipo de manipulación de citas? Por ejemplo, una persona -que actúa como autor, editor y consultor- pudo utilizar al menos 15 revistas como proveedores de citas de artículos publicados por cinco científicos en tres universidades. El problema es generalizado en Scopus, que incluye un elevado número de las nuevas revistas “internacionales”. De hecho, la inclusión en Scopus parece ser un criterio al que hay que dirigirse en este tipo de manipulación de citas.

Los números son asombrosos. Para una universidad, encontré que de los casi 700 artículos de la lista de Scopus que sus investigadores publicaron en 2019, los números de citaciones de al menos 20 parecen haber sido impulsados de esta manera. Casi el 60 por ciento de las citas de los estudios publicados por esta universidad procedían de 15 revistas manipuladas, y esto aumentó significativamente los números de citas de los 20 artículos. Estas citas sospechosas elevaron el promedio de citaciones por artículo (C/P) de esta universidad a 2,50 para el año, mientras que sin ellas, el C/P habría sido de 1,08. Dado que las citaciones por artículo y/o las citaciones por facultad son criterios en la clasificación de Quacquarelli Symonds y en la Clasificación Mundial de Universidades de Educación Superior del Times, esto también infla artificialmente la posición cuantitativa de la universidad.

¿Qué se puede hacer con los carteles de citaciones? Primero, los editores y los consejos editoriales de las revistas legítimas deberían prestar atención y corregir a sus colegas. Tienen una responsabilidad. Cuando cada artículo de una revista está citando un artículo específico o un grupo de artículos, es probable que algo esté mal. Cuando los temas de los artículos citados y los que se citan no están relacionados, es un claro indicio. Esto debería analizarse antes de la publicación de un número de revista. De hecho, la comprobación de la idoneidad de las citas es una tarea importante para los revisores y editores. Las revistas también deberían reconsiderar la práctica de utilizar consultores de servicios de apoyo externos como editores de artículos o números especiales resultantes de conferencias.

Scopus dispone de todos los datos necesarios para detectar esta mala práctica. Las banderas rojas incluyen un gran número de citas a un artículo dentro del primer año. Y para los autores que deseen evitar las actividades de los cárteles de citas: cuando un editor, un revisor o un servicio de apoyo le pida que añada referencias inapropiadas, no lo obligue e informe de la petición a la revista.

Lista de revistas y editoriales depredadoras

Shrestha, Jiban List of predatory journals and publishers., 2020 [Preprint]

Descargar

Stop Predatory Journals

(Anónimo, 2020).

Las publicaciones depredadoras constituyen un gran desafío, especialmente en los países en desarrollo. Las publicaciones depredadoras no sólo dañan o degradan las reputaciones académicas, sino que también desperdician tiempo, dinero, recursos y esfuerzos. Las publicaciones depredadoras plantean un peligro que podría socavar la calidad, integridad y fiabilidad de los trabajos de investigación científica publicados. Las publicaciones depredadoras también dañan la reputación de las universidades y organizaciones de investigación que están relacionadas con estas publicaciones.

Las universidades y las organizaciones de investigación deben educar a los investigadores, especialmente a los jóvenes, acerca de la existencia de revistas de depredación, los peligros que plantean y las formas de evitarlos. El problema de las posibles publicaciones depredadoras o falsas de libre acceso es una cuestión importante que debe debatirse activamente a nivel nacional, regional y mundial en las comunidades académicas. Las publicaciones depredadoras deben evitarse o excluirse al evaluar los currículos o los datos personales de los investigadores para la promoción del empleo y la liberación de las becas de investigación.

Los autores deben tener cuidado con las revistas o editoriales depredadoras o falsas para comunicar sus trabajos científicos. Los investigadores deben ser conscientes de la calidad de las revistas al publicar los resultados de sus investigaciones. Existe una iniciativa internacional llamada “Think. Check. Submit.” que ayuda a los investigadores a identificar revistas fiables para su publicación. Contiene una sencilla lista de verificación que los investigadores pueden utilizar para evaluar las credenciales de una revista o editorial. Los autores deben consultar en el sitio web de la revista algunos de los artículos publicados en las revistas para evaluar su calidad; esta revisión rápida puede ser todo lo que se necesita para identificar revistas depredadoras. La siguiente lista de revistas y editores depredadores procede de de https://predatoryjournals.com/ (Anónimo, 2020). El propósito de este artículo es crear conciencia sobre las publicaciones depredadoras.

Importancia y beneficios de invertir en ciencia

Beck, Hans Peter ;Charitos, Panagiotis. The Economics of Big Science. Springer Nature, 2021

Texto completo

Los ensayos de este volumen de acceso abierto identifican los ingredientes clave para el éxito en la capitalización de las inversiones públicas en proyectos científicos y el desarrollo de infraestructuras de investigación a gran escala. 

La inversión en ciencia, ya sea en educación y formación o mediante financiación pública para desarrollar nuevas herramientas y tecnologías de investigación, es una prioridad fundamental. Autores de grandes laboratorios / organizaciones de investigación, agencias de financiación y el mundo académico discuten cómo la inversión en ciencia puede producir beneficios para la sociedad, así como identificar desafíos futuros para científicos y responsables políticos. 

El volumen cita diferentes formas de evaluar el impacto socioeconómico de las infraestructuras de investigación y su papel como centros de colaboración, creatividad e innovación globales. Destaca los diferentes beneficios derivados de la investigación fundamental a nivel local, a nivel nacional y mundial, al tiempo que nos invita a repensar la noción de “beneficio” en el siglo XXI. Se requiere inversión pública para mantener el ritmo de los avances tecnológicos y científicos durante las próximas décadas. Lejos de defender una transformación radical y una expansión masiva de la financiación, los autores sugieren formas de mantener una base sólida de ciencia e investigación para garantizar que sigamos beneficiándonos de los resultados. 

El volumen se inspira en el primer taller “Economía de la gran ciencia”, celebrado en Bruselas en 2019 con el objetivo de crear un nuevo espacio para el diálogo y la interacción entre representantes de las grandes organizaciones científicas, los responsables políticos y el mundo académico. Aspira a proporcionar lecturas útiles para los responsables políticos, científicos y estudiantes de ciencias.

Se anuncian cambios en el factor de impacto de la revista para 2021

Changes to Journal Impact Factor Announced for 2021 Scholary Kitchen, por PHIL DAVIS 7 DE DICIEMBRE DE 2020

Texto completo

A principios de este otoño, Clarivate Analytics  anunció que estaba pensando en un futuro en el que calculará el factor de impacto de la revista (JIF) en función de la fecha de publicación electrónica y no de la fecha de publicación impresa.

El tiempo de espera entre la publicación en línea y la designación impresa es corto para algunos títulos, puede ser de meses (o incluso años) para otros. Para la mayoría de las revistas en línea, solo hay una fecha de publicación.

Esta discrepancia entre la forma en que Clarivate trataba las revistas impresas tradicionales frente a las revistas solo en línea despertó el escepticismo entre los científicos, algunos de los cuales argumentaron que las largas demoras entre la publicación impresa y en línea beneficiaban a las puntuaciones JIF de las revistas tradicionales sobre los títulos de acceso abierto más nuevos, y sugirieron cínicamente que los editores pueden extender a propósito su retraso en un intento de elevar artificialmente sus puntajes.

Independientemente de si este argumento tiene validez o no (los métodos para contar las citas válidas son problemáticos), los retrasos crean problemas en el registro de citas, especialmente cuando un artículo se ha publicado en línea en un año e impreso en otro, por ejemplo, publicado en línea en Diciembre de 2019 pero que aparece en la edición impresa de enero de 2020.

Esta es solo una de las razones por las que es tan difícil calcular puntuaciones precisas del Factor de impacto de WoS. Al adoptar un nuevo estándar de publicación electrónica, Clarivate ayudará a reducir la ambigüedad en el registro de citas. También hará que sea más fácil y transparente calcular las métricas de citas. 

Web of Science  comenzó a incluir fechas de publicación electrónica («Early Access») en sus registros desde 2017 y ahora incluye esta información para más de 6.000 revistas, aproximadamente la mitad de las más de 12.000 revistas que indexan actualmente.

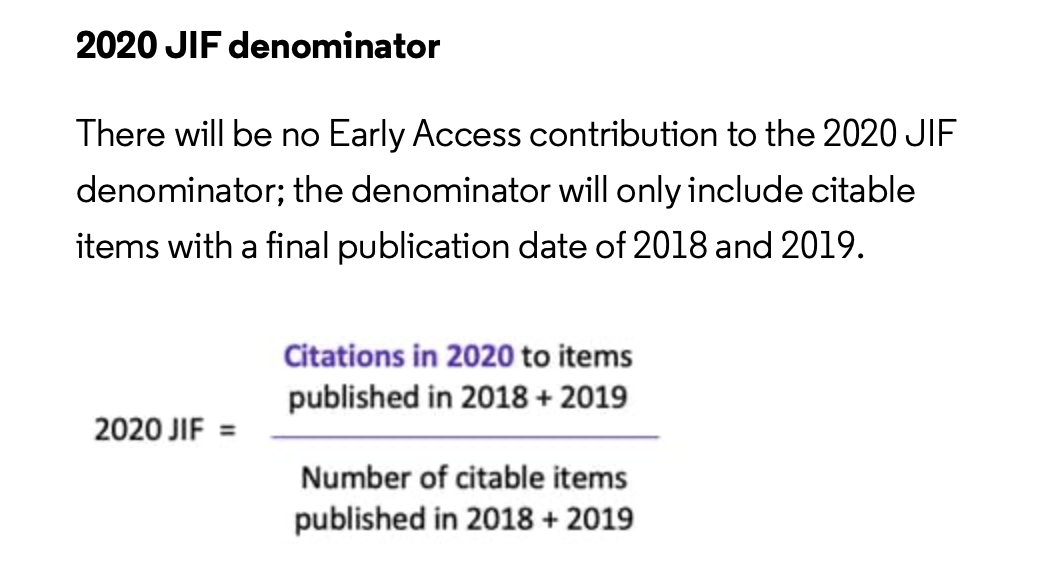
La próxima publicación de 2021 (utilizando datos de 2020) será un año de transición, en el que las citas de los registros de Early Access se agregarán al numerador del cálculo de JIF, pero se excluirán de los recuentos de publicaciones en el denominador.

El cambio completo al uso de la publicación en línea para el cálculo de los factores de impacto de las revistas (JIF) comenzará en 2022 con los datos de publicación de 2021.

eLife requerirá que las presentaciones de artículos se publiquen previamente como preprints

In biology publishing shakeup, eLife will require submissions to be posted as preprints. Por Lila Guterman Science, 3 de diciembre de 2020 12:40 p.m.

Ver completo

Cuando los principales financiadores de investigación biomédica lanzaron la revista de acceso abierto eLife en 2012, esperaban que impulsara la publicación biomédica para aprovechar al máximo el poder de Internet para compartir resultados de manera libre e instantánea. En los años siguientes, el modelo de acceso abierto se ha popularizado. Y cada vez más biólogos han compartido el trabajo en servidores de preprints en línea como bioRxiv y medRxiv antes de someterse a la revisión por pares.

Pero esos cambios no son suficientes para Michael Eisen, biólogo de la Universidad de California, Berkeley, y editor jefe de la revista desde 2019. Esta semana, eLife anunciaron que sólo revisarán los manuscritos que se han presentado previamente como preprints. Y todas las revisiones por pares se harán públicas, incluidas las de los manuscritos que realiza la revista previas a la publicación final. Eisen ve los cambios como el siguiente paso lógico en la evolución de los preprints, dijo a Science Insider.

Semantic Scholar: una herramienta de búsqueda de investigación gratuita para la literatura científica impulsada por la IA

Ochsner Journal Content Available at Semantic Scholar | Ochsner Journal Blog

Semantic Scholar

El proyecto utiliza una combinación de aprendizaje automático, procesamiento de lenguaje natural y visión artificial para añadir una capa de análisis semántico a los métodos tradicionales de análisis de citas, y para extraer figuras, entidades y lugares relevantes de los artículos.En comparación con Google Scholar y PubMed, Semantic Scholar está diseñado para destacar los artículos más importantes e influyentes, e identificar las conexiones entre ellos.

Semantic Scholar tiene por objetivo el acceso oportuno y abierto a la investigación científica relevante, el proyecto fue lanzado en 2015 como un proyecto innovador en el Instituto Allen para la IA, un instituto de investigación sin fines de lucro fundado por el filántropo Paul G. Allen para desarrollar IA que beneficie el bien común. La herramienta aplica la inteligencia artificial para extraer el significado de la literatura científica permitiendo a los estudiosos navegar en la investigación mucho más eficientemente que un motor de búsqueda tradicional. Escanea rápidamente la investigación con la extracción automática de resúmenes, tablas, figuras y citas. Otra de las tareas de Semantic Scholar es comprender el impacto de un trabajo con estadísticas que resalten el volumen y la intención de las citas del trabajo, destacando la influencia de la investigación.

Cuando buscamos entre los 180 millones de artículo de Semantic Scholar encontramso datos relativos al impacto de la investigación tales como citas, indice h, citas de alta influencia, coautores, alertas, cita, texto completo, editor, PDF, TLDR... ) y la posibilidad de filtrar la búsqueda por diferentes criterios como co-autor, con PDF, área de conocimiento o tipo de publicación.

Además de las herramientas de búsqueda y descubrimiento disponibles en semanticscholar.org, proporcionamos una API y un Open Research Corpus como servicios gratuitos para la comunidad investigadora. En la actualidad tiene más de180 millones de documentos

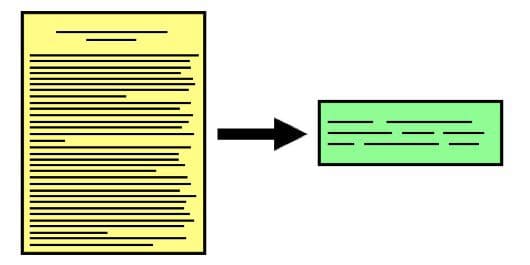
TLDR sistema de inteligencia artificial que resumen los contenidos de investigación de un artículo en una sola frase

Los TLDR (Too Long; Didn’t Read) son resúmenes super-cortos del objetivo principal y los resultados de un artículo científico generados usando el conocimiento de fondo de los expertos y las últimas técnicas de procesamiento del lenguaje natural (PLN) . Esta nueva característica está disponible en versión beta para casi 10 millones de artículos y contando en el dominio de la informática en Semantic Scholar.

Mantenerse al día con la literatura científica es una parte importante del flujo de trabajo de cualquier investigador, y analizar una larga lista de artículos de diversas fuentes mediante la lectura de los resúmenes de los artículos requiere mucho tiempo. TLDR: Extreme Summarization of Scientific Documents, es una nueva forma de resumen extremo, para documentos científicos, utilizando un novedoso protocolo de anotación que produce resúmenes de alta calidad a la vez que reduce al mínimo la carga de anotación.

El motor de búsqueda de información científica Semantic Scholar ahora incluye un nuevo modelo de inteligencia artificial que ofrece un breve extracto sobre cada artículo científico para ayudar a los investigadores en su día a día.

Según la MIT, el sistema ofrece un resumen de una frase junto al famoso indicador TLDR (too long; didn’t read en inglés, demasiado largo; no leído) que aparece debajo de cada artículo de ciencias de la computación (por ahora) cuando los usuarios utilizan la función de búsqueda o van a la página de un autor, lo que le permite localizar rápidamente los documentos adecuados y dedicar el tiempo a leer lo que realmente importa, ya que TLDR ayuda a los usuarios a tomar decisiones rápidas e informadas sobre qué documentos son relevantes, y dónde invertir el tiempo en lecturas adicionales.

Ejemplo:

«Information overload is a top problem facing scientists. Semantic Scholar’s automatically generated TLDRs help researchers quickly decide which papers to add to their reading list.»Isabel Cachola, Johns Hopkins University PhD Student, Former Pre-Doctoral Young Investigator at AI2, and Author of TLDR: Extreme Summarization of Scientific Documents

Bibliografía:

  1. TLDR: Extreme Summarization of Scientific Documents | Semantic Scholar [Internet]. [cited 2020 Dec 3]. Available from: https://www.semanticscholar.org/paper/TLDR%3A-Extreme-Summarization-of-Scientific-Documents-Cachola-Lo/3502a542b2e98d9094e1880a30f652d4170b9534
  2. Una nueva IA resume “papers” de investigación en una sola frase | MIT Technology Review en español [Internet]. [cited 2020 Dec 3]. Available from: https://www.technologyreview.es/s/12886/una-nueva-ia-resume-papers-de-investigacion-en-una-sola-frase
  3. Cachola I, Lo K, Cohan A, Weld DS. TLDR: Extreme Summarization of Scientific Documents [Internet]. [cited 2020 Dec 3]. Available from: https://github.com/allenai/scitldr.

Estado de los Datos Abiertos 2020

Science, Digital; Hahnel, Mark; McIntosh Borrelli, Leslie; Hyndman, Alan; Baynes, Grace; Crosas, Merce; et al. (2020): The State of Open Data 2020. Digital Science. Report. https://doi.org/10.6084/m9.figshare.13227875.v2 

Texto completo

Informe

Conjunto de datos del informe y preguntas de la encuesta

The State of Open Data examina las actitudes y experiencias de los investigadores que trabajan con datos abiertos, compartiéndolos, reutilizándolos y redistribuyéndolos.

La encuesta de este año recibió alrededor de 4.500 respuestas de la comunidad de investigadores y se centró adicionalmente en las prácticas de investigación tras la pandemia de COVID-19. En ella se preguntaba a los investigadores cómo estaba repercutiendo la pandemia en su capacidad de llevar a cabo investigaciones, y sus opiniones sobre la reutilización de los datos y la colaboración.

Entre las principales conclusiones de COVID-19 figuran las siguientes:

  • Un tercio (32%) de los investigadores académicos informaron que su investigación había sido «extremadamente» o «muy» impactada por el brote de COVID-19.
  • Las disciplinas más afectadas por COVID-19 fueron las que trabajaban en Química (47%), Biología (39%), Medicina (36%) y Ciencia de los Materiales (36%). El menor nivel de impacto se registró en Humanidades y Ciencias Sociales (20%)
  • El 43% de los encuestados ya han utilizado o es probable que reutilicen su subvención en cierta medida para la investigación de COVID-19
  • La mitad de los encuestados considera que el bloqueo es «extremadamente» o «algo» probable que resulte en la reutilización de los datos abiertos proporcionados por otros laboratorios, y el 65% espera reutilizar sus propios datos.
  • Más de un tercio de los investigadores dicen que esperan ver más colaboración como resultado de COVID-19; para aquellos en países como Brasil e India donde el impacto de COVID-19 en la investigación parece significativo, alrededor de la mitad esperan que la colaboración aumente como resultado.
  • El número de encuestados que nunca hacen un plan de gestión de datos se redujo a la mitad del 30% al 15%
  • En 2018, el 60% de los encuestados nunca había oído hablar de los principios FAIR, este año ese número se redujo al 39% y la familiaridad general ha aumentado del 15% al 24%.
  • El 55% de los encuestados consideraron que el intercambio de datos debería ser parte de los requisitos para la concesión de subvenciones
  • El 29% de los encuestados no saben quién cubriría los costos de hacer que sus datos de investigación estén en libre acceso
  • Sólo el 13% de los encuestados consideraron que los investigadores reciben actualmente suficiente crédito por compartir datos, mientras que el 59% consideró que recibieron muy poco crédito.

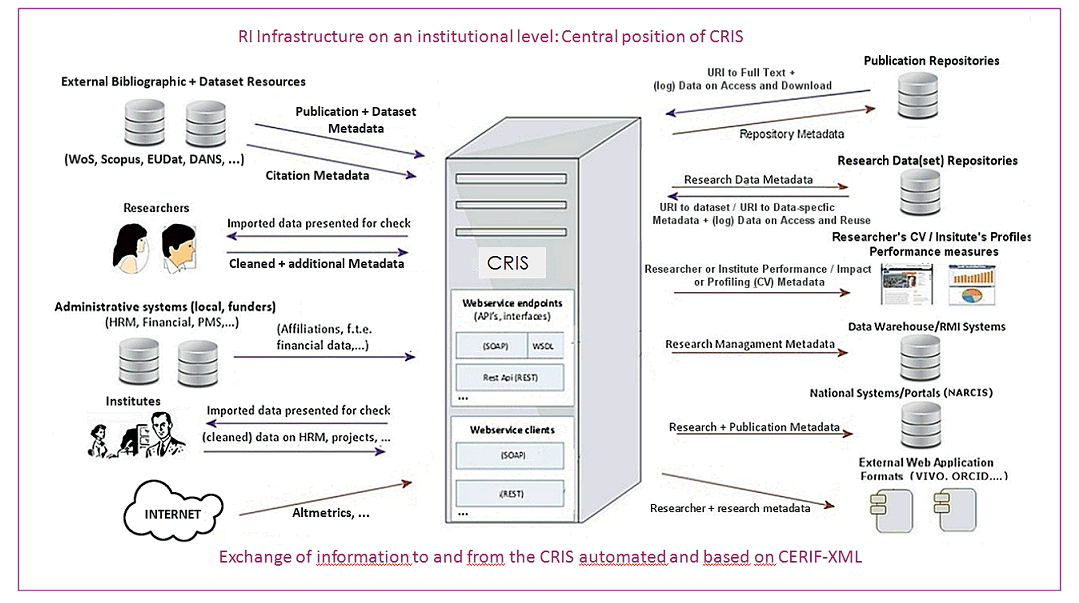
El proceso de investigación y cómo un CRIS puede apoyarlo.

The Research Process and how a CRIS can support it. euroCRIS

Ver original

Descargar imagen en grande

Mas sobre CRIS (Sistemas de Gestión de la Investigación)

Un sistema CRIS, acrónimo de Current Research Information System, es aquella herramienta que permite gestionar de manera global todos los procesos de relacionados con la investigación. El CRIS permite evaluar las oportunidades de financiación de la investigación, evitar la duplicidad de las actividades de investigación, analizar las tendencias, y enlazar con el texto completo o con publicaciones académicas electrónicas e identificar nuevos mercados para los productos de la investigación. Es la herramienta que facilita la realización del CV del investigador y genera informes de gestión, informes a los financiadores, bibliografía de investigación, etc. Paralelamente, las universidades han implementado Repositorios Institucionales para preservar, difundir y poner en valor los objetos digitales emanados de la producción científica institucional.

Existe una división tradicional entre la visión del mundo del investigador individual o del grupo de investigación (reconocimiento de pares) y la visión del mundo de la gestión de la organización. (gobierno y valor por el dinero). Los investigadores fomentan una independencia feroz y se muestran reacios a proporcionar información sobre su actividad con argumento de la libertad de investigación académica impulsada por la curiosidad, a pesar de las posibles ventajas de cooperar con la organización.

Un CERIF-CRIS en el seno de una organización puede superar este problema mediante las siguientes funciones:

  • Información de investigación para el apoyo a la decisión;
  • Metadatos (índice) a las publicaciones académicas (blancas y grises) en un repositorio y a los conjuntos de datos de investigación y software en un repositorio y, como tal, el recurso primario (registro) y principal de metadatos para los repositorios institucionales;
  • Vista de acceso a la información financiera, de recursos humanos y de gestión de proyectos de una organización (y a otros sistemas pertinentes de la organización);
  • Suministro de información del servicio de directorio para la autenticación, autorización, flujo de trabajo y trabajo cooperativo;
  • Generación de páginas web que presentan la organización de la intranet, la DMZ y la extranet, directamente o desde otros sistemas de la organización;
  • Interoperación con otros CERIF-CRIS (y sus sistemas asociados) para dar una visión global de la información de la investigación;
  • Siendo el nodo local y la fuente principal de la información de investigación de la institución en las Infraestructuras de Información de Investigación nacionales e internacionales.

El punto clave es que el investigador, provisto de un CERIF-CRIS, descubre que hay un gran beneficio (CV automatizado, bibliografía, lista de participación en proyectos, generación de páginas web institucionales, finalización parcial de propuestas de investigación, etc.) a cambio de un esfuerzo de entrada relativamente pequeño, ya que la mayoría de las entradas están automatizadas o sólo se requieren una vez y se utilizan muchas veces. De igual modo, el director de la investigación obtiene una visión general de la actividad de investigación dentro y fuera de su institución, lo que le permite tomar mejores decisiones estratégicas.

El CERIF proporciona la interoperación del CRIS y los sistemas asociados con una sintaxis formal y una semántica declarada para que sea fiable y escalable. La situación final ideal es un apoyo completo e integrado de extremo a extremo de las TIC para la cadena de procesos de I+D -programa de trabajo, propuesta, proyecto, resultados, explotación, creación de riquezas- a través de CRISs distribuidos de forma heterogénea.

Para lograr esto necesitamos desarrollar (más) tecnologías de metadatos (interoperación), GRIDs y computación ambiental (facilidad de uso) y flujo de trabajo (reducir la barrera del umbral), permitiendo así que CRIS sea el foco central (proporcionando el contexto de I+D) para los resultados de la investigación, tales como publicaciones, patentes, productos incluyendo conjuntos de datos de I+D y software.

Así pues, el CRIS ocupa una posición central en el espacio de información de la investigación, véase la imagen de arriba para obtener una impresión gráfica de la posición de un CRIS en una institución (haga clic en la imagen para verla más grande)…

Exploración de las identidades de WorldCat como fuente de información Altmetric: Un experimento de análisis del catálogo de la biblioteca en el campo de la Cienciometría

New Interface for WorldCat: Dec 18 | Indiana University Libraries

Torres-Salinas, D., Arroyo-Machado, W., & Thelwall, M. (2020). Exploring WorldCat Identities as an altmetric information source: A library catalog analysis experiment in the field of Scientometrics. (Preprint). ArXiv, https://doi.org/10.1007/s11192-020-03814-w

Evaluar el impacto de los libros académicos es un difícil problema de evaluación de la investigación. El análisis del catálogo de la biblioteca facilita el estudio cuantitativo, a diferentes niveles, del impacto y la difusión de los libros académicos sobre la base de los datos acerca de su disponibilidad en las bibliotecas. El catálogo mundial de WorldCat recopila datos sobre las existencias de las bibliotecas y ofrece una serie de herramientas, entre las que se encuentra la novedosa WorldCat Identities. Se basa en los perfiles de los autores y proporciona indicadores relativos a la disponibilidad de sus libros en los catálogos de las bibliotecas. Se investiga esta nueva herramienta para identificar sus fortalezas y debilidades en base a una muestra de autores de Bibliometría y Cienciometría. Se revisan los problemas que esto conlleva y comparamos los indicadores del Análisis de catálogos de bibliotecas con las citas de Google Scholar y Web of Science. Los resultados muestran que WorldCat Identities puede ser una herramienta útil para la evaluación del impacto de los libros, pero el valor de sus datos se ve socavado por la provisión de colecciones masivas de libros electrónicos a las bibliotecas académicas.