Los sistemas de inteligencia artificial como ChatGPT pueden realizar análisis de datos a un coste de menos del 1% de lo que costaría contratar a un analista humano

South China Morning Post. «Study Shows ChatGPT Has Potential to Do Data Analysis at Fraction of Human Cost», 29 de mayo de 2023. https://www.scmp.com/tech/article/3222214/llms-chatgpt-can-perform-data-analysis-fraction-human-cost-comparable-performance-study.

Los resultados preliminares proceden de un estudio sobre LLM realizado por la Academia Damo de Alibaba y la Universidad Tecnológica Nanyang de Singapur. El coste de GPT-4, la última versión del LLM desarrollado por la start-up estadounidense OpenAI, es sólo el 0,45% de la contratación de un analista de datos senior, según un estudio.

El uso de grandes modelos lingüísticos (LLM) como GPT-4 en el análisis de datos cuesta menos del 1% de lo que cuesta contratar a un analista humano con resultados comparables, según un estudio reciente que pone de relieve la amenaza potencial que supone para la seguridad laboral la creciente adopción de la inteligencia artificial generativa (IA) en diversos sectores.

El coste de GPT-4, la última versión de la LLM desarrollada por la start-up estadounidense OpenAI, es sólo el 0,45% de la contratación de un analista de datos sénior que gane en el mercado unos 90.000 dólares anuales, o el 0,71% de un empleado de nivel subalterno, según las conclusiones de un estudio de unos investigadores de Damo Academy, la rama de investigación interna del gigante chino del comercio electrónico Alibaba Group Holding, y la Universidad Tecnológica Nanyang de Singapur, publicadas en el servidor de preprints arXiv (PDF).

En el estudio, los investigadores formularon preguntas y proporcionaron los datos, y automatizaron todo el proceso de análisis de datos utilizando GPT-4 para extraer y analizar los datos, con el fin de producir finalmente ideas y gráficos. Los resultados del análisis se compararon con los de analistas de datos humanos profesionales en términos de rendimiento, tiempo y costes.

Los experimentos demostraron que la GPT-4 no sólo es significativamente más barata que un analista de datos humano, sino también mucho más rápida a la hora de completar las tareas, según las conclusiones del estudio.

Sin embargo, el estudio señala que se necesitan más estudios antes de concluir que GPT-4 puede sustituir a los analistas de datos. GPT-4 también puede superar a un analista humano de nivel básico en términos de rendimiento, que se evaluó a través de una serie de métricas que incluían la corrección y fluidez en los gráficos y las percepciones que producían, y tiene un «rendimiento comparable» al de un analista de nivel superior, con ventajas que varían según los distintos casos y métricas.

En algunos casos, el modelo de IA consiguió superar a los analistas de datos humanos en cuanto a la corrección de las cifras y el análisis, y las percepciones que generaba GPT-4 tendían a ser más complejas, según el estudio. GPT-4 también obtuvo plena puntuación en alineación y fluidez a la hora de generar el análisis con textos gramaticalmente correctos.

Sin embargo, GPT-4 quedó por detrás de los humanos a la hora de mostrar datos correctos en los gráficos, así como en la presentación y el formato en algunos casos. A pesar de los errores en algunas cifras, GPT-4 podía generar análisis correctos, señalaba el estudio.

El estudio arroja nueva luz sobre la creciente aplicación de las GPT-4 en diversas industrias, donde se espera que mejoren la eficiencia pero también amenacen los puestos de trabajo humanos.

Las empresas tecnológicas chinas se apresuran a desarrollar sus propios servicios similares a ChatGPT. Alibaba está trabajando en su propia respuesta, llamada Tongyi Qianwen, que lanzó en abril para pruebas beta a clientes corporativos por invitación, semanas después de que Baidu diera a conocer su servicio Ernie Bot.
La propiedad de los contenidos generados por IA

Sheth, Sarang. «Who Owns AI-Generated Content? Understanding Ownership, Copyrighting, and How the Law Interprets AI-Generated Art – Yanko Design», 28 de mayo de 2023. https://www.yankodesign.com/2023/05/27/who-owns-ai-generated-content-understanding-ownership-copyrighting-and-how-the-law-interprets-ai-generated-art/.

El origen y la capacidad de los contenidos generados por IA han sido temas de larga data. El aprendizaje automático ha estado presente durante más de una década, permitiendo que las computadoras adquieran inteligencia al recopilar datos, analizarlos, «pensar» y «crear». Desde la histórica victoria de Deep Blue sobre Garry Kasparov en 1996 en una partida de ajedrez, seguida por el triunfo del superordenador Watson de IBM en el programa Jeopardy en 2011, hasta la victoria de AlphaGo sobre el campeón europeo de Go Fan Hui en 2015 por 5 a 0, hemos presenciado hitos impresionantes. Sin embargo, atribuir exclusivamente la victoria a las computadoras o a los ingenieros que las crearon plantea cuestiones difíciles de dilucidar:

¿Es correcto afirmar que las computadoras han derrotado a sus contrapartes humanas? ¿O deberíamos considerar que los ingenieros que diseñaron y desarrollaron estas máquinas son los verdaderos vencedores? Además, si un automóvil Tesla autónomo llegara a causar un accidente mortal a un peatón, ¿a quién se le atribuiría la culpa? ¿A la inteligencia artificial en sí? ¿Al humano que estaba al volante? ¿O al equipo de ingenieros de Tesla que creó el algoritmo de conducción autónoma? Estas preguntas aún no tienen respuestas definitivas.

La propiedad de los contenidos generados por IA es un ámbito jurídico complejo y en evolución. En muchos casos, los términos y condiciones establecidos por las empresas, como Tesla, aclaran que la responsabilidad recae en el conductor y no en la inteligencia artificial del vehículo. Sin embargo, la asignación precisa de responsabilidad en casos como este es un desafío complejo y requiere una cuidadosa consideración legal y ética.

La propiedad de los contenidos generados por IA depende normalmente de la participación y contribución de los creadores humanos. En muchas jurisdicciones, la legislación sobre derechos de autor concede la propiedad a los creadores humanos de obras originales. Sin embargo, dado que los contenidos generados por IA son producidos por algoritmos sin participación humana directa, la cuestión de la propiedad se vuelve más compleja.

En algunos casos, el propietario de la IA puede ser considerado propietario del contenido que genera. Podría tratarse de la persona u organización que creó o entrenó el algoritmo de IA. Sin embargo, este enfoque no es aceptado universalmente, y algunos sostienen que el resultado de una IA no debería estar sujeto a la protección de los derechos de autor porque carece de la creatividad o autoría humanas necesarias.

Como alternativa, la propiedad puede atribuirse a la persona o entidad que proporcionó los datos utilizados para entrenar la IA. Por ejemplo, si una IA se entrena con un conjunto de datos de fotografías, la titularidad de los derechos de autor de esas fotografías puede influir en la titularidad del contenido generado por la IA.

Cabe señalar que algunas jurisdicciones han empezado a explorar marcos jurídicos que abordan específicamente los contenidos generados por IA. Por ejemplo, la Directiva sobre derechos de autor de la Unión Europea, adoptada en 2019, incluye disposiciones que establecen que la protección de los derechos de autor no debe aplicarse a las obras generadas por IA sin participación humana. Sin embargo, los estados miembros son responsables de implementar esta directiva en sus leyes nacionales, por lo que puede haber variaciones en cómo se interpreta y aplica esto.

En lo que respecta a los derechos de autor de las obras de arte generadas por IA, la capacidad de garantizar la protección de los derechos de autor puede depender de la participación de creadores humanos en el proceso creativo. Si un artista humano contribuye a la concepción o el diseño de la obra de arte generada por la IA, puede reclamar derechos de autor sobre ella. Sin embargo, si la IA genera de forma autónoma la obra de arte sin intervención humana, puede ser más difícil hacer valer la propiedad de los derechos de autor.

La interpretación de la legislación sobre derechos de autor y los contenidos generados por IA sigue evolucionando, y las distintas jurisdicciones pueden adoptar enfoques diferentes. Es esencial consultar con profesionales del derecho versados en la propiedad intelectual y la ley de IA para comprender las implicaciones y normativas específicas de cada jurisdicción.

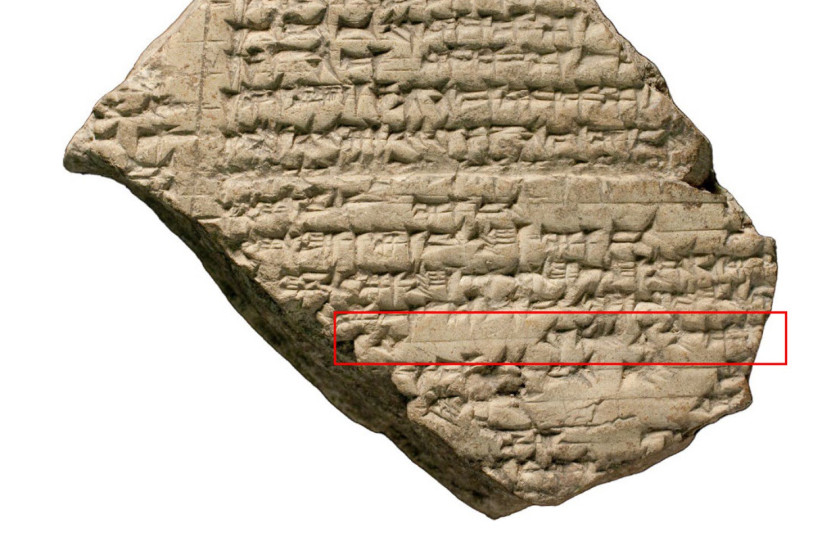
Uso de la inteligencia artificial para la traducción de las tablillas cuneiformes

«Israeli experts create AI to translate ancient cuneiform text – study – The Jerusalem Post». Accedido 1 de junio de 2023. https://www.jpost.com/archaeology/article-741982.

La inteligencia artificial está desempeñando un papel fundamental en la traducción de las tablillas cuneiformes, permitiendo una mejor comprensión de las antiguas civilizaciones mesopotámicas y enriqueciendo nuestro conocimiento sobre la historia y la cultura de la humanidad.

La inteligencia artificial ha demostrado ser una herramienta poderosa en el campo de la traducción automática, y ahora se está aplicando para descifrar y traducir el complejo sistema de escritura cuneiforme. Utilizando algoritmos avanzados y modelos de aprendizaje automático, los investigadores están entrenando a la inteligencia artificial para reconocer y comprender los patrones y las estructuras de las tablillas cuneiformes. Utilizando técnicas de aprendizaje automático y algoritmos avanzados, los investigadores entrenaron a la IA para reconocer y comprender los complejos patrones y estructuras de los textos cuneiformes. Esto permitió que la IA tradujera los textos con mayor precisión y rapidez de lo que los expertos humanos podrían hacerlo.

Un grupo de expertos en Israel ha desarrollado una inteligencia artificial (IA) capaz de traducir textos cuneiformes antiguos, según revela un estudio reciente. Las tablillas cuneiformes son una forma de escritura antigua utilizada en civilizaciones como la sumeria y la babilónica hace miles de años.

Esta tecnología está permitiendo una traducción más rápida y precisa de las tablillas, lo que a su vez está ayudando a los arqueólogos y lingüistas a obtener una mejor comprensión de las antiguas civilizaciones mesopotámicas. Además, la inteligencia artificial está revelando nuevos conocimientos y detalles sobre la vida y las prácticas de estas culturas antiguas.

Y de esta manera, la aplicación de la inteligencia artificial por parte de expertos israelíes representa un importante avance en la traducción de textos cuneiformes antiguos. Este estudio demuestra cómo la IA puede contribuir a la comprensión y la preservación de nuestro legado cultural, proporcionando una nueva forma de explorar y aprender de las civilizaciones del pasado.

Más allá del donut: cinco formas de utilizar las «almetrics» para el éxito académico

Impact of Social Sciences. «Beyond the Doughnut – Five Ways to Use Altmetrics for Academic Success», 1 de junio de 2023.

Texto completa

Una década después de su creación, Andy Tattersall analiza cómo los académicos pueden hacer uso de las altmétricas más allá de los recuentos y las métricas.

El artículo analiza el uso de las altmetrics (métricas alternativas) como una herramienta para evaluar el impacto académico más allá de las métricas tradicionales, como las citas en revistas científicas. El autor destaca cinco formas en las que las altmetrics pueden ser utilizadas para lograr el éxito académico:

  1. Comprender el impacto en línea: Las altmetrics permiten rastrear el impacto de la investigación más allá de las publicaciones académicas tradicionales, incluyendo menciones en redes sociales, blogs y medios de comunicación. Esto proporciona una visión más completa del alcance y la influencia de la investigación.
  2. Identificar colaboraciones potenciales: Las altmetrics pueden ayudar a identificar investigadores y grupos de investigación con intereses similares y con un impacto significativo en sus respectivas áreas. Esto facilita la colaboración y el intercambio de conocimientos.
  3. Evaluar el impacto temprano: Las altmetrics pueden proporcionar una evaluación temprana del impacto de la investigación, incluso antes de que se publiquen las citaciones académicas formales. Esto puede ser especialmente útil para investigadores que desean demostrar el impacto de su trabajo en etapas tempranas de sus carreras.
  4. Mejorar la visibilidad y el alcance: Al promover la investigación a través de plataformas en línea y redes sociales, las altmetrics pueden aumentar su visibilidad y alcanzar a audiencias más amplias. Esto puede llevar a un mayor reconocimiento y oportunidades de colaboración.
  5. Recopilar evidencia para evaluaciones: Las altmetrics pueden proporcionar evidencia adicional para complementar las evaluaciones tradicionales basadas en citas. Al incluir datos de altmetrics en los informes de actividad académica, los investigadores pueden demostrar un impacto más amplio y diverso de su trabajo.

En conclusión, el artículo destaca que las altmetrics ofrecen nuevas formas de evaluar y medir el impacto académico, complementando las métricas tradicionales. Su uso puede ayudar a los investigadores a comprender mejor el impacto de su trabajo, identificar oportunidades de colaboración, evaluar el impacto temprano, aumentar la visibilidad y recopilar evidencia adicional para evaluaciones académicas.

PIRLS: Estudio Internacional de Progreso en Comprensión Lectora en España

El estudio principal de PIRLS 2021 tuvo lugar entre abril y mayo de 2021, y ha evaluado la comprensión lectora de los estudiantes de 4.º de Educación Primaria en casi 500 centros del territorio nacional. El informe internacional se ha publicado el 16 de mayo de 2023 y el nacional el 29 de mayo de 2023.

PIRLS 2021 es el quinto ciclo del Progress in International Reading Literacy Study. Desde 2021, PIRLS ha proporcionado datos de alta calidad para supervisar el progreso en el rendimiento en lectura de los alumnos en cuarto curso, abarcando 20 años de tendencias. La evaluación de la lectura de PIRLS se basa en un marco global que se centra en dos propósitos primordiales de la lectura: para la experiencia literaria y para adquirir y utilizar información. Los resultados de PIRLS 2021 proporcionan descripciones de las destrezas y estrategias de lectura de los alumnos en cuatro puntos de referencia internacionales de la escala de rendimiento en lectura de PIRLS para una interpretación significativa de las puntuaciones de rendimiento en lectura.

El Estudio Internacional de Progreso en Comprensión Lectora (PIRLS, Progress in International Reading Literacy Study), de la Asociación Internacional para la Evaluación del Rendimiento Educativo (IEA, International Association for the Evaluation of Educational Achievement), evalúa la comprensión lectora del alumnado en su cuarto curso de escolarización obligatoria.

En España este curso equivale a 4.º de Educación Primaria y se considera un importante punto de transición en el desarrollo de los/as niños/as como lectores. Habitualmente, en este momento de su educación, han aprendido a leer y ahora leen para aprender.

Figura 2.2.a. Puntuaciones medias estimadas en comprensión lectora e intervalos de
confianza al 95 % de países y regiones adjudicatarias participantes en PIRLS 2021

Los datos de España se presentan comparados con los datos correspondientes al Promedio OCDE-28 y al total de la Unión Europea. Cabe destacar los siguientes:

  • La puntuación media estimada de España se sitúa en 521 puntos, por debajo del Promedio OCDE-28 (533) y del Total UE (528), en línea con los resultados obtenidos por Alemania (524), Nueva Zelanda (521), Portugal (520) o Eslovenia (520).
  • La evolución positiva del rendimiento lector que se había experimentado entre los años 2011 y 2016 se revierte en 2021, con un descenso relevante: se pasa de 528 puntos a 521. Sin embargo, si se compara con los países de la OCDE y de la UE, España es de los países que menos han bajado.
  • España presenta uno de los mejores grados de equidad en el índice social, económico y cultural (ISEC). Este índice se obtiene a través de los cuestionarios de contexto que tienen en cuenta aspectos como el nivel educativo de las familias, la ocupación de los padres, madres o tutores legales y el número de libros que hay en casa.
  • Los porcentajes de chicas y chicos que alcanzan al menos el nivel alto de lectura es prácticamente el mismo en España (36% las chicas y 35% las chicas).
  • En España se produce una diferencia significativa entre el nivel de comprensión lectora de quienes manifiestan que les gusta leer y quienes declaran que no les gusta leer.
  • Ocho de cada diez docentes se sienten muy satisfechos con su profesión (81%), España es el país con el porcentaje más elevado de entre los seleccionados. Supera en 30 puntos al Promedio OCDE-28 (51%) y al Total UE (50%).
  • Los resultados muestran que el indicador de acoso escolar y el rendimiento en lectura están directamente relacionados: a mayor acoso mayor disminución en el rendimiento promedio de lectura.
  • El alumnado que posee mayor sentido de pertenencia al centro obtiene mejor rendimiento. En España el porcentaje de alumnado que tiene un alto sentido de pertenencia alcanza el 73% por un 57% del Promedio OCDE-28 y un 56% del Total UE.

Acusan a Amazon de violar la ley de privacidad infantil al conservar para siempre las grabaciones de voz de los niños con «Alexa» y socavar las peticiones de borrado de los padres

«FTC and DOJ Charge Amazon with Violating Children’s Privacy Law by Keeping Kids’ Alexa Voice Recordings Forever and Undermining Parents’ Deletion Requests | Federal Trade Commission». Accedido 1 de junio de 2023.

Ver noticia

La Comisión Federal de Comercio y el Departamento de Justicia exigirán a Amazon que revise sus prácticas de supresión de datos y aplique estrictas salvaguardias de privacidad para resolver las acusaciones de que la empresa infringió la norma COPPA (Children’s Online Privacy Protection Act Rule) y engañó a los padres y usuarios del servicio de asistente de voz Alexa sobre sus prácticas de supresión de datos.

Según una denuncia presentada por el Departamento de Justicia en nombre de la FTC, Amazon impidió que los padres ejercieran sus derechos de eliminación en virtud de la Regla COPPA, conservó datos sensibles de voz y geolocalización durante años y los utilizó para sus propios fines, mientras ponía los datos en riesgo de daño por acceso innecesario.

«El historial de Amazon de engañar a los padres, conservar indefinidamente las grabaciones de los niños y hacer caso omiso de las solicitudes de supresión de los padres violó la COPPA y sacrificó la privacidad en aras de los beneficios», dijo Samuel Levine, Director de la Oficina de Protección del Consumidor de la FTC. «La COPPA no permite a las empresas conservar los datos de los niños para siempre por ningún motivo, y menos para entrenar sus algoritmos».

En virtud de la propuesta de orden judicial federal presentada también por el DOJ, se exigirá a Amazon que elimine las cuentas inactivas de menores y determinadas grabaciones de voz e información de geolocalización, y se le prohibirá utilizar esos datos para entrenar sus algoritmos. La orden propuesta debe ser aprobada por el tribunal federal para entrar en vigor.

Según la demanda, Amazon aseguró de forma destacada y reiterada a sus usuarios, incluidos los padres, que podían eliminar las grabaciones de voz recogidas por su asistente de voz Alexa y la información de geolocalización recopilada por la aplicación Alexa. Sin embargo, la empresa incumplió estas promesas cuando conservó parte de esta información durante años y utilizó los datos que retuvo ilegalmente para ayudar a mejorar su algoritmo Alexa, según la denuncia.

Buenas prácticas en materia de datos: Eliminación de barreras a la reutilización de datos con licencias CC0 («Sin derechos reservados»)

The Dryad. «Good Data Practices: Removing Barriers to Data Reuse with CC0 Licensing». Dryad news, 30 de mayo de 2023.

Ver noticia

CC0 “No Rights Reserved”

CC0 permite a científicos, educadores, artistas y otros creadores y propietarios de contenidos protegidos por derechos de autor o bases de datos renunciar a esos intereses sobre sus obras y, de ese modo, ponerlas lo más completamente posible en el dominio público, de modo que otros puedan basarse libremente en ellas, mejorarlas y reutilizarlas para cualquier fin sin restricciones en virtud de la legislación sobre derechos de autor o bases de datos.

¿Por qué CC0 es una gran opción para los datos abiertos?

A los autores que envían datos a Dryad se les pide que consientan la publicación de sus datos bajo Creative Commons Public Domain Dedication, más comúnmente conocida como CC0. Al hacerlo, se pide a los autores que confirmen que cualquier material que haya sido publicado previamente por otro autor o grupo de trabajo se publicó en condiciones compatibles con CC0 y que aceptan publicar de forma novedosa cualquier material no publicado previamente bajo esta exención.

Las licencias Creative Commons (CC) son un estándar ampliamente adoptado para los productos académicos y también se emplean para una amplia gama de otros medios difundidos digitalmente (muchas imágenes de Wikipedia están alojadas bajo una licencia CC, por ejemplo). La licencia CC BY (Atribución) es particularmente común en las comunidades de investigación, ya que es la licencia bajo la cual se publican con frecuencia los artículos de acceso abierto. También existen muchas otras licencias abiertas estándar, como las específicas para software.

En cambio, CC0 no es una licencia, sino una renuncia a los derechos de autor del propietario o creador. Dedica una obra al dominio público sin restricciones ni condiciones para su reutilización, modificación o redistribución.

La reutilización de datos es el objetivo ideal de compartir datos abiertos. Las afirmaciones indebidas de derechos de autor y restricciones de licencias sobre material que probablemente no esté amparado por la ley de derechos de autor hace que los usuarios potenciales tengan que descifrar los textos legales para determinar si el contenido está sujeto a derechos de autor. Esto puede resultar bastante oneroso y crear aversión a la reutilización por miedo a acciones legales por uso indebido, especialmente en el caso de las licencias más restrictivas. Incluso si hay poca ambigüedad sobre si se puede hacer una reclamación de derechos de autor, la incertidumbre sobre cómo seguir las condiciones prescritas también puede sofocar la reutilización por miedo a acciones legales. Por ejemplo, todas las licencias CC exigen la atribución, pero ésta debe hacerse de la forma específica prescrita por el creador o creadores. Cuando se recopilan muchas obras con este tipo de licencias, esto puede crear mayor ambigüedad y cargas para los usuarios.

Con CC0, no hay ambigüedad sobre las restricciones de los datos, lo que, de nuevo, no autoriza a los usuarios potenciales a ignorar las normas establecidas por la comunidad, como la citación o la colaboración. Además, evita complicaciones en torno al llamado «apilamiento de atribuciones», cada vez más común a medida que los investigadores compilan grandes conjuntos de datos procedentes de muchas obras con licencias independientes (un inconveniente típico de CC BY en comparación con CC0). Por último, libera al editor de los datos de la carga legal de supervisar la reutilización de sus datos y, en caso necesario, de emprender acciones legales contra acciones percibidas como indebidas (algo para lo que muchas personas carecen de tiempo o recursos).

El concepto de renunciar a los derechos de autor de los productos académicos suele resultar desconcertante para los investigadores, que esperan que se reconozca el mérito de su trabajo. CC0 no exime ni excluye a los usuarios de los resultados publicados bajo esta exención de observar las normas establecidas de la comunidad, de las cuales la citación adecuada es sólo una de muchas. Las expectativas de citación y la práctica de hacerlo deben considerarse como una contribución positiva a una comunidad de investigación, no como una acción tomada bajo coacción por temor a acciones legales.

ChatGPT: la inteligencia artificial y la generación de textos académicos. Planeta biblioteca 2023/05/31

ChatGPT: la inteligencia artificial y la generación de textos académicos.

Planeta biblioteca 2023/05/31

ESCUCHAR EL PROGRAMA

Ir a descargar

Video Conferencia Argentina

Video «Cómo funciona CHATGPT»

ChatGPT es un modelo de lenguaje basado en IA desarrollado por OpenAI que puede ser una herramienta valiosa para los educadores. Permite interactuar con un asistente virtual inteligente para obtener respuestas y generar ideas sobre tendencias. Sin embargo, su uso plantea preocupaciones éticas y de privacidad, como el acceso y uso indebido a datos personales, el sesgo algorítmico, el plagio académico y las implicaciones de la toma de decisiones automatizada en temas sensibles.

Los lectores canadienses están comprando menos libros y pidiendo más libros prestados a la biblioteca

Canadian Leisure & Reading Study 2022. BookNet Canada., 30 de mayo de 2023.

Texto completo

PDF

ePub

Según un informe de BookNet Canada, que analiza las ventas de libros y las tendencias de lectura en el país, se observa un cambio en el comportamiento de los lectores canadienses, quienes están optando cada vez más por pedir prestados libros en bibliotecas en lugar de comprarlos en librerías. Además, el informe destaca un aumento en la popularidad de los cómics y las novelas gráficas entre los lectores canadienses durante el año 2022.

Una encuesta sobre el tiempo libre y los hábitos de lectura de BookNet Canada, organización sin ánimo de lucro del sector, ha revelado que el 81% de los canadienses consideraba que disponía de suficiente o más que suficiente tiempo libre en 2022. Los canadienses dedicaban su tiempo libre a ir de compras (99%), ver la televisión, vídeos o películas (97%), cocinar (96%), escuchar música (96%) y pasar tiempo con la familia (96%).

En la encuesta, que se realiza regularmente cada invierno, se preguntó a 1.290 canadienses si habían leído o escuchado un libro en el último año y, como en los 8 años anteriores, aproximadamente 8 de cada 10 canadienses dijeron que sí. En cuanto a la frecuencia con que leen, el 40% lo hace a diario, el 24% semanalmente y el 15% una vez al mes. En cuanto a lo que leen, casi todos los lectores (94%) han leído al menos un libro impreso en 2021. Tanto la lectura de libros electrónicos como de audiolibros había aumentado con respecto a las cifras de 2021. Más de dos tercios de los lectores habían leído un libro electrónico en 2022 (67%), frente al 64% en 2021. En 2022, el 51% de los lectores había escuchado un audiolibro, frente al 45% de los lectores que lo habían hecho en 2021.

En general, los lectores están adquiriendo menos libros y optando por pedir prestados más ejemplares en 2022 en comparación con 2020, y esta tendencia se hace más notable en el caso de los libros impresos. En 2022, el 52% de los lectores compraron libros impresos, en contraste con el 61% registrado en 2020. Esta disminución en las compras de libros impresos puede atribuirse a varios factores. Uno de ellos puede ser el cambio en las preferencias de los lectores, quienes están optando por pedir prestados libros en lugar de adquirirlos.

El número de lectores de cómics y novelas gráficas aumentó en 2022 con respecto a 2021. Esto es válido tanto para los libros de ficción como para los de no ficción. Los cómics y novelas gráficas de ficción registraron un mayor número de lectores tanto en formato impreso (15% en 2022 frente al 3% en 2021) como electrónico (16% en 2022 frente al 2% en 2021). Los cómics y novelas gráficas de no ficción también registraron un aumento de lectores en formato impreso (12% en 2022 frente al 7% en 2021) y electrónico (10% en 2022 frente al 6% en 2021).

Otros aspectos destacados del estudio:

  • Los lectores utilizan más que nunca los smartphones para leer ebooks: el 23% lo hizo en 2019 y ha aumentado de forma constante hasta el 34% en 2022.
  • Se observa una disminución en las compras de libros por parte de los lectores en favor de la petición de libros prestados en bibliotecas. En 2022, el 52% de los lectores optaron por pagar por sus libros impresos, en comparación con el 61% que lo hizo en 2020.. Esta tendencia es más pronunciada en el caso de los libros impresos. En 2022, el 52% de los lectores pagaron por sus libros impresos, frente al 61% en 2020.
  • Durante el primer año, inspirados por la popularidad de BookTok, preguntamos a los lectores si habían visto una publicación específica sobre un libro en las redes sociales, por ejemplo en BookTok, BookTube, Bookstagram o similares. En 2022, más lectores habían visto o buscado este tipo de contenido a diario que los que habían visitado una red social específica de un libro (por ejemplo, Shelfari, Goodreads, 49th Shelf, Wattpad, etc.): un 12 % para ver una publicación en una red social específica de un libro frente a un 10 % para visitar una red social específica de un libro.

Resultados de la investigación sobre el proyecto de creación de una red nacional de ayuda para la búsqueda de documentos de archivo

Diagram of the National Archival Network linking archives, libraries, researchers, educators, government records, and data storage across the U.S.
Illustration showing how the National Archival Network connects diverse archival resources and users.

Weber, Chela Scott, Lynn Silipigni Connaway, Brooke Doyle, Lesley A. Langa, Merrilee Proffitt, Bruce Washburn, y Itza A. Carbajal. «Summary of Research: Findings from the Building a National Archival Finding Aid Network Project», 30 de mayo de 2023.

Texto completo

Entre 2020 y 2023, OCLC fue socio de Building a National Finding Aid Network (NAFAN) (Creación de una red nacional de ayuda para la búsqueda de archivos), un proyecto de investigación y demostración respaldado por el IMLS para sentar las bases de una red nacional de ayuda para la búsqueda de archivos a fin de abordar la incoherencia e inequidad del panorama actual de identificación de archivos (LG-246349-OLS-20). El proyecto fue dirigido por la Biblioteca Digital de California (CDL), con socios de OCLC, la Biblioteca de la Universidad de Virginia, Shift Collective y Chain Bridge Group.

OCLC dirigió la investigación para el proyecto, llevando a cabo una investigación de las necesidades tanto de los usuarios finales como de los contribuyentes en relación con las asignaciones de ayudas para la búsqueda, y una evaluación de la calidad y coherencia de los datos de ayudas para la búsqueda codificados en EAD existentes de los agregadores de archivos regionales.

Los resultados de NAFAN representan un esfuerzo de investigación sin precedentes al servicio de la comunidad archivística. Esta investigación proporciona valiosos conocimientos que pueden ser utilizados por el proyecto NAFAN e informar a otros proyectos al servicio de los investigadores y archiveros de archivos, de aquellos que deseen aprovechar los datos descriptivos de los archivos y de los investigadores de archivos y usuarios de archivos para explorar nuevas vías de investigación para sus propias investigaciones.