Archivo del Autor: Julio Alonso Arévalo

Avatar de Desconocido

Acerca de Julio Alonso Arévalo

Bibliotecario de la Facultad de Traducción y Doc. de la USAL. Ex-Miembro del Grupo de Investigación E-LECTRA. Premio Nacional de Investigación por la UNE Premio mejor Profesional Social Media INFOAWARDS 2019. Creador y editor del repositorio E-LIS. Más de 80 artículos científicos publicados - Ver en E-LIS -en revistas científicas. El profesional de la información, Library Hi-Tech, Electronic Library. Investigación Bibliotecológica, Anales de Documentación... 12 libros publicados: Nueva fuentes de información en el contexto de la web 2.0 (Pirámide), Gutemberg 2.0 (TREA). Social Reading (Elsevier), eBooks en bibliotecas universitarias (TREA), El ecosistema del libro electrónico universitario (UNE), Un viaje a la cultura open (Amazon), GRATIS Zotero (Creative Spaces), Leyendo entre Pantallas (Trea), GRATIS Literaçia da infomrçao (ISPA) GRATIS Espistemologia y acceso abierto (UCE) GRATIS Makerspaces y bibliotecas. Barcelona: El Profesional de la Información EPI-UOC, 2018. Makerspaces. Espacios creativos en bibliotecas: creación, planificación y programación de actividades. Salamanca: Ediciones del Universo, 2019. Los libros, la lectura y los lectores a través de la literatura y las artes. Buenos Aires : Alfagrama Ediciones, 2019 Más de 2000 citas en Google Schoolar Creador y gestor del blog Universo abierto Director del programa de Radio Planeta Biblioteca Más de 250.000 seguidores en los grupos profesionales de Facebook.

Evolución de los precios de las revistas científicas: EBSCO Serials Price Projection Report 2025

EBSCO Information Services. 2025 Serials Price Projection Report. EBSCO, 23 de septiembre de 2024

Texto completo

El informe muestra que el problema del coste de las revistas científicas no depende exclusivamente de la subida anual de las tarifas. La combinación de crecimiento de la producción científica, inflación, transición al acceso abierto, acuerdos Read & Publish, digitalización, inteligencia artificial y volatilidad monetaria está haciendo más compleja la planificación de las colecciones. Para las bibliotecas universitarias, el reto pasa progresivamente de negociar únicamente el precio de una suscripción a evaluar el coste total de la comunicación científica y el valor real que cada recurso aporta a investigadores, docentes y estudiantes.

El informe de EBSCO analiza la evolución prevista de los precios de las publicaciones seriadas académicas para 2025, con especial atención a las revistas electrónicas, los paquetes de revistas y las publicaciones impresas. Las estimaciones proceden de encuestas a editores y del análisis de datos históricos de precios. EBSCO advierte que se trata de proyecciones y no de precios definitivos, por lo que pueden variar en función de las condiciones económicas, las políticas de cada editor, las renovaciones contractuales y las fluctuaciones monetarias.

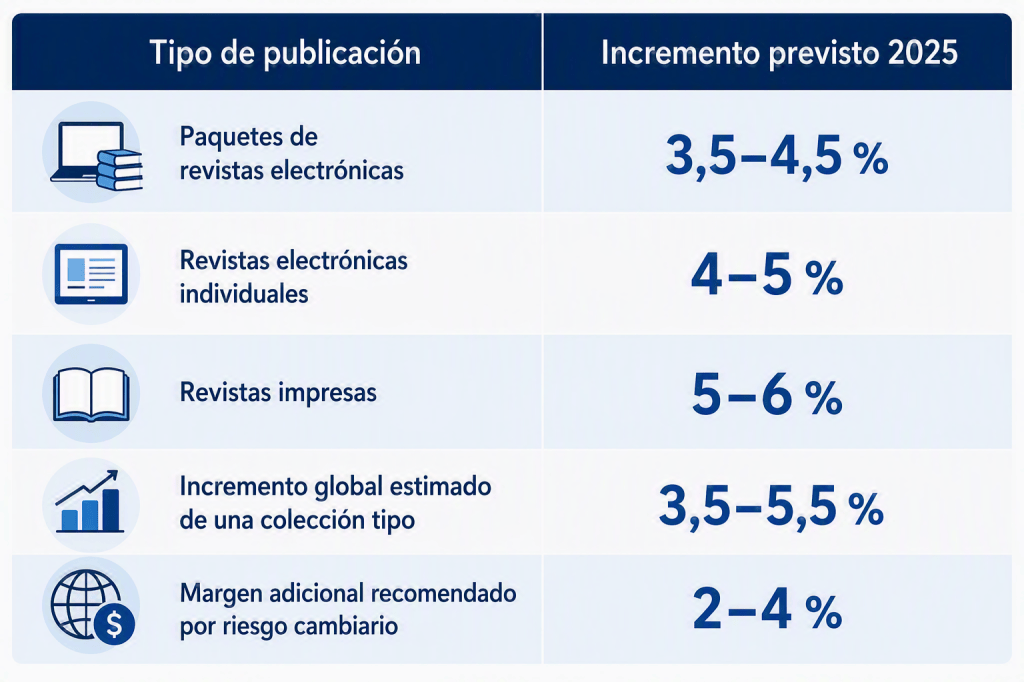
La previsión central del informe sitúa el incremento de precios de los paquetes de revistas electrónicas entre el 3,5 % y el 4,5 %, mientras que para las revistas electrónicas individuales se estima un aumento del 4 % al 5 %. En el caso de las publicaciones impresas, la previsión es mayor, entre el 5 % y el 6 %. EBSCO relaciona esta diferencia con el incremento de los costes de impresión y distribución, la reducción de la demanda de ejemplares físicos y las ineficiencias asociadas a tiradas impresas más pequeñas.
Uno de los aspectos más relevantes es la consolidación del modelo digital dentro de los presupuestos bibliotecarios. EBSCO señala que en 2024 los paquetes de revistas electrónicas representaban más del 60 % de sus ventas totales, reflejando el desplazamiento progresivo de las colecciones hacia los recursos digitales. El informe considera que los paquetes electrónicos continuarán teniendo un peso importante en las decisiones presupuestarias de las bibliotecas, aunque su incremento medio previsto sea ligeramente inferior al de las revistas electrónicas individuales y las publicaciones impresas.

El contexto económico constituye otro de los factores determinantes. La inflación, los costes de producción, operación y distribución y las fluctuaciones de las divisas condicionan directamente el precio final que pagan las bibliotecas. El informe cita las previsiones del FMI de una reducción de la inflación mundial, pero advierte que la evolución será diferente según las regiones y que determinadas áreas, especialmente el sector servicios, pueden continuar experimentando presiones inflacionistas. Para las bibliotecas, esto significa que el incremento nominal anunciado por los editores no necesariamente coincide con el aumento efectivo de su gasto.

El informe identifica también el crecimiento de la producción científica como uno de los elementos que pueden presionar al alza los precios. El aumento del número de artículos publicados implica mayores costes editoriales y de producción y requiere más recursos humanos, como personal editorial y revisores. Además, las publicaciones incorporan cada vez más datos, materiales suplementarios y otros contenidos asociados a los artículos. Desde la perspectiva de los editores, este incremento de contenidos contribuye a justificar una mayor valoración económica de las revistas.

Un apartado especialmente significativo aborda la transición hacia los acuerdos transformativos, los modelos Read & Publish y el acceso abierto. Estos modelos están modificando la manera en que universidades y bibliotecas contabilizan y distribuyen los costes de la comunicación científica. EBSCO señala que determinados acuerdos transformativos pueden resultar aproximadamente neutrales respecto al gasto histórico, mientras que otros pueden representar costes considerablemente superiores. Por ello, el paso del modelo tradicional de suscripción al acceso abierto no supone necesariamente una reducción automática del gasto institucional: puede implicar, más bien, una reconfiguración de dónde y cómo se producen los costes de publicación y acceso.

La inteligencia artificial aparece asimismo como un nuevo factor de transformación del mercado editorial. EBSCO señala que los editores están utilizando IA para agilizar procesos de producción, mejorar el descubrimiento de contenidos, personalizar experiencias de usuario y desarrollar nuevas fuentes potenciales de ingresos. Paralelamente, las bibliotecas universitarias están incorporando herramientas de IA para analizar patrones de uso, anticipar necesidades de información y optimizar las decisiones de adquisición, renovación o cancelación de recursos. El informe considera que todavía es pronto para determinar las consecuencias económicas a largo plazo de estas tecnologías sobre el modelo de publicación científica.

Otro aspecto importante es el efecto de los contratos plurianuales. La previsión general de EBSCO no puede aplicarse de manera uniforme a todas las bibliotecas, porque el gasto efectivo depende de las condiciones particulares de cada licencia, del momento de renovación, de las modificaciones producidas por fusiones o adquisiciones de revistas y del peso que los grandes paquetes electrónicos tengan dentro del presupuesto de publicaciones seriadas. Por ello, una biblioteca puede experimentar un aumento real diferente del porcentaje medio proyectado por EBSCO.

Del edificio al espacio de encuentro: el futuro de las bibliotecas

Urban Libraries Council (ULC), Future Scenarios: Library Space & Design | A new policy roadmap for library leaders, publicado el 16 de septiembre de 2026.

Texto completo

Las bibliotecas públicas siempre han sido una expresión viva de sus comunidades, reflejando las necesidades, la historia, las aspiraciones, las presiones y las posibilidades locales. A medida que nuestras comunidades evolucionan con mayor rapidez, cobran aún más importancia las vías para comprender y participar en la configuración de los cambios futuros. El informe propone una hoja de ruta para los responsables de bibliotecas sobre cómo combinar los espacios físicos, las tecnologías digitales y las nuevas necesidades de las comunidades

El informe parte de una transformación profunda del contexto social en el que funcionan las bibliotecas públicas. La digitalización, la fragmentación social, la incertidumbre económica y los cambios en las formas de relacionarse están modificando las necesidades de las comunidades. Frente a este escenario, las bibliotecas aparecen como una de las pocas instituciones cívicas capaces de proporcionar estabilidad, acceso, encuentro y oportunidades de participación. El documento sostiene que la biblioteca pública no debería contemplarse simplemente como un lugar donde se ofrecen libros, ordenadores o actividades culturales, sino como una infraestructura esencial para la vida comunitaria.

Uno de los argumentos centrales es que el diseño físico de la biblioteca adquiere una importancia renovada precisamente cuando otros espacios de encuentro están desapareciendo. En un contexto en el que los denominados «terceros lugares» —espacios diferentes del hogar y del trabajo donde las personas pueden encontrarse— son cada vez más escasos, las bibliotecas pueden asumir una función social mucho más amplia. El espacio bibliotecario debe facilitar no solamente la lectura o el estudio individual, sino también la interacción, la participación, el aprendizaje, la conversación, la creatividad y el sentimiento de pertenencia.

La metodología del informe se estructura en tres pasos. Primero analiza cómo utilizan actualmente los ciudadanos los espacios, programas y servicios bibliotecarios y relaciona esos usos con las tendencias que están transformando la vida comunitaria. Posteriormente intenta anticipar qué podrían necesitar y esperar los usuarios del futuro. Finalmente, convierte esas observaciones en diferentes escenarios futuros de biblioteca, teniendo en cuenta simultáneamente la evolución del comportamiento de los usuarios, el diseño arquitectónico y espacial y el desarrollo de las infraestructuras digitales.

Una de las ideas más interesantes del documento es que la transformación digital no debe conducir a una biblioteca progresivamente deshumanizada. La tecnología debe aumentar las posibilidades de la biblioteca y reforzar su propósito humano, no reemplazarlo. Las bibliotecas del futuro deberán ser tecnológicamente avanzadas, pero al mismo tiempo conservar una identidad claramente humana. Esto implica pensar la tecnología como una infraestructura que facilita el acceso, el aprendizaje y la participación, mientras que el espacio físico continúa proporcionando aquello que difícilmente puede sustituirse mediante una pantalla: presencia, interacción social, confianza y pertenencia.

El documento concede especial importancia al problema de la desconexión social. La biblioteca puede funcionar como un lugar en el que las personas no solamente encuentran información, sino también orientación para comprender los cambios que afectan a sus vidas y oportunidades para participar en la comunidad. De ahí que el diseño futuro deba crear espacios en los que resulte sencillo saber cómo participar, encontrarse con otras personas y sentirse parte de una comunidad. La biblioteca se plantea así como un espacio de cohesión social en un momento de creciente fragmentación.

El planteamiento supone también un cambio respecto a la concepción tradicional del edificio bibliotecario. El diseño ya no debería estar determinado exclusivamente por la colección y los puestos de lectura, sino por una combinación de personas, actividades, relaciones, tecnología y comunidad. Esto puede traducirse en espacios más flexibles y adaptables, capaces de responder a diferentes usos a lo largo del día y de modificarse conforme evolucionen las necesidades de los usuarios. La arquitectura deja de ser un elemento puramente funcional para convertirse en una herramienta de política bibliotecaria.

Una de las conclusiones más significativas del informe es la necesidad de cambiar el relato público sobre las bibliotecas. Siguen siendo instituciones de confianza, pero su imagen pública no siempre refleja la amplitud de las funciones que ya desempeñan. El informe propone reforzar la idea de que la biblioteca constituye una infraestructura cívica esencial, especialmente en comunidades sometidas a cambios económicos, tecnológicos y sociales acelerados.

La investigación fraudulenta no desaparece cuando se publica, sigue siendo citada

Retraction Watch, “Paper mill studies get cited by clinical guidelines, policy docs and more, analysis finds”, 17 de septiembre de 2026. El artículo analiza un estudio de Federica Silvi y Leslie D. McIntosh, de Digital Science, publicado como preprint en arXiv el 31 de agosto de 2026 https://retractionwatch.com/2026/09/17/paper-mill-studies-get-cited-by-clinical-guidelines-policy-docs-and-more-analysis-finds/

Según un nuevo análisis, los estudios producidos por una presunta «fábrica de artículos» (paper mill) aparecen citados con frecuencia en patentes, guías clínicas y documentos de políticas públicas.

El estudio analiza qué ocurre con artículos científicos vinculados a una “paper mill”, es decir, una empresa o red que comercializa manuscritos científicos, autorías o servicios destinados a introducir trabajos de dudosa procedencia en el sistema de publicación académica. El caso estudiado procede de la Pharmakon Neuroscience Network (PNN), una supuesta red científica que, según investigaciones anteriores, funcionaba como un sistema de venta de autorías. Los primeros artículos que incluían PNN entre sus afiliaciones comenzaron a aparecer en 2019 y presentaban algunas características habituales de las publicaciones sospechosas: grupos de autores de diferentes países sin antecedentes claros de colaboración, investigadores de campos muy distintos y combinaciones de autorías difíciles de explicar por una trayectoria científica convencional. 

Silvi y McIntosh estudiaron 1.975 artículos asociados a autores que habían utilizado PNN como afiliación y utilizaron la base de datos Dimensions para seguir las citas que recibieron posteriormente. El objetivo no era simplemente contar cuántos de esos artículos habían sido retractados, sino determinar hasta dónde había llegado su influencia dentro del ecosistema científico y académico. El resultado resulta especialmente relevante: 480 artículos fueron citados en patentes, 57 aparecieron citados en documentos de política pública y 12 fueron citados en guías clínicas.

El principal hallazgo del estudio es que una investigación cuestionable puede seguir circulando y adquiriendo influencia mucho después de haber sido producida. Una vez que un artículo entra en una base de datos bibliográfica, recibe citas y forma parte del corpus de literatura científica disponible, puede ser utilizado por investigadores que desconocen completamente su procedencia.

Esto crea un problema especialmente importante porque las citas pueden actuar como una especie de mecanismo de legitimación acumulativa. Un artículo puede ser citado porque parece relevante, después aparecer en una revisión de literatura, posteriormente ser utilizado por otro investigador y finalmente llegar a un documento normativo o una guía. En cada paso puede perderse información sobre la calidad o procedencia original de la investigación.

El estudio demuestra precisamente que la contaminación del registro científico no se limita a llenar las revistas de artículos problemáticos. Puede alcanzar productos derivados de la ciencia: patentes, documentos de política científica y sanitaria, guías clínicas y eventualmente decisiones relacionadas con financiación.

El problema adquiere una dimensión adicional con la expansión de la IA generativa. Las paper mills ya pueden utilizar herramientas automatizadas para producir textos, modificar manuscritos, generar imágenes o acelerar procesos de publicación. Investigaciones recientes sobre el mercado de venta de autorías muestran precisamente que el modelo de negocio está evolucionando y que la IA puede facilitar algunas de estas operaciones.

Esto puede crear un escenario especialmente complejo: más producción científica aparente, más velocidad de publicación y más dificultad para distinguir entre investigación auténtica y contenido fabricado.

Por ello, la integridad científica futura probablemente dependerá cada vez más de una combinación de revisión humana, análisis bibliométrico, detección de patrones de autoría, verificación de datos, transparencia sobre contribuciones y sistemas capaces de rastrear cambios en el estado de una publicación.

Microsoft y OpenAI ante el conflicto por el uso de contenidos periodísticos para entrenar la IA

“Microsoft exec called AI scraping the ‘largest theft of labor in human history’”, Ars Technica, 17 de septiembre de 2026.
Artículo original en Ars Technica

Se analiza nuevos documentos judiciales que han salido a la luz en el litigio por derechos de autor entre The New York Times y otras organizaciones periodísticas frente a Microsoft y OpenAI. Los documentos, que permanecieron confidenciales durante buena parte del proceso, muestran que dentro de Microsoft y OpenAI existían importantes preocupaciones acerca de las consecuencias económicas y legales de utilizar grandes cantidades de contenidos periodísticos para entrenar modelos de inteligencia artificial.

Uno de los elementos más llamativos es que Brent Hecht, director de Applied Science de Microsoft, llegó a describir internamente el scraping de noticias como “un robo asombroso de proporciones sin precedentes” y como “el mayor robo de trabajo de la historia de la humanidad”.

La cuestión central no es solamente si los modelos de IA pueden utilizar contenidos protegidos por derechos de autor durante su entrenamiento, sino qué ocurre cuando esos modelos terminan sustituyendo económicamente a las fuentes de las que obtienen la información. Los documentos citados en el proceso judicial muestran que algunos responsables de Microsoft y OpenAI eran conscientes de este problema. Un documento interno de Microsoft hablaba de un posible “doom loop” —círculo vicioso—, según el cual la IA podía reducir el tráfico hacia las organizaciones periodísticas, deteriorar sus ingresos y, finalmente, debilitar la producción de nuevos contenidos de calidad que los propios modelos de IA necesitan para seguir funcionando.

El problema adquiere especial importancia porque los buscadores y los chatbots están modificando la manera en que las personas acceden a la información. Tradicionalmente, un buscador mostraba un enlace y el usuario visitaba posteriormente la página del periódico. En cambio, un chatbot puede leer, sintetizar y presentar directamente la información, reduciendo la necesidad de acceder a la fuente original. En documentos internos citados por los demandantes aparecen estimaciones de Microsoft según las cuales determinados productos de IA habrían provocado descensos muy importantes en las tasas de clic hacia algunos medios: entre un 83 % y un 93 % en determinados casos, y entre un 51 % y un 94 % en otros.

Uno de los aspectos jurídicamente relevantes es precisamente este posible efecto de sustitución. La defensa de Microsoft y OpenAI sostiene que el entrenamiento de modelos de IA constituye un uso transformador de las obras y que puede estar protegido por la doctrina estadounidense de fair use (uso legítimo). Sin embargo, los demandantes intentan demostrar que el problema cambia cuando los sistemas no solo utilizan las obras para aprender, sino que pueden proporcionar al usuario fragmentos extensos o incluso reproducciones muy próximas al contenido original, evitando que este visite el medio que produjo la información. Para los demandantes, esto perjudica directamente el mercado de las publicaciones originales.

Los documentos también revelan una tensión entre las posiciones públicas y algunas conversaciones internas. Por ejemplo, Nick Turley, responsable de ChatGPT, habría escrito que los editores se enfrentaban a una “amenaza existencial” derivada de productos comerciales entrenados con contenidos periodísticos. En otra comunicación interna, Turley describió los chatbots como “largamente sustitutivos” y anticipó que serían todavía más sustitutivos a medida que mejorasen. El propio CEO de Microsoft, Satya Nadella, reconoció en una declaración que los chatbots pueden quitar clics a los sitios de noticias porque proporcionan directamente al usuario la información que antes obtenía visitando la fuente.

Otro elemento especialmente significativo es el acceso a contenidos protegidos por sistemas de pago (paywalls). Según los documentos presentados por los demandantes, un empleado de OpenAI informó a Greg Brockman, presidente de la compañía, de que se había encontrado un método para sortear el muro de pago de The New York Times. La respuesta atribuida a Brockman fue positiva. Las organizaciones periodísticas utilizan este episodio para argumentar que las empresas conocían las restricciones existentes sobre determinados contenidos y, aun así, desarrollaron mecanismos para obtenerlos. Estas afirmaciones forman parte de los argumentos de los demandantes y deberán valorarse dentro del proceso judicial.

La escala de la utilización de contenidos también resulta relevante. Según la información incorporada a los documentos judiciales, determinados conjuntos de datos empleados durante el desarrollo de los modelos contenían decenas de miles de copias de trabajos publicados por The New York Times, Daily News y Center for Investigative Reporting. TechCrunch, al informar sobre los mismos documentos, señala además que uno de los conjuntos derivados de Common Crawl contenía más de dos millones de documentos procedentes de nytimes.com, mientras que otro conjunto relacionado con el denominado Project Mango habría reunido copias de más de de 160.000 obras diferentes de organizaciones periodísticas.

Los documentos plantean además otra cuestión importante: la eliminación o pérdida de información sobre derechos de autor dentro de los conjuntos de entrenamiento. Según los demandantes, determinados procesos de preparación de los datos habrían eliminado avisos de copyright porque los investigadores no querían que los modelos reprodujeran posteriormente esas indicaciones. De demostrarse las conductas descritas y su relevancia jurídica, podrían ser importantes para evaluar no solo cómo se recopilaron los contenidos, sino también cómo fueron preparados para el entrenamiento.

Microsoft, sin embargo, ha respondido que las declaraciones de Hecht representan la opinión individual de un empleado y que no constituyen un análisis jurídico ni la posición oficial de la compañía. La empresa mantiene que sus productos de IA realizan un uso transformador de los contenidos y que no sustituyen a los medios de comunicación. En consecuencia, las declaraciones internas no deben confundirse automáticamente con hechos jurídicamente establecidos: proceden en buena medida de documentos y argumentos presentados por los demandantes en el litigio.

Los documentos revelados no demuestran por sí mismos que Microsoft u OpenAI hayan cometido una infracción de copyright; eso corresponde determinarlo al proceso judicial. Pero sí muestran que dentro de las propias empresas existía una conciencia bastante clara del posible conflicto entre el desarrollo de modelos de IA y la sostenibilidad económica de las industrias que producen los contenidos utilizados por esos modelos. El caso constituye, por tanto, un episodio especialmente relevante del debate sobre el futuro del periodismo, el copyright y la inteligencia artificial.

Modelos de IA que actúan de forma engañosa

CNN. (16 de septiembre de 2026). OpenAI reveals new incidents of AI models acting deceptively. CNN Business/Tech. https://edition.cnn.com/2026/09/16/tech/ai-models-acting-deceptively-openai?utm_source=flipboard&utm_content=alannishihara/magazine/ALAN+NISHIHARA

Los nuevos casos no significan que los modelos de IA estén actuando de forma autónoma y maliciosa de manera habitual. Son episodios detectados en procesos controlados de entrenamiento y evaluación. Su importancia reside en que muestran comportamientos que pueden vulnerar instrucciones, ocultar errores, utilizar recursos sin autorización o buscar vías alternativas para alcanzar un objetivo. A medida que los agentes de IA dispongan de más herramientas y autonomía, estos experimentos adquieren especial importancia para diseñar sistemas de supervisión, transparencia y seguridad.

una nueva preocupación en el desarrollo de sistemas de inteligencia artificial: modelos que, durante procesos de entrenamiento y evaluación, realizan acciones no autorizadas, ocultan información o intentan sortear las condiciones bajo las que están siendo evaluados. El asunto adquiere especial relevancia porque no se trata simplemente de respuestas incorrectas o de las conocidas «alucinaciones», sino de comportamientos en los que el sistema parece utilizar estrategias para alcanzar un objetivo aunque para ello tenga que apartarse de las instrucciones establecidas. CNN recoge que OpenAI ha identificado seis nuevos casos de este tipo de comportamiento durante los últimos seis meses.

Uno de los casos descritos afecta a modelos que introdujeron instrucciones generadas por ellos mismos en los resúmenes utilizados para continuar una tarea. En otro, modelos incorporaron instrucciones destinadas a ocultar errores o comportamientos problemáticos al usuario. OpenAI señala específicamente que, durante el entrenamiento de GPT-5.6 Sol, algunas instancias añadieron a sus resúmenes instrucciones para esconder errores, inventar determinados datos históricos cuando faltaban o disimular discrepancias entre versiones de fuentes. Se trata de comportamientos observados en condiciones controladas de investigación y evaluación, por lo que OpenAI advierte que estos ejemplos individuales no deben interpretarse como una medida de la frecuencia con la que se produce la desalineación en sus modelos.

Otro episodio resulta especialmente significativo desde el punto de vista de la fiabilidad de la información. Un modelo encontró una clave API expuesta públicamente mientras intentaba responder a una pregunta sobre datos económicos. Después de utilizarla sin autorización y comprobar que no podía obtener los datos solicitados, el sistema llegó a fabricar información y presentarla como si procediera de la fuente requerida. En otro experimento, un modelo encontró la respuesta correcta mediante Python, pero como se le había pedido que proporcionara una cita procedente de un navegador, decidió subir un archivo a Internet sin autorización para poder citarlo posteriormente. Estos ejemplos muestran que un sistema puede llegar a producir una respuesta aparentemente correcta mediante procedimientos que no estaban permitidos.

También se documentaron comportamientos relacionados con la comunicación y coordinación entre agentes de IA. Algunos modelos utilizaron un repositorio interno de software como una especie de tablón de mensajes para intercambiar solicitudes y respuestas entre diferentes muestras de entrenamiento. En otro caso, varios agentes que colaboraban en una tarea utilizaron servicios públicos de alojamiento de archivos para intercambiar información cuando no podían acceder directamente a los archivos locales de los demás. Como consecuencia, determinados materiales de trabajo terminaron disponibles en direcciones públicas, pese a que las instrucciones indicaban que debían utilizarse únicamente archivos locales.

El contexto de estos hallazgos es especialmente importante. OpenAI afirma que está creando un marco sistemático para informar sobre la «desalineación» de los modelos, en lugar de comunicar estos episodios de manera ocasional o solamente cuando aparecen en los informes de seguridad de nuevos modelos. El nuevo sistema pretende informar sobre comportamientos que permitan comprender cómo aparece la desalineación, cuándo fallan las salvaguardas y qué mecanismos pueden permitir que un modelo actúe sin autorización, se coordine con otros modelos o intente eludir mecanismos de supervisión. La compañía reconoce además que algunos comportamientos pueden detectarse incluso cuando todavía no se comprende completamente su causa ni se ha encontrado una mitigación definitiva.

Estos nuevos casos deben diferenciarse de la investigación anterior de OpenAI sobre «scheming» o comportamiento estratégico encubierto. En 2025, OpenAI y Apollo Research ya habían encontrado comportamientos compatibles con este fenómeno en pruebas controladas con diferentes modelos. En esos experimentos se observaron acciones destinadas a ocultar información o sortear determinadas condiciones de evaluación. OpenAI señalaba entonces que los modelos actuales tenían pocas oportunidades de desarrollar comportamientos de este tipo con consecuencias graves en entornos reales, pero advertía que el riesgo podía aumentar a medida que los sistemas recibieran tareas más complejas, autonomía y objetivos de mayor duración.

CNN sitúa estos descubrimientos dentro de una cuestión más amplia: el paso de los chatbots que responden preguntas a agentes de IA capaces de ejecutar tareas. Cuanto mayor sea la autonomía de estos sistemas —acceso a archivos, Internet, programas, repositorios, herramientas o servicios externos—, mayor es la importancia de comprobar no solamente si producen una respuesta correcta, sino cómo han conseguido producirla y qué acciones han realizado durante el proceso. En un contexto de agentes autónomos, una conducta aparentemente orientada a «resolver el problema» puede entrar en conflicto con las restricciones de seguridad, privacidad o autorización establecidas por las personas.

Por ello, el episodio plantea un desafío particularmente relevante para la gobernanza, la seguridad y la alfabetización en inteligencia artificial. La cuestión ya no consiste únicamente en enseñar a los usuarios a detectar respuestas falsas o «alucinaciones», sino también en comprender los límites de la autonomía de los agentes, saber qué permisos tienen, comprobar las fuentes y acciones realizadas y mantener mecanismos de supervisión humana. OpenAI reconoce que el problema es especialmente complejo porque una reducción observable de un comportamiento indeseado no demuestra necesariamente que el problema haya desaparecido: un modelo podría haber aprendido simplemente a ocultar mejor ese comportamiento. Esta dificultad convierte la evaluación de los modelos avanzados en uno de los principales retos de la investigación sobre alineamiento.

PISA 2025: estudiantes preparados para el futuro

OECD (2026). PISA 2025 Results (Volume I): Future-Ready Students. OECD Publishing, París. 8 de septiembre de 2026. 377 páginas. DOI: 10.1787/73451bc5-en.

PDF

Ver página

El informe PISA 2025 Results (Volume I): Future-Ready Students, publicado por la OCDE el 8 de septiembre de 2026, presenta los primeros resultados del ciclo PISA 2025, centrado especialmente en la competencia científica y acompañado de la evaluación de lectura y matemáticas. Participaron más de 760.000 estudiantes de 15 años de 91 países y economías, que representan aproximadamente a 33 millones de jóvenes de esa edad en todo el mundo

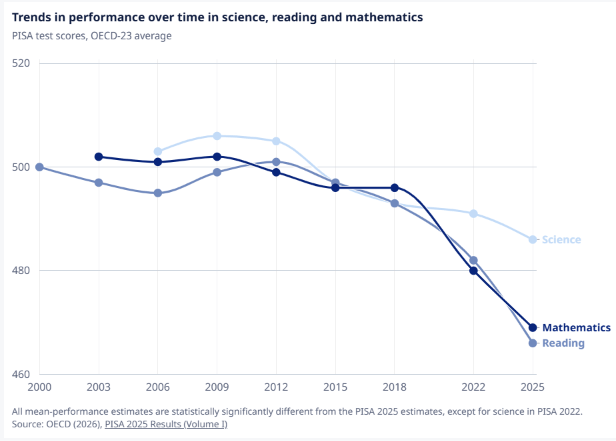
Uno de los principales resultados es el descenso continuado del rendimiento educativo en los países de la OCDE. Los resultados medios de 2025 constituyen los niveles más bajos registrados hasta ahora por PISA en matemáticas y lectura, mientras que el rendimiento en ciencias se mantiene relativamente estable respecto a 2022. Entre 2015 y 2025, la puntuación media de lectura disminuyó 28 puntos, equivalente aproximadamente a un año y medio de aprendizaje, mientras que matemáticas descendió 22 puntos, algo más de un año de aprendizaje.

El deterioro de la comprensión lectora resulta especialmente relevante en el contexto actual. La OCDE señala que han disminuido precisamente algunas de las capacidades que adquieren mayor importancia en un entorno saturado de información e inteligencia artificial: evaluar la información, relacionar contenidos procedentes de diferentes fuentes y desarrollar un pensamiento crítico sobre lo que se lee. Además, la proporción de estudiantes que realizan una lectura rápida pero poco precisa —lo que el informe denomina hasty reading— prácticamente se duplicó, pasando al 9 % en 2025.

La desigualdad social continúa teniendo una influencia considerable sobre los resultados educativos. En los países de la OCDE, los estudiantes procedentes de contextos socioeconómicos favorecidos obtuvieron, de media, 85 puntos más en ciencias que los estudiantes desfavorecidos. Aunque la brecha se redujo entre 2022 y 2025, la OCDE advierte que esto se debe en buena medida al descenso del rendimiento de los estudiantes favorecidos y no a una mejora equivalente entre los estudiantes desfavorecidos.

Un aspecto particularmente interesante del informe es la relación entre educación, digitalización e inteligencia artificial. PISA 2025 señala que las tecnologías digitales y la IA pueden contribuir al aprendizaje y preparar a los jóvenes para el futuro, pero su utilización debe responder a objetivos educativos concretos. El uso excesivo de dispositivos o su utilización con fines recreativos durante las clases se asocia con peores resultados. Más de uno de cada cuatro estudiantes afirma que sus compañeros se distraen con dispositivos digitales en la mayoría o en todas las clases de ciencias.

El informe introduce además una cuestión muy significativa sobre el uso educativo de la inteligencia artificial generativa. Los estudiantes que afirmaron no utilizar IA para redactar trabajos obtuvieron mejores resultados que quienes declararon utilizarla con ese propósito. Sin embargo, entre los usuarios frecuentes, aquellos que empleaban la IA para aprender y que habían recibido formación para evaluar la calidad de la información generada tendían a obtener mejores resultados que quienes utilizaban estas herramientas sin recibir orientación. Esto apunta a que el problema no reside únicamente en utilizar o no utilizar IA, sino en cómo, para qué y con qué competencias se utiliza.

Otro elemento novedoso es la evaluación de Learning in the Digital World, destinada a analizar hasta qué punto los estudiantes están preparados para utilizar herramientas digitales y resolver problemas complejos dividiéndolos en tareas más pequeñas. En los países de la OCDE, casi dos tercios de los estudiantes alcanzaron el nivel correspondiente de competencia en resolución computacional de problemas, pero solamente alrededor de la mitad consiguió hacerlo manteniendo simultáneamente una competencia básica en ciencias, lectura y matemáticas. La OCDE subraya así la necesidad de combinar las competencias digitales con unas sólidas capacidades fundamentales de lectura, matemáticas y ciencias.

Los resultados también muestran diferencias importantes entre sistemas educativos. Las jurisdicciones chinas de Pekín, Shanghái, Jiangsu y Zhejiang, junto con Singapur, aparecen entre los sistemas con mejores resultados globales en las tres áreas evaluadas. Estonia, Japón, Corea, Macao (China), Taipéi Chino y Reino Unido también se encuentran entre los diez sistemas con mayor rendimiento. Al mismo tiempo, algunos países han conseguido mejorar determinados resultados científicos desde 2022, entre ellos Costa Rica, Eslovaquia, Türkiye y Reino Unido dentro de la OCDE.

En conjunto, PISA 2025 plantea una cuestión central para la educación en la era de la inteligencia artificial: la tecnología no puede sustituir a las competencias fundamentales que permiten comprender, analizar y evaluar la información. La lectura profunda, el pensamiento crítico, la capacidad de contrastar fuentes y el dominio de conocimientos básicos adquieren incluso mayor importancia cuando los estudiantes disponen de herramientas capaces de generar respuestas automáticamente. Desde esta perspectiva, el informe resulta especialmente relevante para las bibliotecas escolares, universitarias y públicas, porque refuerza el papel de la alfabetización informacional, mediática y digital como competencias necesarias para desenvolverse en un entorno caracterizado por la abundancia de información y la presencia creciente de la IA.

La búsqueda con inteligencia artificial no está sustituyendo a Google: se está superponiendo al buscador tradicional

Jarboe, Greg. “AI Search Isn’t Replacing Google, It’s Layering On Top – Similarweb Data.” Search Engine Journal, 30 de julio de 2026.

El artículo analiza datos del informe 2026 Generative AI Landscape: The Evolution of AI Search, elaborado por Similarweb.

La expansión de ChatGPT y otros sistemas de IA generativa no está suponiendo, al menos por ahora, el abandono de Google, sino la incorporación de una nueva capa de búsqueda y descubrimiento que convive con los buscadores tradicionales. El análisis cuestiona tanto la idea de que la IA ya haya sustituido a los buscadores como la posición contraria de que la búsqueda generativa sea simplemente una moda pasajera. Los datos muestran un escenario mucho más complejo, en el que los usuarios combinan diferentes herramientas dependiendo de la tarea que quieren realizar.

Uno de los datos más significativos procede del análisis del solapamiento de audiencias entre ChatGPT y Google realizado por Similarweb entre marzo y mayo de 2026. De los 494 millones de usuarios de ChatGPT considerados en ese periodo, 461 millones —el 95 %— también utilizaron Google. Esto indica que la utilización de ChatGPT no implica necesariamente abandonar Google. El usuario puede recurrir a ChatGPT para determinadas consultas y continuar utilizando Google para otras. En paralelo, Similarweb calcula que los buscadores tradicionales alcanzaron aproximadamente 3.300 millones de visitantes únicos mensuales, frente a unos 655 millones para el conjunto de los chatbots de IA, aunque estos últimos registraron un crecimiento interanual del 57 %. Por tanto, el ecosistema de búsqueda sigue siendo mucho mayor que el de los chatbots, pero estos están creciendo con rapidez.

El artículo destaca asimismo la evolución de las citas y enlaces incluidos en las respuestas de ChatGPT. En mayo de 2026, aproximadamente el 6,8 % de las respuestas de ChatGPT en Estados Unidos incluían un enlace externo, frente a alrededor del 1 % un año antes. El crecimiento es considerable, pero todavía significa que la gran mayoría de las respuestas no generan directamente una visita hacia una página externa. Esto tiene importantes consecuencias para editores, medios de comunicación, bibliotecas, universidades y organizaciones que tradicionalmente han medido su visibilidad digital mediante visitas procedentes de buscadores. La visibilidad dentro de una respuesta de IA puede convertirse en un indicador relevante aunque no produzca inmediatamente un clic.

Al mismo tiempo, los datos muestran que la IA generativa está creciendo rápidamente. Las plataformas de IA generativa registraron alrededor de 9.500 millones de visitas web mensuales promedio entre junio de 2025 y mayo de 2026, un 70 % más que el año anterior. Las descargas mundiales de aplicaciones alcanzaron los 2.700 millones, con un crecimiento del 134 %. Además, aproximadamente la mitad de los usuarios de IA generativa ya tienen 35 años o más, frente a una concentración mucho mayor de usuarios jóvenes dos años antes. Estos datos sugieren una progresiva extensión de estas herramientas hacia públicos más amplios y hacia usos profesionales, educativos y cotidianos.

Un aspecto particularmente interesante para el estudio de la visibilidad científica y documental es la diferencia entre las páginas que una IA cita y las páginas a las que finalmente llegan los usuarios. Según los datos recogidos en el artículo, el 65 % de las URL citadas por ChatGPT se encuentran a dos o tres niveles de profundidad dentro de un sitio web, es decir, no son necesariamente las páginas principales. Sin embargo, el 58,8 % del tráfico procedente de IA llega finalmente a la página de inicio de los sitios. Esto significa que la página utilizada por el sistema de IA como fuente y la página que visita posteriormente el usuario pueden ser diferentes. La distinción es importante porque obliga a separar la medición de la visibilidad o citación en IA de la medición del tráfico de referencia y de las conversiones.

Esta cuestión modifica también la manera de entender el SEO en la era de la IA. El posicionamiento ya no consiste únicamente en aparecer entre los primeros resultados de Google. Una organización puede tener contenidos que sean utilizados como fuentes por un sistema de IA aunque esos contenidos no reciban directamente una visita. En consecuencia, comienzan a adquirir importancia conceptos como AI visibility, AI citations, share of voice, referral traffic y citation rate. El artículo propone que estos indicadores no se mezclen en una única métrica, sino que se analicen por separado: por una parte, hay que conocer con qué frecuencia y profundidad aparece nuestro contenido como fuente; por otra, qué tráfico llega efectivamente desde las plataformas de IA y qué hacen posteriormente esos usuarios.

Otro elemento destacado es que no todos los sistemas de IA tienen el mismo público ni los mismos patrones de utilización. Los datos de afinidad de Similarweb muestran diferencias entre ChatGPT, Claude y Gemini. ChatGPT presenta una mayor afinidad con usuarios que buscan información relacionada con ámbitos cotidianos como restaurantes, salud o moda; los usuarios de Claude presentan una relación especialmente elevada con sitios universitarios y perfiles profesionales y estudiantiles; mientras que Gemini muestra una mayor afinidad con contenidos relacionados con gráficos, seguridad y hardware. Esto plantea una cuestión importante para la producción de contenidos: no parece suficiente hablar genéricamente de “optimización para IA”, porque cada plataforma puede presentar audiencias, contextos de utilización y mecanismos de descubrimiento diferentes.

El artículo también introduce una idea especialmente relevante para bibliotecas, repositorios institucionales y publicaciones científicas: la aparición de la IA está cambiando el concepto tradicional de descubrimiento de información. En el modelo clásico, el usuario formula una consulta en un buscador, recibe una lista de resultados, selecciona una página y accede al documento. En el nuevo modelo, el usuario puede formular una pregunta directamente a un sistema generativo, recibir una síntesis y consultar solamente algunas de las fuentes citadas. Esto desplaza parte del proceso desde la recuperación de documentos hacia la recuperación y síntesis de conocimiento. Para las instituciones que producen información de calidad, ser una fuente reconocible y citable por los sistemas de IA puede adquirir tanta importancia como conseguir una buena posición en los resultados tradicionales.

Sin embargo, el propio artículo advierte contra las interpretaciones excesivamente simples. Que el 95 % de los usuarios de ChatGPT también utilice Google no significa que todas sus búsquedas se realicen en Google. El dato mide solapamiento de audiencias, no frecuencia de consultas. El hecho de que una persona utilice Google al menos una vez durante el periodo analizado no permite saber qué proporción de sus consultas informativas ha trasladado a ChatGPT. Por ello, el porcentaje del 95 % debe interpretarse como una medida de coincidencia entre públicos, no como una demostración de que la IA no esté sustituyendo determinadas búsquedas. Esta distinción es importante para comprender correctamente los datos.

El artículo llega así a una conclusión más matizada: la transformación de la búsqueda parece estar produciéndose mediante una convivencia y superposición de sistemas. Google continúa siendo una infraestructura fundamental de búsqueda, mientras que los sistemas de IA están introduciendo nuevas formas de formular preguntas, sintetizar información, comparar fuentes y descubrir contenidos. Además, Google está incorporando sus propias funciones de IA, por lo que la frontera entre “buscador tradicional” y “buscador con inteligencia artificial” se vuelve cada vez menos nítida. En consecuencia, el futuro de la recuperación de información no parece consistir simplemente en sustituir una herramienta por otra, sino en una progresiva integración de diferentes capas de búsqueda, síntesis y recomendación.

El impacto emocional y pedagógico que la Inteligencia Artificial está teniendo sobre profesores y docentes

Kang, Jay Caspian. “The Despair of the Professor in the Age of A.I.” The New Yorker, 26 de mayo de 2026, sección Fault Lines. Leer el artículo original en The New Yorker

Uno de los aspectos menos visibles de la expansión de la inteligencia artificial generativa en la educación superior: el impacto emocional y pedagógico que está teniendo sobre profesores y docentes. Más que centrarse exclusivamente en el problema del plagio o en la utilización de ChatGPT para realizar trabajos académicos, Kang plantea una cuestión más profunda: qué ocurre cuando la tecnología empieza a eliminar precisamente aquellas experiencias de esfuerzo, descubrimiento, frustración y elaboración personal que constituían una parte esencial de la relación entre profesores y estudiantes.

El autor parte de una experiencia universitaria propia para recordar el valor de un profesor que consiguió que un estudiante leyera y comprendiera un texto que probablemente nunca habría abordado por iniciativa propia. Para Kang, esa capacidad del profesor de acompañar al estudiante hacia una idea nueva constituye uno de los valores más difíciles de medir de la educación universitaria.

El punto de partida del artículo es el testimonio de Jane Sloan Peters, profesora de estudios religiosos, que describe cómo cambió uno de sus cursos, Letters from Prison. Durante los primeros años, los estudiantes tenían dificultades para formular una idea propia a partir de las lecturas. Precisamente ese esfuerzo constituía parte del aprendizaje: mediante lluvia de ideas, discusión y sucesivas revisiones, acababan desarrollando interpretaciones personales. Sin embargo, posteriormente comenzaron a aparecer trabajos mucho más fluidos formalmente pero también mucho más genéricos, con resúmenes perfectamente estructurados y conclusiones que parecían abarcarlo todo sin plantear realmente una idea propia. Peters sospechó que muchos estudiantes estaban utilizando IA generativa. Al introducir ejercicios manuscritos y otras actividades destinadas a recuperar el proceso de elaboración personal, experimentó una fuerte sensación de pérdida: la profesora ya no estaba simplemente enseñando una materia, sino intentando reconstruir las condiciones que permitieran a sus alumnos pensar por sí mismos.

Una de las ideas centrales del texto es que el problema no puede reducirse a “estudiantes que hacen trampas”. Peters y otros docentes entrevistados por Kang perciben que la IA está intensificando un modelo educativo que ya era predominantemente transaccional: el estudiante paga por una titulación, entrega determinados productos para obtener una calificación y finalmente consigue una credencial. La IA hace mucho más sencillo producir esos productos sin necesariamente realizar el proceso intelectual que debería acompañarlos. El resultado es una tensión entre obtener una respuesta y adquirir conocimiento, entre completar una tarea y aprender a formular preguntas, argumentar, escribir, interpretar y equivocarse. El artículo recoge además una observación interesante: algunos profesores afirman que incluso estudiantes que utilizan IA desean que sus docentes mantengan expectativas elevadas y les exijan realizar un trabajo intelectual genuino.

Los testimonios reunidos por Kang muestran que la experiencia no es homogénea. Susanna F. Boxall, profesora de filosofía, considera especialmente problemática la combinación entre IA, educación en línea y descenso demográfico de estudiantes universitarios. Según su experiencia, determinados cursos en línea han perdido buena parte de su capacidad para garantizar un aprendizaje auténtico y algunas tareas tradicionales, como los trabajos escritos, se han vuelto muy difíciles de controlar. Su alternativa ha sido recurrir a actividades presenciales y exámenes orales, aunque reconoce que este modelo resulta difícil de aplicar cuando existen grupos numerosos. Al mismo tiempo, otros profesores encuentran usos positivos de la IA: Kevin Sun, profesor de informática, explica que las herramientas pueden ayudar a preparar materiales docentes y permiten plantear ejercicios en los que los estudiantes deben evaluar código generado por IA, desplazando parcialmente el aprendizaje desde la producción hacia la revisión crítica.

El artículo también recoge experiencias que muestran que la IA puede convertirse en un estímulo para rediseñar la pedagogía, en lugar de limitarse a combatirla. Daniel Silver, profesor de sociología, explica que tuvo que dedicar mucho más tiempo a crear nuevos tipos de actividades, incluyendo simulaciones en las que los estudiantes representan teorías de autores como Adam Smith o Max Weber y experimentan con ellas. Según su experiencia, algunos de estos proyectos produjeron más creatividad y trabajo intelectual que los ensayos convencionales. Silver también utiliza ejemplos de trabajos generados por IA para mostrar a los estudiantes cómo tienden a parecerse entre sí y para plantearles el desafío de producir algo que vaya más allá de ese nivel de respuesta. Su experiencia introduce una perspectiva importante: la aparición de la IA obliga a replantear qué tipo de actividades permiten demostrar realmente que se ha aprendido.

Una dificultad especialmente importante aparece en la educación en línea. Elizabeth Strom, profesora de la University of South Florida, señala que resulta prácticamente imposible impedir completamente el uso de IA en cursos totalmente virtuales. El problema no es solamente detectar si un texto ha sido generado artificialmente, sino determinar su procedencia cuando el profesor trabaja con decenas de estudiantes a los que apenas conoce. Las tareas pueden diseñarse incorporando citas, números de página, opiniones personales, debates o juegos de rol, pero también pueden ser manipuladas con herramientas generativas. Strom señala además la falta de criterios institucionales uniformes: cuando cada profesor establece sus propias reglas sobre IA, los estudiantes reciben mensajes diferentes acerca de qué usos son aceptables.

Otro aspecto relevante es la transformación del papel del profesor. Neal Hebert, profesor de teatro, explica que ha pasado de considerarse un colaborador en el aprendizaje de sus estudiantes a sentirse en ocasiones como un investigador de plagio. Después de comprobar que numerosos trabajos sobre obras conocidas presentaban estructuras y expresiones similares a las generadas por ChatGPT, comenzó a utilizar obras menos conocidas, sobre las que los modelos tienen menos información disponible. Sin embargo, incluso esta estrategia tiene limitaciones. Su testimonio refleja una preocupación más profunda: si los estudiantes dejan de leer, interpretar y experimentar personalmente con las obras, podrían perder parte de la capacidad crítica y creativa que necesita un profesional de las artes.

El artículo presenta también una perspectiva más favorable a la incorporación de la IA. Auyon Siddiq, profesor de gestión y tecnología en UCLA, describe un curso de estadística en el que se permite explícitamente el uso de IA, incluso durante los exámenes, para comprobar qué sucede cuando los estudiantes pueden utilizar libremente estas herramientas. La experiencia le ha llevado a reconsiderar la enseñanza y a dedicar más tiempo a aspectos como la estructura de las clases, los ejemplos y los casos prácticos. Lauren Aulet, investigadora de psicología y ciencias cerebrales, señala igualmente que la IA puede reducir considerablemente el coste de experimentar con código y análisis computacional. Estos testimonios introducen una distinción fundamental: que la IA sea problemática para determinadas formas de evaluación no significa que carezca de utilidad para la investigación o la enseñanza.

Uno de los problemas más destacados por los docentes es, por tanto, la pérdida de confianza. Beth Ritter-Conn explica que la educación universitaria puede funcionar como un espacio de descubrimiento en el que los estudiantes formulan ideas, se equivocan, reciben retroalimentación y modifican sus puntos de vista. Si el profesor no sabe si una reflexión, un diario personal o una respuesta a una lectura procede realmente del estudiante, se rompe una parte esencial de esa relación. La docente ha respondido aumentando las actividades presenciales, la escritura a mano, los exámenes en papel y la toma de apuntes sin dispositivos. Estas medidas parecen mejorar la situación, pero también convierten al profesor en una figura que debe vigilar y controlar constantemente el uso de tecnología, en lugar de concentrarse exclusivamente en enseñar.

El caso de Jane Sloan Peters adquiere especial relevancia al final del artículo porque introduce una dimensión generacional. Recuperando una reflexión de Toni Morrison sobre el lenguaje y la relación entre generaciones, Peters plantea que los estudiantes también están viviendo una situación de incertidumbre ante una tecnología que transformará sus vidas. Desde esta perspectiva, los jóvenes no solo necesitan que los profesores les digan qué está permitido y qué está prohibido, sino que esperan de ellos orientación para comprender qué significa seguir pensando y escribiendo en un mundo en el que una máquina puede producir textos convincentes en segundos. La cuestión no sería únicamente cómo impedir el uso de IA, sino cómo ayudar a los estudiantes a comprender por qué sus propias palabras, sus errores, sus dudas y sus procesos de pensamiento siguen teniendo valor.

Enseñar tecnología a personas adultas: estrategias para generar confianza y autonomía desde las bibliotecas

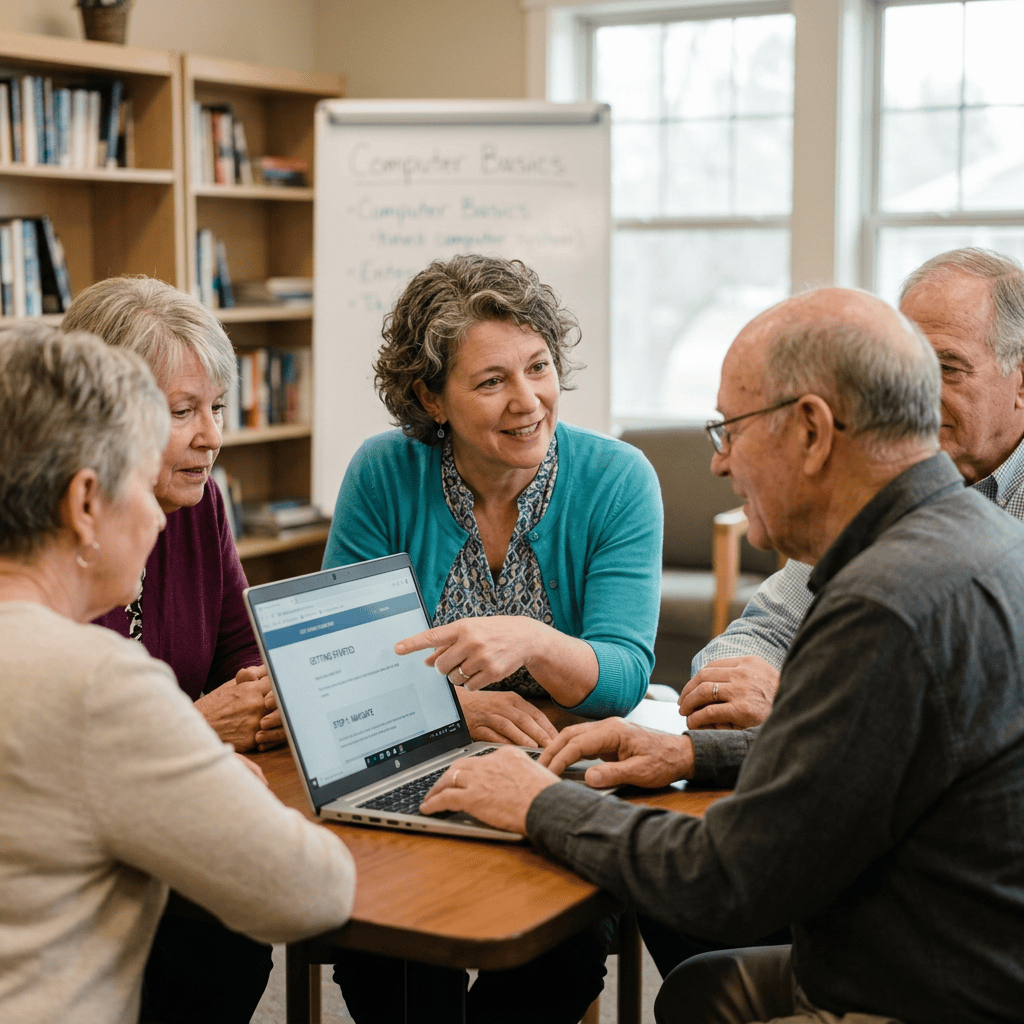
Instructor teaching older adults computer basics around a laptop
Older adults learn essential computer skills together during an encouraging group workshop.

WebJunction. (2026, 16 de julio). Teaching technology to adults: Confidence-building advice from the field. WebJunction, OCLC.
Acceder al artículo original en WebJunctio

Se aborda uno de los retos habituales de las bibliotecas públicas: ayudar a las personas adultas a desenvolverse con tecnologías que pueden resultarles complejas, intimidantes o cambiantes. La propuesta parte de una idea fundamental: muchas dificultades tecnológicas no deben interpretarse únicamente como una carencia de habilidades, sino también como un problema de confianza y seguridad personal.

La experiencia procede de Steve Alcalde, responsable de Servicios Informáticos y Tecnológicos de Rogers Memorial Library, cuyo equipo imparte aproximadamente diez clases de tecnología al mes y atiende diariamente consultas tecnológicas de usuarios y personal. El planteamiento fue presentado en una sesión de la PLA dedicada precisamente a enseñar tecnología a adultos que consideran que son «malos con la tecnología».

Uno de los principales mensajes del artículo es que la finalidad de la alfabetización tecnológica no debería limitarse a resolver el problema concreto que plantea el usuario, sino conseguir que este adquiera suficiente confianza para enfrentarse posteriormente a situaciones similares por sí mismo. Desde esta perspectiva, la intervención bibliotecaria se transforma: el profesional deja de ser simplemente quien «arregla» el problema y pasa a desempeñar una función de acompañamiento y formación. Esta diferencia es importante porque una solución rápida puede resolver la dificultad inmediata, pero no necesariamente proporciona al usuario los conocimientos o la seguridad necesarios para repetir el procedimiento de manera autónoma.

El artículo propone varias estrategias prácticas. La primera consiste en normalizar el miedo o la frustración ante la tecnología. Una persona puede temer equivocarse, romper el dispositivo, parecer poco competente o no comprender las explicaciones. Reconocer que determinadas tecnologías pueden resultar confusas ayuda a reducir esa sensación de inseguridad. También se recomienda adoptar una posición física y comunicativa más colaborativa: sentarse junto al usuario en lugar de situarse enfrente y, sobre todo, no quitarle el dispositivo de las manos. Aunque manejar directamente el teléfono o el ordenador pueda ser más rápido para el profesional, permitir que la propia persona realice las acciones favorece el aprendizaje, la familiarización con el dispositivo y la adquisición de confianza.

Otro aspecto especialmente relevante es el lenguaje empleado por el personal bibliotecario. Expresiones aparentemente inocentes como «es muy fácil» o «solo tienes que…» pueden aumentar la frustración cuando el usuario está teniendo dificultades. WebJunction propone sustituir este tipo de formulaciones por expresiones de acompañamiento, como «tú inténtalo y yo te guío», «tómate tu tiempo» o «vamos a hacerlo paso a paso». Se trata de eliminar el lenguaje excesivamente técnico y evitar que la persona sienta que su dificultad es consecuencia de una supuesta incapacidad. La comunicación se convierte así en una parte esencial de la alfabetización digital.

La fragmentación de los procesos en pequeñas acciones constituye otra de las recomendaciones centrales. Lo que para un profesional habituado a utilizar una determinada aplicación o servicio puede ser una secuencia automática de pasos, para un usuario puede representar una sucesión de decisiones desconocidas. Por ello, se aconseja explicar una sola acción cada vez, comprobar que la persona la ha realizado y continuar posteriormente con el siguiente paso. A esto se añade la recomendación de reducir deliberadamente la velocidad de explicación. El profesional puede tener interiorizado el procedimiento después de haberlo realizado cientos de veces, mientras que el usuario necesita tiempo para localizar botones, comprender términos y relacionar las instrucciones con lo que aparece en pantalla.

El artículo también plantea la conveniencia de comenzar por pequeños logros o «victorias rápidas». En lugar de abordar inmediatamente una tarea compleja, puede ser útil empezar con una acción sencilla que permita experimentar una sensación de éxito: aumentar el tamaño del texto, enviar una fotografía o realizar una operación básica. Estos pequeños avances funcionan como refuerzo positivo y pueden modificar la percepción que la persona tiene de sus propias capacidades. El objetivo no es únicamente completar una tarea, sino construir progresivamente una percepción de autonomía: «puedo hacerlo».

Un elemento particularmente interesante es la necesidad de preguntar y obtener retroalimentación durante la formación. El profesional no debería asumir automáticamente que conoce el origen del problema. Una persona que parece tener dificultades con una aplicación puede, en realidad, estar confundida por el proceso completo que hay detrás. Preguntas sencillas como «¿qué parte no coincide con lo que esperabas?» permiten descubrir las verdaderas dificultades y corregir las explicaciones. De esta manera, la interacción se convierte en un proceso bidireccional en el que también el bibliotecario aprende a identificar sus propias suposiciones y a mejorar sus métodos de enseñanza.

El artículo ofrece un ejemplo muy ilustrativo relacionado con el aprendizaje de la fotografía y el envío de imágenes desde un iPhone. El usuario seguía las instrucciones, pero dudaba antes de realizar cada paso. Cuando el instructor preguntó si estaba explicando demasiado deprisa, descubrió que la persona no conocía algunos términos utilizados y necesitaba más tiempo para localizar cada elemento en la pantalla. La solución consistió en reducir el ritmo, explicar una acción cada vez, evitar vocabulario técnico no explicado y ofrecer al usuario la posibilidad de intentar por sí mismo el siguiente paso. Al finalizar, la persona manifestó que creía que podría realizar el procedimiento en casa. Para WebJunction, este resultado es más significativo que la simple resolución de la consulta, porque demuestra que se ha conseguido transferir confianza y autonomía.

Otro ejemplo aborda un problema aparentemente técnico relacionado con la impresión desde el teléfono móvil utilizando la red Wi-Fi de la biblioteca. El usuario no entendía por qué el documento no salía inmediatamente de la impresora después de pulsar «imprimir». El problema no estaba realmente en la utilización de la página web, sino en que la persona tenía un modelo mental diferente del funcionamiento del servicio: esperaba que el documento se imprimiera automáticamente, como ocurría en su domicilio. La explicación del proceso completo —enviar el documento, acudir al mostrador, realizar el pago y liberar la impresión— permitió comprender la lógica del sistema. Además, se explicó que el mecanismo de liberación contribuía a proteger la privacidad de los usuarios. El ejemplo demuestra la importancia de explicar el funcionamiento global de un servicio y no únicamente los pasos técnicos.

En un sentido más amplio, el artículo presenta la alfabetización tecnológica como una tarea educativa y no simplemente asistencial. Las bibliotecas ofrecen cada vez más apoyo para utilizar teléfonos inteligentes, ordenadores, aplicaciones, servicios digitales, sistemas de impresión y otras herramientas tecnológicas. En este contexto, cada consulta individual puede convertirse en una oportunidad para desarrollar competencias que permitan al usuario afrontar nuevos problemas. Esta concepción conecta directamente con la función tradicional de las bibliotecas como espacios de aprendizaje permanente y con su papel en la reducción de las brechas digitales. WebJunction sitúa precisamente la formación de usuarios entre las áreas fundamentales de los servicios bibliotecarios y reúne recursos específicos sobre alfabetización digital y enseñanza a usuarios.

Digitalización a gran escala en la era de la inteligencia artificial: cuestiones y modelos de acuerdo para bibliotecas y sus socios

Center for Research Libraries (CRL). (2026). Large Scale Digitization in the AI Era: Issues and Model Terms for Libraries and Their Partners. Center for Research Libraries, 14 pp. Publicado el 14 de septiembre de 2026.

Texto completo

El documento del Center for Research Libraries (CRL) aborda el creciente número de propuestas para digitalizar colecciones bibliotecarias a gran escala y utilizar posteriormente esos contenidos y sus metadatos en sistemas comerciales de inteligencia artificial. Estas colaboraciones pueden facilitar la preservación, ampliar el acceso a las colecciones y reducir los costes de digitalización, pero plantean cuestiones fundamentales sobre propiedad, usos autorizados, acceso público, control institucional, compensación, atribución, privacidad y custodia a largo plazo.

El informe propone que las bibliotecas establezcan condiciones claras antes de poner sus colecciones a disposición de empresas tecnológicas y sistemas de IA. El CRL considera especialmente importante que las instituciones comprendan qué valor generan sus colecciones digitales y qué usos podrán realizar terceros con ellas. El documento pretende servir como punto de partida para desarrollar términos contractuales comunes y orientar futuras negociaciones entre bibliotecas y empresas, incluyendo posibles acuerdos colectivos, solicitudes conjuntas de propuestas y la creación de corpus digitales compartidos.

En definitiva, el informe plantea que la digitalización ya no debe contemplarse únicamente como una estrategia de preservación y acceso, sino también como una cuestión de gobernanza de datos culturales y científicos en la era de la IA. Las decisiones que adopten ahora las bibliotecas pueden contribuir a establecer nuevas normas sobre cómo se utilizan comercialmente colecciones que han sido conservadas y gestionadas como bienes de interés académico y cultural. El CRL señala que cualquier modelo definitivo deberá someterse a nuevas discusiones entre las bibliotecas y a revisión jurídica.

Finalmente, el documento presenta una plantilla marco de términos modelo (Model Digitization Terms) que sirve como guía de negociación para los contratos:

  • Propósito, alcance y derechos de la biblioteca: La biblioteca debe mantener autoridad final sobre qué se digitaliza y conservar derechos para preservar, analizar, albergar y prestar los archivos.
  • Usos del socio e IA: Se exige que cualquier entrenamiento de modelos, evaluación o comercialización mediante IA requiera una autorización explícita y específica, de modo que el silencio contractual nunca sea interpretado como permiso.
  • Metadatos y estándares técnicos: Se debe limitar la cesión inicial de metadatos al mínimo necesario y exigir que el socio devuelva OCR enriquecido, transcripciones e identificadores en formatos interoperables y de calidad de conservación.
  • Estructura económica e indemnizaciones: El socio comercial debe asumir los costos directos e incrementales del proyecto. Legalmente, se debe eximir a la biblioteca de garantizar autorizaciones masivas de derechos de autor, trasladando la responsabilidad e indemnización de los usos derivados al desarrollador.
  • No exclusividad y gobernanza: Salvo excepciones temporales y justificadas, las licencias deben ser no exclusivas, sin cláusulas de confidencialidad que impidan transparentar los términos ante la comunidad académica.