Archivo del Autor: Julio Alonso Arévalo

Avatar de Desconocido

Acerca de Julio Alonso Arévalo

Bibliotecario de la Facultad de Traducción y Doc. de la USAL. Ex-Miembro del Grupo de Investigación E-LECTRA. Premio Nacional de Investigación por la UNE Premio mejor Profesional Social Media INFOAWARDS 2019. Creador y editor del repositorio E-LIS. Más de 80 artículos científicos publicados - Ver en E-LIS -en revistas científicas. El profesional de la información, Library Hi-Tech, Electronic Library. Investigación Bibliotecológica, Anales de Documentación... 12 libros publicados: Nueva fuentes de información en el contexto de la web 2.0 (Pirámide), Gutemberg 2.0 (TREA). Social Reading (Elsevier), eBooks en bibliotecas universitarias (TREA), El ecosistema del libro electrónico universitario (UNE), Un viaje a la cultura open (Amazon), GRATIS Zotero (Creative Spaces), Leyendo entre Pantallas (Trea), GRATIS Literaçia da infomrçao (ISPA) GRATIS Espistemologia y acceso abierto (UCE) GRATIS Makerspaces y bibliotecas. Barcelona: El Profesional de la Información EPI-UOC, 2018. Makerspaces. Espacios creativos en bibliotecas: creación, planificación y programación de actividades. Salamanca: Ediciones del Universo, 2019. Los libros, la lectura y los lectores a través de la literatura y las artes. Buenos Aires : Alfagrama Ediciones, 2019 Más de 2000 citas en Google Schoolar Creador y gestor del blog Universo abierto Director del programa de Radio Planeta Biblioteca Más de 250.000 seguidores en los grupos profesionales de Facebook.

La era de Zettabyte: tendencias y análisis

captura_de_pantalla_2014-01-13_a_las_14-58-12


The Zettabyte Era: Trends and Analysis June 2017. [e-Book]  San José, California, Cisco, 2017

Texto completo

El tráfico IP global anual alcanzará 3,3 ZB por año para 2021, o 278 exabytes (EB) por mes. En 2016, la tasa de ejecución anual para el tráfico IP global fue de 1,2 ZB por año, o 96 EB por mes.

El tráfico IP global se triplicará en los próximos cinco años. En general, el tráfico IP crecerá a una tasa de crecimiento anual compuesta (CAGR) del 24 por ciento de 2016 a 2021. El tráfico IP mensual llegará a 35 GB per cápita en 2021, frente a los 13 GB per cápita de 2016.

El tráfico de Internet en horas punta está creciendo más rápidamente que el tráfico medio de Internet. La hora punta (o el período de 60 minutos más ocupado en un día) el tráfico de Internet aumentó 51 por ciento en 2016, comparado con el crecimiento del 32 por ciento en el tráfico promedio. Entre 2016 y 2021, el tráfico medio de Internet aumentará en un factor de 4,6, mientras que el tráfico medio de Internet aumentará en un factor de 3,2.

El tráfico de Smartphone excederá el tráfico de PC. En 2016, los PCs representaron el 46 por ciento del tráfico IP total, pero para el año 2021 los PCs sólo representarán el 25 por ciento del tráfico. Los teléfonos inteligentes supondrán el 33 por ciento del tráfico IP total en 2021, frente al 13 por ciento en 2016. El tráfico originado por PC crecerá en un CAGR del 10 por ciento, y los televisores, tabletas, teléfonos inteligentes y módulos de Máquina a Máquina (M2M) tendrán tasas de crecimiento de tráfico del 21 por ciento, 29 por ciento, 49 por ciento y 49 por ciento, respectivamente.

El tráfico de dispositivos móviles e inalámbricos representará más del 63 por ciento del tráfico total de IP para 2021. Para el 2021, los dispositivos cableados representarán el 37 por ciento del tráfico IP, y los dispositivos Wi-Fi y móviles representarán el 63 por ciento del tráfico IP. En 2016, los dispositivos conectados representaron la mayoría del tráfico IP, con un 51 por ciento.

Las redes de entrega de contenido (CDN) transportarán el 71 por ciento del tráfico de Internet para 2021. Setenta y un por ciento de todo el tráfico de Internet atravesará las CDN para 2021 a nivel mundial, en comparación con el 52 por ciento en 2016.

El número de dispositivos conectados a redes IP será más del triple de la población mundial para 2021. Habrá 3,5 dispositivos conectados en red per cápita para 2021, frente a los 2,3 dispositivos conectados en red per cápita en 2016. En 2021 habrá 27.100 millones de dispositivos conectados en red, frente a los 17.100 millones de 2016.

La velocidad de la banda ancha casi se duplicará en 2021. Para 2021, las velocidades globales de banda ancha fija alcanzarán 53 Mbps, en comparación con los 27.5 Mbps de 2016.

Se necesitarían más de 5 millones de años para ver la cantidad de vídeo que atravesará las redes IP globales cada mes en 2021. Cada segundo, un millón de minutos de contenido de vídeo atravesará la red en 2021.

El vídeo en vivo por Internet representará el 13% del tráfico de vídeo en 2021. El vídeo en directo se multiplicará por 15 de 2016 a 2021.

El tráfico de videovigilancia por Internet aumentó un 71% en 2016, de 516 petabytes por mes a finales de 2015 a 883 petabytes por mes en 2016. El tráfico de videovigilancia en Internet se multiplicará por siete entre 2016 y 2021. Globalmente, el 3,4 por ciento de todo el tráfico de vídeo por Internet se debe a la videovigilancia en 2021, frente al 1,8 por ciento en 2016.

El tráfico de Realidad Virtual (VR) y Realidad Aumentada (AR) se multiplicará por 20 entre 2016 y 2021 a nivel mundial, un CAGR del 82 por ciento.

El vídeo en Internet para la televisión creció un 50 por ciento en 2016. Este tráfico seguirá creciendo a un ritmo acelerado y se multiplicará por 3,6 en 2021. El vídeo en Internet para la televisión será el 26 por ciento del tráfico de vídeo en 2021.

El tráfico de vídeo a la carta (VoD) casi se duplicará en 2021. La cantidad de tráfico VoD en 2021 equivaldrá a 7.200 millones de DVD al mes.

El tráfico de juegos de azar por Internet se multiplicará casi por diez de 2016 a 2021, una tasa de crecimiento del 57%. A nivel mundial, el tráfico de juegos de azar en Internet será el 4 por ciento del tráfico de Internet de los consumidores en 2021, frente al 1 por ciento en 2016.

Aspectos destacados del móvil global

A nivel mundial, el tráfico de datos móviles se multiplicará por siete entre 2016 y 2021. El tráfico de datos móviles crecerá en un CAGR del 46 por ciento entre 2016 y 2021, alcanzando 48,3 exabytes por mes en 2021.

El tráfico mundial de datos móviles crecerá dos veces más rápido que el tráfico IP fijo de 2016 a 2021. El tráfico IP fijo crecerá en un CAGR del 21 por ciento entre 2016 y 2021, mientras que el tráfico móvil crecerá en un CAGR del 46 por ciento. El tráfico mundial de datos móviles representó el 7 por ciento del tráfico IP total en 2016, y será el 17 por ciento del tráfico IP total en 2021.

Hechos destacados regionales

El tráfico IP está creciendo más rápidamente en Oriente Medio y África, seguido de Asia Pacífico. El tráfico en Oriente Medio y África crecerá a un ritmo del 42% entre 2016 y 2021.

Resumen de las tasas de crecimiento regional:

El tráfico IP en América del Norte llegará a 85 EB por

El analfabetismo ciega el espíritu

38840052865_a2466b02cc_b_d

«El Analfabetismo ciega el espíritu : soldado instrúyete» 

Vicente Vila Gimeno, Wila (Valencia, 30 de abril de 1908-Madrid, 28 de junio de 2009)


Cartel de guerra elaborado por Vicente Vila Gimeno, Wila, considerado como el último gran cartelista de la guerra civil española. Nos muestra en un impactante primer plano, frente a un libro abierto, la cabeza de un miliciano cuyos ojos están vendados. La mirada directa al espectador desaparece lo cual rompe la relación discursiva con éste dando paso al relato: el soldado no nos habla de su analfabetismo sino que es el cartel el que nos indica la incultura del soldado cegado. El contraste entre la oscuridad del casco y el rostro del miliciano con el brillante tono blanco del pañuelo y las hojas del libro, viene a destacar estos dos últimos elementos por encima de los demás pretendiendo mostrar lo que el rótulo indica: “El analfabetismo ciega el espíritu”. Fue elaborado para las Milicias de la Cultura, órgano creado por la República para la formación de los soldados en el frente, y es uno de los carteles más difundidos y reproducidos de la colección por su potente impacto visual.

Amparo José Mora Castro

Wila, 1908- «El Analfabetismo ciega el espíritu : soldado instrúyete» Valencia : Milicias de la Cultura. Propaganda y prensa, [entre 1936 i 1939] (Gráficas Valencia, Intervenido U.G.T. – C.N.T). Descripción física: 90 x 63 cm. litografia, col. ;

Notas de reproducción original: Reproducción digital del original conservado en la Biblioteca Histórica de la Universidad de Valencia.

33239454

Bibliotecas, lectura digital y aprendizaje.


X Jornada profesional de la RBIC. «Diez años de propuestas y tendencias en información y documentación (2008-2017)». Belén Llera, Dirección General de Bibliotecas, Archivos y Museos del Ayuntamiento de Madrid, y Julio Alonso Arévalo, Biblioteca de Traducción y Documentación de la Universidad de Salamanca, moderados por Felicidad Campal, Biblioteca Pública del Estado (Salamanca), debatiendo sobre bibliotecas, lectura digital y aprendizaje.


Las bibliotecas del futuro estarán hechas de ADN

file-20171204-22962-16lpmyk

Traducción de

The libraries of the future will be made of DNA
Jerome de Groot
Senior Lecturer, University of Manchester

January 5, 2018 11.57am GMT

Texto completo

 
A todos nos interesa la manera en que las bibliotecas y los archivos podrían funcionar en el futuro, cómo podrían configurarse y qué se podría almacenar, y por qué. Varias organizaciones están explorando formas físicas para almacenar la información de la humanidad. Pero la mayor parte de la actividad actual parece ser biológica. Varios científicos han comenzado a explorar la posibilidad de utilizar el ADN para almacenar información, llamada Nuclear Acid Memory (NAM). Esto implicaría que los datos serían «traducidos» a las letras GATC, los ácidos nucleicos básicos del ADN. Se crearían entonces filamentos de ADN que podrían ser traducidos de nuevo al «original» al ser secuenciados. Los investigadores han almacenado recientemente versiones archivísticas de la música de Miles Davis y Deep Purple y también de un breve GIF en forma de DNA.
.
.

Cada segundo se envían unos 6.000 tweets. En el tiempo que tardas en leer esta oración, se habrán enviado 42.000 tweets, que a un promedio de 34 caracteres por tweet, son 1.428.000 caracteres.

Worldwidewebsize analiza diariamente el tamaño de Internet. En el día que se hizo este post ascendía a 4.590 millones de páginas y mil millones de sitios web. Este es el Internet visible «indexado», pero no incluye la «web oscura» o bases de datos privadas. El tamaño de la red se mide de dos maneras. El primero es «contenido»; la capacidad de almacenamiento se estimó en 2014 en 1024 bytes, o un millón de exabytes. El segundo es el «tráfico», medido en zettabytes. El tráfico global recientemente pasó de un zettabyte, es decir el contenido de 250 mil millones de DVDs.

De manera más convencional, el Reino Unido publicó 184.000 libros en 2013, el mayor número de libros por habitante a nivel mundial. Añada las formas cada vez mayores de medir a un ser humano en términos de datos – secuenciación de ADN, árboles genealógicos en línea, codificación genética, cuentas bancarias, información en línea de todo tipo- o la cantidad de datos científicos que se producen y leen en todo el mundo-, y te darás cuenta que la cantidad de información en el mundo es asombrosa. Incluso la cantidad de espacio de almacenamiento que la mayoría de la gente necesita para fotos y documentos ha crecido enormemente en los últimos años.

Como especie, estamos produciendo información a un ritmo masivo. La «lectura» de la masa de datos ha conducido a nuevos modelos predictivos para la interacción social. Las empresas y los gobiernos se esfuerzan por utilizar estos datos a medida que los seres humanos parecen cada vez más legibles, manejables y -posiblemente- controlables a través de la comprensión y manipulación de la información.

Pero, ¿cómo podría almacenarse toda esta información? Actualmente contamos con bibliotecas físicas, archivos físicos y estanterías de libros. Internet en sí mismo está «almacenado» en servidores de disco duro en todo el mundo, usando enormes cantidades de energía para mantenerlos frescos. La infraestructura en línea es costosa, hambrienta de energía y vulnerable; su longevidad también es limitada – véase Die Hard 4.0 para una dramatización.

Bibliotecas del futuro

El futuro del almacenamiento de la información puede parecer aburrido, pero es una cuestión crucial para cualquier persona interesada en la forma en que las sociedades recuerdan. Un buen ejemplo son las historias familiares, donde los archivos públicos, como los registros del censo y la información tributaria, son cada vez más accesibles en línea. Millones de usuarios en todo el mundo utilizan sitios de suscripción como Ancestry o Findmypast para acceder a esta información pública y crear sus árboles genealógicos utilizando software en línea. Esta proliferación de información plantea cuestiones éticas sobre el acceso (registros públicos utilizados por empresas privadas para obtener beneficios) y sobre cómo se almacenan, gestionan y utilizan estos datos.

A todos nos interesa la manera en que las bibliotecas y los archivos podrían funcionar en el futuro, cómo podrían configurarse y qué se podría almacenar, y por qué. ¿Realmente necesitamos almacenar cada tweet enviado? Tomar cualquier tipo de decisión sobre qué almacenar – qué coleccionar, conmemorar, archivar – provoca una discusión compleja. Las tecnologías para acceder – «leer» – la información debe estar de alguna manera preparada para el futuro, o terminaremos con enormes cantidades de información que no se pueda utilizar.

Entonces: ¿qué hacer? En la actualidad se están llevando a cabo debates de gran alcance, desde qué información almacenar (incluidos varios biobancos llenos de especímenes biológicas), hasta cómo almacenarla, hasta dónde almacenarla (en el Ártico, en el espacio, bajo el agua). La mayoría de estas discusiones tienen lugar dentro de las comunidades científicas; algunas empresas tecnológicas están involucradas. Aquellos que han pasado años pensando en la memoria, la conmemoración y el archivo -historiadores y bibliotecarios- se encuentran a menudo al margen de la discusión.

Nanocristales y ADN

Varias organizaciones diferentes están explorando formas físicas para almacenar la información de la humanidad. Se ha sugerido el almacenamiento físico en discos de níquel (leídos por microscopio) o códigos de barras escritos con láser en vidrio de sílice. La nanotecnología, altamente experimental -y actualmente ávida de energía-, busca escribir información a un nivel casi molecular. El almacenamiento nanotecnológico sería «leído» mediante microscopía sofisticada, con «efecto» del cambio químico o de procesos bastante complicados, como los nanocristales que convierten la radiación (infra-roja) en algo «visible». Algunos de los modelos de almacenamiento más barrocos van desde una bóveda de memoria de datos flash en la luna hasta empresas privadas que envían contenido digital a Marte, pasando por satélites que orbitan la tierra.

Pero la mayor parte de la actividad actual parece ser biológica. Varios científicos han comenzado a explorar la posibilidad de utilizar el ADN para almacenar información, llamada Nuclear Acid Memory (NAM).

Esto implicaría que los datos serían «traducidos» a las letras GATC, los ácidos nucleicos básicos del ADN. Se crearían entonces filamentos de ADN que podrían ser traducidos de nuevo al «original» al ser secuenciados. Los investigadores han almacenado recientemente versiones archivísticas de la música de Miles Davis y Deep Purple y también de un breve GIF en forma de DNA.

El ADN es duradero y cada vez más fácil de producir y leer. Se mantendrá durante miles de años en las condiciones de almacenamiento adecuadas. El ADN podría almacenarse en cualquier lugar oscuro, seco, frío y posiblemente no ocuparía mucho espacio.

Gran parte de esta tecnología está en sus comienzos, pero los avances en nanotecnología y secuenciación del ADN sugieren que dentro de unos años veremos los resultados aplicados de la experimentación y el desarrollo. Surgen preguntas más amplias sobre la ética de la recolección y hasta qué punto estos procesos se convertirán en la corriente dominante. La impresión impresa, y en cierta medida digital, se ha convertido en una forma común y razonablemente democrática de transmitir y almacenar información. Queda por ver si el almacenamiento y la escritura en el futuro serán de fácil acceso, y quién controlará la información y la memoria de la humanidad en las próximas décadas y siglos.


Fuentes de información en la era digital: ¿Qué hace que una fuente de noticias sea «buena»?


media-bias-chart_3-0_hi-res

Otero, Vanessa. «What Makes A News Source “Good?” The Chart, Version 3.0

Posted on 

Ampliar imagen

PDF

Third Edition Blank


En el gráfico se recogen las fuentes de «buenas» noticias». En el eje vertical aparecen las fuentes de «alta calidad» y las de la parte inferior las de «baja calidad». Se caracterizaron las fuentes, de arriba a abajo, en este orden: Complejo, Analítico, Cumple con altos estándares, Básico y Sensacionalista. Esto funciona mayormente porque resulta en que las fuentes consideradas como de alto rango o veraces (por ejemplo, The Atlantic, The Economist) son clasificadas como de alto rango en el eje, y las fuentes de mala calidad (por ejemplo, Addicting Info, Conservative Tribune) son clasificadas como bajas, y los consumidores de noticias más sofisticadas están de acuerdo con eso.

En el pasado, los programas nacionales de noticias vespertinos, los programas locales de noticias nocturnas y las portadas de los periódicos impresos estaban dominados por reportajes de los hechos. Ahora, sin embargo, muchas fuentes que la gente considera como «fuentes de noticias» en realidad están dominadas por análisis y artículos de opinión. Este gráfico clasifica los medios de comunicación que la gente considera, en cierto nivel, como «fuentes de noticias», aunque muchos de ellos están compuestos enteramente por artículos de análisis y opinión.

Pero a pesar de ello, la calidad del artículo puede variar enormemente incluso dentro de la misma fuente de noticias. Uno debería ser capaz de clasificar un artículo individual en el gráfico de la misma manera que uno clasifica una fuente entera de noticias. Entonces, ¿qué hace que un artículo/historia sea de alta o baja calidad? En principio es difícil de eliminar  por completo el propio sesgo sobre ese tema, pero una manera de intentar hacerlo consistentemente es categorizar y calificar las oraciones y palabras reales que lo componen su titular y el artículo en sí.


Guía para los libreros de hoy… hasta que llegue mañana


25850871298_06b83bbde3_o_d

Marcos,Antonio. «Guía para los libreros de hoy… hasta que llegue mañana.» Centro Internacional de Tecnologías Avanzadas. Fundación Germán Sánchez Ruipérez, 2018

Texto completo

Esta guía de la Fundación Germán Sánchez Ruipérez para los libreros de hoy pretende ser un retrato robot de un tipo de establecimiento que, por la coyuntura social y tecnológica actual, debe reinventarse cada día para dar como resultado un modelo que quizás sea el que más extendido o relevante. Ese es el objetivo: responder cómo funciona y qué hace falta para ponerlo en marcha. Descárgate la guía y sigue las pistas para que la librería de tus sueños se haga realidad.


¿Cómo usan las bibliotecas las redes sociales?


libraries-and-social-media-1024x671

Frecuencia con que comparten información en diferentes medios sociales


How Libraries Use Social Media
Molly Bacon, Twitter: @mollymbacon 12 Oct 2017 3:58 PM

Texto completo

Descarga la infografía

Ver la encuesta


El ochenta y uno por ciento de los estadounidenses tienen cuentas de medios sociales, y se espera que ese número aumente cada año. Casi todas las marcas tienen una presencia social y las bibliotecas no son diferentes. Las bibliotecas están utilizando plataformas sociales ahora más que nunca. El 44% de las bibliotecas informaron que diariamente publicaban información en Facebook, y que el 25% lo hacían también en Twitter. Además, más de la mitad de los bibliotecarios encuestadas (56%) dicen que pasan al menos de 5 horas por semana en las redes sociales.


Con a llegada de las redes y la digitalización, cada vez más los bibliotecarios estamos siendo asesores tecnológicos para nuestras comunidades. Son muchas las bibliotecas que a diario recurrimos a las redes sociales para promocionar  y fomentar nuestros servicios y productos. Cada vez más las bibliotecas no son únicamente proveedoras de contenidos, si no que también somos creadores y editores de contenidos

La Biblioteca Pública de Nueva York tiene 2.2 millones de seguidores en Twitter. Los medios sociales están desempeñando un papel importante para ayudar a las bibliotecas a mantener su relevancia en la sociedad digital. Los medios sociales son el espacio digital donde las bibliotecas interactuan con tu comunidad.

TechSoup recientemente se asoció con WebJunction para hacer un estudio en el mes de diciembre de 2017 para averiguar cómo están usando los medios sociales las bibliotecas; para ello se analizaron respuestas de 311 bibliotecas en todo el país, un 63% eran Bibliotecas Publicas, un 20% Universitarias, un 4% Escolares y un 14% de otro tipo (Especiales, Nacionales, Consorcios). De la muestra el 55 por ciento de los encuestados atendía en poblaciones de menos de 25.000 usuarios, por lo que casi la mitad de los encuestados eran bibliotecas pequeñas, probablemente sobre todo en las zonas rurales, que proporcionaron algunos resultados de interés, como que el 44% de las bibliotecas informan que publican diariamente información en Facebook, y que el 25% lo hacen también en Twitter. Además, más de la mitad de los bibliotecarios encuestadas (56%) dicen que pasan al menos de 5 horas por semana en las redes sociales, y el 28 por ciento pasan de 6 a 10 horas a la semana.


hours-spent

Cuántas horas dedican a los medios sociales por semana


En cuanto a que redes utilizan más. Las bibliotecas utilizan Facebook más que cualquier otra plataforma social. Twitter es la siguiente plataforma más popular, y luego Instagram.


38823425675_2de112b364_b_d


¿Cuántos seguidores tienen en medios sociales?

En  cuanto a qué es lo que publican las bibliotecas en los medios sociales. Las bibliotecas utilizan los medios sociales para compartir eventos e imágenes, educar a la gente sobre los servicios, destacar sus colecciones y apoyar a otras bibliotecas.


8640-libraries-social-media-use

¿Para qué usan los medios sociales las bibliotecas?


El crecimiento de los seguidores y la búsqueda de personal de apoyo son algunos de los mayores desafíos de las bibliotecas en los medios sociales.


biggest-social-media-challenges

¿Cual es el objetivo de su uso?


Los resultados demuestran que las bibliotecas están usando las redes sociales con intensidad, y que están deseosas por hacer crecer sus canales.


Incentivos para la creación de Servicios de Gestión Datos de Investigación (RDM) en Bibliotecas Universitarias


1515089418982

Bryant, Rebecca ; Lavoie, Brian  ; Malpas, Constance. Incentives for Building University RDM Services. The Realities of Research Data Management Dublin, Part 3. Ohio: OCLC, 2018

Texto completo


En este tercer informe de la serie Incentives for Building University RDM Services, los autores exploran los incentivos que inspiraron la adquisición de la capacidad de Servicios de Gestión Datos de Investigación (RDM) por parte de las cuatro universidades de investigación descritas en los estudios de caso, y describen tanto los patrones generales como las circunstancias dependientes del contexto que dieron forma a estos incentivos.

Basándose en los estudios de caso, los autores organizaron estos incentivos en cuatro amplias categorías: cumplimiento, normas académicas en evolución, estrategia institucional y demanda de los investigadores.

  • La inversión de la universidad en infraestructura, servicios, o infraestructura de gestión de datos de investigación.
  • El personal está motivado por incentivos relevantes a nivel local. En otras palabras, el aumento de atención sobre RDM en las universidades de investigación que operan en diferentes circunstancias locales refleja una alineación de intereses institucionales y motivaciones externas.
  • La demanda de los investigadores y el cumplimiento de los mandatos de las políticas fueron factores importantes para diseñar y mantener un conjunto de servicios de RDM a lo largo del tiempo, pero no fueron los factores clave para establecer los servicios RDM en las instituciones de estudio de caso.
  • Si bien la constelación de incentivos relevantes difiere de un contexto a otro, la adquisición o el desarrollo de la capacidad está invariablemente motivada por un interés en proteger o mejorar la reputación y el éxito institucional.
  • Consecuentemente, la sostenibilidad a largo plazo de los servicios RDM universitarios depende de la alineación con las necesidades institucionales, tanto como las necesidades individuales de los investigadores.


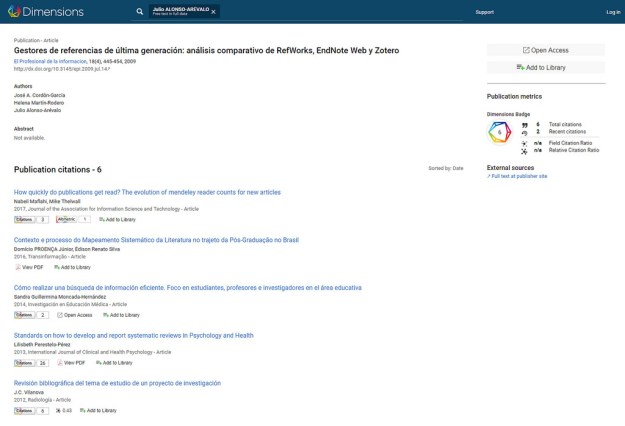
Dimensions: un portal de servicios de investigación y un nuevo índice de citas alternativo a Scopus y Web of Knowledge

25848383408_4bd07f3d99_b_d

Dimensions Homepage 2023

Interface de búsqueda

Dimensons, es una nueva plataforma de descubrimiento de investigación de Digital Science, un nuevo producto que incluye una base de datos de citas, un conjunto de análisis de investigación y una moderna funcionalidad de acceso y descubrimiento de artículos, La mayoría de sus servicios y productos son gratuitos y otros de pago. Un producto innovador en varios aspectos que pretende ser una alternativa a Elsevier y Clarivate. La versión gratuita de Dimensions está diseñada para proporcionar a los investigadores una forma más eficiente y eficaz de descubrir la investigación más relevante. Incluye la búsqueda de artículos a texto completo, y métricas básicas para todas esas publicaciones, además del acceso a cualquier artículo de acceso abierto que aparezca en los resultados de búsqueda. Durante 2018 se añadirá la búsqueda a través de conjuntos de datos.


El panorama de la investigación ha evolucionado rápidamente en los últimos 10 años con nuevas tecnologías, más datos y ecosistemas de investigación cada vez más diversos. Sin embargo, a pesar de estos cambios, los canales para el descubrimiento y las formas como se mide y evalúa el impacto han permanecido estáticas. La ciencia en el entorno digital propicia un sistema de investigación más robusto que favorezca la democratización de los datos, y que la capacidad de comunicación de los resultados de la investigación se maximicen contando con la amplia participación de la comunidad como una parte esencial para convertir esta gran idea en una realidad escalable.

En los últimos años, se ha producido un cambio en la gestión de la investigación y su difusión en plataformas que brinda nuevas e importantes oportunidades para analizar el rendimiento. cada vez existe un interés mayor en medir no sólo el rendimiento de los títulos de las revistas, sino también cada vez más el de los artículos individuales, de los propios investigadores, departamentos y universidades.

Dimensions es producto de la colaboración entre seis empresas del portafolio de Digital Science (Altmetric, Digital Science Consultancy, Figshare, Readcube, Symplectic y ÜberResearch) y más de 100 investigadores y universidades con una misión concreta: hacer la investigación más accesible.

Dimensions recoge más de 860 millones de citas académicas disponibles gratuitamente, y ofrece acceso a más de 9 millones de artículos de Acceso Abierto. El producto además de ser un índice de citas incluye información sobre becas, publicaciones, ensayos clínicos, datos altmétricos y patentes en un solo lugar. Además ofrece indexación del texto completo del artículo con el objetivo de favorecer su descubrimiento. El texto completo está disponible para 50 millones de artículos, procedentes, ya sea de una fuente pública como PubMedCentral o arXiv, o de un acuerdo establecido con el editor. Es este sentido, Dimensions es por lo tanto una herramienta de descubrimiento mucho más potente que las otras bases de datos de citas de la competencia que no indexan el texto completo del artículo.

El modelo institucional, llamado Dimensions Plus, proporciona un uso más intensivo de las herramientas analíticas de investigación, y tiene un precio anual escalonado según el tipo de institución, desde aproximadamente 10.000 a 30.000$. También hay una versión que incluye herramientas diseñadas para atraer a un editor o financiador de investigación. Para los primeros adoptantes institucionales, el precio base incluirá el uso de una potente API que permite construir o integrar servicios adicionales con la base de datos. La API de Dimensions  proporciona acceso a los datos subyacentes de forma fácil y flexible, utilizando un lenguaje específico de dominio diseñado para usuarios no técnicos. La API se puede utilizar no sólo para la recuperación de datos, sino también para agregar datos o devolver diferentes facetas en una sola llamada a la API, lo que permite integraciones directas e implementaciones de máquina a máquina. También las universidades pueden habilitar el acceso a texto completo a través de la plataforma a  los materiales que tienen contratados bajo licencia, previo pago de entre 3.000 a 7.000 dólares adicionales.

Para habilitar las funciones avanzadas Dimensons anima a los investigadores a registrarse en el servicio gratuito utilizando sus cuentas universitarias.


La alfabetización como capital inmaterial local: Historia de una biblioteca rural de entre 1860 – 1920

df5f579e16f3da1832578a51001750cf


Kotilainen, S. (2016). [e-Book] Literacy Skills as Local Intangible Capital : The History of a Rural Lending Library c. 1860 – 1920. Helsinki., Finnish Literature Society / SKS.

Texto completo


Este libro muestra que la ubicación de la biblioteca en su comunidad local y, por otra parte, el estatus y la posición de sus usuarios, tuvo una gran importancia en el uso de la biblioteca y, por lo tanto, en la mejora de las habilidades de lectura».

Este libro estudia la «zona gris» de la exitosa historia de las bibliotecas rurales en los países nórdicos a través de las actividades de las bibliotecas populares en una zona de Finlandia Central. El estudio explora la influencia de los fenómenos sociales, culturales, geográficos y económicos, tales como la difusión de movimientos revivalistas, en los hábitos de lectura de la población local y revela interesantes razones por las que el establecimiento de escuelas primarias y bibliotecas populares y el crecimiento de la alfabetización funcional no aumentaron automáticamente el capital informativo de la gente común de las regiones remotas ni condujeron a su avance social.

Este estudio representa un experimento metodológico para describir el ciclo vital de una biblioteca popular. La combinación de métodos biográficos colectivos y métodos comparativos transnacionales con fuentes originales raramente utilizadas en este estudio es innovadora y no se ha utilizado antes en la investigación histórica finlandesa sobre alfabetización funcional y bibliotecas populares. Para los habitantes del campo finlandés de finales del siglo XIX, las bibliotecas representaban una forma de adquirir nueva información que todavía era extraña y no bien recibida. La distribución del capital inmaterial era extremadamente desigual en cuanto a la edad, género y rango social. En las primeras investigaciones finlandesas no se ha analizado muy a menudo cómo el estatus comunitario del lector campesino y sus redes personales en la comunidad local afectaban la calidad de sus hábitos de lectura.