Archivo de la categoría: Investigación

Las revistas indexadas en el Journal Citation Reports tienen una tasa de autocitación del 25%

Taşkın, Zehra, et al. «Self-Citation Patterns of Journals Indexed in the Journal Citation Reports». Journal of Informetrics, vol. 15, n.o 4, noviembre de 2021, p. 101221. ScienceDirect, https://doi.org/10.1016/j.joi.2021.101221.

Se examinaron los patrones de autocitación de 1.104 revistas indexadas en la edición de 2018 del Journal Citation Reports para evaluar la posibilidad de manipulaciones de rango subyacentes. Se comprobó que todas las revistas incluidas en este estudio tenían una tasa de autocitación superior al 25%. Nuestra investigación muestra que al excluir las tasas de autocitación, el rango de las revistas con un alto factor de impacto no se ve afectado; sin embargo, para otras revistas, la eliminación de incluso una sola autocitación puede causar cambios significativos en el rango. Los patrones de autocitación son típicos de las revistas en idiomas locales, así como de las revistas de los países europeos de renta media-alta. Los factores de impacto utilizados en las evaluaciones del rendimiento de la investigación deberían utilizarse con más cuidado, especialmente cuando variables como el tamaño de la revista, el idioma de publicación, el país de la editorial y el área temática se correlacionan con los índices de autocitación.

Gestión de la información para la investigación en Estados Unidos

Rebecca Bryant, Jan Fransen, Pablo de Castro, Brenna Helmstutler, David Scherer. Research Information Management in the United States. Ohio: OLCLC, 2021

Part 1—Findings and Recommendations

Part 2—Case Studies

Un CRIS, también conocido como Research Information Management o RIMS (Sistemas de Gestión de la investigación) son sistemas de información que sirven para recoger y difundir toda la información relacionada con las actividades de investigación de una institución.

La serie de informes en dos partes sobre la gestión de la información para la investigación en los Estados Unidos ofrece una documentación inédita sobre las prácticas de gestión de la información para la investigación en las universidades estadounidenses, que presenta un examen exhaustivo de las prácticas, los objetivos, las partes interesadas y los componentes del sistema de gestión de la información para la investigación.

Research information management (RIM) es un área de inversión en rápido crecimiento en las universidades de investigación estadounidenses. Mientras que en Europa y otros lugares las prácticas de gestión de la información de la investigación han alcanzado la madurez en apoyo de los requisitos de información a nivel nacional, las prácticas de gestión de la información de la investigación en las universidades estadounidenses han seguido un curso diferente -y característicamente descentralizado-. El resultado es un entorno complejo caracterizado por múltiples casos de uso, partes interesadas y sistemas.

Este informe ofrece una visión general del estado de la gestión de la información de investigación en Estados Unidos, da sentido a la complejidad y ofrece recomendaciones dirigidas a los líderes de las universidades y otros responsables institucionales.

La información presentada en este informe pueda servir de apoyo a los responsables de las bibliotecas a la hora de hablar de los sistemas y las prácticas de Research information management (RIM) con las partes interesadas de las instituciones y para defender el papel de la biblioteca en esta labor.

Los artículos que tiene depositados los datos en un repositorio público tienen de media un 25% más de citas

Colavizza G, Hrynaszkiewicz I, Staden I, Whitaker K, McGillivray B (2020) The citation advantage of linking publications to research data. PLoS ONE 15(4): e0230416. https://doi.org/10.1371/journal.pone.0230416

Los esfuerzos por hacer que los resultados de la investigación sean abiertos y reproducibles se reflejan cada vez más en las políticas de las revistas que animan u obligan a los autores a proporcionar declaraciones de disponibilidad de datos. Como consecuencia de ello, se ha producido un fuerte aumento de las declaraciones de disponibilidad de datos en la literatura reciente. Sin embargo, todavía no está claro qué proporción de estas declaraciones contienen realmente enlaces bien formados a los datos, por ejemplo, a través de una URL o un identificador permanente, y si hay un valor añadido en el suministro de tales enlaces.

Para comprobar esta hipótesis se consideraron 531, 889 artículos de revistas publicadas por PLOS y BMC, y se desarrollo un sistema automático para etiquetar las declaraciones de disponibilidad de datos según cuatro categorías basadas en su contenido y el tipo de disponibilidad de datos que muestran, y finalmente se analizó la ventaja de citación de las diferentes categorías de declaraciones mediante regresión.

Se encontró que, siguiendo las políticas obligatorias de los editores, las declaraciones de disponibilidad de datos se vuelven muy comunes. En 2018, el 93,7% de 21.793 artículos de PLOS y el 88,2% de 31.956 artículos de BMC tenían declaraciones de disponibilidad de datos. Las declaraciones de disponibilidad de datos que contienen un enlace a los datos en un repositorio -en lugar de estar disponibles bajo petición o incluidas como archivos de información de apoyo- son una fracción del total. En 2017 y 2018, el 20,8% de las publicaciones de PLOS y el 12,2% de las publicaciones de BMC proporcionaron DAS que contenían un enlace a los datos en un repositorio. También se encontró una asociación entre los artículos que incluyen declaraciones que enlazan a los datos en un repositorio y hasta un 25,36% (± 1,07%) de impacto de citación más alto en promedio, utilizando un modelo de predicción de citas.

Se discuten las posibles implicaciones de estos resultados para los autores (investigadores) y los editores de revistas que hacen el esfuerzo de compartir sus datos en repositorios.

La importancia de depositar los datos de investigación para maximizar el impacto

What a difference a data repository makes: Six ways depositing data maximizes the impact of your science. Plos Blog, October 18, 2021 Lindsay Morton Open Access Open Data

Texto original

Los datos son la clave para la verificación, la replicación, la reutilización y la mejor comprensión de las conclusiones de la investigación. Cuando los datos están en un repositorio su impacto y su relevancia se magnifican. He aquí seis formas en las que poner los datos en un repositorio público puede ayudar a que la investigación tenga mayor visibilidad.

1 – Los datos que están en un repositorio público nunca se pierden

¿Alguna vez has perdido la pista de un conjunto de datos de tu investigación? Tal vez hayas actualizado tu ordenador o te hayas trasladado a una nueva institución. Tal vez hayas borrado un archivo por error, o simplemente no recuerdes el nombre del archivo que estás buscando. Sea cual sea la causa, la pérdida de datos puede resultar embarazosa y requerir mucho tiempo de búsqueda. No puedes proporcionar la información solicitada por las revistas durante el proceso de revisión o a los lectores después de la publicación. Es imposible realizar futuros metaanálisis o revisiones sistemáticas. Y es posible que tengas que rehacer los experimentos para poder avanzar en tu línea de investigación. Con los datos depositados de forma segura en un repositorio con un DOI único para su seguimiento, normas de archivo para evitar su pérdida, y materiales de metadatos, saber que tus datos se utilizan correctamente, cumplir con las solicitudes de las revistas o revisar trabajos anteriores es fácil.

2 – Los repositorios públicos de datos apoyan la comprensión, el reanálisis y la reutilización

La publicación transparente de los datos brutos en un repositorio público favorece una investigación científica fiable y reproducible. El conocimiento de los datos y el análisis permite a los lectores comprender mejor los artículos de investigación publicados. Ofrecer la oportunidad de que otros interpreten los resultados demuestra integridad y abre nuevas vías de debate y colaboración. Un formato de los datos legibles por máquina permite incorporar el trabajo a futuras revisiones sistemáticas o metaanálisis, ampliando su utilidad.

3 – Los repositorios públicos de datos facilitan el descubrimiento

Incluso los mejores datos no se pueden utilizar si no se pueden encontrar. Los metadatos detallados, la indexación de las bases de datos y los enlaces bidireccionales hacia y desde artículos relacionados ayudan a que los datos de los repositorios públicos sean fácilmente buscables, de modo que lleguen a los lectores que más los necesitan, maximizando el impacto y la influencia del estudio en su conjunto.

4 – Los repositorios públicos de datos reflejan el verdadero valor de los datos

Los datos no deben tratarse como un producto secundario de un artículo de investigación. Los datos son investigación. Y los investigadores merecen el crédito académico por recopilar, capturar y conservar los datos que generan con tu trabajo. Los repositorios públicos ayudan a ilustrar la verdadera importancia y la relevancia duradera de los conjuntos de datos asignándoles su propio y único DOI, distinto del de los artículos de investigación relacionados, para que los conjuntos de datos puedan acumular citas por derecho propio.

5 – Los datos públicos demuestran el rigor

No hay mejor manera de ilustrar el rigor de los resultados que explicar exactamente cómo los has obtenido. Compartir los datos le permite demostrar tu credibilidad e inspira confianza en los lectores al contextualizar los resultados y facilitar la reproducibilidad.

6 – La investigación con datos en repositorios de datos públicos atrae más citas

Un estudio realizado en 2020 sobre más de 500.000 artículos de investigación publicados descubrió que los artículos que enlazan con datos en un repositorio público tienen una tasa de citación un 25% más alta de media que los artículos en los que los datos están disponibles a petición o como información de apoyo. Las razones exactas de esta asociación siguen sin estar claras. ¿Son los investigadores que depositan datos cuidadosamente curados en un repositorio también más dados a producir una investigación rigurosa y digna de ser citada? ¿Los investigadores que tienen tiempo y recursos para dedicar a la conservación y el depósito de datos están más consolidados en sus carreras y, por tanto, son más citados? ¿Son los lectores más propensos a citar la investigación cuando confían en que pueden verificar las conclusiones con datos? ¿Quizás una combinación?
Costes de las infraestructuras abiertas.

Exploring costs & characteristics of open infrastructure providers. IOI Blog, 2021

Texto completo

Este trabajo combina la recogida de datos públicos y la recopilación de información con entrevistas con un número selecto de proyectos de infraestructura abierta para obtener más información sobre su financiación, costes y estructura.

Estas entrevistas pretenden aumentar nuestra auditoría y análisis de los datos disponibles públicamente de las bases de datos de financiación y subvenciones, los informes anuales, los archivos públicos (como los 990 en EE.UU.) y otros. Este enfoque también ayuda a modelar y perfeccionar el método de recopilación y verificación de información para los responsables de la toma de decisiones sobre la historia, el funcionamiento, los retos y la financiación de los programas. Los proyectos elegidos representan una pequeña instantánea de una lista de proyectos más amplia que se está elaborando y clasificando en paralelo para ayudar a situar estos esfuerzos en el ecosistema más amplio y comprender la relación con otras herramientas, tecnologías y servicios.

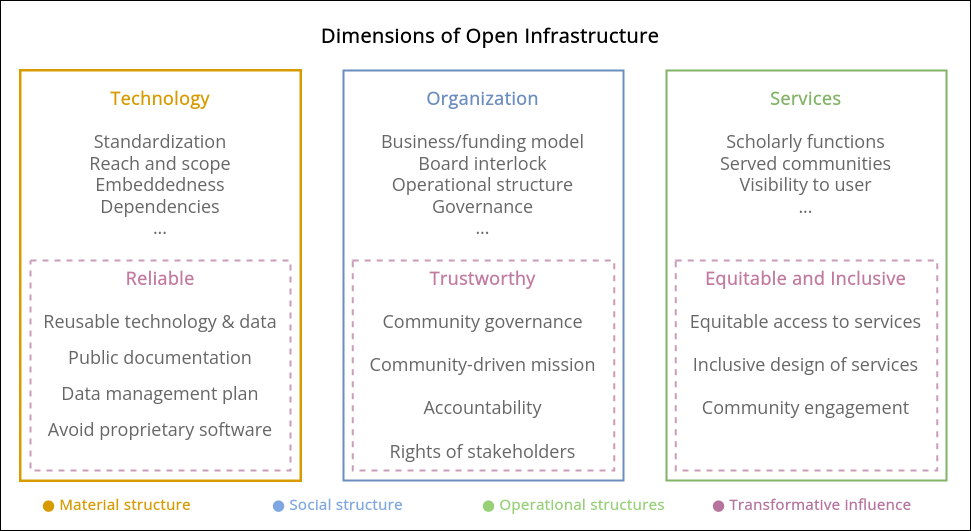
El objetivo era identificar una muestra de entre 5 y 10 proyectos para investigarlos más a fondo y obtener información adicional sobre los costes «ocultos» del funcionamiento de los proyectos y servicios de infraestructura abierta, los puntos de escasez de recursos y las dependencias de otros esfuerzos e iniciativas. El objetivo es conocer mejor los costes asociados al apoyo de estos proyectos, como los costes de alojamiento y mantenimiento, el apoyo de personal, los márgenes, las relaciones con los proveedores/la subcontratación, el apoyo en especie y el desglose de los recursos pasados y actuales. Al enmarcar el impacto y los beneficios de la infraestructura abierta con los costes reales, es posible comprender mejor la escala de los compromisos necesarios para mantener la infraestructura abierta.

They include:

Los proyectos mencionados fueron seleccionados en base a las siguientes dimensiones y criterios clave:

  • Proyectos de código abierto y sin ánimo de lucro;
  • Proyectos que sirven a las comunidades de investigación y comunicación académica;
  • Proyectos gobernados por las partes interesadas;
  • Accesibilidad de la documentación del apoyo financiero del proyecto, idealmente durante un período de 1 a 3 años;
  • Transparencia y diversidad de modelos de negocio (por ejemplo, apoyo basado en la afiliación frente a la subvención nacional);
  • Niveles de adopción y uso como indicador de influencia e impacto;
  • Diversidad de servicios representados;
  • Otras consideraciones ambientales son:
    – Influencia transformadora (por ejemplo, ¿se aleja de un modelo anticuado, cerrado y menos ideal?)
    – Grado (si lo hay) de inversión externa (por ejemplo, subvención gubernamental, apoyo de la industria, donación en especie de personal y servicios)
    – Asequibilidad y accesibilidad por parte del público desatendido

La última estafa de las editoriales depredadoras: Documentos falsificados y de prestigio

Kyle Siler , Vincent Larivière , Philippe Vincent-Lamarre & Cassidy R. Sugimoto. Predatory publishers’ latest scam: bootlegged and rebranded papers,. Nature, 26 October 2021

Texto completo

Una de las tácticas que han utilizado las revistas depredadoras es imitar a revistas legítimas de prestigio en línea (o a veces adquirir los títulos). Las editoriales depredadoras se basan en la reputación de la revista para cobrar derechos sin prestar servicios académicos. En agosto, la académica Anna Abalkina, de la Universidad Libre de Berlín, informó de que una lista de publicaciones de COVID-19 mantenida por la Organización Mundial de la Salud contenía cientos de artículos de tres revistas de este tipo, muchos de ellos totalmente fuera de su ámbito de conocimiento. (Una revista supuestamente sobre lingüística tenía artículos sobre COVID-19, nutrición y anemia gestacional).

La indexación de la base de datos Lacuna descubrió otra práctica alarmante: la re-publicación de copias falsificadas de artículos de fuentes legítimas, bajo nuevos DOI, sin acreditar a la revista original, y a veces tampoco al autor original. Un investigador que examine lo que parecen ser «números atrasados» ve verdaderos artículos revisados por pares copiados de revistas legítimas.

Varias anomalías llevaron a descubrir que al menos nueve artículos de la revista Journal of Bone Research and Reports, bajo la marca iMEDPub LTD, fueron tomados directamente de la revista Bone Reports de Elsevier. (un representante de Elsevier dice que el asunto está ahora bajo investigación). La primera pista fueron los extraños nombres de algunos autores, como «centro urbano» y «parlamentario». Muchos nombres de autores aparecían con un carácter extra (por ejemplo, «John Smitha» y «Mary Jonesb»), lo que indica que fueron copiados de un documento sobrescrito.

Algunas instituciones editoras carecían de sentido, como «universidad de la provincia de Canadá» y «universidad del centro urbano». Las afiliaciones de los autores se enumeraban de forma absurda: Nueva Orleans fue rebautizada como «punto de entrada» y Carolina del Norte fue apodada «antiguo Estado del Norte». Las direcciones de correo electrónico de algunos autores eran las de personas que no eran autores. Cuando los descubridores del engaño se pusieron en contacto con los autores de los artículos de Bone Reports, ninguno era consciente de que sus artículos habían sido pirateados; respondieron con una mezcla de enfado, diversión y desconcierto.

Mejores prácticas en los metadatos de las revistas

Better Practices in Journal Metadata. Coalition Publica, 2021

Better Practices in Journal Metadata

Metadata Feedback for Coalition Publica

Los metadatos son un aspecto esencial de la publicación académica. Garantizan la identificación precisa del contenido de una revista y pueden mejorar la capacidad de descubrimiento, el acceso, la difusión, la preservación y, posiblemente, el impacto de la investigación.

Dado el importante papel de los metadatos en la publicación académica digital, Coalition Publica se complace en anunciar la publicación de dos importantes informes elaborados por su Grupo de Trabajo sobre Metadatos.

  • La guía Better Practices in Journal Metadata debería ser un recurso inestimable para los editores de revistas que utilizan OJS, así como para los proveedores de alojamiento que los apoyan. Esta guía se añadirá al PKP Docs Hub, donde se mantendrá en cooperación con la comunidad de usuarios de PKP.
  • El informe técnico Metadata Feedback for Coalition Publica proporciona una valiosa visión sobre las nuevas tendencias en los metadatos de las publicaciones académicas que Coalition Publica puede necesitar integrar en los próximos años.

El Grupo de Trabajo de Metadatos fue convocado a principios de 2019 con un mandato de dos años para:

  • Proporcionar orientación y asesoramiento sobre las mejores prácticas para la calidad de los metadatos en las revistas académicas alojadas en la biblioteca para garantizar una mayor capacidad de descubrimiento, especialmente para el servicio de difusión de Coalition Publica;
  • Desarrollar procedimientos y documentación para guiar a los bibliotecarios y editores en la asistencia a las revistas en la creación de metadatos de alta calidad;
  • Proporcionar recomendaciones al Comité de Operaciones de Coalition Publica para mejorar y fomentar mejores metadatos en las plataformas de PKP y Érudit.

Escribir y editar

Patrick Barry. Good with Words: Writing and Editing. Maize Books, 2021

PDF

ePub

Si tu éxito en el trabajo o en los estudios depende de tu capacidad para comunicarte de forma persuasiva por escrito, querrás obtener Good with Words. Basado en un curso que los estudiantes de derecho de la Universidad de Michigan y de la Universidad de Chicago han calificado de «extraordinario», «A-M-A-Z-I-N-G» y «el mejor curso que he hecho nunca», el libro reúne una colección de conceptos, ejercicios y ejemplos que también han ayudado a mejorar las habilidades de defensa de las personas que hacen carrera en muchos otros campos, desde el marketing hasta la gestión o la medicina.

Libro blanco: temas, objetivos y participantes de las actividades de ciencia ciudadana


Samu Paajanen, Emilia Lampi, Joni Lämsä, & Raija Hämäläinen. (2021). White paper: Themes, objectives and participants of citizen science activities. Zenodo. https://doi.org/10.5281/zenodo.5026192

Texto completo

Con este resumen, CS Track resume brevemente las principales características de los temas, objetivos y participantes de las actividades de ciencia ciudadana. Esta introducción a estos temas servirá de base para la elaboración de recomendaciones políticas y manuales de buenas prácticas para el campo de la ciencia ciudadana, que se encuentra en plena expansión.

Hacia la participación de los investigadores en los sistemas de información para la investigación

Lee, Dong Joon, et al. Towards Researcher Participation in Research Information Systems. mayo de 2016. oaktrust.library.tamu.edu,

Texto completo

Este póster presenta un estudio de colaboración en curso apoyado por la beca de investigación LIS de OCLC/ALISE. Incluye principalmente la descripción y el diseño de la investigación de este estudio.

El proyecto explora la participación de los investigadores en los sistemas de gestión de identidades de investigación (por ejemplo, Google Scholar, ResearchGate, ORCID). Sobre la base de conocimientos de cómo diseñar soluciones fiables, eficientes y escalables para los sistemas, motivar a los investigadores a participar en los sistemas, y contribuir al desarrollo del sistema en entornos de bibliotecas digitales. La identificación y determinación precisa de la identidad de investigación son esenciales para la agrupación, vinculación, agregación y recuperación eficaces de la erudición digital; la evaluación de la productividad de la investigación y el impacto de los individuos, grupos e instituciones; y la identificación de la experiencia y las habilidades.

Existen muchos sistemas de gestión de la identidad de los investigadores procedentes de editoriales, bibliotecas, universidades, motores de búsqueda y agregadores de contenidos, con diferentes modelos de datos, cobertura y calidad. Aunque la curación del conocimiento por parte de profesionales suele producir resultados de la máxima calidad, puede no ser escalable debido a su elevado coste. La literatura sobre comunidades en línea muestra que las comunidades de curación por pares que tienen éxito y son capaces de atraer y retener a suficientes participantes pueden proporcionar soluciones de curación de conocimientos escalables de una calidad comparable a la de los contenidos curados por profesionales.

Por lo tanto, el éxito de los sistemas de gestión de identidades de investigación en línea puede depender del número de colaboradores y usuarios que sean capaces de reclutar, motivar y comprometerse con la curación de datos de identidades de investigación.

Los resultados de esta investigación exploratoria incluirán, entre otros, una teoría cualitativa de las prácticas de información y datos de identidad de los investigadores, un modelo o modelos cuantitativos de las prioridades de los investigadores para los diferentes datos y servicios de identidad de investigación en línea, los factores que pueden afectar a su participación y compromiso con los sistemas de gestión de identidad de investigación en línea, y sus motivaciones para participar en la curación de datos de identidad de investigación. Los resultados del estudio pueden mejorar en gran medida nuestros conocimientos sobre el diseño de los modelos de datos/metadatos de identidad de investigación, los servicios, las actividades de garantía de calidad y los mecanismos de contratación y retención de investigadores para el suministro y mantenimiento de datos de identidad.