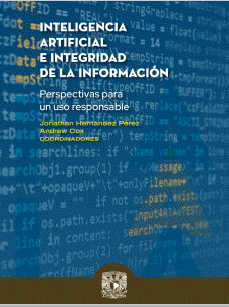
Hernández Pérez, J. (coord.), & Cox, A. (2025). Inteligencia artificial e integridad de la información. Perspectivas para un uso responsable. Serie Información y Sociedad. Ciudad de México: Universidad Nacional Autónoma de México. 204 p. ISBN: 978-607-642-424-7.
Inteligencia artificial e integridad de la información. Perspectivas para un uso responsable ofrece una reflexión multidisciplinar sobre uno de los mayores desafíos de la sociedad contemporánea: preservar la integridad de la información en un contexto profundamente transformado por la inteligencia artificial. Coordinada por Jonathan Hernández Pérez, con la participación de Andrew Cox y otros especialistas, la obra surge de las discusiones desarrolladas en el Seminario Inteligencia Artificial e Integridad de la Información, celebrado en el marco del Mexican Information Global Forum. El libro reúne diez capítulos que analizan desde distintas perspectivas las implicaciones sociales, éticas, tecnológicas y educativas derivadas del creciente protagonismo de la IA en la producción, distribución y consumo de información.
Toppo, G. (2026).The End of Homework? Teachers Grapple With Cheating in the Age of AI. The 74, 14 de julio de 2026.
La rápida adopción de herramientas de inteligencia artificial generativa como ChatGPT, Gemini o Claude está transformando profundamente la forma en que los estudiantes realizan sus tareas escolares y obligando a los docentes a replantearse el papel tradicional de los deberes. El artículo de The 74 sostiene que el problema ya no consiste únicamente en detectar cuándo un alumno utiliza IA para completar una actividad, sino en diseñar experiencias de aprendizaje que mantengan su valor educativo en un contexto donde cualquier ejercicio rutinario puede resolverse en segundos mediante un chatbot.
Uno de los ejemplos destacados es el del profesor de matemáticas Al Rabanera, del instituto La Vista High School (California), quien parte de una premisa sencilla: asumir que sus estudiantes tienen acceso a la IA y que probablemente la utilizarán. En lugar de intentar impedirlo mediante vigilancia constante, ha transformado completamente sus métodos de enseñanza. Ha abandonado los tradicionales ejercicios repetitivos para sustituirlos por proyectos personalizados, desafíos realizados en clase y actividades relacionadas con situaciones reales, como la compra de un automóvil, el cálculo de préstamos, las puntuaciones de crédito o la planificación financiera. El objetivo es que los alumnos demuestren comprensión y capacidad de razonamiento, no simplemente la entrega de respuestas correctas.
El reportaje muestra que este cambio de enfoque se está extendiendo entre numerosos docentes. Muchos consideran que los deberes tradicionales han perdido gran parte de su utilidad porque las aplicaciones de IA pueden resolver fácilmente problemas estandarizados, redactar ensayos o responder cuestionarios. En consecuencia, los profesores están diseñando tareas más creativas, personalizadas y difíciles de automatizar, como la elaboración de proyectos originales, presentaciones, debates, actividades colaborativas o la creación de problemas propios a partir de intereses personales del alumnado. Estas propuestas obligan a los estudiantes a aplicar conocimientos, justificar decisiones y demostrar que comprenden realmente los conceptos trabajados.
El artículo también pone de manifiesto un cambio de filosofía educativa. En lugar de centrar todos los esfuerzos en perseguir el fraude mediante detectores de IA —herramientas cuya fiabilidad sigue siendo muy cuestionada— muchos educadores prefieren modificar los sistemas de evaluación para que el uso indiscriminado de la inteligencia artificial resulte poco útil. La evaluación continua, las actividades desarrolladas en el aula, las exposiciones orales y los proyectos contextualizados adquieren mayor protagonismo porque permiten valorar el proceso de aprendizaje y no únicamente el producto final entregado por el estudiante.
Más allá del problema del plagio, el artículo plantea una reflexión sobre el futuro de los deberes escolares. Si la IA puede realizar automáticamente una parte importante de las tareas tradicionales, quizá el verdadero reto no sea prohibir estas herramientas, sino redefinir qué significa aprender en la era de la inteligencia artificial. Para muchos docentes, la solución pasa por convertir la IA en un recurso de apoyo para el aprendizaje mientras se diseñan actividades que fomenten el pensamiento crítico, la creatividad, la resolución de problemas y la capacidad de explicar y defender las propias ideas, competencias que siguen dependiendo fundamentalmente del estudiante.
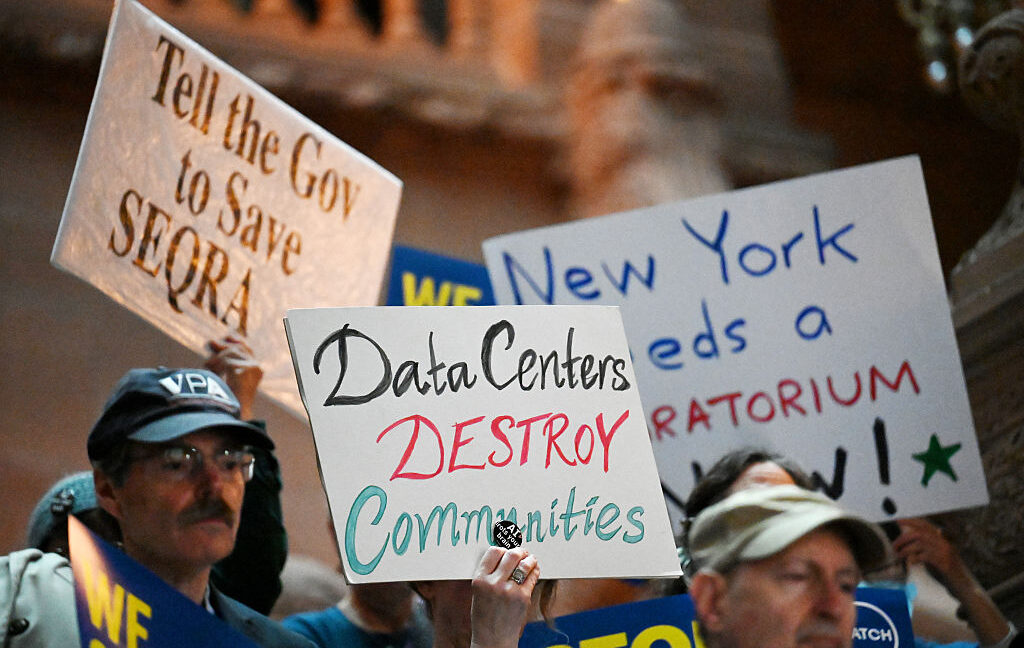
Nueva York se ha convertido en el primer estado de Estados Unidos en decretar una moratoria temporal sobre la construcción de nuevos centros de datos de gran escala, una decisión que marca un punto de inflexión en el debate sobre el crecimiento de la infraestructura necesaria para la inteligencia artificial.
La gobernadora Kathy Hochul anunció una suspensión de un año para los nuevos proyectos de centros de datos que requieran 50 megavatios o más de potencia eléctrica, con el objetivo de desarrollar un marco regulatorio que tenga en cuenta sus impactos energéticos, ambientales y sociales.
La medida responde al extraordinario crecimiento de la demanda de capacidad de computación impulsada por la IA generativa. Los denominados hiperscale data centers consumen enormes cantidades de electricidad y agua para alimentar y refrigerar miles de servidores especializados. Según el gobierno estatal, el rápido aumento de estas instalaciones amenaza con incrementar el coste de la electricidad para los ciudadanos, ejercer una presión considerable sobre la red eléctrica y comprometer los objetivos climáticos de Nueva York. Además, existe preocupación por la ocupación de suelo, el consumo de recursos hídricos y el impacto sobre las comunidades locales.
Durante el periodo de moratoria, las agencias estatales elaborarán nuevas normas para regular la implantación de estos complejos tecnológicos. Entre las iniciativas previstas figura la creación de un marco que permita a las comunidades negociar beneficios locales derivados de estos proyectos y la revisión de los incentivos fiscales existentes, incluyendo la posible eliminación de determinadas exenciones tributarias para los grandes centros de datos. El objetivo declarado es garantizar que el desarrollo de la infraestructura de IA genere beneficios económicos sin trasladar los costes ambientales y energéticos a la población.
La decisión ha generado una fuerte reacción en la industria tecnológica. Empresas y asociaciones del sector sostienen que la moratoria puede frenar inversiones multimillonarias y provocar que los nuevos proyectos se trasladen a estados como Texas, Virginia, Arizona o Florida, donde las políticas son más favorables al desarrollo de infraestructuras digitales. Desde esta perspectiva, la medida podría afectar a la competitividad de Nueva York en la carrera por atraer inversiones relacionadas con la inteligencia artificial y la computación en la nube.
No obstante, la moratoria refleja una tendencia creciente en Estados Unidos. A medida que aumenta la demanda de centros de datos para alimentar los modelos de IA, también crecen las protestas ciudadanas y las iniciativas legislativas orientadas a limitar su expansión debido a su elevado consumo energético, su impacto ambiental y su influencia sobre las infraestructuras locales. La decisión de Nueva York podría convertirse en un precedente para otros estados que buscan equilibrar el desarrollo tecnológico con la sostenibilidad y la protección de las comunidades.
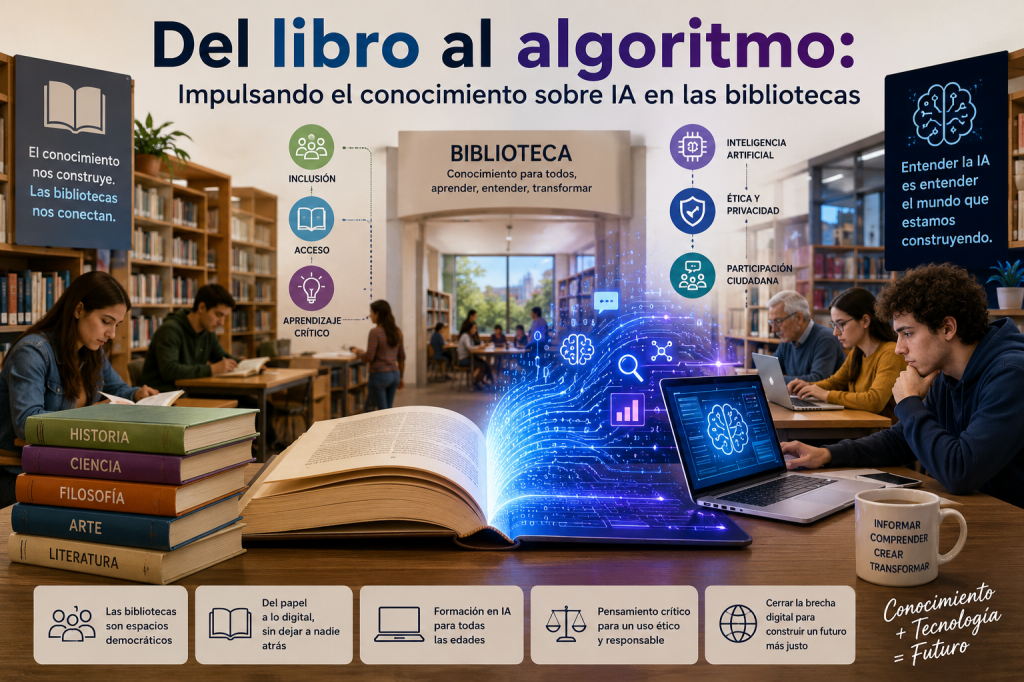
Alonso Arévalo, J., & López Melguizo, I. (2025, 5–7 de noviembre). Del libro al algoritmo: Impulsando el conocimiento sobre IA en las bibliotecas [Comunicación en congreso]. XII Congreso Nacional de Bibliotecas Públicas, Palacio de Congresos de Granada, Granada, España.
Se plantea una profunda reflexión sobre el nuevo papel que deben desempeñar las bibliotecas en una sociedad donde la inteligencia artificial (IA) se ha convertido en una tecnología omnipresente. Los autores sostienen que la IA ya no constituye una innovación reservada a especialistas, sino un elemento que condiciona la vida cotidiana de millones de personas, desde los sistemas de recomendación que utilizan las plataformas digitales hasta los algoritmos que participan en procesos médicos, educativos, financieros o administrativos. Sin embargo, cuanto mayor es la presencia de la IA en nuestras vidas, menor suele ser el conocimiento que posee la ciudadanía sobre su funcionamiento, sus limitaciones y las implicaciones sociales, éticas y políticas que conlleva.
El trabajo parte de la idea de que la revolución provocada por la inteligencia artificial no es únicamente tecnológica, sino también cultural y social. Los algoritmos influyen cada vez más en la manera en que las personas acceden a la información, toman decisiones, consumen contenidos o interactúan con las instituciones. No obstante, la mayoría de estos procesos permanecen ocultos para los ciudadanos, funcionando como auténticas «cajas negras» cuyos mecanismos internos resultan prácticamente desconocidos. Esta falta de comprensión genera una nueva modalidad de analfabetismo, que los autores denominan analfabetismo digital crítico: la incapacidad para comprender cómo funcionan los sistemas algorítmicos que condicionan nuestra vida diaria.
Los autores advierten que esta situación tiene importantes consecuencias sociales. Las personas que desconocen el funcionamiento de la IA son mucho más vulnerables a la manipulación informativa, a la desinformación, a la pérdida de privacidad y a la exclusión de los debates sobre el desarrollo tecnológico. Además, la IA incorpora inevitablemente decisiones humanas, ya que los algoritmos son diseñados, entrenados y ajustados mediante datos que reflejan intereses, prioridades y, en muchos casos, prejuicios existentes en la sociedad. Por ello, la alfabetización en inteligencia artificial no debe limitarse a aprender a utilizar herramientas, sino que debe proporcionar capacidad crítica para comprender cómo se producen esas decisiones automatizadas, quién se beneficia de ellas y qué consecuencias generan para distintos colectivos sociales.
En este contexto, el artículo sitúa a las bibliotecas como las instituciones mejor preparadas para asumir una nueva misión educativa. Históricamente las bibliotecas han garantizado el acceso democrático al conocimiento, primero mediante los libros impresos, posteriormente facilitando el acceso a Internet y a los recursos digitales, y ahora deben contribuir a democratizar el conocimiento sobre la inteligencia artificial. Los autores consideran que las bibliotecas representan uno de los pocos espacios públicos donde cualquier ciudadano, independientemente de su edad, nivel educativo o situación económica, puede acceder gratuitamente tanto a recursos tecnológicos como a programas de formación. De esta manera, la biblioteca deja de ser únicamente un lugar de conservación documental para convertirse en un centro de aprendizaje permanente y participación ciudadana en la era digital.
El proyecto «Del libro al algoritmo» propone precisamente ampliar la misión tradicional de las bibliotecas sin abandonar sus valores históricos. Los libros continúan siendo fundamentales, pero ahora deben convivir con laboratorios digitales, espacios de creación, talleres tecnológicos y actividades relacionadas con la inteligencia artificial. La biblioteca pasa así de ser un lugar donde se consume conocimiento a un espacio donde también se crea, experimenta y reflexiona colectivamente sobre las nuevas tecnologías. Esta evolución resulta coherente con la transformación que ya han experimentado muchas bibliotecas mediante makerspaces, laboratorios de innovación y espacios colaborativos.
Uno de los aspectos centrales del artículo consiste en definir qué significa realmente la alfabetización en inteligencia artificial. Los autores adoptan el enfoque desarrollado por Stanford Teaching Commons, según el cual la alfabetización en IA comprende cuatro grandes dimensiones. La primera consiste en comprender cómo funcionan los sistemas de inteligencia artificial, incluyendo conceptos básicos como los datos de entrenamiento, los modelos de aprendizaje automático, las capacidades reales de estas herramientas y también sus limitaciones. La segunda dimensión se refiere a la ética de la IA, incorporando cuestiones relacionadas con los sesgos, la privacidad, la transparencia, la integridad académica y la fiabilidad de la información generada por los modelos. La tercera dimensión aborda la comunicación con la IA, enseñando a formular instrucciones eficaces mediante técnicas de prompting y comprendiendo cómo el lenguaje condiciona las respuestas obtenidas. Finalmente, la cuarta dimensión estudia el uso de la IA para mejorar los procesos de enseñanza y aprendizaje mediante metodologías pedagógicas innovadoras e inclusivas.
El artículo concede especial importancia al diseño pedagógico de los programas formativos. Los talleres no deben dirigirse únicamente a usuarios expertos, sino adaptarse a personas con distintos niveles de competencia digital. Para ello se propone una metodología gradual que comience utilizando ejemplos cotidianos fácilmente comprensibles, como recetas de cocina o procesos de organización de una biblioteca, para explicar qué es un algoritmo y cómo funciona. Posteriormente, el aprendizaje evoluciona hacia aplicaciones más complejas relacionadas con la salud, la educación, la administración pública o la justicia. Todo el proceso debe apoyarse en metodologías activas, colaborativas e inclusivas, donde los participantes aprendan experimentando directamente con herramientas de inteligencia artificial y compartiendo experiencias con otros usuarios.
Los autores consideran imprescindible que la formación sobre IA vaya mucho más allá del aprendizaje técnico. El objetivo principal consiste en desarrollar pensamiento crítico. Los participantes deben aprender no sólo cómo funcionan los algoritmos, sino también por qué funcionan de esa manera, quién los diseña, qué intereses reflejan y qué alternativas podrían existir. Para ello, los programas incluyen ejercicios destinados a analizar resultados generados por la IA, identificar errores, detectar sesgos y debatir las implicaciones éticas derivadas de su utilización. Esta dimensión crítica constituye uno de los pilares fundamentales del proyecto, ya que permite transformar a los usuarios en ciudadanos capaces de cuestionar la tecnología en lugar de aceptarla de forma pasiva.
Otro bloque del artículo describe con gran detalle los componentes que debería incluir un programa completo de alfabetización en IA desarrollado desde las bibliotecas. Los primeros módulos enseñan que los algoritmos están presentes en prácticamente todas las actividades cotidianas: buscadores de Internet, plataformas audiovisuales, filtros de correo electrónico, sistemas de navegación, asistentes virtuales o redes sociales. Posteriormente se introduce el aprendizaje automático explicando cómo las máquinas identifican patrones a partir de grandes cantidades de datos y cómo este proceso se diferencia del aprendizaje humano. El objetivo consiste en desmitificar la inteligencia artificial y mostrar que, aunque sus capacidades son extraordinarias, continúa dependiendo de datos, modelos matemáticos y decisiones humanas.
Uno de los apartados más desarrollados del trabajo analiza los sesgos algorítmicos. Los autores consideran que comprender este fenómeno constituye probablemente el aspecto más importante de toda la alfabetización en inteligencia artificial. Explican diferentes tipos de sesgos, entre ellos los derivados de los datos de entrenamiento, de la representación de determinados colectivos, de la confirmación de ideas previas o de los métodos utilizados para evaluar los sistemas. Para ilustrar estos problemas presentan casos reales de discriminación algorítmica en procesos de selección de personal, concesión de créditos bancarios y sistemas de justicia penal, demostrando cómo decisiones aparentemente técnicas pueden generar importantes desigualdades sociales. El programa propone que los participantes analicen estos casos mediante actividades prácticas para comprender de primera mano cómo se producen estos fenómenos.
El proyecto también dedica una atención significativa a la privacidad y al tratamiento de los datos personales. Los autores explican que la economía digital actual se basa en la recopilación masiva de información sobre los usuarios, convirtiendo los datos personales en uno de los principales activos económicos de las grandes empresas tecnológicas. Por ello, la alfabetización en IA debe incluir conocimientos sobre consentimiento informado, protección de la privacidad, configuración de redes sociales, navegación segura, cifrado de comunicaciones y comprensión de los modelos económicos basados en la vigilancia y la predicción del comportamiento humano. Los participantes aprenden que cuando utilizan servicios aparentemente gratuitos, en muchas ocasiones están intercambiando sus propios datos personales como forma de pago.
El artículo incorpora igualmente una dimensión jurídica y regulatoria mediante el análisis de la Ley Europea de Inteligencia Artificial (AI Act). Los autores explican que esta normativa establece un enfoque basado en el riesgo, imponiendo obligaciones de transparencia, evaluación de riesgos, supervisión y sanciones para los sistemas de IA de mayor impacto. La formación propuesta pretende que los ciudadanos comprendan estas normas y sean capaces de exigir responsabilidades cuando los sistemas automatizados afecten a sus derechos fundamentales. Para ello se plantean simulaciones donde los participantes representan distintos actores —desarrolladores, reguladores, usuarios o ciudadanos afectados— con el fin de comprender la complejidad de la gobernanza tecnológica.
Además de enseñar conocimientos técnicos, el programa desarrolla herramientas para evaluar críticamente cualquier sistema de inteligencia artificial. Los participantes aprenden a formular preguntas esenciales antes de confiar en una aplicación: qué problema pretende resolver, quién ha definido ese problema, qué datos utiliza, cómo fueron obtenidos, quién obtiene beneficios, qué riesgos existen para determinados colectivos y qué alternativas podrían plantearse. Esta metodología convierte la evaluación crítica en una competencia permanente que puede aplicarse a cualquier nueva tecnología que aparezca en el futuro.
Otro de los objetivos fundamentales consiste en reducir las desigualdades digitales. Los autores consideran que el conocimiento sobre IA no debe quedar restringido a universidades, grandes empresas tecnológicas o profesionales especializados. La alfabetización en inteligencia artificial debe llegar también a personas mayores, habitantes del medio rural, colectivos vulnerables y ciudadanos con escasa formación tecnológica. Las bibliotecas, por su carácter abierto e inclusivo, representan el entorno ideal para democratizar estos conocimientos y evitar que la revolución de la IA amplíe aún más las brechas sociales existentes.
El artículo dedica también un apartado específico al nuevo perfil profesional del bibliotecario. Según los autores, el bibliotecario del futuro ya no será únicamente un gestor de colecciones documentales, sino también un facilitador del aprendizaje digital, un curador de recursos tecnológicos y un mediador entre la complejidad técnica de la IA y las necesidades concretas de la ciudadanía. Para desempeñar esta función deberá adquirir conocimientos básicos sobre inteligencia artificial, metodologías docentes, experiencia de usuario, alfabetización digital y análisis de necesidades comunitarias. Asimismo, deberá organizar actividades participativas, foros de debate y programas de formación adaptados a los distintos perfiles de usuarios.
El artículo concluye afirmando que «Del libro al algoritmo» representa mucho más que un simple programa de formación tecnológica. Constituye una propuesta estratégica para redefinir el papel de las bibliotecas en la sociedad contemporánea. Al integrar la alfabetización en inteligencia artificial dentro de sus servicios, las bibliotecas fortalecen su misión histórica como instituciones democráticas dedicadas al acceso universal al conocimiento. La combinación entre el patrimonio bibliográfico tradicional y la comprensión crítica de los algoritmos permitirá que estas instituciones continúen siendo actores esenciales para la construcción de una ciudadanía informada, participativa y capaz de intervenir activamente en los debates sobre el futuro digital. Los autores sostienen que comprender la inteligencia artificial debe convertirse en un derecho ciudadano básico, y que las bibliotecas están llamadas a desempeñar un papel protagonista para hacerlo realidad.
La Guía para la Autoevaluación constituye el documento de referencia para la implantación del Modelo Europeo de Gestión de Calidad (EFQM) en centros educativos. Su propósito es ofrecer una metodología sistemática que permita a las instituciones analizar de manera objetiva su funcionamiento, identificar fortalezas y detectar áreas de mejora, impulsando un proceso continuo de innovación y excelencia organizativa. La guía parte de la premisa de que la calidad educativa no depende únicamente de los resultados académicos, sino también de la eficacia del liderazgo, la planificación, la gestión de las personas, los recursos y los procesos que sustentan la actividad del centro.
El crecimiento del uso de herramientas de inteligencia artificial como ChatGPT, Gemini o Claude ha generado una nueva preocupación en ámbitos como la educación, el periodismo, la contratación de personal y la creación de contenidos: ¿es posible distinguir con fiabilidad un texto escrito por una persona de otro generado por una IA? Para responder a esta pregunta, Popular Science realizó una prueba práctica con cinco de los detectores de IA más populares del mercado: Pangram, Grammarly, GPTZero, Scribbr y Copyleaks.
Los detectores de texto generado por inteligencia artificial se han convertido en una herramienta habitual en escuelas, universidades y empresas preocupadas por el uso de modelos como ChatGPT, Gemini o Claude. Sin embargo, una prueba realizada por Popular Science demuestra que estas aplicaciones están lejos de ser infalibles. El artículo evaluó cinco detectores ampliamente utilizados enfrentándolos tanto a textos escritos íntegramente por una persona como a otros producidos por diferentes modelos de IA.
El objetivo era comprobar si realmente pueden distinguir con precisión entre escritura humana y escritura artificial. Los resultados revelan que todos los sistemas analizados cometieron errores, aunque en distinta medida, lo que pone de manifiesto las limitaciones actuales de esta tecnología.
La principal conclusión es que ningún detector ofrece una fiabilidad del 100 %. Algunas herramientas identificaron correctamente buena parte de los textos generados por IA, pero también clasificaron como artificiales escritos completamente humanos (falsos positivos) y, a la inversa, consideraron como humanos algunos textos creados por modelos de lenguaje (falsos negativos). Esta variabilidad se debe a que los detectores no reconocen el origen real de un documento, sino que calculan la probabilidad de que un texto presente determinados patrones estadísticos característicos de la escritura generada por IA, como la baja «perplejidad» o una estructura lingüística especialmente uniforme.
Pangram: el detector más preciso
La primera herramienta evaluada fue Pangram, que se presenta como «un detector de IA que realmente funciona». En la prueba obtuvo un resultado perfecto. Reconoció correctamente ambos textos escritos por el autor como completamente humanos, asignándoles un 100 % de probabilidad de autoría humana y un alto grado de confianza. Del mismo modo, identificó correctamente los textos generados por ChatGPT y Claude como escritos íntegramente por IA. Además de emitir un porcentaje, explicó qué expresiones o estructuras habían influido en su decisión, señalando algunas frases típicas del estilo de los modelos de lenguaje.
Grammarly: muy fiable, aunque menos contundente
La segunda herramienta fue Grammarly, conocida tradicionalmente por sus funciones de corrección ortográfica y gramatical, pero que también incorpora un detector de IA. Los dos textos humanos fueron clasificados correctamente como escritos por una persona, sin detectar ningún patrón asociado a inteligencia artificial. Sin embargo, cuando analizó los textos generados por Claude y Gemini, sí detectó que probablemente habían sido creados mediante IA, aunque con un grado de confianza inferior al de Pangram: uno recibió una probabilidad del 68 % y el otro del 66 % de haber sido generado artificialmente. Es decir, Grammarly acertó en todos los casos, aunque mostró mayor cautela en sus conclusiones.
GPTZero: otra de las herramientas más fiables
El tercer detector fue GPTZero, una de las aplicaciones más conocidas en el ámbito educativo y universitario. Los dos textos escritos por el autor fueron clasificados como completamente humanos, indicando incluso que existía una elevada confianza en esa conclusión. Cuando analizó los textos producidos por Gemini y ChatGPT también los identificó correctamente como generados por inteligencia artificial. Una característica interesante de GPTZero es que no solo ofrece una valoración global, sino que señala las frases concretas que considera más características de un texto generado por IA. Sin embargo, el propio autor reconoce que, al revisar esas frases, no siempre resulta evidente qué rasgos específicos justifican dicha clasificación.
Scribbr: el gran decepcionante
La cuarta herramienta fue Scribbr, conocida principalmente por sus servicios de revisión académica. En este caso, el detector identificó correctamente los textos humanos como escritos por personas. Sin embargo, falló completamente al analizar los textos generados por IA, clasificándolos también como totalmente humanos. Lo más llamativo es que el sistema mostró una elevada confianza en sus conclusiones erróneas, lo que pone de manifiesto una calibración insuficiente para detectar contenidos generados por modelos actuales.
Copyleaks: resultados irregulares
El último detector analizado fue Copyleaks, una plataforma que también ofrece herramientas para detectar imágenes y vídeos generados mediante IA. Como ocurrió con los demás detectores, identificó correctamente los textos humanos. Sin embargo, al evaluar los textos generados por IA obtuvo resultados contradictorios: uno de ellos fue clasificado erróneamente como completamente humano, mientras que el otro fue detectado correctamente como generado por inteligencia artificial. Esta inconsistencia llevó al autor a concluir que la calibración del sistema todavía necesita mejoras.
Detector
Textos humanos
Textos IA
Resultado
Pangram
✔✔
✔✔
4/4
Grammarly
✔✔
✔✔
4/4
GPTZero
✔✔
✔✔
4/4
Scribbr
✔✔
✘✘
2/4
Copyleaks
✔✔
✔✘
3/4
El reportaje explica que basta con realizar pequeñas modificaciones en un texto generado por IA para dificultar considerablemente su detección. Una revisión manual, la incorporación de experiencias personales o incluso el uso de herramientas de reformulación pueden alterar los patrones lingüísticos que utilizan los detectores para emitir sus predicciones. Del mismo modo, textos escritos por personas con un estilo muy formal, repetitivo o académico pueden ser erróneamente etiquetados como contenidos generados por inteligencia artificial. Esta limitación resulta especialmente preocupante en el ámbito educativo, donde ya se han documentado casos de estudiantes acusados injustamente debido a la confianza excesiva depositada en estas herramientas.
Otra conclusión importante del análisis es que los detectores deben considerarse únicamente un indicio y nunca una prueba definitiva. El artículo coincide con numerosos investigadores y organismos educativos en que estas herramientas pueden servir para señalar textos que merecen una revisión más detallada, pero no deberían utilizarse como única evidencia para sancionar a un estudiante o cuestionar la autoría de un documento. La mejor práctica consiste en combinar su uso con otros métodos de evaluación, como el seguimiento del proceso de escritura, entrevistas con el autor, versiones previas del trabajo o actividades presenciales que permitan verificar el aprendizaje.
En conjunto, la prueba de Popular Science confirma que los detectores de IA siguen siendo una tecnología inmadura. Aunque han mejorado respecto a sus primeras versiones y pueden ofrecer información útil en determinados contextos, la rápida evolución de los modelos generativos hace que la carrera entre generación y detección sea cada vez más difícil. La tendencia actual apunta a que, más que confiar ciegamente en algoritmos de detección, instituciones educativas y organizaciones deberán desarrollar nuevas estrategias de evaluación y políticas de uso responsable de la inteligencia artificial.
La proliferación de herramientas de inteligencia artificial generativa ha hecho que distinguir entre fotografías auténticas e imágenes sintéticas sea una tarea cada vez más compleja, incluso para periodistas especializados y verificadores profesionales.
En esta guía, Snopes explica los métodos que utiliza habitualmente para determinar si una imagen ha sido creada mediante IA y advierte de que las antiguas señales evidentes —como las manos con seis dedos o el texto ilegible— ya no son suficientes para identificar un montaje. Los modelos más recientes han mejorado notablemente su capacidad para generar imágenes fotorrealistas, por lo que la verificación exige combinar el análisis visual con herramientas técnicas y la comprobación del contexto.
Entre los indicios visuales que aún pueden resultar útiles destacan las anomalías en elementos complejos. Las manos, los dedos, las orejas, el cabello o las conexiones entre objetos siguen siendo puntos débiles de muchos modelos de IA. Snopes cita ejemplos recientes, como imágenes falsas de la supuesta boda de Taylor Swift y Travis Kelce, donde algunos personajes presentaban seis dedos, o una fotografía ficticia del senador Mitch McConnell hospitalizado, en la que los tubos médicos terminaban de forma incoherente o se conectaban de manera imposible. También recomienda examinar cuidadosamente reflejos, sombras, patrones repetitivos y la interacción entre distintos objetos de la escena.
Otro aspecto importante es el tratamiento del texto dentro de las imágenes. Aunque los generadores actuales producen rótulos y carteles mucho más convincentes que hace unos años, todavía suelen cometer pequeños errores gramaticales, puntuación inconsistente o mayúsculas inusuales. Estos detalles permitieron a Snopes desmontar, por ejemplo, una falsa carta de dimisión atribuida al entonces presidente de la Reserva Federal, Jerome Powell. Sin embargo, los autores insisten en que estos fallos son cada vez menos frecuentes y no deben considerarse una prueba definitiva de manipulación.
La guía concede especial importancia a las herramientas de verificación técnica. Recomienda utilizar buscadores inversos de imágenes, como Google Lens o TinEye, para comprobar el origen de una fotografía, así como revisar los metadatos cuando sea posible. Además, destaca la aparición de sistemas de procedencia digital como SynthID de Google o las Content Credentials (C2PA), que permiten identificar determinadas imágenes creadas por IA cuando conservan sus marcas de origen. No obstante, estas tecnologías no son infalibles: una imagen puede perder esa información si ha sido recortada, capturada mediante una captura de pantalla o editada posteriormente.
La principal conclusión de Snopes es que ya no basta con preguntarse si una imagen «parece real». La mejor estrategia consiste en verificar quién la publica, cuál es su contexto, si existen otras fuentes independientes que confirmen el hecho y qué evidencias respaldan su autenticidad. En la era de la inteligencia artificial generativa, el pensamiento crítico y la verificación de la procedencia resultan mucho más fiables que confiar únicamente en la percepción visual
En esta edición de Planeta Biblioteca, Bernat Kun y Carme Roig presentan Index, una plataforma tecnológica en la nube (Software as a Service, SaaS) desarrollada para gestionar de forma integral el proceso editorial de las revistas científicas, con una especial orientación hacia las publicaciones de acceso abierto. Durante la conversación explican cómo la plataforma nace para responder a las necesidades de digitalización y profesionalización de la edición académica, ofreciendo un entorno único que reúne todas las fases del flujo editorial, desde la recepción de manuscritos hasta la publicación final.
Los entrevistados destacan que la misión de Index es facilitar la comunicación científica mediante la automatización de tareas administrativas y técnicas que tradicionalmente consumen una gran cantidad de tiempo y recursos. La plataforma permite gestionar el envío de originales, la revisión por pares, la comunicación entre autores, revisores y editores, el control de versiones, la maquetación, la publicación y el seguimiento de indicadores, contribuyendo a una gestión editorial más eficiente, transparente y organizada.
Uno de los aspectos centrales de la entrevista es la importancia de la automatización como herramienta para mejorar el trabajo de los equipos editoriales. Bernat Kun y Carme Roig explican que la reducción de tareas repetitivas permite a los editores dedicar más tiempo a la evaluación científica y a la mejora de la calidad de los contenidos. Al mismo tiempo, autores y revisores disponen de un entorno intuitivo que agiliza la comunicación, mejora el seguimiento de los manuscritos y reduce significativamente los tiempos de respuesta y publicación.
La conversación también aborda el compromiso de Index con el acceso abierto. Sus responsables defienden que el conocimiento científico debe ser accesible para toda la sociedad y consideran que la tecnología desempeña un papel fundamental para democratizar el acceso a la investigación. En este sentido, la plataforma busca ofrecer soluciones avanzadas que estén al alcance tanto de grandes instituciones como de pequeñas y medianas editoriales, eliminando barreras técnicas y económicas que tradicionalmente dificultaban la gestión profesional de las revistas científicas.
Otro de los temas tratados es el apoyo específico que Index ofrece a las editoriales de menor tamaño, que suelen enfrentarse a limitaciones de recursos humanos y tecnológicos. La plataforma proporciona una infraestructura completa sin necesidad de realizar grandes inversiones en desarrollo o mantenimiento informático, permitiendo que las instituciones centren sus esfuerzos en la calidad científica, la internacionalización y la mejora de la visibilidad de sus publicaciones.
Durante la entrevista también se presentan los valores que definen la cultura organizativa de Index, basados en la innovación, la colaboración, la orientación al cliente y el compromiso con la excelencia. Sus responsables explican que la empresa trabaja con revistas e instituciones de distintos países, adaptando la plataforma a diferentes contextos editoriales y favoreciendo la interoperabilidad con estándares internacionales, un aspecto esencial para incrementar la difusión y el impacto de la producción científica.
La inteligencia artificial está transformando los procesos de selección de personal al permitir que las empresas examinen con mucha más profundidad la huella digital de candidatos y empleados. Lo que antes consistía en una búsqueda superficial en Google se ha convertido en análisis automatizados capaces de rastrear publicaciones, imágenes, comentarios y perfiles dispersos por decenas de plataformas, incluso cuando los usuarios creen haber permanecido en el anonimato. Herramientas especializadas combinan reconocimiento facial, análisis de redes sociales y correlación de datos públicos para reconstruir la actividad digital de una persona con gran precisión.
El artículo explica que esta práctica ya no se limita a altos directivos o cargos especialmente sensibles. Gracias a la reducción de costes y al aumento de la capacidad de la IA, las verificaciones digitales se están extendiendo a puestos de atención al público y a muchos procesos ordinarios de contratación. Las empresas buscan detectar comportamientos que puedan afectar a su reputación, identificar posibles conflictos con sus valores corporativos o evaluar el encaje cultural de los candidatos. En algunos casos, el seguimiento continúa incluso después de la contratación mediante sistemas de monitorización permanente de la actividad pública en Internet.
Uno de los aspectos más llamativos es que la IA puede recuperar información que parecía olvidada. Publicaciones antiguas en redes sociales, fotografías comprometedoras, comentarios realizados hace muchos años o participaciones en plataformas de contenido para adultos, apuestas o mercados de predicción pueden reaparecer durante un proceso de selección. El artículo cita ejemplos recientes de figuras públicas cuyas antiguas publicaciones o contenidos digitales dañaron gravemente sus carreras, ilustrando cómo la permanencia de la información en Internet se convierte en un factor de riesgo profesional.
Sin embargo, eliminar por completo la presencia digital tampoco constituye una solución. Los expertos consultados advierten de que una huella digital excesivamente limpia o recientemente borrada puede despertar sospechas entre los responsables de contratación. Algunas empresas incluso desarrollan herramientas para detectar perfiles con una presencia en línea anormalmente escasa, ya que esto puede interpretarse como un intento deliberado de ocultar información o incluso como un posible fraude de identidad.
El artículo concluye que la mejor estrategia no consiste en desaparecer de Internet, sino en gestionar activamente la reputación digital. Se recomienda revisar periódicamente qué información aparece al buscar el propio nombre, eliminar contenidos claramente perjudiciales cuando sea posible, reforzar la privacidad de las cuentas y generar una presencia profesional positiva mediante páginas personales, perfiles actualizados o publicaciones relacionadas con la actividad laboral. En la era de la inteligencia artificial, la reputación digital deja de ser un aspecto secundario para convertirse en un elemento cada vez más determinante en el acceso y la permanencia en el mercado laboral.
Tay, Aaron.AI Search Is Rebundling Everything Libraries Know About Discovery: Ten established traditions, an emerging eleventh, and why libraries need to have a more holistic view of discovery. Aaron Tay’s Musings about Librarianship (Substack), 18 de julio de 2026. https://aarontay.substack.com/p/eleven-ways-of-looking-at-academic
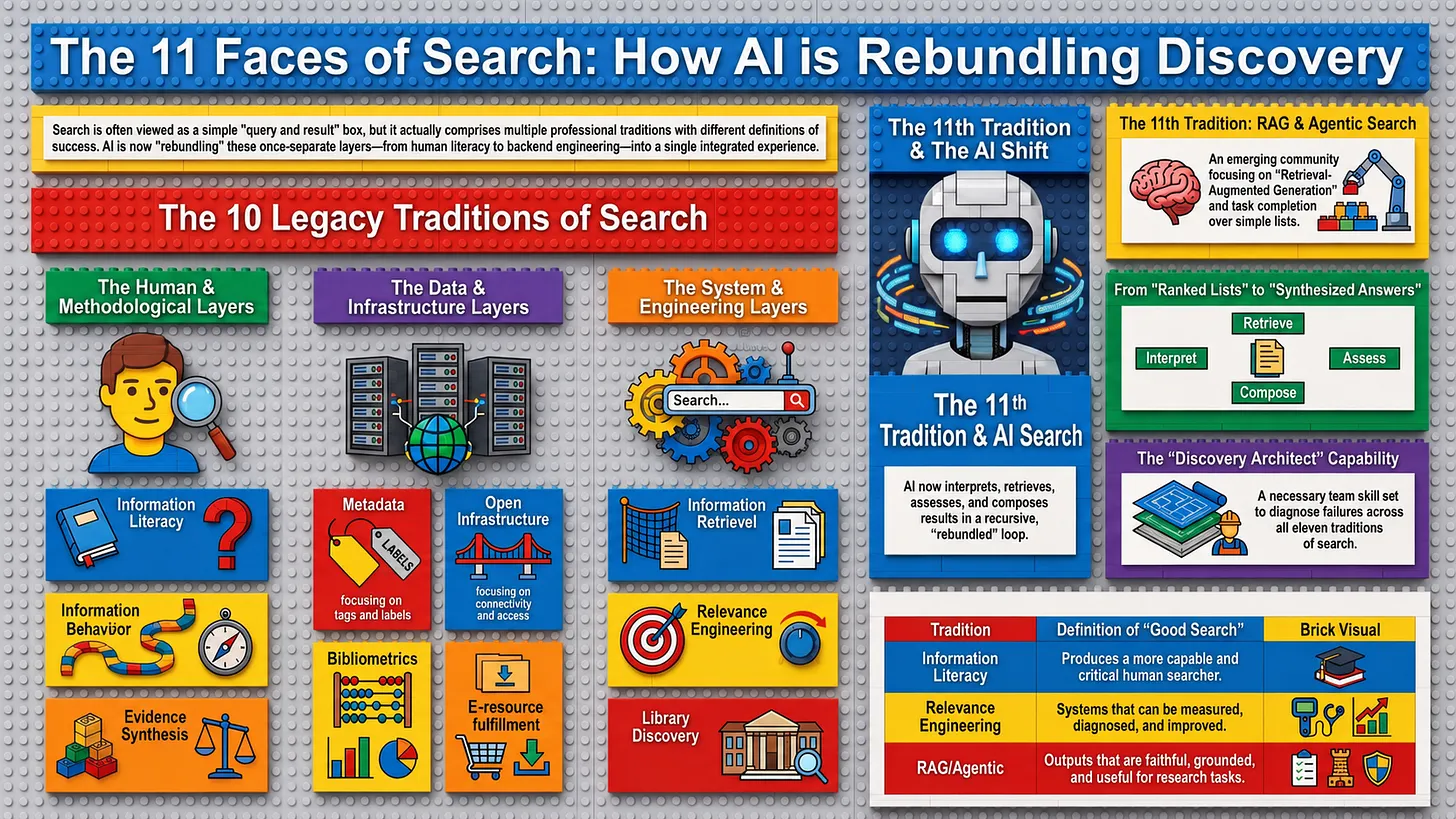
Aaron Tay plantea que la búsqueda académica nunca ha sido una actividad única y homogénea, sino un conjunto de perspectivas desarrolladas por comunidades profesionales y de investigación diferentes. Inspirándose en el conocido ensayo de Lorcan Dempsey Thirteen Ways of Looking at Libraries, Discovery, and the Catalog, el autor propone que la búsqueda científica puede entenderse desde diez tradiciones consolidadas y una undécima emergente.
Cada una de ellas interpreta el mismo proceso de búsqueda desde objetivos distintos: unas priorizan la alfabetización informacional, otras el comportamiento de los usuarios, la recuperación de información, la bibliometría, la infraestructura científica, la organización del conocimiento o la ingeniería de relevancia. El problema, sostiene Tay, no es la ausencia de conocimiento sobre la búsqueda académica, sino la fragmentación de ese conocimiento entre comunidades que apenas comparten lenguaje, métodos de evaluación o marcos conceptuales.
El autor describe cómo cada tradición aporta una pieza esencial del ecosistema de descubrimiento. Los especialistas en alfabetización informacional consideran que una buena búsqueda es aquella que forma usuarios críticos capaces de evaluar fuentes y detectar sesgos, especialmente en un contexto donde las respuestas generadas por IA pueden parecer convincentes sin ser necesariamente fiables. Los investigadores del comportamiento informacional, por su parte, entienden la búsqueda como un proceso dinámico en el que las necesidades del usuario evolucionan mientras explora información, reformula consultas y redefine sus objetivos. Los expertos en revisiones sistemáticas y síntesis de evidencia ponen el énfasis en la exhaustividad, la transparencia y la reproducibilidad de las estrategias de búsqueda, considerando que estas forman parte del propio método científico y deben ser documentadas y auditadas rigurosamente.
Uno de los argumentos centrales del artículo es que la irrupción de la inteligencia artificial está desdibujando las fronteras tradicionales entre estas disciplinas. En los sistemas clásicos existían capas relativamente independientes: los metadatos, la recuperación de documentos, el ordenamiento de resultados, el acceso al texto completo o la evaluación crítica podían estudiarse por separado. Los sistemas de búsqueda basados en IA, en cambio, integran continuamente interpretación de preguntas, recuperación de información, selección de evidencias, generación de respuestas y razonamiento automatizado. La IA no elimina estas capas, sino que las reorganiza en arquitecturas mucho más complejas donde interactúan de forma constante. Como consecuencia, comprender cómo funciona realmente un sistema de búsqueda requiere conocimientos que hasta ahora estaban distribuidos entre comunidades muy distintas.
Ante esta nueva realidad, Tay propone el surgimiento de una nueva capacidad organizativa que denomina «discovery architect» o arquitecto del descubrimiento, aunque insiste en que no debe entenderse necesariamente como un nuevo puesto de trabajo, sino como una competencia colectiva que deberían desarrollar las bibliotecas académicas. Este equipo tendría una visión transversal del ecosistema completo de búsqueda científica, capaz de comprender metadatos, infraestructuras abiertas, algoritmos de recuperación, modelos de IA, sistemas de acceso, grafos de conocimiento y herramientas de descubrimiento. Su función consistiría en diagnosticar correctamente por qué un sistema de búsqueda falla: si el problema reside en la cobertura documental, en los metadatos, en la desambiguación de entidades, en el algoritmo de recuperación, en el ranking, en la selección de evidencias o en la generación de respuestas por parte del modelo. Más que resolver directamente todos esos problemas, debería ser capaz de identificar qué tipo de conocimiento especializado resulta necesario en cada caso.
Según Aaron Tay, las once maneras de entender la búsqueda académica representan diferentes disciplinas y comunidades profesionales que analizan el descubrimiento de información desde perspectivas complementarias. Son las siguientes:
Alfabetización informacional (Information Literacy) Considera la búsqueda como una competencia que debe aprenderse y desarrollarse. El objetivo es que los usuarios sepan formular preguntas, elegir fuentes adecuadas, evaluar críticamente la información y utilizarla de forma ética.
Comportamiento informacional (Information Behaviour) Estudia cómo las personas buscan información en situaciones reales. Analiza las necesidades de información, las estrategias de búsqueda, la incertidumbre, la exploración y cómo evolucionan las consultas durante el proceso.
Recuperación de información (Information Retrieval – IR) Se centra en los algoritmos y modelos que permiten localizar los documentos más relevantes para una consulta. Incluye aspectos como la indexación, el ranking, la relevancia, la recuperación semántica y la evaluación de los sistemas de búsqueda.
Recuperación interactiva de información (Interactive Information Retrieval – IIR) Examina la interacción entre el usuario y el sistema de búsqueda. Estudia cómo las interfaces, la reformulación de consultas y la retroalimentación mejoran los resultados obtenidos.
Revisiones sistemáticas y síntesis de evidencia (Systematic Searching / Evidence Synthesis) Concibe la búsqueda como un componente esencial del método científico. Da prioridad a la exhaustividad, la reproducibilidad, la transparencia y la documentación detallada de las estrategias de búsqueda.
Bibliometría y cienciometría (Bibliometrics / Scientometrics) Utiliza la búsqueda para analizar la producción científica, las citas, las redes de colaboración, el impacto de las publicaciones y la evolución de las disciplinas.
Organización del conocimiento (Knowledge Organization) Se ocupa de cómo se describen y estructuran los recursos mediante metadatos, vocabularios controlados, tesauros, clasificaciones, ontologías y grafos de conocimiento para facilitar su descubrimiento.
Bibliotecas y sistemas de descubrimiento (Library Discovery Systems) Analiza las plataformas que integran catálogos, bases de datos, repositorios y recursos electrónicos, así como las decisiones sobre cobertura, relevancia y experiencia de usuario en los servicios bibliotecarios.
Infraestructura de comunicación científica (Scholarly Communication Infrastructure) Observa la búsqueda desde el punto de vista de las infraestructuras que hacen posible el descubrimiento: identificadores persistentes (DOI, ORCID), índices, repositorios, bases de datos, acceso abierto y metadatos interoperables.
Motores de búsqueda académicos y plataformas comerciales (Academic Search Engines and Discovery Platforms) Estudia cómo servicios como Google Scholar, Scopus, Web of Science, Semantic Scholar o Dimensions construyen sus índices, seleccionan contenidos y ordenan los resultados mediante algoritmos propios.
Arquitectura del descubrimiento impulsada por IA (Discovery Architecture / AI Discovery)(la perspectiva emergente propuesta por Tay)
El autor advierte que esta capacidad de diagnóstico será insuficiente si las bibliotecas no exigen mayor transparencia a los proveedores de plataformas de búsqueda basadas en IA. Reclama acceso a registros de consultas, información sobre la cobertura de los índices, documentación de los criterios de clasificación, mecanismos para evaluar la relevancia de los resultados y posibilidades de auditar las distintas fases del proceso de recuperación y generación de respuestas. Sin esa apertura, afirma Tay, incluso reuniendo a especialistas de todas las disciplinas implicadas, cualquier análisis sobre el funcionamiento de estos sistemas seguirá siendo en gran medida especulativo. El artículo concluye anunciando una segunda parte dedicada a analizar dónde reside realmente la inteligencia de los nuevos sistemas de búsqueda: en los grandes modelos de lenguaje, en los mecanismos de recuperación documental o en la combinación de ambos mediante arquitecturas híbridas.