Archivo del Autor: Julio Alonso Arévalo

Avatar de Desconocido

Acerca de Julio Alonso Arévalo

Bibliotecario de la Facultad de Traducción y Doc. de la USAL. Ex-Miembro del Grupo de Investigación E-LECTRA. Premio Nacional de Investigación por la UNE Premio mejor Profesional Social Media INFOAWARDS 2019. Creador y editor del repositorio E-LIS. Más de 80 artículos científicos publicados - Ver en E-LIS -en revistas científicas. El profesional de la información, Library Hi-Tech, Electronic Library. Investigación Bibliotecológica, Anales de Documentación... 12 libros publicados: Nueva fuentes de información en el contexto de la web 2.0 (Pirámide), Gutemberg 2.0 (TREA). Social Reading (Elsevier), eBooks en bibliotecas universitarias (TREA), El ecosistema del libro electrónico universitario (UNE), Un viaje a la cultura open (Amazon), GRATIS Zotero (Creative Spaces), Leyendo entre Pantallas (Trea), GRATIS Literaçia da infomrçao (ISPA) GRATIS Espistemologia y acceso abierto (UCE) GRATIS Makerspaces y bibliotecas. Barcelona: El Profesional de la Información EPI-UOC, 2018. Makerspaces. Espacios creativos en bibliotecas: creación, planificación y programación de actividades. Salamanca: Ediciones del Universo, 2019. Los libros, la lectura y los lectores a través de la literatura y las artes. Buenos Aires : Alfagrama Ediciones, 2019 Más de 2000 citas en Google Schoolar Creador y gestor del blog Universo abierto Director del programa de Radio Planeta Biblioteca Más de 250.000 seguidores en los grupos profesionales de Facebook.

Anthropic anuncia que Claude ya puede acceder a Gmail, Google Calendar y Google Docs

Zeff, Maxwell. 2025. “Anthropic’s Claude Can Now Read Your Gmail.” TechCrunch, April 15, 2025. https://techcrunch.com/2025/04/15/anthropics-claude-now-read-your-gmail/

Anthropic informó que su chatbot de inteligencia artificial, Claude, ahora se integra con Google Workspace, permitiéndole acceder a correos electrónicos en Gmail, eventos programados en Google Calendar y documentos en Google Docs.

Esta funcionalidad está en fase beta y está disponible para los suscriptores de los planes Max, Team, Enterprise y Pro. Para las cuentas corporativas, será necesario que los administradores activen previamente la integración.

Con esta nueva herramienta, Claude se posiciona como uno de los primeros chatbots de terceros que se conectan profundamente con el ecosistema de productividad de Google, en competencia directa con Gemini de Google DeepMind y ChatGPT de OpenAI (este último ya permite acceso a archivos de Google Drive).

La integración busca ofrecer respuestas personalizadas sin necesidad de que el usuario suba archivos o escriba indicaciones complejas. Claude podrá escanear correos y calendarios, por ejemplo, para ayudar a padres a identificar compromisos importantes y buscar información relevante como calendarios escolares, eventos comunitarios o pronósticos del tiempo.

Uno de los aspectos más destacados es que Claude ofrecerá citas en línea (inline citations), mostrando al usuario la fuente precisa de la información que utiliza desde Google Workspace.

Sin embargo, esta funcionalidad también ha generado preocupaciones sobre la privacidad y seguridad de los datos, ya que no está completamente claro el alcance de la búsqueda que Claude puede realizar en los contenidos del usuario. Por ejemplo, no se especifica si Claude necesita instrucciones explícitas para acceder a ciertos correos o si puede consultar datos sensibles automáticamente. Tampoco se ha aclarado si el usuario puede restringir el acceso a determinados archivos.

En respuesta a estas inquietudes, un portavoz de Anthropic aseguró que la empresa no utiliza los datos de los usuarios para entrenar sus modelos, y que ha implementado mecanismos rigurosos de autenticación y control de acceso. Cada conexión con servicios externos está ligada exclusivamente al usuario o institución correspondiente y Claude no puede compartir información entre cuentas.

Además de esta integración, Anthropic lanzó también una nueva función llamada Claude Research, un sistema de búsqueda profunda que realiza múltiples consultas web para ofrecer respuestas detalladas. Esta herramienta compite directamente con los agentes de investigación avanzados de OpenAI y Google, y promete un equilibrio óptimo entre velocidad y exhaustividad. Según la compañía, las búsquedas de Claude Research tardan menos de un minuto en completarse.

Claude Research está disponible inicialmente en Estados Unidos, Japón y Brasil para usuarios de los planes Max, Team y Enterprise, y llegará próximamente a los suscriptores del plan Pro.

Ambas novedades se enmarcan en la estrategia de Anthropic para atraer nuevos usuarios a sus planes de suscripción. Aunque Claude ha ganado popularidad —con 3,3 millones de usuarios web en marzo de 2025—, su base de usuarios aún es considerablemente más pequeña que la de ChatGPT.
10 razones por las que la revista científica no se adapta a las nuevas formas de hacer y comunicar ciencia en el siglo XXI

Worlock, David. 2025. “10 Reasons Why the Science Research Journal Has Passed Its Sell-by Date.” David Worlock, April 2025. https://www.davidworlock.com/2025/04/10-reasons-why-the-science-research-journal-has-passed-its-sell-by-date/

El autor propone una revisión profunda y urgente del modelo actual, denunciando no solo su ineficacia y costes, sino también su incapacidad para adaptarse a las nuevas formas de hacer y comunicar ciencia en el siglo XXI.

Se recogen una reflexión crítica presentada durante una conferencia reciente del UKSG en Brighton. El autor, uno de los participantes en un debate junto con representantes de Elsevier y Coherent Digital, expone diez argumentos que justifican su afirmación de que el sistema de publicación científica, tal como lo conocemos, necesita una transformación profunda.

El sistema de publicación científica ha quedado anclado en estructuras del pasado, reproduciendo en digital las limitaciones del mundo impreso. La irrupción de la inteligencia artificial promete cambiar radicalmente este panorama, automatizando procesos, eliminando intermediarios innecesarios y creando un nuevo ecosistema de comunicación científica más ágil, accesible y confiable.

  1. El acceso abierto ya no cumple su promesa
    El modelo de acceso abierto (open access), que en su origen pretendía reducir barreras y costos para que el conocimiento científico fuera más accesible, ha comenzado no solo a estancarse, sino incluso a retroceder. Su funcionamiento basado en el volumen de publicaciones ha generado desconfianza, pues antepone la cantidad a la calidad. Irónicamente, lo que debía ser una alternativa más económica, ahora está siendo rechazado precisamente por sus elevados costes.
  2. La revisión por pares está en crisis
    El sistema de revisión por pares, que históricamente ha sido la piedra angular de la credibilidad científica, se encuentra quebrado. Cada vez más investigadores, entidades financiadoras y usuarios pierden la confianza en este mecanismo. Su lentitud, falta de transparencia y vulnerabilidad ante fraudes han generado una creciente deslegitimación del proceso.
  3. Falta un sistema centralizado de retracciones
    Existe una carencia grave de transparencia en lo que respecta a las retractaciones de artículos científicos. Los usuarios no disponen de un índice centralizado ni fiable para consultar qué artículos han sido retirados y por qué. Esto genera incertidumbre sobre la validez del conocimiento publicado y dificulta la depuración de errores científicos.
  4. Las publicaciones son demasiado lentas
    En áreas donde el conocimiento avanza a gran velocidad —como la biotecnología, la inteligencia artificial o la salud pública—, el sistema tradicional de publicación científica resulta excesivamente lento. Las revistas no logran adaptarse a los ritmos que exige la investigación actual, lo que entorpece el progreso científico y su aplicación práctica.
  5. Costes insostenibles para la comunidad investigadora
    Publicar en revistas científicas se ha convertido en una tarea costosa y poco rentable. Los beneficios no justifican el gasto y los financiadores se muestran cada vez más reacios a asumir los pagos asociados. El desequilibrio entre coste y retorno ha hecho que este sistema se perciba como económicamente insostenible.
  6. Falta de integridad estructural
    Muchos de los problemas actuales podrían resolverse si las revistas ofrecieran la integridad editorial plena que los usuarios esperan. Sin embargo, hoy en día proliferan contenidos generados por inteligencias artificiales sin control, artículos de papermills (fábricas de artículos) y fraudes sistemáticos que socavan la confianza en las publicaciones científicas.
  7. Estándares técnicos difíciles de aplicar en el sistema actual
    El desarrollo y aplicación de estándares técnicos como metadatos estructurados, identificadores persistentes (PIDs) y códigos de contenido (ISCC, C2PA, etc.) resulta más viable en entornos de autopublicación que dentro de los sistemas rígidos y obsoletos de las editoriales científicas. Esto limita el potencial de la ciencia abierta y dificulta la interoperabilidad entre plataformas.
  8. La validación científica debe independizarse de las revistas
    Los procesos de reconocimiento y evaluación científica —como la concesión de becas, ascensos o financiación— están demasiado ligados al prestigio de las revistas y a métricas como el factor de impacto, fácilmente manipulables. Sería preferible desarrollar sistemas independientes y más justos que reconozcan la calidad real de los investigadores sin depender de la marca editorial.
  9. El formato del artículo científico necesita evolucionar
    El formato tradicional de artículo ya no responde a las necesidades actuales. Es necesario introducir prácticas como la pre-registro de hipótesis y metodologías, y la integración de datos experimentales, código, vídeos, imágenes, audio, blogs y otros soportes que hoy en día las revistas no contemplan. La publicación científica debe volverse multimodal y más transparente.
  10. La lectura humana ya no es suficiente
    Dado el volumen de información disponible, muchos investigadores no tienen tiempo para leer artículos completos. Por ello, la comunicación entre máquinas se vuelve crucial. Sin embargo, las estructuras narrativas actuales no están diseñadas para su interpretación automática, lo que impide aprovechar el potencial de la inteligencia artificial y del análisis automatizado. Se necesita una transición hacia datos estructurados y enriquecidos con metadatos, comprensibles por máquinas.

German Natonal Academy of Sciences propone un cambio estructural de modelo de comunicación científica basado en una financiación directa de revistas científicas.

Tautz, D., Holzer, A., Schmidt, K. M., Buchner, J., Grötschel, M. & Jurburg, S. A New Concept for the Direct Funding and Evaluaton of Scientfc Journals.
Discussion No. 38, Halle (Saale): German Natonal Academy of Sciences
Leopoldina, 2025

Texto completo

La Academia Nacional de Ciencias de Alemania (Leopoldina) ha publicado el 15 de abril de 2025 un documento de debate que propone una profunda transformación en el modelo de publicación científica. El foco principal del texto es la necesidad de financiar directamente y evaluar públicamente las revistas científicas, con el objetivo de garantizar el acceso abierto al conocimiento, reducir costes y mejorar la calidad de las publicaciones académicas.

Actualmente, el acceso a los artículos científicos está restringido por barreras de pago impuestos por un pequeño grupo de editoriales con fines de lucro. Estas empresas obtienen ingresos bien sea a través de suscripciones de bibliotecas o mediante el cobro a los autores por publicar sus investigaciones (las llamadas article processing charges, APC). Dado que la financiación de la ciencia y las bibliotecas universitarias proviene del erario público, los beneficios de estas editoriales terminan repercutiendo en el presupuesto público, sin que exista una mejora proporcional en el valor científico ofrecido. Además, la escasa competencia ha derivado en una especie de monopolio editorial, que ha encarecido el sistema sin mejorar su eficiencia ni su calidad.

Frente a esta problemática, el documento propone que la financiación de las revistas científicas siga el mismo modelo que la investigación pública. En este sentido, serían las sociedades científicas, academias o instituciones públicas las encargadas de solicitar recursos para crear y mantener revistas científicas. Estas solicitudes se evaluarían mediante procedimientos competitivos y con criterios similares a los aplicados en la financiación de proyectos de investigación. De este modo, no solo se aseguraría la calidad y la pertinencia científica de las publicaciones, sino que también se garantizaría la transparencia en la gestión de los recursos.

El modelo propuesto se basa en el acceso abierto diamante (diamond open access), que se distingue por ser gratuito tanto para los autores como para los lectores. A diferencia del modelo de acceso abierto “oro”, donde el autor asume los costes de publicación, el modelo diamante plantea que la financiación provenga exclusivamente de fondos públicos adjudicados mediante convocatorias específicas. Así, el control editorial y financiero permanecería en manos de la comunidad científica, y los componentes del proceso editorial (como la revisión, maquetación o difusión) podrían contratarse a terceros mediante procedimientos abiertos y competitivos.

Para implementar este nuevo sistema, el informe recomienda involucrar activamente a las sociedades científicas que ya gestionan publicaciones, a fin de calcular el presupuesto necesario y diseñar adecuadamente el proceso de solicitud de fondos. También propone poner en marcha un proyecto piloto a nivel nacional que permita probar la viabilidad del modelo y ajustar sus mecanismos. Asimismo, se sugiere crear un grupo de trabajo internacional para explorar posibilidades de cofinanciación supranacional, lo cual permitiría extender el sistema a escala europea o global.

En definitiva, la propuesta de la Leopoldina busca asegurar que el conocimiento científico financiado con recursos públicos sea accesible libremente por toda la sociedad, esté gestionado desde la comunidad científica y se publique bajo principios de calidad, eficiencia y transparencia. Se trata de una iniciativa que, de implementarse, supondría una transformación radical del sistema editorial científico actual, desplazando el protagonismo de las grandes editoriales comerciales hacia las instituciones científicas públicas.

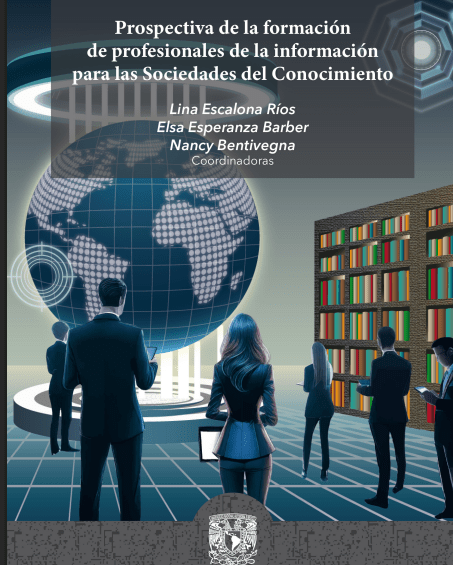
Prospectiva de la formación de profesionales de la información para las sociedades del conocimiento

Escalona Ríos, Lina, Elsa E. Barber y Nancy Bentivegna. 2025. Prospectiva de la formación de profesionales de la información para las sociedades del conocimiento. Ciudad de México: Instituto de Investigaciones Bibliotecológicas y de la Información, UNAM, 2025

Texto completo

PDF

ePuB

El libro Prospectiva de la formación de profesionales de la información para las sociedades del conocimiento examina los fenómenos de la bibliotecología desde diversas perspectivas. Analiza temas como la enseñanza en el currículo, las estrategias de aprendizaje y los retos de la docencia en entornos híbridos, lo que demanda un manejo avanzado de las Tecnologías de la Información y la Comunicación (TIC). Cada capítulo aborda formas de afrontar los paradigmas de la educación bibliotecológica, archivística y documental. Los autores invitan a reflexionar sobre la evolución de conceptos clave, como información, datos, práctica docente e investigación, así como la transformación de las áreas de especialización. La obra también explora la educación formal de los profesionales de la información y los retos que conlleva a través de estrategias docentes y los desafíos inherentes. Además, ofrece un panorama del mercado laboral al que se enfrentan estudiantes y expertos, describiendo los espacios de inserción profesional, tanto tradicionales como emergentes. Los trabajos reflejan los temas que preocupan a los especialistas de la información y cómo los abordan mediante una mirada representativa de las posturas teóricas y metodológicas contemporáneas en el campo.​

La mayoría de los estadounidenses quiere leer más libros. Pero no lo consigue

Limbong, Andrew. “Most Americans Want to Read More Books. We Just Don’t.” NPR, April 7, 2025. https://www.npr.org/2025/04/07/nx-s1-5333652/books-reading-poll.

Una nueva encuesta realizada por NPR/Ipsos revela que la mayoría de los estadounidenses disfrutan de la lectura y desean leer más, aunque en la práctica no sea una prioridad para ellos. El sondeo, realizado a más de 2.000 adultos en EE. UU., muestra que el 82 % considera que leer es una buena forma de aprender sobre el mundo, el 76 % lo encuentra relajante, y un 98 % de quienes tienen hijos quieren que estos desarrollen el gusto por la lectura.

A pesar de estas aspiraciones, solo el 51 % de los encuestados leyó un libro en el último mes, mientras que alrededor del 80 % consumió contenido en plataformas de streaming, redes sociales o videos cortos. Mallory Newall, vicepresidenta de Ipsos, señala que no se trata de una competencia directa entre leer y otras formas de entretenimiento, sino más bien de una cuestión de falta de tiempo. La razón más común para no leer más fue “otras actividades de la vida”, como tareas del hogar, socializar o simplemente descansar.

Cuando se preguntó qué harían con una hora extra de ocio, la mayoría optó por pasar tiempo con la familia, seguido en un empate por ver televisión, leer o hacer ejercicio. Las mujeres y las personas con mayor nivel educativo son significativamente más propensas a elegir la lectura en ese caso hipotético.

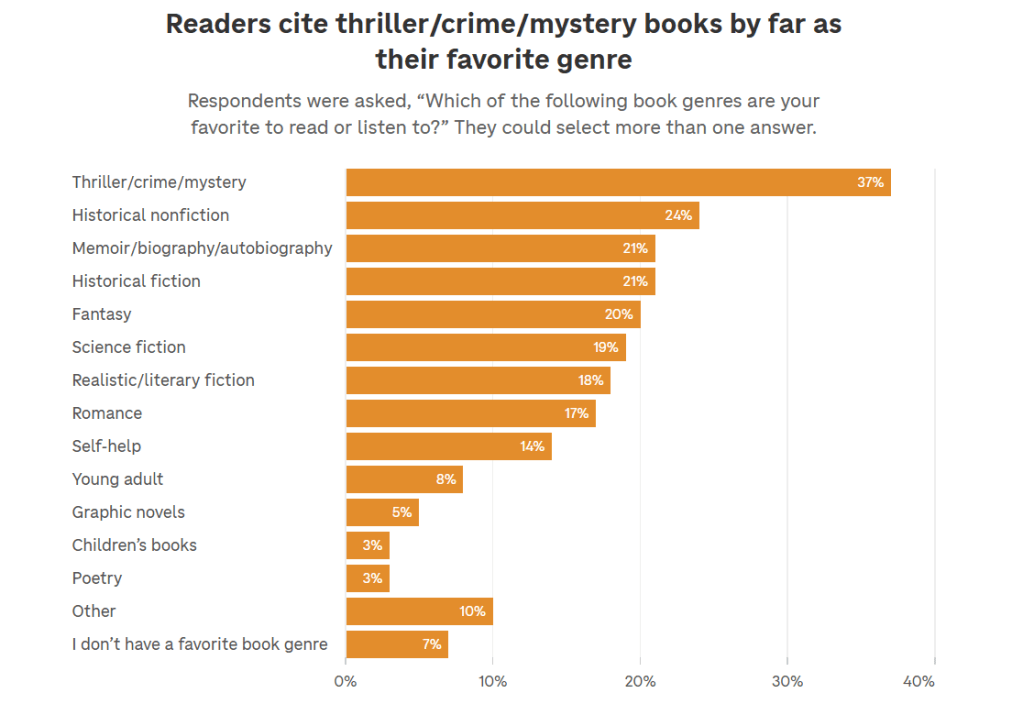
En cuanto a los géneros favoritos, los libros de suspense, crimen y misterio lideran ampliamente con un 37 % de preferencia. En un segundo nivel están la no ficción histórica (24 %), las memorias y la ficción histórica (ambas con 21 %). Las mujeres y los mayores de 50 años son los principales lectores de thrillers, aunque las mujeres muestran una mayor diversidad en sus gustos literarios, mientras que los hombres tienden a concentrarse en la no ficción.

Los porcentajes representan la proporción de personas que seleccionaron cada género como uno de sus favoritos:

  1. Thriller/crimen/misterio: 37% — Es claramente el género más popular, con una ventaja significativa sobre los demás.
  2. No ficción histórica: 24%
  3. Memorias/biografías/autobiografías: 21%
  4. Ficción histórica: 21%
  5. Fantasía: 20%
  6. Ciencia ficción: 19%
  7. Ficción realista/literaria: 18%
  8. Romance: 17%
  9. Autoayuda: 14%
  10. Literatura juvenil (Young adult): 8%
  11. Novelas gráficas: 5%
  12. Libros infantiles: 3%
  13. Poesía: 3%
  14. Otros: 10%
  15. No tengo un género favorito: 7%

Respuestas clave:

  • Los géneros más populares tienden a ser narrativos y orientados al entretenimiento, como los thrillers y la fantasía.
  • Los géneros de no ficción también tienen una gran presencia (como la no ficción histórica y las biografías).
  • Géneros como la poesía y los libros infantiles tienen una representación muy baja.
  • Un 7% de los encuestados afirmó no tener un género favorito, lo que sugiere una apertura o falta de preferencia específica en un segmento de lectores.

La edad influye notablemente en los hábitos de lectura: las personas mayores de 65 años son quienes más tiempo dedican a leer, posiblemente porque tienen más tiempo libre o no están al cuidado de niños pequeños. Para los jóvenes, leer es un deseo, pero se percibe como una actividad de baja prioridad e incluso algo aburrida, según Newall.

En conclusión, aunque leer sigue siendo una aspiración compartida por muchos estadounidenses, los hábitos reales muestran que otras formas de entretenimiento y las demandas del día a día suelen desplazar a la lectura del centro de sus rutinas.

Cada vez se solicitan más retiradas de libros en el Reino Unido influenciados por los grupos extremista de Estados Unidos

Creamer, Ella. 2025. «Librarians in UK Increasingly Asked to Remove Books, as Influence of US Pressure Groups Spreads.» The Guardian, April 14, 2025. https://www.theguardian.com/books/2025/apr/14/librarians-in-uk-increasingly-asked-to-remove-books-as-influence-of-us-pressure-groups-spreads.

En el Reino Unido, las solicitudes para retirar libros de las bibliotecas están aumentando, influenciadas por grupos de presión estadounidenses que han impulsado campañas de censura, especialmente en torno a libros con contenido LGBTQ+. Aunque la situación británica no es tan grave como la estadounidense, profesionales del sector advierten de casos preocupantes de censura, acoso en redes sociales y pérdida de empleo por defender la libertad intelectual.

Louis Coiffait-Gunn, director del Chartered Institute of Library and Information Professionals (CILIP), y Ed Jewell, presidente de Libraries Connected, señalan un incremento anecdótico en las peticiones de censura, sobre todo desde personas o pequeños grupos, a diferencia de EE. UU., donde la mayoría de los intentos de censura provienen de organizaciones bien estructuradas.

La investigadora Alison Hicks, profesora de estudios bibliotecarios en UCL, entrevistó a bibliotecarios escolares británicos que enfrentaron desafíos similares a los estadounidenses, como recibir propaganda en sus escritorios o ser atacados por redes sociales. Su estudio también detectó formas particulares de censura en las escuelas del Reino Unido, como la vandalización de libros y carteles con insultos racistas u homófobos, algo que no suele observarse en EE. UU.

Los libros más atacados en el Reino Unido suelen estar relacionados con temas LGBTQ+. Obras como la serie Heartstopper de Alice Oseman y Billy’s Bravery de Tom Percival han sido blanco de críticas. Una encuesta de Index on Censorship reveló que más de la mitad de los casos en los que se pidió retirar libros resultaron en la retirada efectiva de títulos, muchos de temática LGBTQ+. Otro estudio de CILIP en 2023 encontró también que libros sobre raza y el imperio británico eran frecuentemente cuestionados.

A pesar de las diferencias entre ambos países, los ataques están generando altos niveles de angustia entre los bibliotecarios británicos, especialmente en las escuelas. En EE. UU., la censura ha escalado a nivel legislativo en varios estados, lo que preocupa a los profesionales del Reino Unido, que siguen la evolución con solidaridad y alarma.

Una dificultad clave en Reino Unido es la falta de datos oficiales: no se sabe cuántas bibliotecas escolares existen ni cuántos libros han sido censurados. Esto complica el seguimiento del problema. Aun así, la mayoría de las bibliotecas siguen el marco ético de CILIP, que defiende el acceso libre a contenidos siempre que no infrinjan la ley.

Finalmente, Jewell advierte sobre el peligro de que las bibliotecas empiecen a autocensurarse por miedo a la controversia. Destaca la necesidad de preservar la diversidad de ideas para garantizar un debate abierto y plural en la sociedad.

Una exdirectiva de Meta acusa a Zuckerberg de ofrecer datos de ciudadanos estadounidenses a China para operar en el país

Thomson, Iain. “Ex-Meta Exec Tells Senate Zuck Dangled US Citizen Data in Bid to Enter China.” The Register, 11 de abril de 2025. https://www.theregister.com/2025/04/11/meta_senate_china/?utm_source=flipboard&utm_content=other

El 9 de abril de 2025, Sarah Wynn-Williams, exdirectora de políticas públicas globales de Meta (antes Facebook), declaró ante el Subcomité del Senado de EE. UU. sobre Crimen y Contraterrorismo que Mark Zuckerberg estuvo dispuesto a ofrecer datos de ciudadanos estadounidenses a las autoridades chinas con tal de que Facebook pudiera operar en China. Según su testimonio, el proyecto secreto se llamaba Project Aldrin y estaba limitado a personal con necesidad de saber. Parte del plan incluía construir un cable submarino entre EE. UU. y Hong Kong, que fue desviado tras alertas de seguridad nacional.

Wynn-Williams acusó a Meta de ignorar advertencias sobre riesgos de seguridad y de haber mentido al público sobre sus vínculos con China. Afirmó también que Meta desarrolló herramientas de censura junto al Partido Comunista Chino y que la compañía sigue generando ingresos significativos de empresas chinas, aunque oficialmente no opera en el país.

Además, denunció que los modelos de IA de Meta (como LLaMA) han contribuido a avances en inteligencia artificial china, posiblemente con usos militares. Tras su salida de Meta, presentó denuncias ante la SEC y el Departamento de Justicia. Actualmente enfrenta una demanda por parte de Meta que intenta silenciarla.

Varios senadores, incluidos Josh Hawley, Dick Durbin y Richard Blumenthal, respaldaron su testimonio y criticaron a Meta por intentar frenar la audiencia. La compararon con tácticas pasadas de la industria del tabaco para ocultar daños al público. El Senado anunció planes para reforzar la protección de los denunciantes, también en el ámbito de la inteligencia artificial.

Wynn-Williams concluyó que «el pueblo estadounidense merece conocer la verdad» y que la colaboración de Meta con China durante su etapa en la empresa la dejó profundamente impactada.

Análisis de la cobertura de referencias de OpenAlex en comparación con Web of Science y Scopus

Culbert, J., Hobert, A., Jahn, N., Haupka, N., Schmidt, M., Donner, P., & Mayr, P. (2025). Reference Coverage Analysis of OpenAlex compared to Web of Science and Scopus. Scientometrics. https://doi.org/10.1007/s11192-025-05293-3

El estudio muestra que OpenAlex tiene una cobertura de referencias comparable a Web of Science y Scopus. Su número de citas por publicación y cobertura interna son muy similares. Destaca por incluir más identificadores ORCID, aunque ofrece menos resúmenes. En conjunto, es una alternativa válida y abierta para estudios bibliométricos.

Se analiza de manera rigurosa y comparativa la cobertura de referencias y metadatos que ofrece OpenAlex, en relación con dos de las principales bases de datos científicas comerciales: Web of Science (WoS) y Scopus. OpenAlex, desarrollada por el equipo de OurResearch y lanzada oficialmente en enero de 2022 como sucesora de Microsoft Academic Graph (MAG), se presenta como una plataforma de acceso abierto y licencia libre, lo cual representa un cambio significativo frente a los modelos propietarios que han dominado el campo de la bibliometría. Esta accesibilidad ha despertado un interés creciente en su uso por parte de investigadores, bibliotecarios y analistas de información científica.

El objetivo principal del estudio es determinar si OpenAlex puede considerarse una fuente válida, robusta y comparable a WoS y Scopus para el análisis de referencias bibliográficas, uno de los aspectos centrales en los estudios bibliométricos. Para ello, los autores del artículo construyeron un conjunto de datos compuesto por 16,8 millones de publicaciones recientes que aparecen de forma simultánea en las tres bases. Sobre este conjunto común, llevaron a cabo una comparación sistemática en torno a tres aspectos fundamentales: el número medio de referencias por artículo, la cobertura interna de citas (es decir, cuántas referencias citan otros documentos también presentes en la base de datos) y la disponibilidad de metadatos clave como identificadores ORCID, resúmenes y datos sobre el acceso abierto.

Uno de los hallazgos principales del estudio es que OpenAlex proporciona un número de referencias por artículo que es prácticamente equivalente al que ofrecen WoS y Scopus. Asimismo, la distribución de estas referencias —es decir, la forma en que se reparten entre los artículos— es muy similar entre las tres bases de datos, tanto a nivel global como cuando se desagrega por revista científica. Este hallazgo es relevante porque respalda la utilidad de OpenAlex en análisis cuantitativos basados en citas, tales como estudios de impacto, redes de colaboración, evolución de campos científicos, entre otros. La cobertura interna de referencias también se mostró comparable, lo que indica que OpenAlex tiene una red de citaciones sólida dentro de su propio sistema, un criterio importante para quienes realizan análisis de redes académicas.

En lo que respecta a los metadatos adicionales, OpenAlex ofrece una ventaja clara en cuanto a la inclusión de identificadores ORCID, lo que la convierte en una fuente particularmente útil para estudios que exploran la autoría, la colaboración científica y la identificación precisa de personas investigadoras. Sin embargo, presenta una desventaja significativa frente a WoS y Scopus en cuanto a la disponibilidad de resúmenes de artículos, un aspecto que puede limitar su utilidad en estudios de análisis de contenido, minería de texto o revisión sistemática automatizada. En cuanto a los datos sobre acceso abierto, las tres bases de datos muestran porcentajes similares, lo que sugiere que comparten fuentes comunes para este tipo de información, como Unpaywall.

El artículo no solo proporciona datos comparativos, sino que también reflexiona sobre el potencial transformador de OpenAlex en el ámbito de la ciencia abierta. Su gratuidad, accesibilidad y licencia permisiva permiten el desarrollo de herramientas bibliométricas libres, dashboards académicos, sistemas de recomendación científica y visualizaciones sin restricciones legales ni costes de suscripción. Este marco la convierte en una opción especialmente valiosa para instituciones de países en vías de desarrollo, universidades sin acceso a WoS o Scopus, o proyectos de investigación que prioricen la transparencia, la trazabilidad y la reproducibilidad de los datos utilizados.

En conclusión, los autores sostienen que OpenAlex es una alternativa plenamente válida a las bases de datos tradicionales para una gran variedad de estudios bibliométricos. Aunque aún presenta limitaciones, como la menor cobertura de resúmenes, sus fortalezas en cobertura de referencias y metadatos como ORCID la convierten en una herramienta prometedora. Dado que además se encuentra en constante actualización y crecimiento, su adopción puede contribuir a democratizar el acceso a la información científica y a fomentar una ciencia más abierta, colaborativa y reproducible.

El consumo energético de los centros de datos a consecuencia del uso de IA se duplicará en cinco años

Zeff, Maxwell. «An Answer to AI’s Energy Addiction? More AI, Says the IEA.» The Next Web, April 10, 2025. https://thenextweb.com/news/answer-to-ai-energy-consumption-is-more-ai-says-iea.

La Agencia Internacional de la Energía (AIE) ha publicado su primer gran informe sobre el impacto del auge de la inteligencia artificial en el consumo energético global, con resultados preocupantes y algo contradictorios.

Según el informe, el consumo energético de los centros de datos, especialmente por aplicaciones de IA, se duplicará en cinco años, alcanzando el 3% del uso energético mundial. La IA será responsable de más de la mitad de este crecimiento. Algunos centros consumen ya tanta electricidad como 100.000 hogares, y en el futuro podrían multiplicar por 20 ese número.

Aunque se espera que para 2030 los centros usen un 50% de energía renovable, el resto provendrá de carbón, gas natural y energía nuclear, lo que plantea serios retos climáticos. No obstante, la AIE ve una oportunidad en la IA: puede optimizar redes eléctricas, mejorar la predicción del clima, detectar fugas o descubrir nuevos materiales sostenibles. Pero advierte que estos beneficios serán marginales si no se crean condiciones adecuadas desde los gobiernos.

El informe ha generado controversia. Críticos como Alex de Vries creen que la AIE subestima el consumo energético de la IA, que podría comprometer los objetivos climáticos. Otros, como Claude Turmes, ministro de Energía de Luxemburgo, acusan a la AIE de presentar una visión demasiado optimista y de favorecer intereses políticos y corporativos.

Algunas soluciones sostenibles ya existen, como la refrigeración por inmersión o el reaprovechamiento del calor de los centros de datos, pero deben escalarse rápidamente. Y, sobre todo, será clave usar la capacidad informática con más criterio.

Datos, información y conocimiento en el marco de la cultura impresa y la cultura digital: aproximaciones, tendencias y retos desde la perspectiva bibliotecológica

Datos, información y conocimiento en el marco de la cultura impresa y la cultura digital: aproximaciones, tendencias y retos desde la perspectiva bibliotecológica y los estudios de la información / coordinadores Eder Ávila Barrientos, Adriana Suárez Sánchez. – Primera edición. – Ciudad de México : Universidad Nacional Autónoma de México, Instituto de Investigaciones Bibliotecológicas y de la Información, 2

Texto completo

Este libro aborda la relación entre datos, información y conocimiento en el contexto de la cultura impresa y la cultura digital, desde una perspectiva bibliotecológica y de los estudios de la información. A través de once capítulos, expertos en el campo reflexionan sobre las transformaciones tecnológicas que han redefinido la gestión, organización y acceso a la información en las últimas décadas. La obra se estructura en cuatro secciones principales: Organización de la información y del conocimiento; Ciencia abierta, alfabetización digital y usuarios; Información y sociedad; y Archivos y recursos relacionados. Cada apartado analiza desafíos; y tendencias actuales. Se tratan temas como la gobernanza de datos; el uso de LRM, BIBFRAME y RDA para concebir al catálogo del futuro; la exclusión digital; el papel de los datos en el ejercicio ciudadano y la ciencia ciudadana; y la preservación del patrimonio documental, entre otros. Dirigido a estudiantes, docentes y profesionales de la información, este volumen ofrece una visión integral sobre cómo las tecnologías digitales están reconfigurando las prácticas bibliotecarias y archivísticas, al tiempo que plantea preguntas cruciales sobre el futuro de la gestión del conocimiento en un mundo cada vez más interconectado.