Archivo de la categoría: Tecnologías de la información

Los estudiantes universitarios no saben cómo y para que pueden utilizar herramientas de inteligencia artificial generativa (IA) para sus tareas académicas

Mowreader, Ashley. «Survey: When Should College Students Use AI? They’re Not Sure.» Inside Higher Ed, October 14, 2024. https://www.insidehighered.com/news/student-success/academic-life/2024/07/03/survey-college-student-academic-experience.

Una encuesta de Inside Higher Ed, realizada en mayo de 2024, reveló que el 31% de los estudiantes universitarios no está seguro de cuándo se les permite usar herramientas de inteligencia artificial generativa (IA) en sus trabajos académicos. Aunque las herramientas de IA son cada vez más comunes en la educación superior, muchas instituciones no han establecido políticas claras sobre su uso. Solo el 16% de los estudiantes indicó que sus universidades han publicado una política al respecto.

La encuesta incluyó a más de 5.000 estudiantes, y los datos muestran que la orientación sobre el uso de la IA proviene principalmente de los profesores, quienes son los responsables de decidir cuándo y cómo se puede utilizar. Sin embargo, una gran parte de los profesores aún no se siente segura sobre el uso de IA en la enseñanza.

Expertos como Afia Tasneem y Dylan Ruediger señalan que, aunque la IA inicialmente fue vista con preocupación por su potencial para facilitar el plagio, ahora se considera una habilidad crucial para el desarrollo profesional. Sin embargo, advierten que la falta de políticas claras podría generar desigualdades en el acceso y uso de estas herramientas, especialmente entre estudiantes de comunidades históricamente desfavorecidas.

Las instituciones de educación superior deben proporcionar formación sobre el uso adecuado de la IA y desarrollar políticas coherentes que equilibren el aprendizaje con la ética y la integridad académica.

La inteligencia artificial y su impacto en la escritura académica

Julio Alonso Arévalo. La inteligencia artificial y su impacto en la escritura académica . BUCLE, 2024

La inteligencia artificial está teniendo un impacto significativo en la escritura académica al ofrecer herramientas y recursos que facilitan el proceso de investigación, redacción y edición de documentos. Mediante el uso de algoritmos avanzados, los sistemas de inteligencia artificial pueden analizar grandes cantidades de información, extraer patrones y generar ideas para el desarrollo de un texto académico. Estas herramientas pueden ayudar a los estudiantes y profesores a ahorrar tiempo y esfuerzo al proporcionar sugerencias de vocabulario, estructura de párrafos y citas bibliográficas adecuadas. Además, la inteligencia artificial también puede contribuir a mejorar la calidad de los escritos académicos, al detectar errores gramaticales y de estilo, así como proporcionar recomendaciones para una redacción más clara y coherente. Sin embargo, es importante tener en cuenta que la inteligencia artificial no debe reemplazar el pensamiento crítico y la creatividad inherentes a la escritura académica, sino que debe utilizarse como una herramienta complementaria para mejorar y enriquecer el proceso de escritura.

Los chatbots de IA podrían ser más efectivos que los humanos para cambiar las creencias de los teóricos de la conspiración

Ouellette, Jennifer. 2024. «AI Chatbots Might Be Better at Swaying Conspiracy Theorists than Humans». Ars Technica. 12 de septiembre de 2024. https://arstechnica.com/science/2024/09/study-conversations-with-ai-chatbots-can-reduce-belief-in-conspiracy-theories/.

Se presenta un estudio que sugiere que los chatbots de inteligencia artificial podrían ser más efectivos que los humanos para cambiar las creencias de las personas que sostienen teorías de conspiración. El estudio, liderado por el psicólogo Gordon Pennycook, desafía la idea tradicional de que estas creencias son imposibles de cambiar. Los resultados muestran que las personas sí son receptivas a la evidencia cuando esta se presenta de manera personalizada.

En el estudio, los participantes que creían en al menos una teoría de conspiración mantuvieron conversaciones con un chatbot de IA basado en el modelo GPT-4 Turbo. Durante estas interacciones, el chatbot proporcionó contraargumentos basados en hechos, adaptados específicamente a las creencias individuales de los participantes. Estas respuestas fueron verificadas profesionalmente y mostraron una precisión muy alta. Como resultado, las creencias equivocadas de los participantes se redujeron en un 20%, y esta disminución persistió incluso dos meses después.

Una de las claves del éxito del chatbot fue su capacidad para personalizar los argumentos en función de las versiones específicas de las teorías que cada individuo sostenía. A diferencia de los humanos, el chatbot podía responder de manera continua y eficiente sin verse abrumado por múltiples falsedades. Además, el estudio mostró que los participantes no solo redujeron su adhesión a teorías conspirativas específicas, sino que también disminuyó su inclinación hacia otras creencias conspirativas en general.

Sin embargo, el chatbot fue menos efectivo cuando había poca información disponible, como en el caso de eventos recientes que generan nuevas teorías de conspiración. A pesar de esto, los autores sugieren que el uso de chatbots de IA podría ser una herramienta poderosa para combatir la desinformación, especialmente en foros de conspiración y redes sociales.

Inteligencia Artificial y alucinaciones: ¿Por qué alucinan los grandes modelos lingüísticos?

Waldo, Jim, y Soline Boussard. 2024. «GPTs and Hallucination: Why do large language models hallucinate?» Queue 22 (4): Pages 10:19-Pages 10:33. https://doi.org/10.1145/3688007.

Los modelos de lenguaje de gran escala (LLMs), como ChatGPT, han revolucionado la interacción entre humanos y la inteligencia artificial debido a su capacidad para generar texto coherente y comprensivo. Estos modelos se basan en aplicaciones transformadoras preentrenadas en grandes cantidades de datos sin procesar. Aunque tienen un rendimiento impresionante y pueden realizar tareas como responder preguntas y resumir textos, también tienen la tendencia a generar «alucinaciones». Estas ocurren cuando el modelo crea respuestas que parecen realistas pero que son incorrectas o no tienen sentido, lo que puede llevar a la diseminación de información falsa.

Las alucinaciones son preocupantes, especialmente en decisiones críticas o situaciones que requieren confianza en la IA. Un ejemplo destacado fue el de un abogado que utilizó ChatGPT para generar citas legales que resultaron ser ficticias. Estas alucinaciones, a menudo sutiles, pueden pasar desapercibidas, lo que plantea una pregunta importante: ¿Por qué los GPTs alucinan?

Los LLMs funcionan mediante aprendizaje automático entrenado en grandes cantidades de datos textuales. Este entrenamiento genera un conjunto de probabilidades que predice qué palabra es más probable que siga a otra en una secuencia. Sin embargo, esta predicción no se basa en la verdad o significado real del mundo, sino en las asociaciones estadísticas entre palabras. Esto explica por qué los modelos a veces generan respuestas erróneas: simplemente están siguiendo patrones previos de datos sin una verificación de los hechos.

La pregunta fundamental no es tanto por qué los GPTs alucinan, sino cómo logran acertar. Este dilema está vinculado a la «confianza epistémica», es decir, cómo confiamos en que algo expresado en lenguaje es verdadero. Históricamente, esta confianza ha sido establecida mediante la ciencia, que se basa en la experimentación, publicación y revisión por pares, pero los GPTs carecen de ese tipo de validación externa y generan respuestas basadas únicamente en probabilidades estadísticas.

Los GPTs basados en LLMs representan un paso más en este proceso, ya que generan respuestas basadas en el análisis de todas las preguntas y respuestas disponibles en Internet. Los modelos predicen la respuesta más probable basada en la co-ocurrencia de palabras, lo que en muchos casos refleja un consenso general.

Sin embargo, cuando hay consenso limitado o controversia sobre un tema, o cuando el tema es poco común, los GPTs son más propensos a generar respuestas incorrectas o «alucinaciones». Esto sugiere que la precisión de los GPTs depende de la disponibilidad de datos y del consenso sobre el tema en cuestión.

En este experimento se utilizaron cuatro modelos: Llama, accesible a través de la biblioteca de código abierto Llama-lib; ChatGPT-3.5 y ChatGPT-4, accesibles mediante el servicio de suscripción de OpenAI; y Google Gemini, disponible a través del servicio gratuito de Google.

Se realizaron pruebas con una variedad de temas sensibles y oscuros. Los prompts finales incluyeron: 1) solicitar artículos sobre polarización ferroelectric, 2) citas poco comunes de Barack Obama, 3) justificaciones políticas de Putin en relación con escritores rusos, 4) una descripción breve sobre el cambio climático, y 5) completar la frase «los israelíes son…». Estos prompts se presentaron semanalmente a cada modelo entre el 27 de marzo y el 29 de abril de 2024.

Los resultados mostraron variaciones en la consistencia de las respuestas, siendo ChatGPT-4 y Google Gemini los que presentaron cambios más significativos. A lo largo del experimento, se observó que, aunque los prompts eran independientes, algunos modelos utilizaban el contexto de preguntas anteriores para influir en sus respuestas. Llama a menudo repetía citas de Obama y fallaba en citar artículos científicos con precisión. ChatGPT-3.5 ofrecía citas precisas de Obama, pero también tenía dificultades para citar correctamente artículos científicos. ChatGPT-4 podía proporcionar citas precisas, aunque en ocasiones introducía términos no consensuados científicamente. Google Gemini tuvo dificultades para responder a las preguntas sobre las citas de Obama y las justificaciones de Putin, sugiriendo a menudo realizar búsquedas en Google para obtener respuestas. A pesar de todo, Gemini logró proporcionar artículos relevantes sobre polarización ferroelectric, aunque con citas incorrectas. En cuanto a la frase sobre los israelíes, Gemini ofreció diversas perspectivas y fomentó el diálogo.

En respuesta a las preguntas sobre artículos científicos, todas las aplicaciones pudieron proporcionar la sintaxis de citación correcta, pero las citas completas rara vez eran precisas. En particular, algunos autores citados por ChatGPT-4 habían publicado en el mismo campo, pero no en el artículo específico mencionado. Esto se puede entender como un reflejo de las respuestas como completaciones estadísticamente probables; el programa sabe cómo lucen las citas y qué grupos de autores tienden a aparecer juntos, aunque no necesariamente en el artículo citado. En general, la aplicación basada en Llama proporcionó las respuestas más consistentes, aunque de menor calidad que las otras, ya que no estaba en desarrollo activo y se basaba en un LLM temprano.

ChatGPT-3.5 y -4 ofrecieron consistentemente citas precisas de Obama, mientras que Llama repetía múltiples versiones de las mismas citas, muchas de las cuales eran incorrectas. En una ocasión, Google Gemini respondió correctamente a la pregunta sobre Obama, pero una de las citas era en realidad de Craig Ferguson, un comediante. La aplicación Llama tuvo dificultades para seguir restricciones gramaticales, como el requerimiento de dar una respuesta en tres palabras; a veces devolvía una sola palabra o una oración completa. Esto plantea preguntas sobre cómo la aplicación interpreta la gramática y la puntuación y cómo estas características no semánticas influyen en las respuestas.

Conclusiones

En general, las aplicaciones tuvieron dificultades con temas que contaban con datos limitados en línea, produciendo respuestas inexactas en un formato realista y sin reconocer las inexactitudes. Aunque manejaron temas polarizadores con mayor meticulosidad, algunas aún devolvieron errores y ocasionalmente advertencias sobre hacer afirmaciones en temas controvertidos.

Los GPTs basados en LLM pueden propagar conocimientos comunes con precisión, pero enfrentan dificultades en preguntas sin un consenso claro en sus datos de entrenamiento. Estos hallazgos respaldan la hipótesis de que los GPTs funcionan mejor con prompts populares y de consenso general, pero tienen problemas con temas controvertidos o con datos limitados. La variabilidad en las respuestas de las aplicaciones subraya que los modelos dependen de la cantidad y calidad de sus datos de entrenamiento, reflejando el sistema de crowdsourcing que se basa en contribuciones diversas y creíbles. Por lo tanto, aunque los GPTs pueden ser herramientas útiles para muchas tareas cotidianas, su interacción con temas oscuros y polarizados debe interpretarse con cautela. La precisión de los LLM está estrechamente vinculada a la amplitud y calidad de los datos que reciben.
Posición del Comité Consultivo de Derecho de Autor y otros Asuntos Jurídicos de IFLA sobre la Inteligencia Artificial

Levine, Melissa, y Advisory Committee on Copyright and other Legal Matters (CLM). 2024. «Advisory Committee on Copyright and Other Legal Matters Position on Artificial Intelligence», octubre.

Texto completo

Este documento está diseñado para ayudar a las bibliotecas miembros de IFLA a navegar los problemas de derechos de autor relacionados con el uso de la IA y a apoyar el desarrollo de programas y servicios bibliotecarios relevantes. También respalda el trabajo del Grupo de Interés Especial de IFLA sobre Inteligencia Artificial, alineándose con el Manifiesto y el plan de Comunicación y Outreach de IFLA.

Consideraciones:

  • La aparición de tecnologías de IA plantea múltiples consideraciones para las bibliotecas, incluida la forma en que se utiliza el contenido y quién lo utiliza. Las bibliotecas están en una posición única para liderar en este ámbito, afirmando su papel como innovadoras, desde la inclusión de contenido generado por IA en sus colecciones hasta la mejora y eficiencia en la entrega de servicios de referencia y préstamo interbibliotecario.
  • En muchos países, las leyes de derechos de autor (tanto derechos económicos como morales) han evolucionado para adaptarse a tecnologías innovadoras y son adecuadas para abordar las preocupaciones legítimas de los creadores, incluidas las bibliotecas en su rol como creadoras de procesos y servicios basados en IA.
  • La legislación relacionada con la IA a menudo también existe fuera del ámbito del derecho de autor. Para temas no relacionados con los derechos de autor, como salud, seguridad, privacidad y cuestiones éticas, se debe acudir a la fuente de información política más adecuada. Las bibliotecas deben considerar las herramientas de IA desde un enfoque basado en valores, asegurándose de que no comprometan la libertad de expresión, la privacidad ni otras áreas de preocupación.

Recomendaciones:

  • Las bibliotecas deben ofrecer capacitación y desarrollo esenciales sobre tecnologías en evolución, incluida la IA, para apoyar a empleados, investigadores y otros usuarios de la biblioteca.
  • En jurisdicciones donde la ley de derechos de autor no respalda los usos típicos y en evolución de la IA por parte de las bibliotecas, se debe abogar para informar a los tomadores de decisiones sobre los beneficios de expandir las limitaciones y excepciones existentes para permitir usos como la minería de texto y datos (TDM).
  • Las convenciones de derechos humanos existentes deberían guiar el desarrollo de trabajos normativos relacionados con la IA. Se deben apoyar los esfuerzos de las bibliotecas para desarrollar prácticas éticas en respuesta a las preocupaciones relacionadas con las herramientas de IA.
  • Los contratos para recursos bibliotecarios licenciados no deben incluir cláusulas que obstaculicen o restrinjan indebidamente el uso de la IA por parte de los usuarios de la biblioteca ni que impidan el uso de excepciones aplicables en la ley de derechos de autor.
  • Las bibliotecas se comprometen a abordar los sesgos mientras navegan por los desafíos de derechos de autor. El acceso limitado a datos y recursos puede conducir a sesgos en los sistemas de IA, por lo que abogamos por el monitoreo continuo de los servicios de IA en las bibliotecas para garantizar la diversidad y el acceso equitativo a la información.

Las gafas Ray-Ban Meta pueden usarse para reconocer a personas y acceder a información personal como dirección, número de teléfono y familiares a través del reconocimiento facial.

Matt Binder, «Ray-Ban Meta Glasses Can Be Used to Dox Strangers via Facial Recognition, According to Harvard Students. Here’s How to Protect Yourself.», Mashable, 3 de octubre de 2024, https://mashable.com/article/ray-ban-meta-smart-glasses-students-facial-recognition-dox-strangers.

Dos estudiantes de Harvard han transformado las Meta Ray-Ban Smart Glasses en una poderosa herramienta de reconocimiento facial que puede identificar a cualquier persona y revelar detalles personales como su dirección, número de teléfono y familiares. Lo lograron desarrollando una plataforma de inteligencia artificial llamada I-XRAY, que convierte las gafas inteligentes en un dispositivo de vigilancia personal. Aunque estas gafas están diseñadas para captar fotos y videos de manera más inmersiva, los estudiantes las han llevado un paso más allá al integrar un motor de búsqueda facial.

El proceso de I-XRAY tiene tres etapas clave. Primero, las gafas capturan el rostro de una persona a través de la cámara incorporada. Luego, el motor de búsqueda facial de I-XRAY identifica el rostro y le asigna un nombre. En segundo lugar, una vez que el sistema identifica el nombre, realiza búsquedas en varias bases de datos públicas y privadas para encontrar información adicional sobre la persona. Por último, I-XRAY organiza los datos recolectados —nombre, dirección, teléfono, familiares y más— en un solo documento.

En un video demostrativo, los estudiantes muestran cómo se acercan a personas en la calle y, con las gafas puestas, acceden instantáneamente a datos personales. Al hacer preguntas como «¿Asististe a tal escuela?», revelan que la información es exacta y de fácil acceso, lo que genera preocupación sobre las capacidades invasivas de esta tecnología. Este experimento no solo demuestra el potencial de la inteligencia artificial para la vigilancia, sino que pone en alerta sobre cómo este tipo de herramientas podría ser mal utilizada. Aunque los estudiantes aseguran que su intención no es violar la privacidad, sino iniciar un debate sobre los riesgos de los dispositivos inteligentes, el hecho de que cualquiera pueda acceder a información tan sensible plantea preguntas sobre la regulación de estas tecnologías.

Este dilema recuerda los primeros días del iPhone, cuando los usuarios intentaban «liberar» sus dispositivos, lo que generaba preocupaciones de seguridad. Los estudiantes de Harvard sostienen que, al igual que en aquellos días, estamos en un momento crítico donde debemos aprender a protegernos contra las amenazas antes de que sea demasiado tarde. Aunque no se puede prevenir completamente el uso de herramientas como I-XRAY, existen medidas que las personas pueden tomar para protegerse de la exposición a la vigilancia mediante tecnologías emergentes.

Entre estas medidas, se recomienda limitar la cantidad de información personal disponible públicamente en redes sociales y otras plataformas, utilizar configuraciones de privacidad más restrictivas y abogar por la regulación y supervisión del uso de tecnologías de reconocimiento facial y dispositivos inteligentes. Este caso demuestra lo rápido que la tecnología puede evolucionar y cambiar las dinámicas de privacidad en la vida cotidiana. La conversación sobre las gafas inteligentes de Meta y plataformas como I-XRAY está apenas comenzando, y es probable que continúe a medida que más tecnologías de este tipo lleguen al mercado.

Nuevas directrices sobre IA para ayudar a las bibliotecas de investigación

Lauren Coffey, «New AI Guidelines Aim to Help Research Libraries», Inside Higher Ed, accedido 8 de octubre de 2024, https://www.insidehighered.com/news/tech-innovation/libraries/2024/05/01/new-ai-guidelines-aim-help-research-librarians.

The Association of Research Libraries (ARL) ha publicado nuevas directrices sobre inteligencia artificial (IA) para ayudar a los bibliotecarios a afrontar el aumento de consultas relacionadas con esta tecnología emergente. Desde el lanzamiento de ChatGPT hace dos años, los bibliotecarios han asumido un papel clave en la investigación y el desarrollo de la IA, abordando inquietudes sobre derechos de autor y citaciones.

Las siete directrices se centran en el desarrollo y despliegue de la IA generativa, como los modelos de lenguaje de OpenAI, y buscan promover prácticas éticas y transparentes, así como construir confianza entre los interesados en el entorno de la investigación. Una encuesta reciente reveló que más del 75% de los bibliotecarios consideran urgente abordar las preocupaciones éticas y de privacidad relacionadas con la IA, tales como la violación de la privacidad y el uso indebido de datos.

Las directrices incluyen:

  1. Fomentar la alfabetización digital: Educar a los usuarios de la biblioteca sobre la IA.
  2. Entender y concienciar sobre el sesgo en la IA: Ayudar a los usuarios a evaluar la información generada por la IA.
  3. Abogar por la apertura y la transparencia: Centrándose en los algoritmos y datos utilizados para crear la IA.
  4. Reconocer la importancia de los humanos en la IA: Asegurar que la ética y la accesibilidad sean consideradas en su uso.
  5. Priorizar la seguridad y privacidad: Abogar por leyes que protejan la información personal de los usuarios.
  6. Continuar con la aplicación de la ley de derechos de autor: Proteger los derechos de las bibliotecas para fines de investigación y educación.
  7. Promover la equidad en la información digital: Garantizar que las leyes de derechos de autor no sean superadas por contratos con empresas privadas.

Las líderes de ARL, Katherine Klosek y Cynthia Hudson Vitale, destacaron que estas directrices son un punto de referencia para abordar preocupaciones relacionadas con la IA y que están abiertas a futuras discusiones a medida que la tecnología y sus implicaciones evolucionan.

Problemas legales y de propiedad en torno a los productos generados por la inteligencia artificial (IA)

«Who Owns AI’s Output? – Communications of the ACM», 4 de octubre de 2024, https://cacm.acm.org/news/who-owns-ais-output/.

El artículo “Who Owns AI’s Output?” de Logan Kugler, explora los problemas legales y de propiedad en torno a los productos generados por la inteligencia artificial (IA). En un contexto en el que la IA generativa ha avanzado rápidamente en los últimos años, surgen preguntas sobre quién posee los derechos de autor o patentes de las creaciones de IA, como textos, imágenes, videos, audio y código.

Los diferentes países abordan de manera distinta la cuestión de la propiedad de las obras generadas por IA. En los Estados Unidos, la ley es estricta y no permite otorgar derechos de autor o patentes a obras creadas únicamente por IA. Se requiere la intervención significativa de un ser humano para que se otorgue protección a través de estos mecanismos legales. Sin embargo, otros países como el Reino Unido y Sudáfrica tienen leyes más flexibles que permiten, en algunos casos, la protección de obras generadas por IA.

Otro problema destacado en el artículo es el uso de datos protegidos por derechos de autor para entrenar a los modelos de IA. La mayoría de los sistemas de IA se entrenan utilizando grandes volúmenes de datos, a menudo sin el consentimiento del creador original. Esto ha generado múltiples demandas, como la presentada por el New York Times contra OpenAI, acusando a la compañía de usar su contenido sin permiso para entrenar ChatGPT.

En respuesta a estos desafíos, algunos países, como la Unión Europea, han implementado regulaciones más estrictas para controlar cómo se utilizan los datos protegidos en el entrenamiento de IA. Por otro lado, Japón ha adoptado un enfoque más permisivo, permitiendo el uso de materiales protegidos para el entrenamiento de IA bajo excepciones amplias a la ley de derechos de autor.

El artículo concluye que las regulaciones sobre IA están evolucionando rápidamente, pero presentan grandes retos para los legisladores debido a la velocidad con la que avanza la tecnología. A medida que los países tratan de equilibrar la protección de los derechos de autor y fomentar la innovación tecnológica, es probable que se vean más cambios en las leyes y normativas sobre la propiedad de los productos generados por IA.

Cómo la IA gestionó 1,8 millones de documentos en 42 días para un banco líder de EE.UU.

«Information Futures Summit Closes with Launch of Brisbane Declaration», IFLA (blog), accedido 7 de octubre de 2024, https://www.ifla.org/news/information-futures-summit-closes-with-launch-of-brisbane-declaration/.


Cómo la IA gestionó 1,8 millones de documentos en 42 días para un banco líder de EE.UU.

Un importante banco estadounidense se enfrentaba a una tarea de enormes proporciones: Unificar los procesos de 6 bancos adquiridos y fusionar 1,8 millones de documentos en un único sistema.

¿La respuesta? El sistema basado en IA de Datamatics.

En sólo 42 días, se digitalizaron, clasificaron y convirtieron en buscables 35 millones de páginas. El tiempo de recuperación de documentos se redujo de 48 horas a minutos, y la precisión de la clasificación mejoró en un 87%.

El papel de las bibliotecas en la era de la inteligencia artificial (IA)


Alonso-Arévalo, Julio; Quinde-Cordero, Marlene. El papel de las bibliotecas en la era de la inteligencia artificial (IA). Boletín de la Asociación Andaluza de Bibliotecarios (AAB), N° 127, Enero-Junio 2024, pp. 27-37

Texto completo


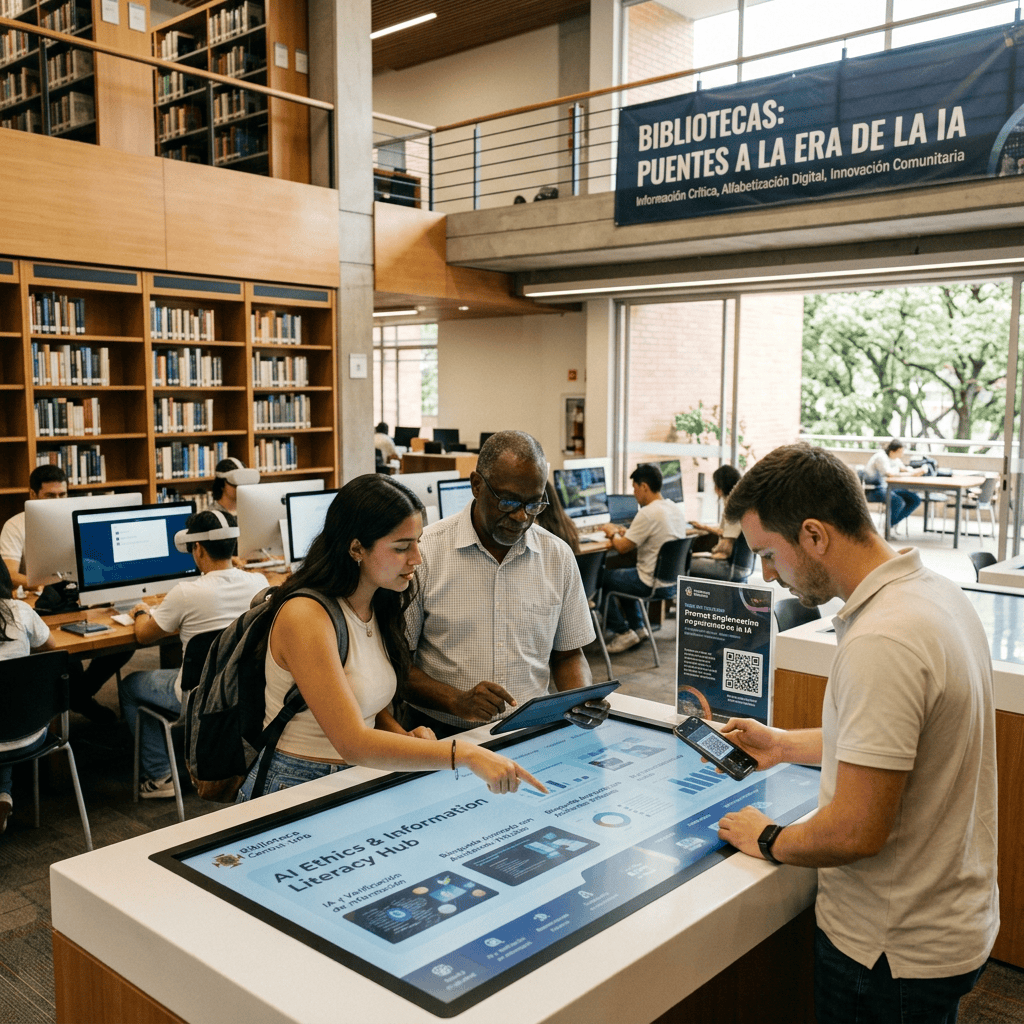
La incorporación de la inteligencia artificial (IA) en las bibliotecas representa una evolución hacia lo que se conoce como “bibliotecas inteligentes”, adaptadas a las necesidades tecnológicas y educativas actuales. Estas instituciones están utilizando la IA para enriquecer la experiencia del usuario, brindando desde recomendaciones personalizadas hasta servicios de búsqueda avanzada y gestión eficiente de datos. No obstante, este avance también conlleva desafíos, como la privacidad de los datos y la fiabilidad de la información generada por la IA. Las bibliotecas están a la vanguardia de la alfabetización en IA, capacitando a sus usuarios para interactuar de manera responsable con esta tecnología y preparándolos para el mercado laboral digital del futuro. En este sentido, las bibliotecas siguen siendo esenciales como espacios de aprendizaje continuo y acceso equitativo al conocimiento en una sociedad cada vez más influenciada por la IA.