Archivo de la categoría: Investigación

Las colecciones cómo datos: de la biblioteca digital a los conjuntos de datos abiertos

9306647851_fa6abd0a57_b


Wittmann, R., Neatrour, A., Cummings, R., & Myntti, J. (2019). From Digital Library to Open Datasets. Information Technology and Libraries, 38(4), 49-61. https://doi.org/10.6017/ital.v38i4.11101

Texto completo


Este artículo analiza el floreciente movimiento de «colecciones como datos» dentro de los campos de las bibliotecas digitales y las humanidades digitales. Los profesores de la Biblioteca Marriott de la Universidad de Utah están desarrollando una colección como estrategia de datos al aprovechar los programas existentes de Biblioteca Digital y Asuntos Digitales. Al seleccionar varias colecciones digitales, se exploran enfoques a pequeña y gran escala para desarrollar conjuntos de datos abiertos. Se revisan cinco estudios de caso que relatan esta estrategia, junto con la prueba de los conjuntos de datos utilizando diversos métodos de humanidades digitales, como minería de texto, modelado de temas y SIG (sistema de información geográfica).

Los bibliotecarios utilizan un enfoque de hackatón en los sprints de investigación

research-sprints


Ready, Set, Research!: Librarians use hackathon-like approach with research sprints. Amercian Libraries. By Timothy Inklebarger | December 3, 2019

Texto completo


Una hackathon o hackatón, es un término usado en las comunidades hacker para referirse a un encuentro de programadores cuyo objetivo es el desarrollo colaborativo de software, aunque en ocasiones puede haber también un componente de hardware. Estos eventos pueden durar entre dos días y una semana. El objetivo es doble: por un lado hacer aportes al proyecto de software libre que se desee y, por otro, aprender sin prisas. El término integra los conceptos de maratón y hacker, aludiendo a una experiencia colectiva que persigue la meta común de desarrollar aplicaciones de forma colaborativa en un lapso corto. Se cree que el término fue creado en 1999 de forma independiente por los desarrolladores del OpenBSD y el equipo de marketing de Sun Microsystems.


Los sprints o carreras de investigación adoptan el mismo enfoque, pero con bibliotecarios que conectan a los estudiantes y al profesorado con expertos en sus diversos campos que pueden, en cortos períodos de tiempo, resolver problemas de investigación que de otro modo podrían llevar meses o años.

Diana Perpich, especialista en tecnología académica de la Universidad de Michigan (U-M), dice que su biblioteca comenzó a organizar carreras académicas en el verano de 2018 y que ha abordado una amplia variedad de temas de investigación, incluyendo la exploración del impacto de la tecnología de reconocimiento facial en las comunidades de color, el desarrollo de un sistema de gestión de datos para la información sobre el agua potable pública y la creación de una guía para que los académicos protejan su anonimato a la vez que investigan en la red oscura.

Los proyectos a menudo requieren datos de una amplia gama de fuentes, y encontrar la colección correcta puede ser clave para hacer avanzar en la investigación. Caitlin Pollock, especialista en investigación digital de la Biblioteca de la Universidad de Michigan, dice que es común que los estudiantes no sepan a dónde acudir para encontrar la experiencia o guía correcta. En este sentido los bibliotecarios pueden ser fundamentales ya que ayudan a resolver más rápidamente los obstáculos que deben superar para que la investigación avance más rápidamente.

El papel de la biblioteca es fundamental para anunciar y difundir el programa para fomentar una mayor participación. La biblioteca también trabaja para determinar si los proyectos en los que los bibliotecarios e investigadores podrían ayudar también contribuirán a su desarrollo profesional.


Las revisiones por pares no profesionales perjudican desproporcionadamente a los grupos subrepresentados

peer-reviews-1-638

Silbiger, Nyssa J. ; Stubler, Amber D. Peer Reviews Disproportionately Harm Underrepresented Groups in STEM. PeerJ  7 : e8247
DOI: 10.7717 / peerj.8247

Texto completo

La investigación revisada por pares es fundamental para el avance de la ciencia. Idealmente, el proceso de revisión por pares es una evaluación imparcial y justa del mérito científico y la credibilidad de un estudio; sin embargo, surgen sesgos bien documentados en todos los métodos de revisión por pares. Se ha demostrado que los sesgos sistémicos tienen un impacto directo en los resultados de la revisión por pares, pero se sabe poco sobre los impactos posteriores de los comentarios de revisores no profesionales que se comparten con los autores.

Métodos

En una encuesta anónima de participantes internacionales en los campos de ciencia, tecnología, ingeniería y matemáticas (STEM), se investigó la omnipresencia y las percepciones de los autores de las implicaciones a largo plazo sobre la recepción de comentarios no profesionales. Específicamente, se evaluó las percepciones de los autores sobre la aptitud científica, la productividad y la trayectoria profesional después de recibir una revisión por pares no profesional.

Resultados

Los encuestados clasificados en cuatro categorías por género y raza / etnia recibieron comentarios no profesionales de revisión por pares por igual. Sin embargo, los grupos tradicionalmente subrepresentados en los campos STEM tenían más probabilidades de percibir impactos negativos en la aptitud científica, la productividad y el avance profesional después de recibir una revisión por pares no profesional.

Discusión

Los estudios muestran que una percepción negativa de aptitud conduce a una disminución de la confianza en uno mismo, interrupciones a corto plazo en el éxito y la productividad y retrasos en el avance profesional. Por lo tanto, estos resultados indican que las revisiones no profesionales probablemente han perpetuado y continuarán perpetuando la brecha en los campos STEM para grupos tradicionalmente subrepresentados en las ciencias.

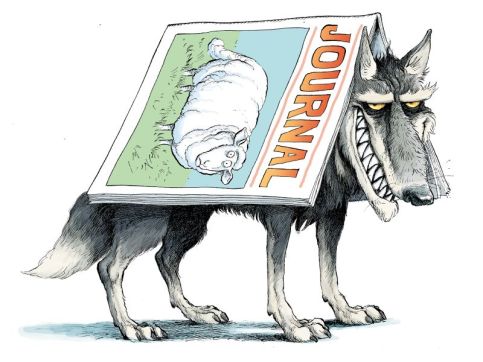
Nueva definición de revista depredadora para luchar contra este tipo de prácticas

d41586-019-03759-y_17468170

Predatory journals: no definition, no defence. Nature 11 dic, 2019

Documento

Todos estamos de acuerdo en que los editores depredadores siembran confusión, promueven la investigación de mala calidad y desperdician los recursos financieros. Lo que se necesita es un consenso sobre una definición de revistas depredadoras. Esto proporcionaría un punto de referencia para la investigación sobre su prevalencia e influencia, y ayudaría a elaborar intervenciones coherentes.


Las revistas depredadoras son una amenaza global. Aceptan artículos para publicación, junto con los honorarios de los autores, sin realizar las comprobaciones de calidad prometidas para cuestiones como el plagio o la aprobación ética. Los lectores ingenuos no son las únicas víctimas. Muchos investigadores son engañados para que publiquen en revistas depredadoras, en las que no se revisa o se hace una revisión muy por encima de los trabajos. Un estudio a 46.000 investigadores con de Italia encontró que alrededor del 5% de ellos publicaron en estas revistas. Los editores depredadores recaudan millones de dólares en tarifas de publicación que finalmente pagan las instituciones financiadoras

Aquí se presenta la definición de revista depredadora:

“Las publicaciones y editoriales depredadoras son entidades que priorizan el interés propio a expensas de la investigación, y se caracterizan por contener información falsa o engañosa, desviación de las mejores prácticas editoriales y de publicación, falta de transparencia y / o uso de prácticas de solicitud agresivas e indiscriminadas «.

Para lograr tal consenso y encontrar soluciones, se celebró un encuentro en Ottawa, Canadá, durante dos días en abril de este año. Los 43 participantes provenían de 10 países y representaban a sociedades editoriales, financiadores de investigaciones, investigadores, formuladores de políticas, instituciones académicas, bibliotecas y otros socios (es decir, asociaciones de pacientes y cuidadores que participan activamente en la investigación) provenientes del ámbito de las ciencias biomédicas, aunque las recomendaciones que se hicieron eran de aplicación general.


Servicios de gestión de datos de investigación en bibliotecas universitarias: ¿Dónde estamos?


2019-12-12_16-30-15


Tenopir, Carol ; Kaufman, Jordan; Sandusky, Robert ; Pollock, Danielle. “Research Data Services in Academic Libraries: Where are We Today?” New White Paper From Choice. Choice, 2019

Texto completo


Como unidad editorial de la ACRL, Choice apoya el trabajo y el el desarrollo profesional de los bibliotecarios universitarios mediante el suministro de herramientas y servicios que les ayuden a convertirse en más eficaces para sus usuarios. lo largo de sus más de cincuenta años de historia, se ha establecido como un fuente autorizada para la evaluación de recursos académicos y como editor de investigaciones confiables en las áreas de interés para una comunidad bibliotecaria académica cambiante.

Para determinar hasta qué punto los servicios de datos de investigación (RDS) están respaldados por las bibliotecas universitarias y conocer que cambios se han producido en este tema en la última década, en 2019 un equipo de investigación dirigido por Carol Tenopir del Centro de Estudios de Información y Comunicación de la Universidad de Tennessee, en colaboración con ACRL-Choice, encuestó a directores de bibliotecas universitarias de Estados Unidos y Canadá. Esta encuesta permitió comparar los resultados con una encuesta similar realizada en 2012. El objetivo de ambos estudios era descubrir los tipos de servicios de datos ofrecidos, la dotación de personal desplegada o prevista para estos servicios, la formación necesaria para apoyar la gestión de datos de investigación y los planes de para el futuro.

En los últimos siete años transcurridos desde que se realizó la encuesta han aparecido nuevas tecnologías, nuevas herramientas, y las nuevas perspectivas sobre la gestión y el acceso a los datos que han cambiado el panorama de la gestión de datos durante este período. El trabajo documenta no solo los cambios estadísticos en los servicios de datos, si no que además, ofrece una evaluación cualitativa de los impedimentos para avanzar en los servicios de datos de investigación (RDS)

¿Cómo se han posicionado las bibliotecas universitarias en este entorno en evolución? ¿Qué progresos se han hecho con respecto a los objetivos identificados en la encuesta original? Aquí tenemos algunas de las conclusiones del informe de 2019:

  • Cada vez más bibliotecas universitarias siguen ofreciendo servicios de datos de investigación informativos y consultivos (RDS) (como la creación de guías web o la consulta de planes de gestión de datos) que servicios técnicos y prácticos (como el mantenimiento de repositorios de datos o la creación de metadatos para conjuntos de datos).
  • Las bibliotecas de las universidades que ofrecen enseñanza de doctorado tienen más probabilidades de ofrecer servicios de datos de investigación (RDS) informativos.
  • De las bibliotecas que actualmente ofrecen RDS técnico/práctico, la mayoría de ellas comenzaron a ofrecer este servicio en los últimos tres años.
  • El tipo de servicio informativo más popular que ofrecen todos los tipos de instituciones es el de soporte de referencia, seguido de la creación de guías web.
  • Generalmente los centros y bibliotecas asociados al bachillerato y maestría ofrecen RDS técnico/práctico.
  • Las universidades están participando directamente con los investigadores en un proyecto o equipo para proporcionar servicios RDS.
  •  Las instituciones de investigación y doctorado ofrecen más apoyo técnico a los RDS. Todos los tipos de instituciones planean identificar los datos o conjuntos de datos que podrían añadirse a los repositorios.
  • Las bibliotecas de todos los tipos de instituciones tienen previsto identificar más datos o conjuntos de datos que se depositarán en repositorios temáticos o institucionales.
  • El 44.1% de las bibliotecas que respondieron no están involucradas en ningún proyecto de RDS,  debido a uno o más de los siguientes factores: financiación insuficiente, tiempo insuficiente, falta de interés por parte del profesorado, y  falta de personal.
  • Es más probable que las bibliotecas de las instituciones más grandes tengan bibliotecarios/especialistas dedicados a servicios RDS.
  • Las instituciones de investigación están contratando nuevo personal a medida que crece la necesidad de RDS en sus instituciones.


El acuerdo de Elsevier con Francia decepciona a los defensores del acceso abierto

library_1280p

National license agreement sees Elsevier support France’s open science objectives

Texto del acuerdo

El gigante de la edición científica  Elsevier ha firmado un acuerdo de licencia nacional con Couperin, elconsorcio de universidades y organizaciones de investigación francés, pero los críticos dicen que no es suficiente para avanzar en el acceso abierto (OA) a los artículos de revistas científicas. Sus términos están en desacuerdo con el Plan S, un mandato para poner inmediatamente de manera gratuita las publicaciones a partir de 2021, que la  Agencia Nacional de Investigación francesa ha respaldado.

El acuerdo de 4 años incluye un descuento en los costos de suscripción, reduciéndolos a los niveles de 2009 para fines de 2022. El gobierno francés dice que el acuerdo, que es retroactivo a enero, ahorrará 1,5 millones de dólares este año. El acuerdo no establece que todos los artículos se publiquen inmediatamente en Acceso Abierto; en cambio, incluye un descuento del 25% en los cargos que los investigadores pagan si eligen publicar artículos individuales en OA. “ Por primera vez, hay una disminución de los gastos, y es un tema muy importante”, dice un portavoz del Ministerio de Investigación de Francia

Pero los críticos están en desacuerdo con la forma en que los investigadores pagan la tarifa por tener sus documentos en OA. El acuerdo dice que estos documentos serían de lectura gratuita, alojados en los servidores de Elsevier 1 año después de la publicación. Esto es más largo que el embargo de 6 meses definido en la ley francesa de 2016. El gobierno francés dice que el acuerdo no infringe la ley, lo que otorga a los autores el derecho de hacer que sus documentos estén disponibles gratuitamente en un archivo en línea después de 6 meses, pero no obliga a los editores a hacerlo.


Alfabetización informacional en gestión de datos de investigación

51sjjqnk1fl._sx349_bo1204203200_

Carlson, J. and L. Johnston (). [e-Book] Data Information Literacy. Indiana: Purdue University Press, 2015.

Texto completo

Dada la creciente atención que se presta a la gestión, publicación y preservación de los conjuntos de datos de investigación como activos académicos, ¿qué competencias en el trabajo con datos de investigación necesitarán los estudiantes graduados en disciplinas STEM para tener éxito en sus campos? ¿Y qué papel pueden desempeñar los bibliotecarios para ayudar a los estudiantes a alcanzar estas competencias? Al abordar estas preguntas, este libro articula una nueva área de oportunidad para los bibliotecarios y otros profesionales de la información, desarrollando programas educativos que introducen a los estudiantes de postgrado a los conocimientos y habilidades necesarios para trabajar con datos de investigación. El término «alfabetización en información de datos» se ha adoptado con la intención deliberada de vincular dos funciones emergentes para los bibliotecarios. Al considerar los conocimientos básicos en materia de información y los servicios de datos como actividades complementarias y no separadas, los contribuyentes tratan de aprovechar los progresos realizados y las lecciones aprendidas en cada área de servicio.

GetFTR: nuevo servicio de editores para agilizar el acceso a los artículos investigación

ek3gdkpwoair9ky

GetFTR (Get Full Text Research).

Acceso

GetFTR es un servicio desarrollado por editoriales líderes que las herramientas de descubrimiento y las plataformas académicas de hoy en día pueden usar para optimizar el acceso de los usuarios a la investigación, ya sea suscripción o acceso abierto. Aunque ha sido recibido con preocupación por parte del sector bibliotecario debido a la privacidad y a la exclusión de la biblioteca en el proyecto.


Get Full Text Research (GetFTR) es una nueva solución gratuita que permite a los investigadores un acceso más rápido a los artículos publicados que necesitan. Trabajando dentro y fuera del campus y basándose en tecnología confiable.

GetFTR intenta reducir la distancia entre el descubrimiento y el acceso a través de un nuevo tipo de servicio de enlace de datos. Cuando los investigadores están utilizando herramientas en línea para buscar investigación, GetFTR proporcionará vías de acceso perfectas para los artículos publicados que deseen. Los investigadores podrán vincular directamente a la versión más actualizada y mejor de un artículo. Para crear una experiencia fluida, los investigadores serán llevados directamente al artículo, y solo al artículo, desde una amplia variedad de herramientas de descubrimiento que ya están utilizando. Incluso si un investigador no tiene el acceso institucional relevante a un artículo, los editores pueden proporcionar una versión alternativa del contenido. Es importante destacar que GetFTR permite a los usuarios acceder al contenido de esta manera tanto fuera del campus como dentro del campus para ayudar a maximizar sus beneficios para la comunidad de investigación.

Desarrollado por un grupo de cinco de las editoriales más grandes, y construido sobre el servicio Seamless Access de RA21, GetFTR se mantuvo en secreto hasta el anuncio formal hace unas semanas.

El servicio GetFTR utiliza el método de acceso federado bien establecido para permitir la visualización del indicador GetFTR y el camino continuo del usuario hacia la investigación. El acceso federado a veces se denomina ‘Inicio de sesión único’, ‘Shibboleth y OpenAthens’ o ‘Autenticación basada en SAML’. Es un método de autenticación en el que el usuario indica su afiliación institucional y utiliza sus credenciales institucionales para autenticarse.

Se espera que GetFTR entre en funcionamiento a principios de 2020.

Tres plataformas académicas y herramientas de descubrimiento:Mendeley, ReadCube Papers y Dimensions, han acordado probar GetFTR en el primer trimestre de 2020, permitiendo la experimentación en un entorno en vivo, aprendiendo más de los usuarios y refinando el servicio.

GetFTR ofrece beneficios claros para editores e investigadores. Un enlace directo a una copia con derechos de acceso conocidos es muy útil. Sin embargo, entre algunos sectores profesionales cono los bibliotecarios el anuncio no ha sido muy bienvenido y existe cierta preocupación. La preocupación deriva del proyecto predecesor, de Seamless Access, denominado RA21, que planteó muchas preocupaciones relacionadas con el control y la privacidad de los datos del usuario y el futuro del soporte del editor para la autenticación basada en proxy e IP. Además de que al desarrollar GetFTR, no sólo los editores excluyeron a las bibliotecas de la asociación, sino que también algunos pudieron haber excluido las relaciones internas de los líderes con la biblioteca, así como sus consejos de asesoramiento de la biblioteca.

Guía para principiantes sobre la ciencia de datos


787de5aae7b9a5ced13c1219f7fccea2


A Beginner’s Guide To Data Science: Start your self-learning journey into the world of data right now. 

Oleksii Kharkovyna

Ver completo

Cuando Aristóteles y Platón estaban debatiendo apasionadamente si el mundo es material o ideal, ni siquiera adivinaron el poder de los datos. En la actualidad, los datos dominan el mundo y la Ciencia de los Datos va ganando terreno, aceptando los retos del tiempo y ofreciendo nuevas soluciones algorítmicas. No es de extrañar, ya que cada vez resulta más atractivo no sólo observar todos esos movimientos, sino también formar parte de ellos.

Sin embargo,casi todos somos unos recién llegados a esta materia, ¿Eso significa que tenemos  un largo camino por recorrer para ser un experto? ¿Es necesario pasar por toda una serie de intentos y fracasos antes de alcanzar la confianza total en este trabajo? Probablemente, sí. Pero con este post, se trata de facilitar esta tarea. La forma más efectiva de aprender con los pasos más necesarios.

Paso 0. ¿Qué es qué?

Bueno, en términos generales, la ciencia de datos no es un ámbito determinado o único, es como una combinación de varias disciplinas que se centran en el análisis de datos y la búsqueda de las mejores soluciones basadas en ellos. Inicialmente, esas tareas eran realizadas por especialistas en matemáticas o estadística, pero luego los expertos en datos comenzaron a utilizar el aprendizaje automático y la inteligencia artificial, lo que agregó la optimización y la informática como un método para analizar los datos. Este nuevo enfoque resultó ser mucho más rápido y eficaz, por lo que fue muy popular.

Por lo tanto, la popularidad de la ciencia de datos radica en el hecho de que abarca la recopilación de grandes conjuntos de datos estructurados y no estructurados y su conversión a un formato legible por el ser humano, incluyendo la visualización, el trabajo con métodos estadísticos y analíticos – aprendizaje automático y profundo, análisis de probabilidades y modelos predictivos, redes neuronales y su aplicación para la resolución de problemas reales.

Inteligencia Artificial, Aprendizaje Automático, Aprendizaje Profundo y Ciencia de Datos – indudablemente, estos términos principales son los más populares hoy en día. Y aunque de alguna manera están relacionados, no son lo mismo. Así que, antes de pasar a la siguiente etapa, es obligatorio diferenciarlos.

  • La Inteligencia Artificial es el ámbito que se centra en la creación de máquinas inteligentes que funcionan y reaccionan como los humanos. El estudio de la IA se remonta a 1936, cuando Alan Turing construyó las primeras máquinas que funcionaban por IA. A pesar de ser una historia bastante larga, hoy en día la IA en la mayoría de las áreas aún no es capaz de reemplazar completamente a un ser humano. Y la competencia de la IA con los humanos en el ajedrez, y la encriptación de datos son dos caras de la misma moneda.
  • El aprendizaje automático es una herramienta de creación para extraer conocimientos de los datos. En el aprendizaje automático los modelos pueden basarse en datos de manera independiente o en etapas.
  • El aprendizaje profundo es la creación de redes neuronales multicapa en áreas en las que se necesita un análisis más avanzado o rápido y en las que el aprendizaje automático tradicional no puede hacer frente. La «profundidad» proporciona más de una capa oculta de redes de neuronas que realizan cálculos matemáticos.
  • Big Data – trabaja con grandes cantidades de datos, a menudo no estructurados. Las características específicas de la esfera son herramientas y sistemas capaces de soportar grandes cargas.
  • La ciencia de datos es la adición de significado a las matrices de datos, la visualización, la recopilación de ideas y la toma de decisiones basadas en estos datos. Los especialistas de campo utilizan algunos métodos de aprendizaje automático y Big Data – computación en nube, herramientas para crear un entorno de desarrollo virtual y mucho más. Las tareas de Data Science se resumen bien en este diagrama de Venn creado por Drew Conway


Entonces, ¿qué es Data Scientist? Aquí está todo lo que necesitas saber al respecto:
detección de anomalías, por ejemplo, comportamiento anormal del cliente, fraude;
marketing personalizado – boletines personales por correo electrónico, sistemas de recomendación;

  • Previsiones métricas – indicadores de rendimiento, calidad de las campañas publicitarias y otras actividades;
  • Sistemas de puntuación: procesan grandes cantidades de datos y ayudan a tomar una decisión;
  • interacción básica con el cliente – respuestas estándar en salas de chat, asistentes de voz, clasificación de cartas en carpetas.

Para realizar cualquiera de las tareas anteriores es necesario seguir ciertos pasos:

  • Recolección Busque los canales en los que puede recopilar datos y cómo obtenerlos.
  • Comprobado. Validación, eliminación de anomalías que no afectan al resultado, pero confunden con análisis posteriores.
  • Análisis. El estudio de los datos, la confirmación de los supuestos, las conclusiones.
  • Visualización. Presentación en una forma que sea simple y comprensible para la percepción de una persona – en gráficos, diagramas.
  • Actuar. Tomar decisiones basadas en los datos analizados, por ejemplo, sobre el cambio de la estrategia de marketing, aumentando el presupuesto para cualquier actividad de la empresa.


Paso 1. Estadística, Matemáticas, Álgebra Lineal

El conocimiento matemático fundamental es importante para poder analizar los resultados de la aplicación de algoritmos de procesamiento de datos. Hay ejemplos de ingenieros relativamente fuertes en el aprendizaje de máquinas sin este tipo de formación, pero esto es más bien la excepción.

Si la educación universitaria ha dejado muchas lagunas, el libro The Elements of Statistical Learning de Hastie, Tibshirani y Friedman. En este libro, las secciones clásicas del aprendizaje automático se presentan en términos de estadísticas matemáticas con cálculos matemáticos rigurosos. A pesar de la abundancia de formulaciones y pruebas matemáticas, todos los métodos van acompañados de ejemplos prácticos y ejercicios.

El mejor libro en este momento para entender los principios matemáticos que subyacen a las redes neuronales – Deep Learning de Ian Goodfellow. En la introducción, hay una sección entera sobre todas las matemáticas que se necesitan para una buena comprensión de las redes neuronales. Otra buena referencia son lasRedes Neuronales y el Aprendizaje Profundo de Michael Nielsen– esto puede no ser un trabajo fundamental, pero será muy útil para entender los principios básicos.


Paso 2. Programación (Python)

De hecho, una gran ventaja sería familiarizarse inmediatamente con los fundamentos de la programación. Pero como se trata de un proceso que requiere mucho tiempo, puede simplificar un poco esta tarea. ¿Cómo? Todo es muy sencillo. Empieza a aprender un lenguaje y enfócate en todos los matices de la programación a través de la sintaxis de ese lenguaje.

Pero aún así, es difícil prescindir de algún tipo de guía general. Por esta razón, recomiendo prestar atención a este artículo:  Software Development Skills for Data Scientists: Increíble artículo sobre importantes habilidades sociales para la práctica de la programación.

Por ejemplo, le aconsejo que preste atención a Python. En primer lugar, es perfecto para que los principiantes aprendan, tiene una sintaxis relativamente simple. En segundo lugar, Python combina la demanda de especialistas y es multifuncional.


Paso 3. Aprendizaje automático

El aprendizaje automático permite entrenar a los ordenadores para que actúen de forma independiente, de modo que no tengamos que escribir instrucciones detalladas para realizar determinadas tareas. Por esta razón, el aprendizaje automático es de gran valor para casi cualquier área, pero antes que nada, por supuesto, funcionará bien donde existe la ciencia de datos.


Paso 4. Minería de datos y visualización de datos

La minería de datos es un proceso analítico importante diseñado para explorar datos. Es el proceso de analizar patrones ocultos de datos de acuerdo a diferentes perspectivas para su categorización en información útil, la cual es recolectada y ensamblada en áreas comunes, tales como almacenes de datos, para un análisis eficiente, algoritmos de minería de datos, facilitando la toma de decisiones de negocios y otros requerimientos de información para finalmente reducir costos y aumentar los ingresos.


Paso 5. Experiencia práctica

Estudiar sólo la teoría no es muy interesante, hay que probar la práctica. El principiante de Data Scientist tiene algunas buenas opciones para esto:

Utiliza Kaggle, un sitio web dedicado a la ciencia de datos. Constantemente organiza concursos de análisis de datos en los que puedes participar. También hay un gran número de conjuntos de datos abiertos que puede analizar y publicar sus resultados. Además, puede ver los guiones publicados por otros participantes (en Kaggle, estos guiones se llaman Kernels) y aprender de la experiencia exitosa.


Paso 6. Confirmación de la cualificación

Después de que hayas estudiado todo lo que necesita para analizar los datos y probar con tareas abiertas y concursos, a continuación, empieza a buscar un trabajo. Por supuesto, sólo dirás cosas buenas, pero tienes derecho a dudar de tus palabras. A continuación, se mostrarán, por ejemplo, confirmaciones independientes:

Perfil avanzado en Kaggle. Kaggle tiene un sistema de rangos, puedes progresar desde principiante hasta gran maestro. Para participar con éxito en concursos, la publicación de guiones y debates, puede obtener puntos que le permitan aumentar la puntuación. Además, el sitio muestra en qué competiciones has participado y cuáles son tus resultados.

Los programas de análisis de datos pueden ser publicados en GitHub u otros repositorios abiertos, y todos los interesados pueden familiarizarse con ellos. Incluyendo a los representantes del empleador, que realizarán una entrevista con usted.


Ver completo


ROR, el ORCID de las instituciones de investigación


ror.org_land_rgb

ROR

Organization Registry Community


ROR es un proyecto dirigido por la comunidad para desarrollar un identificador abierto, sostenible, utilizable y único para cada organización de investigación en el mundo.


La comunidad de investigación académica depende de una serie de identificadores abiertos y sistemas de infraestructura de metadatos que facilitan los procesos de comunicación científica. Los identificadores de contenido (DOI) y los identificadores de contribuyentes (ORCID) son infraestructura fundamental para la comunidad. Pero falta una parte de la infraestructura: actualmente no existe una infraestructura abierta gestionada por las partes interesadas para identificar las organizaciones de investigación y sus metadatos asociados.

ROR significa «Registro de Organizaciones de Investigación», es un proyecto dirigido por la comunidad para desarrollar un identificador abierto, sostenible, utilizable y único para cada organización de investigación en el mundo. Cuando hablamos de ROR, nos referimos alternativamente o, a veces, simultáneamente a un proyecto, una capa de infraestructura, un registro de identificador, un elemento de metadatos y / o una comunidad de personas.

El alcance de ROR es el «caso de uso de afiliación»: descripción adecuada de las relaciones entre contribuyentes, contribuciones, patrocinadores de investigación, editores y empleadores. Usa «afiliación» para describir cualquier relación formal entre un investigador y una organización asociada con los investigadores, incluyendo, entre otros, su empleador, educador, financiador o sociedad académica. Define «organización de investigación» como cualquier organización que realiza, produce o gestiona la investigación.

La visión de un registro de organizaciones de investigación con identificaciones únicas y metadatos asociados consta de las siguientes características requeridas:

  • Identificaciones únicas y persistentes para organizaciones de la comunidad de investigación.
  • Las identificaciones resuelven la información sobre la entidad: legible por humanos y máquinas
  • API abierta / negociación de contenido
  • Facilidad administrativa para corregir, administrar y cruzar datos, incluido el modelo de afirmación y la sincronización con otros proveedores de PID
  • Volcado de datos públicos
  • Conjunto de metadatos comunes y uniformes


El registro ROR se lanzó en enero de 2019. Los orígenes de ROR están en la iniciativa OrgID, en el que 17 organizaciones diferentes (que representaban a editoriales, bibliotecas, proveedores de plataformas, servicios de metadatos y otras partes interesadas) trabajaron juntas para definir una visión para un registro de identificadores de organizaciones liderado por la comunidad

Actualmente posee registros de cerca de 100,000 organizaciones, todas con ID de ROR únicas y metadatos asociados. Además del registro en sí, existen herramientas e interfaces para trabajar con datos ROR, como una búsqueda frontal , una API abierta , un reconciliador que funciona con OpenRefine para limpiar datos de afiliación desordenados y más.