Archivo de la categoría: Investigación

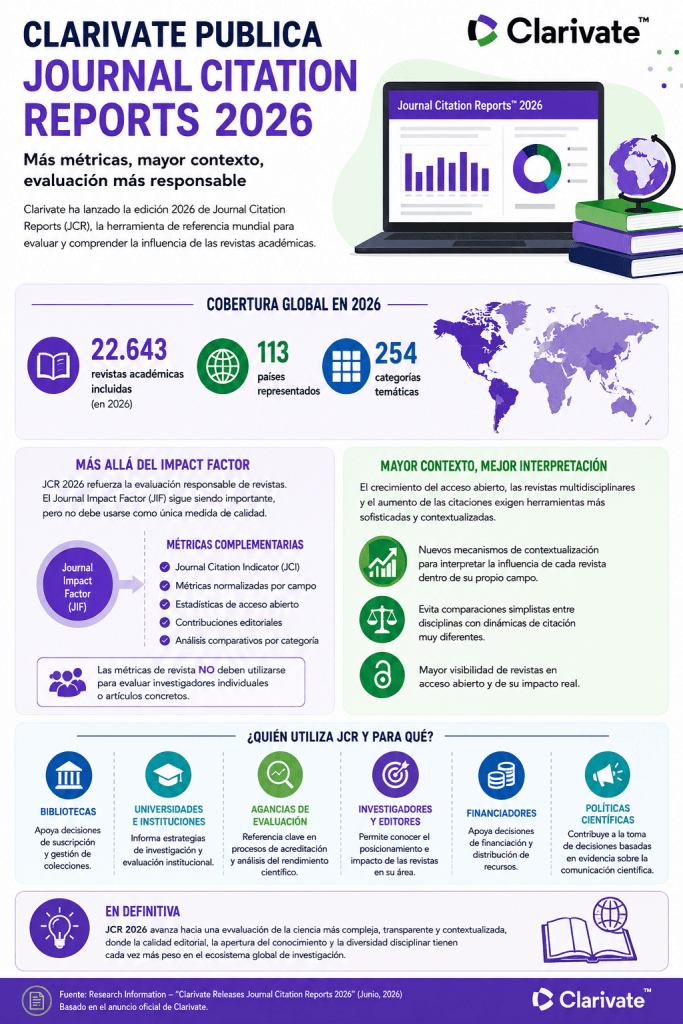
Clarivate publica el Journal Citation Reports 2026

Research Information. “Clarivate Releases Journal Citation Reports 2026”. Junio de 2026. Basado en el anuncio oficial de Clarivate Analytics

Clarivate ha presentado la edición 2026 de su influyente informe Journal Citation Reports (JCR), una de las herramientas bibliométricas más utilizadas en el mundo académico para evaluar el impacto y la influencia de las revistas científicas. Esta nueva edición refuerza la apuesta por una evaluación más responsable, contextualizada y multidimensional de las publicaciones científicas, en un momento en que la comunidad investigadora cuestiona cada vez más la dependencia exclusiva del tradicional Impact Factor.

El informe, integrado en la plataforma Journal Citation Reports de Clarivate, amplía significativamente su cobertura global. La edición 2026 incorpora 22.643 revistas académicas procedentes de 113 países y distribuidas en 254 categorías temáticas, consolidando a JCR como uno de los repertorios de referencia para universidades, bibliotecas, agencias de evaluación e instituciones científicas. La metodología mantiene un enfoque estable que permite comparaciones longitudinales entre disciplinas y seguimiento de tendencias de publicación a escala internacional.

Una de las principales líneas de evolución del JCR 2026 es el énfasis en la evaluación responsable de revistas, reduciendo la centralidad histórica del Journal Impact Factor (JIF) como único indicador de calidad. Clarivate insiste en que las métricas de revista no deben utilizarse para evaluar directamente investigadores individuales o artículos concretos. En este sentido, la plataforma complementa el JIF con indicadores adicionales como el Journal Citation Indicator (JCI), métricas normalizadas por campo disciplinar, estadísticas de acceso abierto, datos sobre contribuciones editoriales y análisis comparativos por categoría científica.

El lanzamiento refleja también cambios más amplios en el ecosistema de la comunicación científica. Según Clarivate, el crecimiento de modelos de publicación en acceso abierto, la expansión de revistas multidisciplinares y el aumento global del volumen de citación exigen herramientas analíticas más sofisticadas. Por ello, JCR 2026 incorpora nuevos mecanismos de contextualización que permiten interpretar mejor la influencia de una revista dentro de su propio campo, evitando comparaciones simplistas entre disciplinas con dinámicas de citación muy diferentes.

Para bibliotecarios, gestores de colecciones y responsables universitarios, esta actualización resulta especialmente relevante porque influye directamente en políticas de suscripción, estrategias de adquisición, decisiones de financiación y evaluación institucional de la investigación. El sistema sigue funcionando como referencia central en numerosos procesos de acreditación académica y análisis del rendimiento científico internacional, aunque en paralelo continúa creciendo el debate sobre alternativas más abiertas y menos dependientes de métricas cuantitativas tradicionales.

Argumentos a favor y en contra de la coautorización con IA

Two people collaborating on writing using laptop, desktop, and AI holographic assistant
Two professionals use AI tools to enhance their writing project in a modern office.

Diab, Robert. “The Case for and Against Co-Authoring With AI”. Publicado en Slaw.ca, 6 de mayo de 2026.

El jurista canadiense Robert Diab examina críticamente una de las cuestiones más debatidas en la era de la inteligencia artificial generativa: si resulta conveniente utilizar herramientas de IA como colaboradoras directas en la escritura profesional. Su reflexión se centra especialmente en el ámbito jurídico, aunque las ideas planteadas son extrapolables al periodismo, la investigación académica y cualquier disciplina donde la escritura sea una manifestación del pensamiento crítico y de la autoría intelectual.

Diab parte de una distinción fundamental entre dos usos distintos de la inteligencia artificial: emplearla como herramienta de apoyo para revisar o editar un texto ya escrito por una persona, o utilizarla para generar el documento desde cero a partir de instrucciones o prompts. Mientras considera legítimo y útil el primer caso, manifiesta reservas importantes sobre el segundo. Su principal preocupación es que, aunque técnicamente el texto generado pueda ser correcto, la escritura producida por IA suele carecer de autenticidad, personalidad y profundidad argumentativa, dando lugar a documentos excesivamente formales, repetitivos o mecánicos.

El autor analiza la postura opuesta defendida por el abogado neoyorquino Zack Shapiro, quien sostiene que la IA puede actuar como una verdadera coautora siempre que el usuario aporte previamente el pensamiento estratégico, la estructura argumentativa y las decisiones intelectuales fundamentales. Según esta visión, la parte esencial del trabajo cognitivo ocurre antes de redactar: el humano piensa, diseña y decide, mientras la máquina ejecuta y optimiza la expresión escrita. Desde esta perspectiva, no existiría una oposición binaria entre escritura humana y escritura artificial, sino una tercera vía híbrida de colaboración hombre-máquina.

Diab reconoce que este modelo de coautoría resulta intelectualmente atractivo y que numerosos profesionales lo están experimentando activamente. Sin embargo, mantiene su escepticismo. Señala que incluso cuando se utilizan instrucciones sofisticadas y procesos iterativos complejos, los textos producidos siguen presentando rasgos característicos de la escritura automatizada: verbosidad excesiva, formulaciones previsibles, falta de originalidad estilística y ausencia de matices personales. A su juicio, quienes valoran realmente la calidad de la escritura pueden detectar fácilmente estas limitaciones.

Uno de los aspectos más interesantes del artículo es la reflexión sobre la dimensión reputacional y profesional del acto de escribir. En profesiones como la abogacía, argumenta Diab, redactar bien no es simplemente transmitir información sino demostrar competencia, criterio y personalidad profesional. Un documento que suena excesivamente automatizado podría transmitir al lector —sea un cliente, un colega o un juez— la impresión de que el autor no dedicó suficiente atención o esfuerzo personal al trabajo realizado.

El autor reconoce, sin embargo, un argumento fuerte a favor del uso de IA: la eficiencia. En contextos laborales de alta presión, como servicios jurídicos saturados o tareas administrativas rutinarias, una carta elaborada parcialmente con ayuda de IA puede ser preferible a no producir ningún documento o limitarse a una comunicación oral improvisada. En estos escenarios, la inteligencia artificial puede servir como una herramienta valiosa para sintetizar información, organizar ideas y acelerar tareas de menor complejidad.

En sus conclusiones, Diab plantea una pregunta provocadora: si el objetivo final es producir un texto que refleje verdaderamente las propias ideas, la propia voz y el propio criterio, ¿no sería más razonable escribirlo directamente uno mismo? Sugiere que quizá la cuestión central no sea si la IA permite escribir más rápido, sino qué tipo de pensamiento, autenticidad y responsabilidad estamos dispuestos a delegar en sistemas automáticos.

El artículo refleja una preocupación creciente en ámbitos profesionales y académicos: a medida que la inteligencia artificial se integra en los procesos de escritura, surge la necesidad de redefinir conceptos tradicionales como autoría, responsabilidad intelectual y creatividad humana. Más allá de la eficiencia técnica, el verdadero debate gira en torno al valor que seguimos atribuyendo al pensamiento humano expresado a través de la escritura

El inquietante aumento de artículos científicos en la era de la inteligencia artificial

Dahl, Josh. “Guest Post — Is Growth Always Good News? 2026 Article Submission Surges”. The Scholarly Kitchen, 13 de mayo de 2026. Disponible en: The Scholarly Kitchen

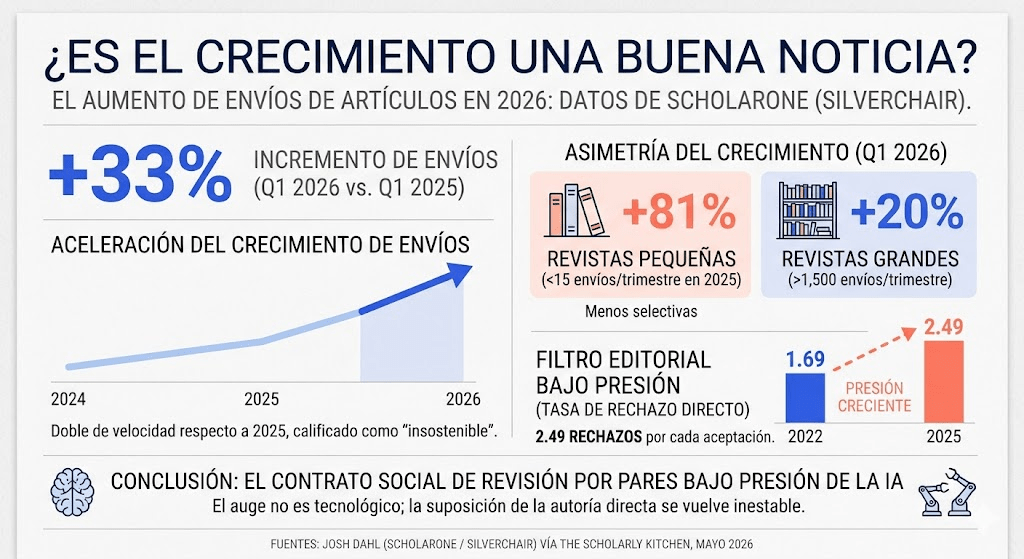
Una cuestión que está generando creciente preocupación en la comunicación científica: el espectacular aumento de manuscritos enviados a las revistas cientificas durante 2026 y el papel que la inteligencia artificial podría estar desempeñando en este fenómeno. Basándose en datos de la plataforma ScholarOne Manuscripts, una de las mayores infraestructuras mundiales de gestión editorial, Dahl revela que durante el primer trimestre de 2026 las revistas recibieron un 33 % más de artículos que en el mismo período del año anterior. Lo más llamativo no es únicamente la magnitud del crecimiento, sino su aceleración: mientras que en 2025 el incremento había sido del 17 %, en 2026 prácticamente se duplicó. Para muchos editores y responsables de revistas, esta tendencia empieza a parecer insostenible.

El autor evita interpretar automáticamente estos datos como una señal positiva. A primera vista, podría pensarse que estamos asistiendo a una expansión saludable de la actividad investigadora mundial. Más investigadores, más proyectos y más artículos podrían indicar un fortalecimiento del sistema científico. Sin embargo, Dahl advierte que los datos permiten otra lectura menos optimista. La proliferación de herramientas de inteligencia artificial generativa ha reducido drásticamente el esfuerzo necesario para producir textos académicos, lo que podría estar favoreciendo una avalancha de manuscritos elaborados con ayuda de sistemas automatizados. El problema no sería únicamente la cantidad de artículos, sino la posible disminución de la calidad media y el aumento de trabajos producidos con escasa supervisión intelectual.

Uno de los hallazgos más reveladores del análisis es que el crecimiento no se distribuye de forma homogénea entre las revistas. Las publicaciones más pequeñas y menos selectivas son las que están experimentando los mayores aumentos. Las revistas que recibían menos de quince artículos por trimestre registraron incrementos cercanos al 81 %, mientras que las grandes publicaciones, con más de 1.500 envíos trimestrales, crecieron aproximadamente un 20 %. Este patrón no demuestra por sí mismo que exista una invasión de manuscritos generados por IA, pero sí resulta compatible con esa hipótesis. Los autores que buscan publicar rápidamente podrían estar orientando sus envíos hacia revistas con menos recursos editoriales y menores barreras de entrada, precisamente aquellas que tienen más dificultades para detectar problemas metodológicos, éticos o de autoría.

El artículo destaca asimismo que los mecanismos de filtrado editorial ya están reaccionando a esta presión. Entre 2022 y 2025, los rechazos iniciales sin revisión por pares (desk rejections) aumentaron un 72 %, mientras que el número total de decisiones editoriales creció un 43 %. En otras palabras, los editores están rechazando proporcionalmente más trabajos antes de enviarlos a revisión externa. Esta tendencia sugiere que las revistas están absorbiendo una creciente cantidad de manuscritos considerados inadecuados, irrelevantes o insuficientemente elaborados. El sistema editorial continúa funcionando como filtro, pero lo hace a costa de una carga de trabajo cada vez mayor.

Para Dahl, el verdadero problema no es tecnológico, sino social. El sistema de revisión por pares se construyó sobre una premisa fundamental: que el investigador es el autor intelectual del texto que presenta, comprende plenamente su contenido y puede defender cada afirmación, referencia y conclusión. La inteligencia artificial ha introducido una zona de ambigüedad que desafía ese supuesto. Entre una simple corrección gramatical y la generación completa de borradores existe un amplio espectro de usos de la IA para el que todavía no existen normas claras ni consensos sólidos. La frontera entre asistencia legítima y delegación excesiva de la escritura se vuelve cada vez más difusa.

El autor pone como ejemplo el problema de las referencias bibliográficas inventadas por los modelos de lenguaje. Un investigador puede utilizar una herramienta de IA para redactar parte de un artículo y recibir citas aparentemente válidas que en realidad no existen. Aunque no haya intención deliberada de fraude, el manuscrito acaba incorporando información falsa. Este tipo de situaciones revela una brecha entre los actuales sistemas de responsabilidad científica y las nuevas prácticas de escritura asistida por inteligencia artificial. Los mecanismos tradicionales de autoría y rendición de cuentas fueron diseñados para un entorno en el que la producción textual era completamente humana.

Otro aspecto destacado es la dimensión psicológica del fenómeno. Dahl sostiene que el uso de IA para redactar textos académicos no genera la misma percepción moral que prácticas claramente fraudulentas como la contratación de empresas que venden artículos científicos. Muchos investigadores consideran que utilizar IA para escribir partes de un manuscrito es simplemente una herramienta de productividad. El razonamiento suele ser que las ideas, los datos y la investigación siguen siendo propios, aunque la redacción haya sido parcialmente automatizada. Esta normalización puede resultar más problemática que el fraude deliberado porque es mucho más fácil de escalar y puede afectar a miles de investigadores que no se consideran deshonestos.

Las consecuencias se extienden también al sistema de revisión por pares. Cada nuevo artículo enviado requiere revisores y tiempo editorial. Sin embargo, la disponibilidad de revisores lleva años disminuyendo. La fatiga asociada a la evaluación científica ya era un problema antes de la explosión de la IA, pero el incremento del 33 % en los envíos amenaza con agravar una situación que muchos consideran crítica. De hecho, datos complementarios citados en la discusión del artículo indican que las tasas de respuesta de revisores han descendido significativamente durante los últimos años. Esto significa que el sistema recibe más manuscritos precisamente cuando dispone de menos capacidad para evaluarlos rigurosamente.

Particularmente vulnerables aparecen las revistas pequeñas, gestionadas frecuentemente por editores a tiempo parcial, comités voluntarios o sociedades científicas con recursos limitados. Son estas publicaciones las que están absorbiendo la mayor parte del crecimiento de envíos y las que disponen de menos infraestructura para afrontar el problema. Dahl considera que esta situación pone de manifiesto una debilidad estructural del ecosistema editorial académico: la insuficiente inversión histórica en capacidades editoriales y mecanismos de control en los márgenes del sistema científico.

La conclusión del artículo es que el aumento de envíos no debe interpretarse únicamente como un desafío tecnológico ni resolverse exclusivamente mediante detectores de IA o herramientas automáticas de control. Lo que está en juego es la propia arquitectura de confianza sobre la que se construye la comunicación científica. La explosión de manuscritos en 2026 funciona como una prueba de estrés que obliga a replantear cuestiones fundamentales: cómo redefinir la responsabilidad de los autores en la era de la IA, cómo sostener la participación de los revisores y cómo proteger a las revistas más vulnerables frente a una presión creciente. Más que una crisis de software, Dahl ve en estos datos una señal de que el contrato social que sustenta la revisión por pares necesita ser revisado y adaptado a un entorno donde la producción científica ya no es exclusivamente humana.

La inteligencia artificial transforma la publicación científica

Harvey, Laura y Adam Hyde. “Guest Post — Trust & Community Are the Moat, Infrastructure Is Your Leverage: Dispatches from PurePub.AI”. The Scholarly Kitchen, 9 de junio de 2026

Ver noticia

Se recogen las principales conclusiones surgidas del encuentro PurePub.AI, un evento que reunió a 47 expertos en 15 sesiones dedicadas a explorar el impacto de la inteligencia artificial en la publicación académica. La elevada participación —más de 800 asistentes en directo y centenares de intervenciones en los debates— demuestra que la IA ha dejado de ser una cuestión futurista para convertirse en una preocupación estratégica inmediata para editoriales, sociedades científicas y proveedores de servicios. Las discusiones revelaron que los grandes temas que dominan actualmente el sector son la transformación de los flujos de trabajo, la evolución de los modelos de negocio, el papel creciente de las máquinas como consumidoras de contenidos y la necesidad de replantear los procesos editoriales tradicionales.

Uno de los mensajes centrales del encuentro es que la transición hacia la llamada “IA agéntica” ya está en marcha. En una primera fase, las organizaciones utilizan la IA para realizar más rápidamente tareas que ya existían, como la búsqueda de revisores, la detección de fraude científico, la realización de controles técnicos o el enriquecimiento de metadatos. Sin embargo, la evolución apunta hacia una segunda etapa en la que la IA no solo automatiza procesos, sino que mejora significativamente los servicios ofrecidos a investigadores, autores y lectores. Ejemplos de ello son los asistentes inteligentes para la consulta de contenidos científicos, las herramientas de revisión automatizada o los sistemas capaces de generar nuevos servicios de apoyo a la investigación. Aun así, la mayoría de las organizaciones siguen en una fase experimental y todavía no han alcanzado un despliegue generalizado de estas tecnologías.

La revisión por pares constituye uno de los ámbitos donde los cambios resultan más visibles. Los participantes señalaron que los modelos de IA más avanzados ya son capaces de realizar numerosas tareas asociadas al proceso de evaluación científica. La cuestión ya no es si la IA puede participar en la revisión, sino qué aspectos deberían seguir dependiendo del juicio humano. Mientras los sistemas automáticos destacan en tareas de verificación técnica, análisis estadístico, detección de inconsistencias o comprobación de la transparencia metodológica, los revisores humanos continúan siendo esenciales para valorar la originalidad, la relevancia científica, la pertinencia de las preguntas de investigación o la importancia potencial de los resultados. El futuro parece orientarse hacia una colaboración complementaria entre humanos y máquinas más que hacia una sustitución completa de los expertos.

Precisamente esta complementariedad lleva a una reflexión más amplia sobre el valor diferencial que los seres humanos aportan en un entorno cada vez más automatizado. Según los autores, atributos como el criterio, el gusto, la responsabilidad, la capacidad de generar confianza y el mantenimiento de relaciones dentro de las comunidades científicas se perfilan como espacios donde la intervención humana seguirá siendo indispensable. No obstante, también aparecen interrogantes sobre cómo afectará esta transformación a los perfiles profesionales existentes. Muchos participantes expresaron preocupación por la posibilidad de que ciertos trabajadores terminen desempeñando funciones limitadas a supervisar sistemas automáticos, una tarea poco estimulante si no se redefine adecuadamente el papel humano dentro de los nuevos ecosistemas editoriales.

Otro fenómeno destacado es el auge del denominado vibe coding, una metodología que permite a profesionales sin formación avanzada en programación crear prototipos funcionales mediante herramientas de IA. Durante el evento se presentaron trece proyectos desarrollados mediante este enfoque, que abarcan desde gestores de noticias hasta plataformas de transferencia de manuscritos o sistemas de revisión de textos alternativos para imágenes. La importancia de esta tendencia radica en que democratiza la innovación tecnológica, permitiendo que expertos en edición, marketing, operaciones o gestión editorial puedan diseñar soluciones adaptadas a sus necesidades sin depender completamente de equipos técnicos especializados.

Sin embargo, la conclusión más relevante del artículo gira en torno a la idea expresada en su título: la confianza y la comunidad constituyen la auténtica “muralla defensiva” de los editores científicos, mientras que la infraestructura representa su principal fuente de ventaja competitiva. En un contexto en el que la generación de contenidos se vuelve cada vez más barata y abundante gracias a la IA, la capacidad de filtrar, validar y contextualizar la información adquiere un valor extraordinario. Los autores sostienen que las marcas editoriales consolidadas y las comunidades científicas que las respaldan poseen un activo difícilmente replicable por las plataformas tecnológicas: la confianza acumulada durante décadas. Esta visión coincide con otros análisis recientes que consideran que el verdadero valor de las sociedades científicas y los editores no reside únicamente en los contenidos, sino en las relaciones, la reputación y la capacidad de proporcionar señales fiables en un entorno saturado de información.

La infraestructura tecnológica emerge como el segundo gran factor estratégico. Diversos expertos insistieron en que el éxito de la IA depende mucho menos de los modelos lingüísticos que de la capacidad para integrarlos con sistemas, datos y flujos de trabajo existentes. Según una de las citas más repetidas del encuentro, un agente de IA es apenas un 5 % modelo y un 95 % ingeniería de procesos. Esto significa que disponer de datos estructurados, sistemas interoperables y arquitecturas capaces de conectar múltiples fuentes de información será mucho más importante que simplemente adoptar la última tecnología disponible. La verdadera ventaja competitiva se construirá alrededor de la calidad de los datos y de la capacidad organizativa para utilizarlos eficazmente.

Para terminar, los autores plantean una visión de la publicación científica en 2030. Prevén que los agentes inteligentes estarán completamente integrados en los flujos editoriales, que las personas concentrarán su trabajo en tareas relacionadas con la responsabilidad, el juicio crítico y la construcción de comunidades, y que las organizaciones más exitosas serán aquellas que hayan invertido con suficiente anticipación en infraestructuras robustas y flexibles. En este escenario, la inteligencia artificial no sustituirá el valor humano, sino que aumentará la importancia de aquello que las máquinas todavía no pueden ofrecer: confianza, criterio y pertenencia a una comunidad científica reconocida.
Cómo citar la inteligencia artificial en los trabajos académicos: guía práctica para investigadores y estudiantes

Universitat Oberta de Catalunya (UOC). ¿Cómo citar la IA en los trabajos? Barcelona: Biblioteca de la UOC. Disponible en: https://hdl.handle.net/10609/148823

La guía elaborada por la Biblioteca de la Universitat Oberta de Catalunya ofrece orientaciones prácticas para el uso responsable y la correcta citación de herramientas de inteligencia artificial generativa en trabajos académicos y científicos.

El documento parte de la premisa de que la IA puede ser un apoyo útil para la investigación y la redacción, pero advierte que sus resultados deben verificarse siempre, ya que estas herramientas pueden proporcionar información incorrecta o incluso inventar fuentes bibliográficas. Por ello, recomienda solicitar las fuentes utilizadas por la IA, contrastarlas críticamente y citar directamente las fuentes originales cuando sean fiables. Además, cuando la IA forme parte del proceso de investigación, su utilización debe describirse explícitamente en la metodología del trabajo.

La publicación distingue entre la citación de una conversación mantenida con una herramienta de IA y la citación de la propia herramienta. Una conversación solo debería citarse cuando exista un enlace permanente y público que permita a otras personas recuperar y consultar el contenido exacto del diálogo. En aquellos casos en que la conversación no pueda compartirse por razones técnicas, éticas o de privacidad, la recomendación es citar únicamente la herramienta empleada, indicando claramente que se utilizó como apoyo durante la elaboración del trabajo.

La guía también aclara cuándo no es necesario citar la IA. Por ejemplo, no se requiere referencia cuando la herramienta se utiliza únicamente para localizar fuentes de información, del mismo modo que no se cita un buscador web o una base de datos. Tampoco suele ser necesario citar funciones de IA integradas en programas de uso cotidiano. Sin embargo, cuando la inteligencia artificial constituye una parte relevante del método de investigación, su utilización debe documentarse obligatoriamente.

Uno de los aspectos más valiosos del documento es su análisis comparativo de distintos estilos de citación. La UOC señala que, aunque todavía no existe una normalización universal, algunos estilos han comenzado a desarrollar pautas específicas. Entre ellos destaca especialmente APA, considerado el sistema que ofrece actualmente las orientaciones más completas y detalladas para referenciar contenidos generados mediante inteligencia artificial. Además, se subraya que las respuestas de los sistemas generativos son dinámicas y pueden variar entre sesiones, por lo que es importante documentar el texto exacto utilizado, incorporándolo en anexos o materiales suplementarios cuando resulte relevante para la comprensión del trabajo.

El documento dedica apartados específicos a los estilos APA, Vancouver, ISO 690, Chicago y Harvard. Para cada uno de ellos proporciona modelos concretos de referencia bibliográfica y ejemplos de citas dentro del texto. En términos generales, la recomendación es incluir la conversación en la bibliografía únicamente cuando exista una URL pública y permanente. En caso contrario, la referencia debe limitarse al texto o a notas explicativas. La guía adapta además las normas de estilos que todavía no contemplan oficialmente la inteligencia artificial, ofreciendo propuestas prácticas para mantener la coherencia académica y la trazabilidad de las fuentes utilizadas.

Finalmente, la guía insiste en la necesidad de actuar con transparencia académica. Los autores recomiendan informar siempre del uso de herramientas de IA cuando estas hayan intervenido en la elaboración, revisión, traducción o generación de contenidos. Esta transparencia permite evaluar adecuadamente el proceso de trabajo, favorece la reproducibilidad de la investigación y contribuye a mantener la integridad académica en un contexto en el que las tecnologías generativas están adquiriendo un papel cada vez más relevante en la producción de conocimiento

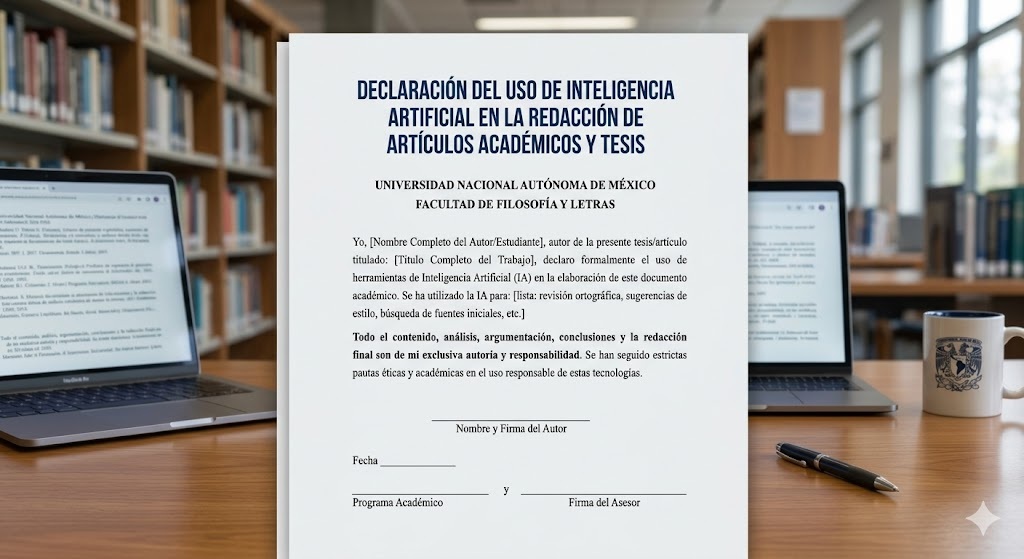
Declaración del uso de inteligencia artificial en la redacción de artículos académicos y tesis

Cabrera Huaycochea, Daril. 2025. Declaración del uso de inteligencia artificial en la redacción de artículos académicos y tesis: Hacia un estándar ético y transparente para la producción científica en la era de los modelos de lenguaje de gran escala. ResearchGate. Consultado el 30 de mayo de 2026.

Texto completo

La expansión de los modelos de lenguaje de gran escala, como GPT, Claude o Gemini, ha transformado profundamente la producción académica, facilitando tareas como la redacción, la síntesis bibliográfica y la revisión textual. Sin embargo, este avance tecnológico no ha ido acompañado de normas homogéneas para declarar su utilización, generando importantes desafíos éticos relacionados con la transparencia, la autoría y la evaluación del mérito académico. El artículo de analiza esta problemática y propone un marco estandarizado para la declaración del uso de inteligencia artificial en artículos científicos y tesis.

El autor examina las políticas adoptadas por algunas de las principales instituciones y editoriales científicas internacionales, entre ellas arXiv, Elsevier, Nature y el Comité de Ética en Publicaciones (COPE). Aunque existen diferencias en los procedimientos, todas coinciden en dos principios fundamentales: las herramientas de inteligencia artificial no pueden ser consideradas autoras de trabajos académicos y cualquier utilización relevante debe ser declarada de manera explícita. Estas organizaciones subrayan que la responsabilidad sobre la exactitud, integridad y ética de los contenidos recae siempre en los autores humanos.

Uno de los principales aportes del trabajo es la formulación de una taxonomía de cuatro niveles de declaración. El Nivel 1 corresponde a trabajos elaborados sin IA generativa; el Nivel 2 contempla el uso de herramientas para corrección gramatical y estilística; el Nivel 3 incluye la generación de borradores, síntesis o análisis supervisados por los autores; y el Nivel 4 se refiere a aquellos casos en los que la IA participa de forma sustancial en la estructura argumentativa o conceptual del trabajo. El objetivo de esta clasificación no es juzgar moralmente los distintos usos de la tecnología, sino ofrecer un marco de transparencia que permita comprender el grado de intervención tecnológica en cada investigación.

El artículo también proporciona modelos prácticos de declaración para revistas científicas y tesis universitarias. Estas plantillas buscan facilitar la adopción de estándares comunes que permitan describir qué herramientas se utilizaron, en qué fases del proceso participaron y qué mecanismos de revisión humana se aplicaron posteriormente. Según el autor, la normalización de estas declaraciones contribuiría a reducir la ambigüedad normativa y fomentaría una cultura de integridad académica basada en la transparencia y la responsabilidad.

Se presta especial atención al contexto latinoamericano, donde identifica importantes desafíos relacionados con la desigualdad en el acceso a tecnologías avanzadas, la obsolescencia de los reglamentos universitarios y los sesgos lingüísticos de los modelos entrenados principalmente en inglés. Ante esta situación, propone que las universidades actualicen sus normativas y distingan claramente entre el uso declarado de la inteligencia artificial y el fraude académico por ocultamiento u omisión. La conclusión central del trabajo es que el verdadero debate no debe centrarse en prohibir o permitir la IA, sino en garantizar que su utilización sea transparente, verificable y compatible con los principios fundamentales de la integridad científica.

La búsqueda en IA para la ciencia aún depende de los metadatos

Man searching academic articles with AI software on computer in library
A man uses AI-powered research software in a library setting.

Hansen, Stephanie Lovegrove. 2026. “Scholarly AI Search Shortcomings and the Need for Better Metadata.” The Scholarly Kitchen, 29 de mayo de 2026. https://scholarlykitchen.sspnet.org/2026/05/29/guest-post-scholarly-ai-search-shortcomings-and-the-need-for-better-metadata

El artículo defiende que el futuro de la búsqueda académica no será una sustitución de los sistemas actuales, sino un modelo híbrido en el que coexistan la búsqueda por palabras clave, la IA generativa y los sistemas de metadatos enriquecidos. En este escenario, la calidad, estandarización y estructura de los metadatos se convierten en un elemento clave: sin ellos, incluso los sistemas de IA más avanzados no pueden ofrecer resultados fiables ni plenamente utilizables en entornos científicos.

Se analiza las limitaciones actuales de los sistemas de búsqueda académica basados en inteligencia artificial y sostiene que su rendimiento depende de forma crítica de la calidad de los metadatos subyacentes. A partir de la evaluación de herramientas de descubrimiento científico impulsadas por IA, la autora argumenta que estos sistemas aún no logran sustituir de manera fiable a la búsqueda tradicional basada en palabras clave, especialmente cuando se trata de consultas precisas, técnicas o altamente estructuradas.

Uno de los problemas centrales es la dificultad de las herramientas de IA para manejar con precisión información exacta como fórmulas, datos químicos, identificadores o referencias bibliográficas específicas. Aunque la IA destaca en tareas de síntesis y en la exploración de preguntas abiertas en lenguaje natural, tiende a fallar en escenarios donde la exactitud, la reproducibilidad y la trazabilidad son esenciales. Esto genera una tensión entre dos modelos de descubrimiento: el tradicional, basado en control y precisión, y el emergente, centrado en interpretación y síntesis automática.

El texto subraya además la opacidad de muchos sistemas de IA, que dificulta comprender por qué un resultado es recuperado o no. Esta falta de transparencia afecta directamente a la confianza de los usuarios y complica su uso en contextos académicos formales, como revisiones sistemáticas o investigación regulatoria.

Análisis comparativo y evaluación de la cobertura y estructura de las bases de datos científicas en la investigación académica

De-Moya-Anegón, Félix; Sánchez-Jiménez, Rodrigo; Halevi, Gali; Guerrero-Bote, Vicente P.; Guerrero-Castillo, Pablo; Rivadeneyra, Federico (2026). A Comparative Analysis of Open and Commercial Bibliographic Infrastructures: Scale, Metadata Standardization, and Implications for Bibliometric Evaluation. Granada: Ediciones Profesionales de la Información, 48 pp. ISBN: 978-84-125757-8-1

Texto completo

El informe analiza la viabilidad estructural de las infraestructuras bibliográficas abiertas para su uso en evaluación de la investigación, comparándolas con bases de datos comerciales como Scopus en aspectos clave como cobertura, calidad de metadatos, interoperabilidad y utilidad en flujos de trabajo bibliométricos. El contexto está marcado por el impulso de marcos políticos recientes como CoARA y la Declaración de Barcelona, que promueven una transición hacia datos de investigación abiertos. Sin embargo, el estudio muestra que esta transición no es lineal, ya que existe una tensión estructural entre la enorme escala de las plataformas abiertas y la estandarización de sus metadatos, lo que genera un dilema entre cobertura masiva y consistencia analítica.

Las plataformas abiertas como OpenAIRE, OpenAlex y The Lens superan ampliamente a Scopus en volumen de registros, pero este crecimiento se produce a costa de una menor calidad y completitud de los metadatos. Problemas como la ausencia de afiliaciones en más del 55% de los registros, la baja normalización de identificadores como ISSN y DOI, y una clasificación documental excesivamente algorítmica afectan directamente a su aplicabilidad en evaluación institucional. Esta situación limita su uso directo en bibliometría, especialmente en análisis comparativos entre instituciones o países.

El informe también destaca una dinámica asimétrica en los flujos de citación: el “long tail” de las bases abiertas no redistribuye de forma equilibrada el impacto científico, sino que tiende a reforzar la centralidad de la literatura ya indexada en bases comerciales. En otras palabras, la ampliación del corpus abierto no se traduce automáticamente en una democratización del impacto científico, sino que en muchos casos consolida estructuras previas de visibilidad. A ello se suman desigualdades geográficas persistentes, con mejoras en regiones como América Latina y África, pero con importantes vacíos en Asia y Oriente Medio, además de déficits en tipologías documentales complejas como monografías de humanidades o actas de congresos.

Por otro lado, las plataformas abiertas enfrentan importantes compromisos estructurales: The Lens presenta dificultades en la estandarización global de metadatos, registrando las tasas más bajas de presencia de ISSN y DOI y un déficit del 71,67% en la captura de actas de congresos. OpenAlex depende en gran medida de datos de origen no estructurados, con un 41,5% de sus registros (con fuente) sin ISSN, y presenta un posible sesgo analítico debido a la sobre-etiquetación algorítmica de documentos como «artículos». Finalmente, OpenAIRE presenta anomalías técnicas relevantes, incluyendo más de un millón de DOI duplicados y la tasa más alta de documentos no clasificados (23,1%) dentro del núcleo curado, lo que resulta en el menor ratio global de impacto de citación del grupo.

Finalmente, el estudio subraya que cada plataforma abierta presenta fortalezas y debilidades específicas: The Lens destaca por su integración con patentes y su utilidad en análisis de transferencia tecnológica; OpenAlex por su alta alineación con registros de Scopus y su densidad de citación en el núcleo coincidente; y OpenAIRE por su mayor cobertura de identificadores persistentes y menor ausencia de afiliaciones. Sin embargo, todas comparten limitaciones estructurales cuando se utilizan sin procesos rigurosos de normalización y depuración. La conclusión central es que el acceso abierto a grandes volúmenes de datos no equivale automáticamente a su validez evaluativa, y que el futuro de la evaluación científica abierta depende de pasar de la mera disponibilidad de datos a su validación activa y metodológicamente controlada.

Papel de la automatización y la inteligencia artificial en el ciclo completo de la investigación científica

Frechette, John, and Heather Pierce-Lopez. 2026. “A Friendly Debate: Where Automation Will (And Should) Land in the Research Lifecycle.” The Scholarly Kitchen, 22 de mayo de 2026. https://scholarlykitchen.sspnet.org/2026/05/22/guest-post-a-friendly-debate-where-automation-will-and-should-land-in-the-research-lifecycle/

El artículo de The Scholarly Kitchen plantea un debate estructurado sobre el papel de la automatización y la inteligencia artificial en el ciclo completo de la investigación científica. Más que discutir si la IA “debe” o “no debe” utilizarse, el texto propone una reflexión más matizada: en qué fases del proceso investigador la automatización puede mejorar la eficiencia y en cuáles es imprescindible preservar el juicio humano.

El punto de partida es la constatación de que la IA ya está integrada de forma implícita en numerosas herramientas académicas, desde motores de búsqueda hasta sistemas de descubrimiento y gestión bibliográfica, aunque muchas veces no se perciba como tal.

El artículo identifica varias fases del ciclo de investigación donde la automatización ya está avanzando o podría hacerlo con mayor intensidad. Entre ellas se encuentran la búsqueda y descubrimiento de literatura, la organización de información, el apoyo a la redacción científica, la revisión preliminar de manuscritos y ciertas tareas administrativas dentro de las instituciones académicas. En estos ámbitos, la IA se presenta como un mecanismo de ampliación de capacidades, especialmente relevante para equipos con recursos limitados, como bibliotecas universitarias pequeñas o centros de investigación con alta carga operativa. La automatización permite reducir tareas repetitivas y liberar tiempo para actividades de mayor valor intelectual o pedagógico.

Sin embargo, el texto subraya que existen dimensiones del proceso de investigación que no pueden ni deberían ser completamente automatizadas. Entre ellas destacan la curación crítica del conocimiento, la interpretación contextual de los resultados, la toma de decisiones éticas y la integración del conocimiento en marcos institucionales específicos. Estas funciones requieren experiencia acumulada, sensibilidad disciplinar y comprensión del entorno académico que la IA no puede replicar plenamente. También se enfatiza la importancia del juicio humano en cuestiones relacionadas con la integridad científica, el riesgo institucional y la responsabilidad legal.

Un eje central del debate es la tensión entre eficiencia y confianza. Aunque la automatización puede acelerar significativamente el ciclo de producción del conocimiento, también introduce problemas de opacidad, reproducibilidad y gobernanza. El artículo señala que muchas de las herramientas actuales operan como “cajas negras”, lo que genera preocupación entre bibliotecarios, editores y gestores de investigación. La cuestión no es solo técnica, sino estructural: cómo garantizar que los sistemas automatizados sean transparentes, auditables y alineados con los valores de la ciencia abierta.

Finalmente, el texto propone una visión intermedia en la que la IA no sustituye el proceso de investigación, sino que se inserta en él como infraestructura. Esto implica rediseñar flujos de trabajo completos, definir claramente los puntos de intervención humana y establecer mecanismos de control y supervisión. En este modelo, la automatización no elimina la necesidad del investigador, sino que redefine su papel, desplazándolo hacia funciones de mayor nivel cognitivo, como la interpretación, la supervisión crítica y la toma de decisiones estratégicas dentro del ecosistema de producción científica.

La ciencia ante la avalancha de “AI slop”

Peters, Jay. 2026. “AI Research Papers Are Getting Better, and It’s a Big Problem for Scientists.” The Verge, mayo de 2026. https://www.theverge.com/ai-artificial-intelligence/930522/ai-research-papers-slop-peer-review-problem

Se analiza una creciente preocupación dentro de la comunidad científica internacional: la expansión de artículos académicos generados parcial o totalmente mediante inteligencia artificial y el impacto que este fenómeno está teniendo sobre el sistema de revisión por pares. Lo que hace apenas dos años se identificaba fácilmente como “AI slop” —textos plagados de errores, referencias inventadas y frases incoherentes— ha evolucionado rápidamente hacia trabajos aparentemente sofisticados, bien redactados y difíciles de detectar incluso para expertos. Investigadores y editores científicos advierten que la automatización masiva de la escritura académica amenaza con saturar los mecanismos tradicionales de validación científica.

El reportaje explica que los modelos de lenguaje actuales son capaces de producir artículos completos en cuestión de minutos utilizando bases de datos públicas, gráficos automatizados y síntesis bibliográficas generadas algorítmicamente. Herramientas agentivas de IA permiten ya redactar hipótesis, construir marcos teóricos, producir análisis estadísticos e incluso responder automáticamente a comentarios de revisores. El problema no reside únicamente en la existencia de errores, sino en la enorme escala de producción. Según varios investigadores citados, la IA puede generar trabajos mucho más rápido de lo que los científicos humanos pueden leerlos o evaluarlos.

Uno de los aspectos más preocupantes es el deterioro progresivo del sistema de revisión por pares, históricamente considerado uno de los pilares de la credibilidad científica. Revisores y editores describen un entorno cada vez más difícil de gestionar debido al incremento de manuscritos redundantes, superficiales o engañosos. El artículo señala que muchos de estos textos utilizan lenguaje técnico convincente y estructuras académicas correctas, pero aportan escaso valor científico real. Esto obliga a los revisores a invertir más tiempo verificando datos, referencias y metodologías. La carga de trabajo se multiplica mientras la calidad media de las contribuciones disminuye.

La situación ha llevado a plataformas científicas a adoptar medidas drásticas. El repositorio científico arXiv anunció recientemente que prohibirá durante un año a los autores que publiquen trabajos con evidencia clara de contenido generado por IA no verificado, incluyendo referencias inventadas o comentarios residuales dejados por modelos lingüísticos. Además, quienes sean sancionados deberán demostrar posteriormente que sus investigaciones han sido aceptadas en publicaciones revisadas por pares antes de poder volver a subir artículos a la plataforma. Esta decisión refleja la preocupación institucional por preservar la confianza y la integridad académica en un contexto de creciente automatización textual.

El artículo también subraya que la crisis no puede entenderse únicamente como un problema tecnológico, sino como una consecuencia de las propias dinámicas estructurales del sistema académico contemporáneo. La presión por publicar, conseguir financiación y mantener productividad científica favorece comportamientos donde la cantidad de publicaciones se valora más que la calidad o la originalidad. La IA amplifica estas dinámicas al reducir drásticamente el coste y el tiempo necesarios para producir artículos. Algunos expertos comparan la situación con una “tragedia de los comunes”: cada investigador obtiene beneficios individuales al aumentar su productividad mediante IA, pero colectivamente el ecosistema científico se degrada debido a la saturación y pérdida de confianza.

Otro problema destacado es la aparición de errores sofisticados difíciles de detectar. Investigaciones recientes muestran que incluso conferencias científicas de alto prestigio han aceptado trabajos con referencias completamente inventadas generadas por IA. Estos fallos no siempre resultan evidentes porque los modelos producen citas plausibles, nombres verosímiles y estructuras metodológicas aparentemente coherentes. El riesgo no es solo la publicación de investigaciones deficientes, sino la contaminación progresiva del propio ecosistema científico con datos falsos, referencias inexistentes y conocimiento difícilmente verificable.

Paradójicamente, mientras algunos sectores intentan frenar el “AI slop”, otros comienzan a utilizar inteligencia artificial para aliviar precisamente la crisis de revisión. Algunos proyectos experimentales, como los desarrollados en conferencias de inteligencia artificial, ya emplean sistemas automatizados capaces de revisar miles de artículos en menos de un día. Sus defensores argumentan que la IA puede detectar errores técnicos y debilidades metodológicas con gran rapidez, aunque críticos advierten de que esto puede generar revisiones homogéneas, sesgadas y fácilmente manipulables mediante ajustes estilísticos. El debate gira así en torno a una paradoja creciente: utilizar IA para controlar los problemas creados por la propia IA.

Las reacciones en comunidades académicas y tecnológicas reflejan una mezcla de alarma, resignación y escepticismo. En foros como Reddit, numerosos investigadores consideran que el problema no se limita a los modelos lingüísticos, sino a un sistema científico que ya estaba sobrecargado antes de la llegada de la IA generativa. Algunos usuarios sostienen que el verdadero riesgo es que el volumen de textos automatizados haga imposible distinguir entre investigación genuina y producción mecánica. Otros creen que la crisis obligará a replantear prácticas fundamentales de evaluación científica, desde la verificación de referencias hasta la exigencia de compartir datos experimentales completos.

La inteligencia artificial no solo está transformando la manera de escribir artículos científicos, sino que está alterando profundamente los mecanismos de validación del conocimiento académico. La revisión por pares, concebida históricamente como filtro de calidad y garantía de rigor, enfrenta ahora un escenario donde la producción automatizada amenaza con superar la capacidad humana de evaluación. El desafío ya no consiste únicamente en detectar textos generados por IA, sino en redefinir qué significa producir conocimiento fiable en una época dominada por la automatización intelectual.