Archivo del Autor: Julio Alonso Arévalo

Avatar de Desconocido

Acerca de Julio Alonso Arévalo

Bibliotecario de la Facultad de Traducción y Doc. de la USAL. Ex-Miembro del Grupo de Investigación E-LECTRA. Premio Nacional de Investigación por la UNE Premio mejor Profesional Social Media INFOAWARDS 2019. Creador y editor del repositorio E-LIS. Más de 80 artículos científicos publicados - Ver en E-LIS -en revistas científicas. El profesional de la información, Library Hi-Tech, Electronic Library. Investigación Bibliotecológica, Anales de Documentación... 12 libros publicados: Nueva fuentes de información en el contexto de la web 2.0 (Pirámide), Gutemberg 2.0 (TREA). Social Reading (Elsevier), eBooks en bibliotecas universitarias (TREA), El ecosistema del libro electrónico universitario (UNE), Un viaje a la cultura open (Amazon), GRATIS Zotero (Creative Spaces), Leyendo entre Pantallas (Trea), GRATIS Literaçia da infomrçao (ISPA) GRATIS Espistemologia y acceso abierto (UCE) GRATIS Makerspaces y bibliotecas. Barcelona: El Profesional de la Información EPI-UOC, 2018. Makerspaces. Espacios creativos en bibliotecas: creación, planificación y programación de actividades. Salamanca: Ediciones del Universo, 2019. Los libros, la lectura y los lectores a través de la literatura y las artes. Buenos Aires : Alfagrama Ediciones, 2019 Más de 2000 citas en Google Schoolar Creador y gestor del blog Universo abierto Director del programa de Radio Planeta Biblioteca Más de 250.000 seguidores en los grupos profesionales de Facebook.

Valor de los bibliotecarios en un mundo de desinformación generada por IA

«En una sociedad inundada de información, confusión generada por la inteligencia artificial, desinformación y noticias falsas, los bibliotecarios son la primera y mejor línea de defensa: navegantes de confianza que nos ayudan a encontrar el sentido, la relevancia, las pruebas y el conocimiento práctico a partir de fuentes fiables.»

Abram, Stephen. “Save the Librarians.” The Lens, 2024. https://stephenslighthouse.com/2025/04/22/academic-database-comparisons/

Stephen Abram es bibliotecario y director de Lighthouse Consulting Inc. y director ejecutivo de la Federación de Bibliotecas Públicas de Ontario.

El hachazo de Trump a las bibliotecas y museos: desmantelan el IMLS

Dave, Paresh, y Louise Matsakis. “The DOGE Axe Comes for Libraries and Museums.” WIRED, 1 de abril de 2025. https://www.wired.com/story/institute-museum-library-services-layoffs/

El gobierno de Trump ha paralizado casi por completo el Instituto de Servicios de Museos y Bibliotecas (IMLS), dejando sin funciones a la mayoría de sus empleados. Esta agencia federal financiaba servicios esenciales en bibliotecas y museos, especialmente en comunidades vulnerables. Las subvenciones otorgadas están en riesgo de perderse, afectando programas educativos, digitales y culturales. La medida, justificada por un supuesto plan de eficiencia, enfrenta críticas por su impacto social y falta de justificación.

Durante años, el Instituto de Servicios de Museos y Bibliotecas (IMLS, por sus siglas en inglés) ha contado con apoyo bipartidista en Estados Unidos, pero el gobierno de Donald Trump ha logrado asestarle un golpe devastador. En julio de 2020, casi todo el personal de la agencia —77 empleados— fue puesto en licencia administrativa con sueldo, dejando paralizadas sus operaciones. Esta medida se ejecutó poco después de que Trump designara como director interino a Keith Sonderling, del Departamento de Trabajo, en coordinación con el llamado Departamento de Eficiencia Gubernamental (DOGE), impulsado por Elon Musk.

La decisión afecta directamente a miles de bibliotecas y museos que dependían de los fondos del IMLS para llevar a cabo programas como excursiones escolares, talleres para personas mayores y acceso a recursos digitales como Libby, una popular app para leer libros electrónicos. Aunque el presupuesto anual del IMLS es menor a un dólar por habitante, en 2019 distribuyó más de 269 millones de dólares en subvenciones. Sin personal para gestionar los reembolsos, la continuidad de esos fondos está en peligro.

Los efectos son extensos: por ejemplo, una comunidad indígena en California esperaba recibir 10.000$ para adquirir libros y recursos digitales; un museo en Carolina del Norte planeaba usar 23.500$ para talleres textiles dirigidos a personas mayores; y en Idaho, una subvención de 10.350 estaba destinada a excursiones escolares. También se preveían reembolsos por casi 189.000$ para la compra de 54.000 libros infantiles por parte de cinco tribus nativas, ahora en riesgo.

La administración justificó el cierre aludiendo a un decreto presidencial que pedía reducir el IMLS a su mínima expresión legal, en línea con intentos previos de Trump por eliminarlo, bajo el argumento de eliminar gastos superfluos. Aun así, no hay evidencia de mal uso de fondos. De hecho, expertos y líderes del sector destacan la importancia vital de estas subvenciones, especialmente para zonas rurales y poblaciones vulnerables.

La acción provocó un fuerte rechazo. El sindicato que representa a los empleados del IMLS denunció la incertidumbre sobre los proyectos ya aprobados, y una coalición bipartidista de senadores, liderada por Jack Reed, exigió al gobierno que cumpla con la ejecución de los fondos autorizados por el Congreso.

Aunque bibliotecas y museos reciben apoyo de otras fuentes, el IMLS es el mayor proveedor federal directo de financiación para estos sectores. El impacto de su paralización se extiende incluso a grandes sistemas como el de Nueva York, donde aunque el porcentaje de fondos federales es menor, estos se usan para innovación y nuevos programas. Instituciones están organizando campañas para buscar donantes privados, mientras algunas fundaciones filantrópicas ya se preparan para suplir el vacío económico.

El futuro del IMLS está ahora en manos del Congreso, los tribunales y la presión pública. Mientras tanto, la incertidumbre persiste y amenaza el acceso equitativo a la cultura, la educación y la tecnología para millones de estadounidenses.

Durante la guerra las bibliotecas de Ucrania están siendo centros clave de ayuda humanitaria, refugios, espacios de aprendizaje y apoyo emocional

Lopatovska, Irene, Grace Pickering, y Celia Coan. 2025. «Ukrainian Public Libraries During the Russia-Ukraine War: Supporting Individuals, Communities, and the Nation.» Journal of Librarianship and Information Science. https://doi.org/10.1177/09610006251326610

Este estudio analiza el papel de las bibliotecas públicas ucranianas durante la guerra entre Rusia y Ucrania. A través de entrevistas con doce directores de bibliotecas en distintas regiones del país, se recopilan testimonios sobre cómo el conflicto ha impactado sus servicios y funciones.

Los resultados confirman que muchas bibliotecas se han transformado en centros clave de ayuda humanitaria, refugios, espacios de aprendizaje y apoyo emocional. Además, han impulsado nuevas iniciativas relacionadas con la alfabetización mediática, la descolonización de las colecciones y el fortalecimiento de la identidad nacional ucraniana.

A partir de los datos recogidos y de la literatura existente, los autores proponen un marco teórico que identifica las necesidades de los usuarios en contextos de guerra, que van desde necesidades básicas (psicológicas, físicas, de seguridad e informativas) hasta la necesidad de pertenecer a una comunidad y una nación. Este marco, aunque contextualizado en Ucrania, puede aplicarse también para comprender el valor y las funciones de las bibliotecas públicas en otras partes del mundo.

Los motores de búsqueda basados en inteligencia artificial citan incorrectamente las fuentes de noticias en más del 60 % de los casos.

Edwards, Benj. 2025. «AI Search Engines Cite Incorrect News Sources at an Alarming 60% Rate, Study Says.» Ars Technica, March 13, 2025. https://arstechnica.com/ai/2025/03/ai-search-engines-give-incorrect-answers-at-an-alarming-60-rate-study-says/

Un estudio reciente del Tow Center for Digital Journalism de la Columbia Journalism Review ha revelado que los motores de búsqueda basados en inteligencia artificial citan incorrectamente las fuentes de noticias en más del 60 % de los casos.

El análisis se realizó con ocho herramientas de búsqueda impulsadas por IA, a las que se les pidió identificar título, editor, fecha y URL de artículos reales. Los resultados mostraron errores sistemáticos en la atribución de fuentes.

Los investigadores Klaudia Jaźwińska y Aisvarya Chandrasekar señalaron que aproximadamente uno de cada cuatro estadounidenses ya usa estos modelos como alternativa a los buscadores tradicionales, lo que agrava la preocupación sobre su fiabilidad. Entre las herramientas analizadas, Grok 3 tuvo la tasa de error más alta (94 %), mientras que ChatGPT Search falló en el 67 % de los casos y Perplexity en el 37 %. En total se realizaron 1.600 pruebas.

Una práctica común de estos modelos fue responder con seguridad aunque no tuvieran información confiable, generando respuestas plausibles pero erróneas, conocidas como confabulaciones. Además, las versiones de pago como Perplexity Pro y Grok 3 Premium cometieron errores con más frecuencia, ya que evitan negarse a responder.

El estudio también detectó que algunas herramientas ignoraron los protocolos de exclusión de robots (robots.txt), accediendo a contenidos que los editores habían solicitado explícitamente no fueran rastreados, como en el caso de National Geographic. Además, muchas veces los enlaces proporcionados llevaban a versiones sindicadas (por ejemplo, Yahoo News) en lugar del sitio original, o eran URL inventadas que conducían a páginas de error, como ocurrió en 154 de 200 enlaces proporcionados por Grok 3.

Estos problemas ponen a los editores en una situación difícil: bloquear los rastreadores puede suponer perder visibilidad, pero permitirlos implica la reutilización masiva sin retorno de tráfico.

Mark Howard, director de operaciones de Time, expresó su preocupación por la falta de control y transparencia, aunque confía en que el producto mejorará con el tiempo. También advirtió a los usuarios: “Si alguien cree que estos productos gratuitos son 100 % precisos, es culpa suya”.

OpenAI y Microsoft reconocieron la recepción del informe, pero no abordaron directamente los problemas señalados.

La clasificación como colonización: cómo las bibliotecas perpetúan el poder a través de la clasificación

Olson, Mike. 2025. “Classification as Colonization: The Hidden Politics of Library Catalogs.” The Scholarly Kitchen, March 25, 2025. https://scholarlykitchen.sspnet.org/2025/03/25/guest-post-classification-as-colonization-the-hidden-politics-of-library-catalogs/

Se expone de manera crítica cómo los sistemas de clasificación bibliotecaria, lejos de ser neutros o puramente técnicos, han sido y continúan siendo herramientas de poder con implicaciones políticas y sociales profundas.

Olson comienza refiriéndose a la orden ejecutiva del presidente Trump del 20 de enero de 2025, que impone cambios de nombre geográfico significativos (como “Mount McKinley” en lugar de “Mount Denali” y “Gulf of America” en vez de “Gulf of Mexico”), para ilustrar cómo el lenguaje en los catálogos puede ser utilizado como instrumento de control ideológico y simbólico. Esta intervención política explicita lo que siempre ha sido una realidad encubierta: que nombrar y clasificar es también decidir qué visiones del mundo se legitiman.

El autor analiza cómo el lenguaje en la catalogación ha sido históricamente una forma de imponer perspectivas dominantes, enmascarando decisiones sesgadas bajo una apariencia de objetividad técnica. Cita ejemplos como el uso prolongado del término “Illegal aliens” en la Library of Congress, que solo se reemplazó tras décadas de presión y denuncia por parte de bibliotecarios críticos como Sanford Berman, quien ya en 1971 denunciaba la carga racista, sexista y xenófoba de muchos encabezamientos. Para Olson, estas decisiones no son meras omisiones técnicas, sino actos deliberados de poder que estructuran el acceso al conocimiento y refuerzan desigualdades.

La crítica también se extiende a sistemas históricos como la Clasificación Decimal Dewey, que continúa vigente en bibliotecas de todo el mundo y cuya estructura original reflejaba abiertamente las ideas misóginas y racistas de su creador, Melvil Dewey. Temas como la salud femenina aparecen subordinados dentro de categorías menores, mientras que las voces de culturas no occidentales son relegadas a secciones marginales como “folclore”. Según Olson, estas jerarquías no son fallos del sistema, sino su esencia misma: reflejan un orden epistemológico centrado en el hombre blanco cristiano como norma universal.

Otro blanco de crítica es el sistema de encabezamientos de materia de la Biblioteca del Congreso (LCSH), ampliamente utilizado a nivel internacional. Olson denuncia cómo este sistema sigue utilizando terminología desfasada o directamente ofensiva, como “Sexual minorities” para referirse a personas LGBTQ+ o el aún vigente “Indians of North America”. Investigaciones como las de Rachel K. Fischer demuestran que el vocabulario oficial apenas refleja el 25 % de los términos identitarios empleados por comunidades LGBTQ+, según el vocabulario especializado Homosaurus. Esta desconexión entre los sistemas de catalogación y las formas reales en que las comunidades se nombran a sí mismas constituye, para Olson, una forma de injusticia epistémica, tal como la define la filósofa Miranda Fricker: una violencia que margina a los sujetos como productores y transmisores legítimos de conocimiento.

El catálogo, plantea Olson, se ha convertido en un sistema fracturado que oscila entre su función de organizar el saber bajo normas estandarizadas —que perpetúan sesgos históricos— y su aspiración de ser un espacio democrático de acceso equitativo al conocimiento. La reciente ola de mandatos políticos que imponen terminología nacionalista o censuran referencias a derechos reproductivos, diversidad o cambio climático, no introduce la política en la catalogación, sino que hace visible la política que siempre estuvo allí. Sin embargo, también abre la puerta a formas de resistencia creativa, como la “bibliographic drag”, en la que los catalogadores pueden subvertir el lenguaje impuesto introduciendo encabezamientos complementarios que expongan el carácter ideológico de ciertos términos.

Olson propone repensar profundamente la autoridad en catalogación. Frente a sistemas jerárquicos y centralizados que buscan imponer significados únicos, el autor aboga por modelos abiertos y colaborativos que permitan múltiples interpretaciones. Herramientas como la clasificación facetada, los modelos de datos enlazados o los sistemas de etiquetado comunitario ofrecen vías para representar la diversidad de lenguajes y experiencias, sin sacrificar el orden ni la accesibilidad. Ejemplos como la biblioteca Xwi7xwa en la Universidad de Columbia Británica —que utiliza un sistema adaptado a perspectivas indígenas— o el vocabulario Homosaurus —creado por y para comunidades LGBTQ+— muestran que otra catalogación es posible, una que no impone sino que dialoga con los saberes comunitarios.

En definitiva, si los catálogos dejan de nombrar ciertos conceptos o los sustituyen por eufemismos ideológicos, estamos frente a una forma sutil pero poderosa de control del pensamiento. En lugar de resignarse a ello, el autor invita a los profesionales de la información a repensar la infraestructura intelectual de las bibliotecas como espacios críticos, participativos y abiertos a la pluralidad de voces. Solo así se podrá superar la lógica de la colonización del saber y construir sistemas de clasificación realmente democráticos y representativos.

ChatGPT en la ciencia: su uso es mayor en países donde está prohibido

Bao, Honglin, Mengyi Sun, y Misha Teplitskiy. 2025. “Where There’s a Will There’s a Way: ChatGPT Is Used More for Science in Countries Where It Is Prohibited.” Quantitative Science Studies, 1–23. https://doi.org/10.1162/qss_a_00368.

El estudio demuestra que las prohibiciones geográficas no están logrando limitar el uso de ChatGPT en la producción científica. Las herramientas de inteligencia artificial están siendo ampliamente utilizadas incluso en contextos donde su uso está regulado o restringido, lo que plantea importantes desafíos para el diseño de políticas eficaces en el ámbito de la gobernanza tecnológica global. Además, pone de relieve la creciente dependencia de los investigadores en estas tecnologías para la redacción y difusión de su trabajo.

Se analiza críticamente la eficacia de las restricciones geográficas impuestas al acceso de modelos de inteligencia artificial como ChatGPT en el ámbito científico. El caso de estudio se centra en países donde el acceso a ChatGPT está oficialmente bloqueado, como China, Rusia, Irán y otros.

El estudio parte de una pregunta clave: si estas restricciones fueran realmente efectivas, ¿se detectaría un menor uso de ChatGPT en la producción científica de dichos países? Para responder a esta cuestión, los autores desarrollaron un sofisticado clasificador capaz de identificar textos redactados con asistencia de ChatGPT, utilizando como base ciertas elecciones lingüísticas características de sus primeras versiones, como el uso de palabras específicas (“delve”, “remarkably”, entre otras).

Este clasificador, entrenado con resúmenes de artículos científicos anteriores y posteriores a la aparición de ChatGPT, demostró ser más preciso que herramientas populares como GPTZero y ZeroGPT, e incluso fue validado con artículos en los que los autores habían declarado explícitamente el uso de IA.

Al aplicar este modelo a más de 170.000 preprints de plataformas de investigación como ArXiv, BioRxiv y MedRxiv, los investigadores encontraron que, para agosto de 2023, aproximadamente el 12,6% de los artículos científicos presentaban indicios de uso de ChatGPT. Sorprendentemente, el uso fue un 7,7% más alto en los países donde la herramienta estaba oficialmente restringida. Esta diferencia se produjo antes de que estuviera disponible en el mercado el primer modelo de lenguaje de gran escala desarrollado en China, lo que sugiere que los investigadores de estos países estaban utilizando métodos alternativos (como VPNs) para acceder a ChatGPT.

Además, los autores exploraron la hipótesis de si esta alta demanda de herramientas de IA en ciencia —especialmente en países asiáticos donde el inglés no es lengua oficial— podría haber impulsado un uso aún mayor en ausencia de restricciones. Los resultados confirmaron que el uso de ChatGPT era más elevado precisamente en aquellos países donde el acceso estaba prohibido, lo que refuerza la idea de que las restricciones no son efectivas y que los científicos están dispuestos a sortear los obstáculos para beneficiarse de estas herramientas.

Otro hallazgo interesante fue que el uso de ChatGPT correlacionaba con un mayor número de visualizaciones y descargas de los artículos, lo cual sugiere que podría estar influyendo en la claridad, presentación o atractivo del contenido. Sin embargo, este uso no mostró correlación con un mayor número de citas ni con una mejor colocación en revistas académicas de alto impacto.

ERIC en peligro: la mas importante base de datos de investigación educativa podría dejar de actualizarse esta semana

​Barshay, Jill. «Proof Points: A Treasure Trove of Education Reports and Studies Is Under Threat.» The Hechinger Report, April 21, 2025. https://hechingerreport.org/proof-points-eric-under-threat/

El centro de recursos educativos ERIC (Education Resources Information Center), una biblioteca pública digital con 2,1 millones de documentos educativos, podría dejar de actualizarse esta semana por falta de financiación. A pesar de tener un contrato vigente hasta 2028 y fondos ya autorizados por el Congreso, el Departamento de Eficiencia Gubernamental (DOGE) se ha negado a liberar el dinero necesario para su operación. ERIC, gestionado por el Departamento de Educación de EE.UU., es una herramienta esencial para investigadores, docentes y responsables de políticas educativas, comparable a PubMed en el campo de la salud.

Erin Pollard Young, la única empleada del Departamento de Educación dedicada a ERIC, fue despedida en marzo junto con otros 1.300 trabajadores. Antes de su salida, intentó recortar el presupuesto de ERIC a la mitad, como exigía DOGE, pero incluso esa propuesta fue rechazada. El contrato podría expirar el 23 de abril, lo que significaría que ya no se añadirían nuevos documentos al repositorio.

ERIC contiene artículos de revistas académicas, libros, informes gubernamentales y tesis doctorales, incluyendo una gran cantidad de «literatura gris» (estudios no publicados ni catalogados en bases privadas como EBSCO), lo que lo hace insustituible por herramientas como Google o IA.

Desde el Departamento de Educación han justificado los recortes con la necesidad de reestructurar el Instituto de Ciencias de la Educación (IES), del cual depende ERIC, acusándolo de ineficacia en la mejora de resultados educativos.

Pollard Young ha decidido hablar públicamente sobre la situación, a pesar del riesgo de represalias, para intentar salvar un recurso que ha sido clave para la investigación educativa durante más de 60 años.

Entrevista al músico ecuatoriano Jaime Martínez. Viviendo en la era pop 2025/04/18

Entrevista al músico ecuatoriano Jaime Martínez.

Viviendo en la era pop 2025/04/18

ESCUCHAR

Descargar

Jaime Martínez es un reconocido músico ecuatoriano cuya trayectoria abarca una amplia y prolífica discografía. Apasionado del arte y la literatura, ha dejado huella en la escena musical por su capacidad para reinventarse constantemente y explorar nuevas sonoridades. Su recorrido incluye la participación en numerosas bandas y proyectos, entre ellos Zuchos del Vado, El Funambulista Irrompible, Los Animales Lisérgicos, Los Reciénmuertitos, entre otros, moviéndose con soltura entre el rock, el punk y territorios más experimentales.

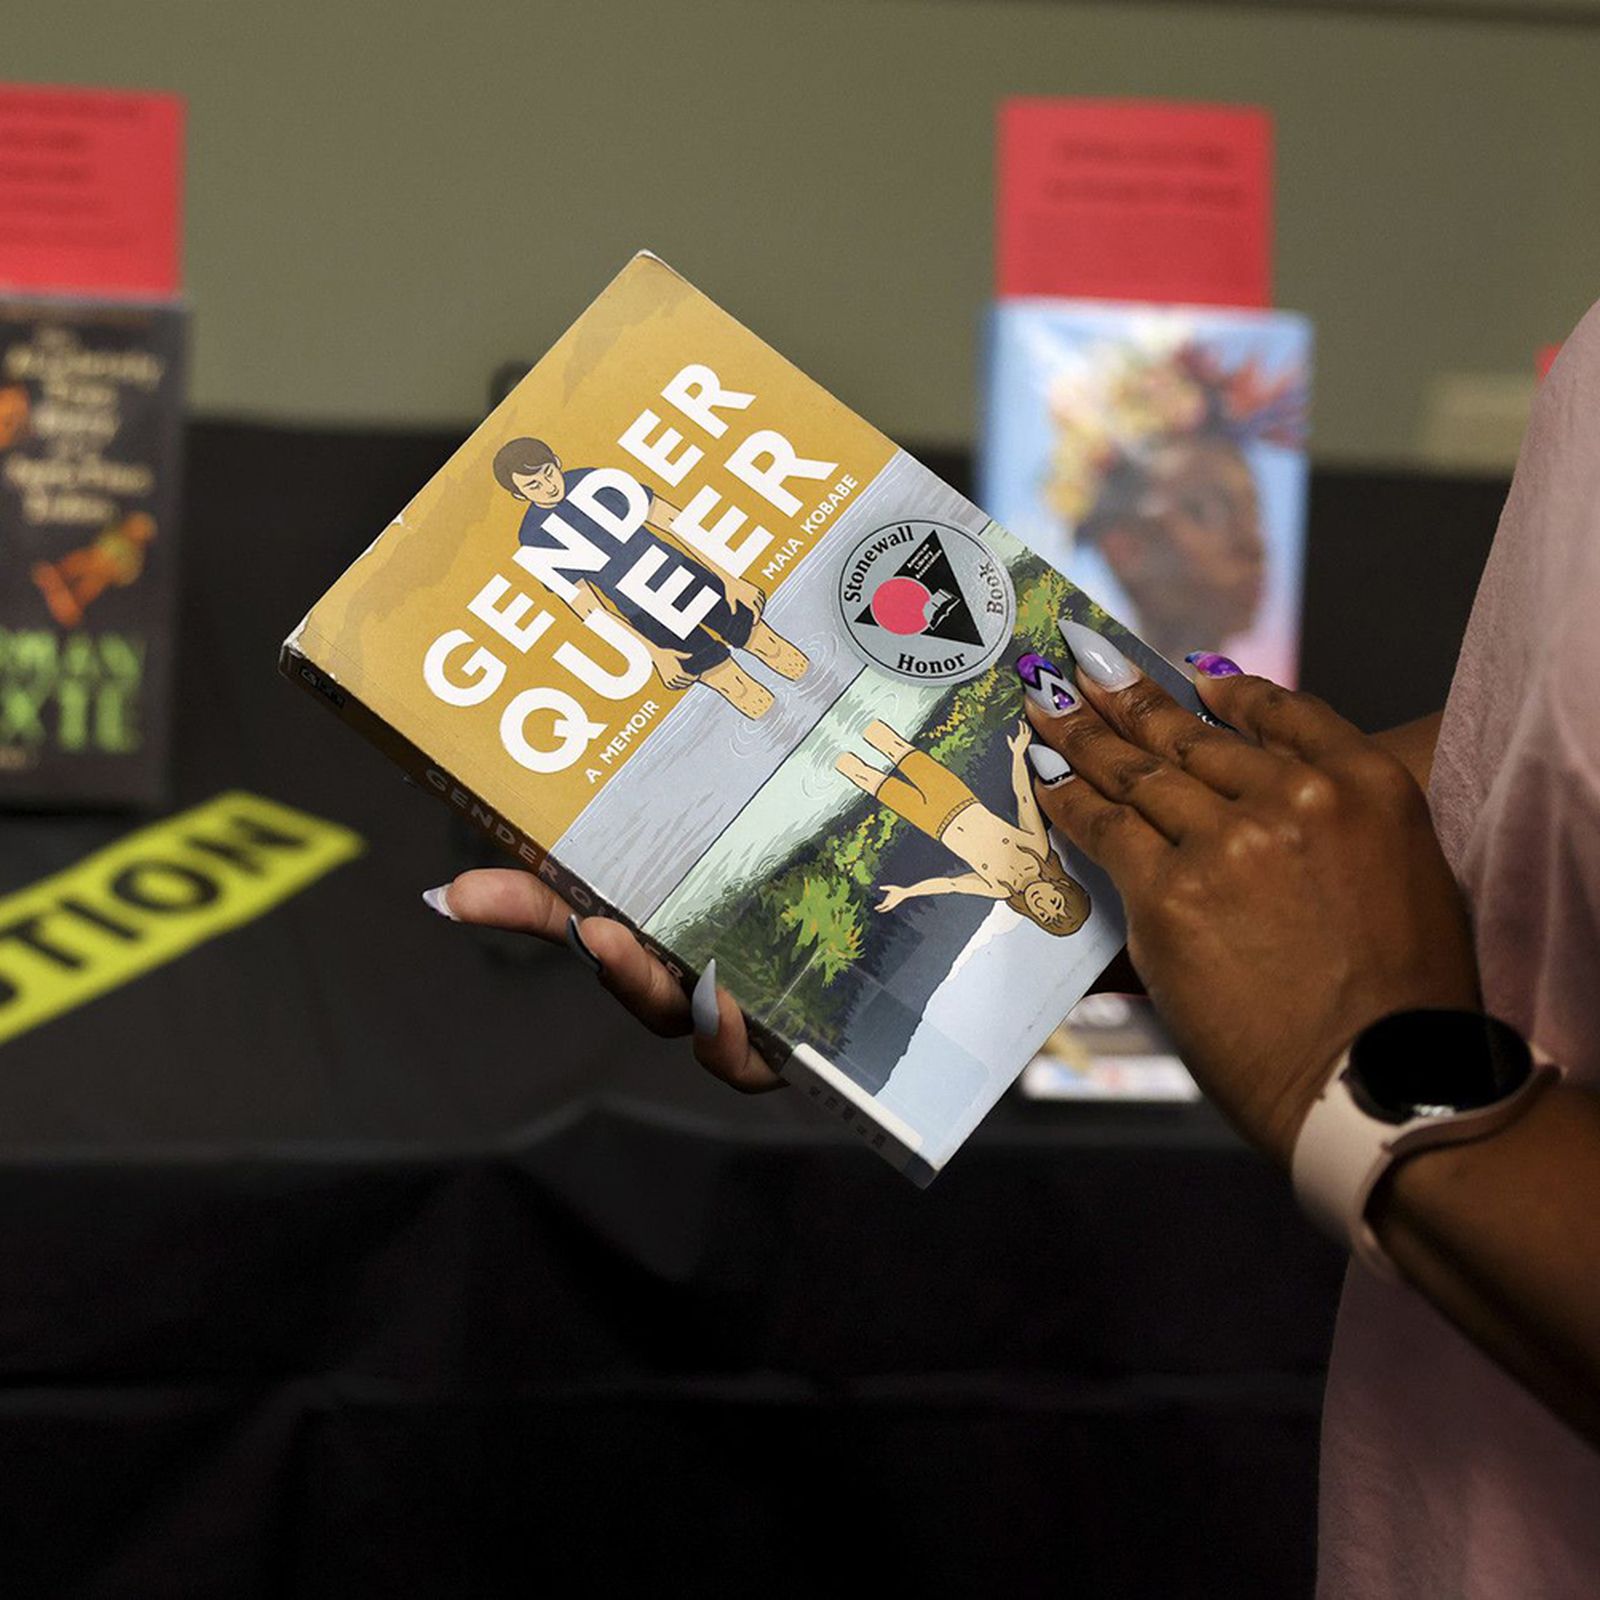
La mayoría de los libros prohibidos en Estados Unidos presentan a personas de color y personas LGBTQ+

Oladipo, Gloria. «Most Banned Books Feature People of Color and LGBTQ+ People, Report Finds.» The Guardian, February 27, 2025. https://www.theguardian.com/us-news/2025/feb/27/banned-books-people-of-color-lgbtq

Un estudio de PEN America ha revelado que la mayoría de los libros prohibidos en las escuelas públicas de EE. UU. durante el año escolar 2023-2024 trataban sobre personas de color, personas LGBTQ+ y otras demografías. El informe también refuta las afirmaciones de legisladores conservadores de que los libros prohibidos eran explícitamente sexuales, argumentando que, en realidad, el foco principal de la censura fue la representación de identidades marginadas.

Hubo más de 10.000 casos de libros prohibidos en el año escolar 2023-24, según PEN America, un aumento considerable respecto al año anterior, ya que los estados dirigidos por republicanos implementaron nuevas leyes de censura.

De los 4.218 títulos de libros prohibidos, 1.534, o el 36%, presentaban a personas de color, el grupo más censurado en las prohibiciones de libros. Algunos de los títulos retirados incluían la obra Fences, ganadora del Pulitzer de August Wilson, y el libro infantil A is for Activist de Innosanto Nagara, que trata sobre problemas sociales.

El informe encontró que los libros que presentaban a personas de color fueron desproporcionadamente atacados en todas las categorías de libros prohibidos, especialmente en los títulos históricos y biográficos eliminados. De esos libros prohibidos, el 44% incluían a personas de color; más de una cuarta parte, o el 26%, de esos libros presentaban a personas negras.

Los defensores de PEN America señalaron que, al mismo tiempo que se multiplicaban las prohibiciones de libros, más del 50% de los jóvenes en EE. UU. son niños de color, según datos de 2021 de la Children’s Defense Fund.

«Esta censura dirigida equivale a un ataque dañino a las poblaciones históricamente marginadas y subrepresentadas, un esfuerzo peligroso por borrar sus historias, logros e historia de las escuelas», dijo Sabrina Baêta, gerente senior del programa Freedom to Read de PEN America, en un comunicado de prensa sobre el informe. «Cuando despojamos a las estanterías de las bibliotecas de libros sobre ciertos grupos, estamos derrotando el propósito de una colección bibliográfica que debe reflejar la vida de todas las personas. Las consecuencias dañinas para los jóvenes son reales».

Los títulos que presentaban personajes LGBTQ+ también representaron una proporción considerable de las prohibiciones de libros: 1,066 libros, o el 25% de todos los títulos prohibidos, incluían personas LGBTQ+. Los personajes transgénero o genderqueer fueron específicamente atacados en estas prohibiciones de libros, ya que el 28% de los libros retirados que presentaban personajes LGBTQ+ incluían a esa demografía.

Más allá de las personas de color y las personas LGBTQ+, los libros que incluían personas con discapacidades también fueron afectados por las prohibiciones a nivel nacional. Aproximadamente el 10% de todos los títulos retirados incluían personajes con discapacidades físicas, de aprendizaje o del desarrollo, o que eran neurodivergentes. Varios de los libros afectados con personajes discapacitados se centraron en temas como «confianza, autoestima o experiencias con el capacitismo», según informó PEN America.

Mientras tanto, solo el 13% de los títulos eliminados incluían experiencias sexuales «en la página». Las experiencias sexuales implícitas o «fuera de la página» fueron mencionadas en el 31% de los libros prohibidos.

La gran mayoría de los libros prohibidos (85%) eran ficción, con un 14% de no ficción y un 1% de poesía. Aproximadamente el 67% de los libros eliminados eran para audiencias más jóvenes, según el informe de PEN America.

La continua prohibición de libros ocurre en un contexto en el que la administración Trump ha intensificado la represión de los esfuerzos de diversidad, equidad e inclusión (DEI) en las escuelas y universidades públicas de EE. UU. En un memorándum de la semana pasada, Trump amenazó con retener fondos federales de cualquier escuela que se negara a eliminar iniciativas de diversidad, como becas para estudiantes de ciertos grupos de identidad y programas escolares.

Un grupo de autores demandan a Meta por uso no autorizado de sus e-books en entrenamiento de IA

Wiggers, Kyle. «Law Professors Side with Authors Battling Meta in AI Copyright Case.» TechCrunch, April 11, 2025. https://techcrunch.com/2025/04/11/law-professors-side-with-authors-battling-meta-in-ai-copyright-case/

Un grupo de profesores especializados en derecho de autor ha presentado un informe amicus curiae en apoyo de los autores que están demandando a Meta, acusando a la empresa de entrenar sus modelos de inteligencia artificial Llama con libros electrónicos sin permiso.

El informe, presentado el viernes en el Tribunal de Distrito de los EE.UU. para el Distrito Norte de California, sostiene que la defensa de «uso legítimo» de Meta representa una solicitud exagerada de privilegios legales que nunca se han otorgado a los autores humanos.

Según el informe, el uso de obras con derechos de autor para entrenar modelos generativos no es «transformador», ya que no se diferencia de usar las obras para educar a autores humanos, que es uno de los propósitos originales de esas obras. Además, se argumenta que el uso tiene un propósito comercial, ya que permite la creación de trabajos que compiten directamente con las obras originales.

La Asociación Internacional de Editores Científicos, Técnicos y Médicos, junto con la Copyright Alliance y Association of American Publishers., también presentaron informes de apoyo a los autores.

En el caso Kadrey v. Meta, los autores Richard Kadrey, Sarah Silverman y Ta-Nehisi Coates acusan a Meta de violar sus derechos de propiedad intelectual al utilizar sus libros electrónicos para entrenar modelos y eliminar la información de derechos de autor para ocultar la infracción. Meta, por su parte, argumenta que su uso es legítimo y que el caso debe ser desestimado por falta de legitimación activa de los autores.

El juez del Tribunal de Distrito de EE. UU. Vince Chhabria permitió que el caso siguiera adelante, aunque desestimó parte de la demanda, señalando que la alegación de infracción de derechos de autor es suficiente para que los autores tengan legitimación para demandar.