Archivo de la categoría: Tecnologías de la información

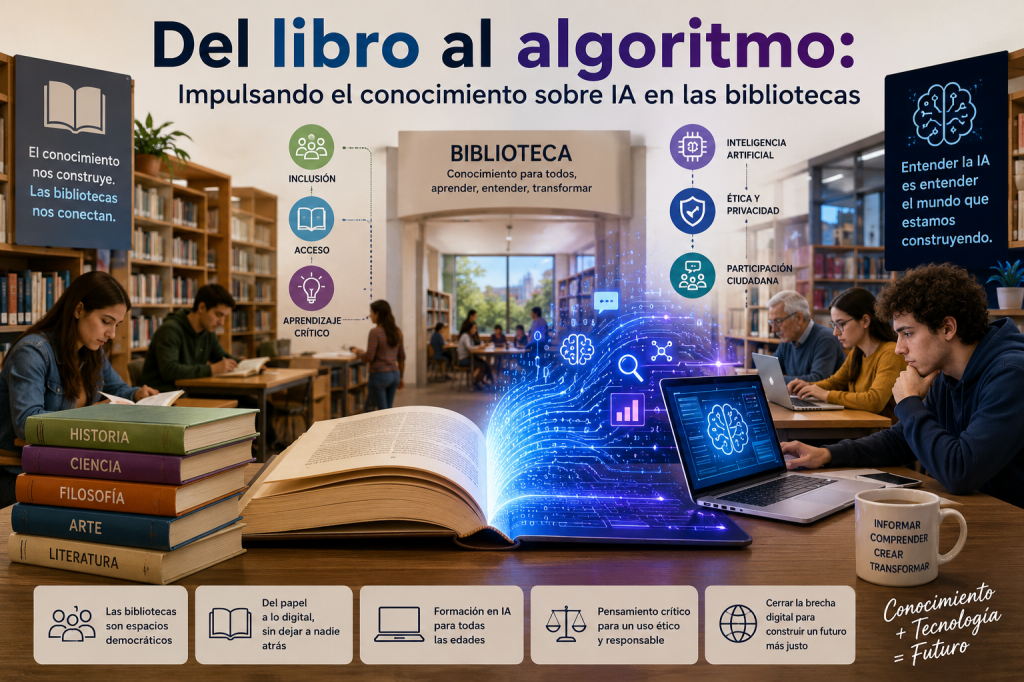
Del libro al algoritmo: impulsando el conocimiento sobre IA en las bibliotecas


Alonso Arévalo, J., & López Melguizo, I. (2025, 5–7 de noviembre). Del libro al algoritmo: Impulsando el conocimiento sobre IA en las bibliotecas [Comunicación en congreso]. XII Congreso Nacional de Bibliotecas Públicas, Palacio de Congresos de Granada, Granada, España.

Texto completo

Se plantea una profunda reflexión sobre el nuevo papel que deben desempeñar las bibliotecas en una sociedad donde la inteligencia artificial (IA) se ha convertido en una tecnología omnipresente. Los autores sostienen que la IA ya no constituye una innovación reservada a especialistas, sino un elemento que condiciona la vida cotidiana de millones de personas, desde los sistemas de recomendación que utilizan las plataformas digitales hasta los algoritmos que participan en procesos médicos, educativos, financieros o administrativos. Sin embargo, cuanto mayor es la presencia de la IA en nuestras vidas, menor suele ser el conocimiento que posee la ciudadanía sobre su funcionamiento, sus limitaciones y las implicaciones sociales, éticas y políticas que conlleva.

El trabajo parte de la idea de que la revolución provocada por la inteligencia artificial no es únicamente tecnológica, sino también cultural y social. Los algoritmos influyen cada vez más en la manera en que las personas acceden a la información, toman decisiones, consumen contenidos o interactúan con las instituciones. No obstante, la mayoría de estos procesos permanecen ocultos para los ciudadanos, funcionando como auténticas «cajas negras» cuyos mecanismos internos resultan prácticamente desconocidos. Esta falta de comprensión genera una nueva modalidad de analfabetismo, que los autores denominan analfabetismo digital crítico: la incapacidad para comprender cómo funcionan los sistemas algorítmicos que condicionan nuestra vida diaria.

Los autores advierten que esta situación tiene importantes consecuencias sociales. Las personas que desconocen el funcionamiento de la IA son mucho más vulnerables a la manipulación informativa, a la desinformación, a la pérdida de privacidad y a la exclusión de los debates sobre el desarrollo tecnológico. Además, la IA incorpora inevitablemente decisiones humanas, ya que los algoritmos son diseñados, entrenados y ajustados mediante datos que reflejan intereses, prioridades y, en muchos casos, prejuicios existentes en la sociedad. Por ello, la alfabetización en inteligencia artificial no debe limitarse a aprender a utilizar herramientas, sino que debe proporcionar capacidad crítica para comprender cómo se producen esas decisiones automatizadas, quién se beneficia de ellas y qué consecuencias generan para distintos colectivos sociales.

En este contexto, el artículo sitúa a las bibliotecas como las instituciones mejor preparadas para asumir una nueva misión educativa. Históricamente las bibliotecas han garantizado el acceso democrático al conocimiento, primero mediante los libros impresos, posteriormente facilitando el acceso a Internet y a los recursos digitales, y ahora deben contribuir a democratizar el conocimiento sobre la inteligencia artificial. Los autores consideran que las bibliotecas representan uno de los pocos espacios públicos donde cualquier ciudadano, independientemente de su edad, nivel educativo o situación económica, puede acceder gratuitamente tanto a recursos tecnológicos como a programas de formación. De esta manera, la biblioteca deja de ser únicamente un lugar de conservación documental para convertirse en un centro de aprendizaje permanente y participación ciudadana en la era digital.

El proyecto «Del libro al algoritmo» propone precisamente ampliar la misión tradicional de las bibliotecas sin abandonar sus valores históricos. Los libros continúan siendo fundamentales, pero ahora deben convivir con laboratorios digitales, espacios de creación, talleres tecnológicos y actividades relacionadas con la inteligencia artificial. La biblioteca pasa así de ser un lugar donde se consume conocimiento a un espacio donde también se crea, experimenta y reflexiona colectivamente sobre las nuevas tecnologías. Esta evolución resulta coherente con la transformación que ya han experimentado muchas bibliotecas mediante makerspaces, laboratorios de innovación y espacios colaborativos.

Uno de los aspectos centrales del artículo consiste en definir qué significa realmente la alfabetización en inteligencia artificial. Los autores adoptan el enfoque desarrollado por Stanford Teaching Commons, según el cual la alfabetización en IA comprende cuatro grandes dimensiones. La primera consiste en comprender cómo funcionan los sistemas de inteligencia artificial, incluyendo conceptos básicos como los datos de entrenamiento, los modelos de aprendizaje automático, las capacidades reales de estas herramientas y también sus limitaciones. La segunda dimensión se refiere a la ética de la IA, incorporando cuestiones relacionadas con los sesgos, la privacidad, la transparencia, la integridad académica y la fiabilidad de la información generada por los modelos. La tercera dimensión aborda la comunicación con la IA, enseñando a formular instrucciones eficaces mediante técnicas de prompting y comprendiendo cómo el lenguaje condiciona las respuestas obtenidas. Finalmente, la cuarta dimensión estudia el uso de la IA para mejorar los procesos de enseñanza y aprendizaje mediante metodologías pedagógicas innovadoras e inclusivas.

El artículo concede especial importancia al diseño pedagógico de los programas formativos. Los talleres no deben dirigirse únicamente a usuarios expertos, sino adaptarse a personas con distintos niveles de competencia digital. Para ello se propone una metodología gradual que comience utilizando ejemplos cotidianos fácilmente comprensibles, como recetas de cocina o procesos de organización de una biblioteca, para explicar qué es un algoritmo y cómo funciona. Posteriormente, el aprendizaje evoluciona hacia aplicaciones más complejas relacionadas con la salud, la educación, la administración pública o la justicia. Todo el proceso debe apoyarse en metodologías activas, colaborativas e inclusivas, donde los participantes aprendan experimentando directamente con herramientas de inteligencia artificial y compartiendo experiencias con otros usuarios.

Los autores consideran imprescindible que la formación sobre IA vaya mucho más allá del aprendizaje técnico. El objetivo principal consiste en desarrollar pensamiento crítico. Los participantes deben aprender no sólo cómo funcionan los algoritmos, sino también por qué funcionan de esa manera, quién los diseña, qué intereses reflejan y qué alternativas podrían existir. Para ello, los programas incluyen ejercicios destinados a analizar resultados generados por la IA, identificar errores, detectar sesgos y debatir las implicaciones éticas derivadas de su utilización. Esta dimensión crítica constituye uno de los pilares fundamentales del proyecto, ya que permite transformar a los usuarios en ciudadanos capaces de cuestionar la tecnología en lugar de aceptarla de forma pasiva.

Otro bloque del artículo describe con gran detalle los componentes que debería incluir un programa completo de alfabetización en IA desarrollado desde las bibliotecas. Los primeros módulos enseñan que los algoritmos están presentes en prácticamente todas las actividades cotidianas: buscadores de Internet, plataformas audiovisuales, filtros de correo electrónico, sistemas de navegación, asistentes virtuales o redes sociales. Posteriormente se introduce el aprendizaje automático explicando cómo las máquinas identifican patrones a partir de grandes cantidades de datos y cómo este proceso se diferencia del aprendizaje humano. El objetivo consiste en desmitificar la inteligencia artificial y mostrar que, aunque sus capacidades son extraordinarias, continúa dependiendo de datos, modelos matemáticos y decisiones humanas.

Uno de los apartados más desarrollados del trabajo analiza los sesgos algorítmicos. Los autores consideran que comprender este fenómeno constituye probablemente el aspecto más importante de toda la alfabetización en inteligencia artificial. Explican diferentes tipos de sesgos, entre ellos los derivados de los datos de entrenamiento, de la representación de determinados colectivos, de la confirmación de ideas previas o de los métodos utilizados para evaluar los sistemas. Para ilustrar estos problemas presentan casos reales de discriminación algorítmica en procesos de selección de personal, concesión de créditos bancarios y sistemas de justicia penal, demostrando cómo decisiones aparentemente técnicas pueden generar importantes desigualdades sociales. El programa propone que los participantes analicen estos casos mediante actividades prácticas para comprender de primera mano cómo se producen estos fenómenos.

El proyecto también dedica una atención significativa a la privacidad y al tratamiento de los datos personales. Los autores explican que la economía digital actual se basa en la recopilación masiva de información sobre los usuarios, convirtiendo los datos personales en uno de los principales activos económicos de las grandes empresas tecnológicas. Por ello, la alfabetización en IA debe incluir conocimientos sobre consentimiento informado, protección de la privacidad, configuración de redes sociales, navegación segura, cifrado de comunicaciones y comprensión de los modelos económicos basados en la vigilancia y la predicción del comportamiento humano. Los participantes aprenden que cuando utilizan servicios aparentemente gratuitos, en muchas ocasiones están intercambiando sus propios datos personales como forma de pago.

El artículo incorpora igualmente una dimensión jurídica y regulatoria mediante el análisis de la Ley Europea de Inteligencia Artificial (AI Act). Los autores explican que esta normativa establece un enfoque basado en el riesgo, imponiendo obligaciones de transparencia, evaluación de riesgos, supervisión y sanciones para los sistemas de IA de mayor impacto. La formación propuesta pretende que los ciudadanos comprendan estas normas y sean capaces de exigir responsabilidades cuando los sistemas automatizados afecten a sus derechos fundamentales. Para ello se plantean simulaciones donde los participantes representan distintos actores —desarrolladores, reguladores, usuarios o ciudadanos afectados— con el fin de comprender la complejidad de la gobernanza tecnológica.

Además de enseñar conocimientos técnicos, el programa desarrolla herramientas para evaluar críticamente cualquier sistema de inteligencia artificial. Los participantes aprenden a formular preguntas esenciales antes de confiar en una aplicación: qué problema pretende resolver, quién ha definido ese problema, qué datos utiliza, cómo fueron obtenidos, quién obtiene beneficios, qué riesgos existen para determinados colectivos y qué alternativas podrían plantearse. Esta metodología convierte la evaluación crítica en una competencia permanente que puede aplicarse a cualquier nueva tecnología que aparezca en el futuro.

Otro de los objetivos fundamentales consiste en reducir las desigualdades digitales. Los autores consideran que el conocimiento sobre IA no debe quedar restringido a universidades, grandes empresas tecnológicas o profesionales especializados. La alfabetización en inteligencia artificial debe llegar también a personas mayores, habitantes del medio rural, colectivos vulnerables y ciudadanos con escasa formación tecnológica. Las bibliotecas, por su carácter abierto e inclusivo, representan el entorno ideal para democratizar estos conocimientos y evitar que la revolución de la IA amplíe aún más las brechas sociales existentes.

El artículo dedica también un apartado específico al nuevo perfil profesional del bibliotecario. Según los autores, el bibliotecario del futuro ya no será únicamente un gestor de colecciones documentales, sino también un facilitador del aprendizaje digital, un curador de recursos tecnológicos y un mediador entre la complejidad técnica de la IA y las necesidades concretas de la ciudadanía. Para desempeñar esta función deberá adquirir conocimientos básicos sobre inteligencia artificial, metodologías docentes, experiencia de usuario, alfabetización digital y análisis de necesidades comunitarias. Asimismo, deberá organizar actividades participativas, foros de debate y programas de formación adaptados a los distintos perfiles de usuarios.

El artículo concluye afirmando que «Del libro al algoritmo» representa mucho más que un simple programa de formación tecnológica. Constituye una propuesta estratégica para redefinir el papel de las bibliotecas en la sociedad contemporánea. Al integrar la alfabetización en inteligencia artificial dentro de sus servicios, las bibliotecas fortalecen su misión histórica como instituciones democráticas dedicadas al acceso universal al conocimiento. La combinación entre el patrimonio bibliográfico tradicional y la comprensión crítica de los algoritmos permitirá que estas instituciones continúen siendo actores esenciales para la construcción de una ciudadanía informada, participativa y capaz de intervenir activamente en los debates sobre el futuro digital. Los autores sostienen que comprender la inteligencia artificial debe convertirse en un derecho ciudadano básico, y que las bibliotecas están llamadas a desempeñar un papel protagonista para hacerlo realidad.
¿Son realmente fiables los detectores de IA?

Nield, D. (19 de julio de 2026). Do AI Detectors Really Work? We Put Five to the Test. Popular Science. https://www.popsci.com/technology/do-ai-detectors-really-work-tech-tested/?utm_source=flipboard&utm_content=user/PopularScience

El crecimiento del uso de herramientas de inteligencia artificial como ChatGPT, Gemini o Claude ha generado una nueva preocupación en ámbitos como la educación, el periodismo, la contratación de personal y la creación de contenidos: ¿es posible distinguir con fiabilidad un texto escrito por una persona de otro generado por una IA? Para responder a esta pregunta, Popular Science realizó una prueba práctica con cinco de los detectores de IA más populares del mercado: Pangram, Grammarly, GPTZero, Scribbr y Copyleaks.

Los detectores de texto generado por inteligencia artificial se han convertido en una herramienta habitual en escuelas, universidades y empresas preocupadas por el uso de modelos como ChatGPT, Gemini o Claude. Sin embargo, una prueba realizada por Popular Science demuestra que estas aplicaciones están lejos de ser infalibles. El artículo evaluó cinco detectores ampliamente utilizados enfrentándolos tanto a textos escritos íntegramente por una persona como a otros producidos por diferentes modelos de IA.

El objetivo era comprobar si realmente pueden distinguir con precisión entre escritura humana y escritura artificial. Los resultados revelan que todos los sistemas analizados cometieron errores, aunque en distinta medida, lo que pone de manifiesto las limitaciones actuales de esta tecnología.

La principal conclusión es que ningún detector ofrece una fiabilidad del 100 %. Algunas herramientas identificaron correctamente buena parte de los textos generados por IA, pero también clasificaron como artificiales escritos completamente humanos (falsos positivos) y, a la inversa, consideraron como humanos algunos textos creados por modelos de lenguaje (falsos negativos). Esta variabilidad se debe a que los detectores no reconocen el origen real de un documento, sino que calculan la probabilidad de que un texto presente determinados patrones estadísticos característicos de la escritura generada por IA, como la baja «perplejidad» o una estructura lingüística especialmente uniforme.

Pangram: el detector más preciso

La primera herramienta evaluada fue Pangram, que se presenta como «un detector de IA que realmente funciona». En la prueba obtuvo un resultado perfecto. Reconoció correctamente ambos textos escritos por el autor como completamente humanos, asignándoles un 100 % de probabilidad de autoría humana y un alto grado de confianza. Del mismo modo, identificó correctamente los textos generados por ChatGPT y Claude como escritos íntegramente por IA. Además de emitir un porcentaje, explicó qué expresiones o estructuras habían influido en su decisión, señalando algunas frases típicas del estilo de los modelos de lenguaje.

Grammarly: muy fiable, aunque menos contundente

La segunda herramienta fue Grammarly, conocida tradicionalmente por sus funciones de corrección ortográfica y gramatical, pero que también incorpora un detector de IA. Los dos textos humanos fueron clasificados correctamente como escritos por una persona, sin detectar ningún patrón asociado a inteligencia artificial. Sin embargo, cuando analizó los textos generados por Claude y Gemini, sí detectó que probablemente habían sido creados mediante IA, aunque con un grado de confianza inferior al de Pangram: uno recibió una probabilidad del 68 % y el otro del 66 % de haber sido generado artificialmente. Es decir, Grammarly acertó en todos los casos, aunque mostró mayor cautela en sus conclusiones.

GPTZero: otra de las herramientas más fiables

El tercer detector fue GPTZero, una de las aplicaciones más conocidas en el ámbito educativo y universitario. Los dos textos escritos por el autor fueron clasificados como completamente humanos, indicando incluso que existía una elevada confianza en esa conclusión. Cuando analizó los textos producidos por Gemini y ChatGPT también los identificó correctamente como generados por inteligencia artificial. Una característica interesante de GPTZero es que no solo ofrece una valoración global, sino que señala las frases concretas que considera más características de un texto generado por IA. Sin embargo, el propio autor reconoce que, al revisar esas frases, no siempre resulta evidente qué rasgos específicos justifican dicha clasificación.

Scribbr: el gran decepcionante

La cuarta herramienta fue Scribbr, conocida principalmente por sus servicios de revisión académica. En este caso, el detector identificó correctamente los textos humanos como escritos por personas. Sin embargo, falló completamente al analizar los textos generados por IA, clasificándolos también como totalmente humanos. Lo más llamativo es que el sistema mostró una elevada confianza en sus conclusiones erróneas, lo que pone de manifiesto una calibración insuficiente para detectar contenidos generados por modelos actuales.

Copyleaks: resultados irregulares

El último detector analizado fue Copyleaks, una plataforma que también ofrece herramientas para detectar imágenes y vídeos generados mediante IA. Como ocurrió con los demás detectores, identificó correctamente los textos humanos. Sin embargo, al evaluar los textos generados por IA obtuvo resultados contradictorios: uno de ellos fue clasificado erróneamente como completamente humano, mientras que el otro fue detectado correctamente como generado por inteligencia artificial. Esta inconsistencia llevó al autor a concluir que la calibración del sistema todavía necesita mejoras.

DetectorTextos humanosTextos IAResultado
Pangram✔✔✔✔4/4
Grammarly✔✔✔✔4/4
GPTZero✔✔✔✔4/4
Scribbr✔✔✘✘2/4
Copyleaks✔✔✔✘3/4

El reportaje explica que basta con realizar pequeñas modificaciones en un texto generado por IA para dificultar considerablemente su detección. Una revisión manual, la incorporación de experiencias personales o incluso el uso de herramientas de reformulación pueden alterar los patrones lingüísticos que utilizan los detectores para emitir sus predicciones. Del mismo modo, textos escritos por personas con un estilo muy formal, repetitivo o académico pueden ser erróneamente etiquetados como contenidos generados por inteligencia artificial. Esta limitación resulta especialmente preocupante en el ámbito educativo, donde ya se han documentado casos de estudiantes acusados injustamente debido a la confianza excesiva depositada en estas herramientas.

Otra conclusión importante del análisis es que los detectores deben considerarse únicamente un indicio y nunca una prueba definitiva. El artículo coincide con numerosos investigadores y organismos educativos en que estas herramientas pueden servir para señalar textos que merecen una revisión más detallada, pero no deberían utilizarse como única evidencia para sancionar a un estudiante o cuestionar la autoría de un documento. La mejor práctica consiste en combinar su uso con otros métodos de evaluación, como el seguimiento del proceso de escritura, entrevistas con el autor, versiones previas del trabajo o actividades presenciales que permitan verificar el aprendizaje.

En conjunto, la prueba de Popular Science confirma que los detectores de IA siguen siendo una tecnología inmadura. Aunque han mejorado respecto a sus primeras versiones y pueden ofrecer información útil en determinados contextos, la rápida evolución de los modelos generativos hace que la carrera entre generación y detección sea cada vez más difícil. La tendencia actual apunta a que, más que confiar ciegamente en algoritmos de detección, instituciones educativas y organizaciones deberán desarrollar nuevas estrategias de evaluación y políticas de uso responsable de la inteligencia artificial.

La IA ya sabe lo que hiciste en Internet

Borchers, Callum. AI Knows What You Did Online. Now Your Employer Does, Too. The Wall Street Journal, 16 de julio de 2026. https://www.wsj.com/lifestyle/careers/ai-knows-what-you-did-online-now-your-employer-does-too-49796adc?st=xRecFU&mod=flipboard

La inteligencia artificial está transformando los procesos de selección de personal al permitir que las empresas examinen con mucha más profundidad la huella digital de candidatos y empleados. Lo que antes consistía en una búsqueda superficial en Google se ha convertido en análisis automatizados capaces de rastrear publicaciones, imágenes, comentarios y perfiles dispersos por decenas de plataformas, incluso cuando los usuarios creen haber permanecido en el anonimato. Herramientas especializadas combinan reconocimiento facial, análisis de redes sociales y correlación de datos públicos para reconstruir la actividad digital de una persona con gran precisión.

El artículo explica que esta práctica ya no se limita a altos directivos o cargos especialmente sensibles. Gracias a la reducción de costes y al aumento de la capacidad de la IA, las verificaciones digitales se están extendiendo a puestos de atención al público y a muchos procesos ordinarios de contratación. Las empresas buscan detectar comportamientos que puedan afectar a su reputación, identificar posibles conflictos con sus valores corporativos o evaluar el encaje cultural de los candidatos. En algunos casos, el seguimiento continúa incluso después de la contratación mediante sistemas de monitorización permanente de la actividad pública en Internet.

Uno de los aspectos más llamativos es que la IA puede recuperar información que parecía olvidada. Publicaciones antiguas en redes sociales, fotografías comprometedoras, comentarios realizados hace muchos años o participaciones en plataformas de contenido para adultos, apuestas o mercados de predicción pueden reaparecer durante un proceso de selección. El artículo cita ejemplos recientes de figuras públicas cuyas antiguas publicaciones o contenidos digitales dañaron gravemente sus carreras, ilustrando cómo la permanencia de la información en Internet se convierte en un factor de riesgo profesional.

Sin embargo, eliminar por completo la presencia digital tampoco constituye una solución. Los expertos consultados advierten de que una huella digital excesivamente limpia o recientemente borrada puede despertar sospechas entre los responsables de contratación. Algunas empresas incluso desarrollan herramientas para detectar perfiles con una presencia en línea anormalmente escasa, ya que esto puede interpretarse como un intento deliberado de ocultar información o incluso como un posible fraude de identidad.

El artículo concluye que la mejor estrategia no consiste en desaparecer de Internet, sino en gestionar activamente la reputación digital. Se recomienda revisar periódicamente qué información aparece al buscar el propio nombre, eliminar contenidos claramente perjudiciales cuando sea posible, reforzar la privacidad de las cuentas y generar una presencia profesional positiva mediante páginas personales, perfiles actualizados o publicaciones relacionadas con la actividad laboral. En la era de la inteligencia artificial, la reputación digital deja de ser un aspecto secundario para convertirse en un elemento cada vez más determinante en el acceso y la permanencia en el mercado laboral.

Un distrito escolar de Nueva York prueba un profesor robot con IA para apoyar la enseñanza

DiBenedetto, Chase. A New York School District Is Testing Robot Teachers. Mashable, 15 de julio de 2026. https://mashable.com/tech/new-york-school-testing-robot-teacher?utm_source=flipboard&utm_content=user/Mashable

El distrito escolar Salamanca City Central School District, situado en el estado de Nueva York, ha puesto en marcha un proyecto piloto para incorporar un profesor robot humanoide impulsado por inteligencia artificial en sus aulas de secundaria. La iniciativa, desarrollada en colaboración con la empresa canadiense Realbotix, introduce un asistente educativo denominado Sally, diseñado para complementar el trabajo de los docentes y ofrecer apoyo personalizado a los estudiantes tanto durante las clases como fuera del horario escolar. Según sus responsables, el sistema representa uno de los primeros despliegues reales de robots humanoides con IA en un entorno educativo estadounidense.

El robot forma parte de la serie M-Series de Realbotix y utiliza procesamiento del lenguaje natural, reconocimiento de expresiones faciales y capacidades conversacionales para interactuar con alumnos y profesores. Permanecerá sentado en el aula y podrá realizar movimientos del torso, la cabeza y el rostro para ofrecer una comunicación más natural. Además, los estudiantes podrán identificarse mediante un código personal para que el sistema acceda a su historial de aprendizaje y adapte las explicaciones, ejercicios y recomendaciones a las necesidades de cada uno. También estará disponible como asistente virtual las 24 horas para resolver dudas y ayudar con los deberes.

El proyecto comenzará en las asignaturas de Inteligencia Artificial y Robótica del instituto, integradas en el programa educativo Woz ED STEM Pathway, impulsado por Steve Wozniak para fomentar las competencias en ciencia, tecnología, ingeniería y matemáticas. Si la experiencia resulta satisfactoria, el distrito contempla ampliar el uso del robot a otras materias y cursos. El superintendente del distrito, Mark Beehler, defiende que la escuela debe enseñar a utilizar la inteligencia artificial de forma responsable en lugar de intentar prohibirla, ya que considera que estas herramientas formarán parte del futuro profesional de los estudiantes.

Los desarrolladores insisten en que Sally no sustituirá al profesorado, sino que actuará como un asistente pedagógico capaz de responder preguntas, ofrecer explicaciones adicionales, traducir contenidos, reforzar conceptos y proporcionar apoyo individualizado. Para minimizar riesgos, el sistema incorpora salvaguardas específicas para el ámbito educativo: está entrenado con el currículo del distrito y dispone de mecanismos para detectar conversaciones relacionadas con autolesiones, suicidio u otras situaciones de riesgo, notificándolas automáticamente a los responsables del centro.

No obstante, la iniciativa también ha generado interrogantes. Expertos y organizaciones educativas advierten de que la creciente presencia de la IA en las aulas puede incrementar la dependencia tecnológica, reducir el pensamiento crítico y acentuar desigualdades si se utiliza como sustituto del profesorado o como solución a la falta de recursos humanos. Estas preocupaciones se suman al debate nacional sobre el papel de la inteligencia artificial en la educación, en un momento en que diversos distritos escolares estadounidenses experimentan con asistentes inteligentes mientras padres, investigadore

Las habilidades cognitivas que podríamos estar perdiendo silenciosamente por culpa de la inteligencia artificial

Essel, Rocky. The Cognitive Skills We May Be Quietly Losing to AI. HackerNoon, 16 de julio de 2026. https://hackernoon.com/the-cognitive-skills-we-may-be-quietly-losing-to-ai?utm_source=flipboard&utm_content=other

Se plantea una reflexión sobre un efecto menos visible de la inteligencia artificial: su posible impacto en las capacidades cognitivas humanas. El autor sostiene que el verdadero desafío de la IA no reside únicamente en la automatización del trabajo o en la transformación de las profesiones, sino en el riesgo de que las personas dejen de ejercitar habilidades fundamentales como el razonamiento, la escritura, la memoria, la resolución de problemas o la creatividad. A medida que los asistentes inteligentes se convierten en herramientas habituales para estudiar, trabajar o tomar decisiones, existe el peligro de delegar progresivamente procesos mentales que hasta ahora contribuían al desarrollo de nuestras capacidades intelectuales.

Uno de los argumentos centrales es que la IA ofrece beneficios indiscutibles. Facilita la comunicación, democratiza el acceso al conocimiento, acelera el desarrollo de software, mejora la productividad profesional y permite que una sola persona pueda realizar tareas que antes requerían equipos completos. Además, ayuda a comprender documentos complejos, ofrece apoyo en ámbitos como la salud o el derecho y amplía las oportunidades de innovación y emprendimiento. Sin embargo, el autor advierte de que esta enorme utilidad puede ocultar un coste cognitivo: cuanto más dependemos de la IA para pensar, menor es el esfuerzo intelectual que realizamos por nosotros mismos.

El artículo establece una comparación entre la inteligencia artificial y las redes sociales. Mientras que los efectos psicológicos de estas últimas pudieron estudiarse porque millones de personas consumían contenidos similares, la IA genera conversaciones completamente personalizadas para cada usuario. Esa personalización convierte cada interacción en una experiencia única, lo que dificulta enormemente medir sus consecuencias cognitivas y emocionales. Según el autor, este carácter individualizado hace más complicado detectar patrones de dependencia o deterioro intelectual antes de que se conviertan en un problema generalizado.

Para ilustrar este fenómeno, el autor recurre a una experiencia personal relacionada con el uso constante de calculadoras. Explica cómo, tras años delegando operaciones sencillas en dispositivos electrónicos, descubrió que había perdido la agilidad para realizar cálculos mentales básicos. Utiliza este ejemplo como metáfora de lo que podría suceder con otras habilidades intelectuales si la inteligencia artificial comienza a asumir tareas de razonamiento, redacción, análisis o resolución de problemas. La preocupación no es que la tecnología realice esas funciones mejor que los humanos, sino que las personas dejen de practicarlas y, con ello, pierdan la destreza necesaria para ejecutarlas de forma autónoma.

Otro aspecto relevante es la preocupación por las nuevas generaciones. Los niños que crezcan rodeados de asistentes inteligentes podrían desarrollar formas de aprendizaje muy diferentes a las de generaciones anteriores. El autor se pregunta si seguirán experimentando el esfuerzo, el ensayo y error y la práctica continuada que tradicionalmente han permitido construir capacidades cognitivas sólidas. Aunque reconoce que es imposible predecir con exactitud qué competencias serán esenciales en el futuro, considera imprescindible reflexionar sobre cuáles no deberían dejarse completamente en manos de la inteligencia artificial.

Finalmente, el artículo evita ofrecer respuestas categóricas y concluye que la sociedad se encuentra ante una transformación de enorme magnitud cuyos efectos todavía desconocemos. Más que rechazar la inteligencia artificial, propone utilizarla con conciencia crítica, evitando que la búsqueda de eficiencia conduzca a una progresiva pérdida de autonomía intelectual. Diversos investigadores y expertos comparten preocupaciones similares, señalando que un uso excesivamente pasivo de la IA puede favorecer el denominado cognitive offloading (delegación cognitiva), reduciendo el pensamiento crítico y la capacidad de aprendizaje independiente si no se mantiene una participación activa del usuario.

Cómo cambian los comportamientos y valores de sus modelos de IA según el idioma y la versión utilizada.

Anthropic. (2026). Claude’s values across models and languages. Anthropic Research. https://www.anthropic.com/research/claude-values-models-languages

Anthropic presenta una investigación destinada a comprender cómo los modelos de la familia Claude expresan valores en sus respuestas y cómo estos varían tanto entre diferentes versiones del modelo como entre distintos idiomas.

El estudio se basa en el análisis de 309.815 conversaciones reales y anonimizadas mantenidas con Claude.ai, centradas exclusivamente en consultas subjetivas, es decir, aquellas en las que no existe una única respuesta correcta y en las que el sistema debe realizar juicios, recomendaciones o interpretaciones. A partir de este enorme conjunto de datos, los investigadores identificaron más de 3.300 valores presentes en las respuestas del modelo, que posteriormente agruparon en categorías más generales para construir un mapa del comportamiento ético y comunicativo de Claude.

Uno de los hallazgos más relevantes es que las diferencias entre modelos no se limitan al rendimiento técnico, sino que también afectan al estilo de interacción y a la forma en que el sistema manifiesta determinados valores. Mediante técnicas estadísticas de reducción de dimensiones, Anthropic identificó cuatro ejes fundamentales que describen estas variaciones: deferencia frente a cautela, calidez frente a rigor, profundidad frente a brevedad y franqueza frente a orientación a la ejecución. Así, algunos modelos muestran una mayor tendencia a ofrecer respuestas empáticas y alentadoras, mientras que otros privilegian el análisis crítico, la precisión o la objetividad. Estas diferencias son relativamente moderadas, pero suficientemente consistentes como para caracterizar la personalidad comunicativa de cada versión de Claude.

La investigación también demuestra que el idioma en el que interactúa el usuario influye de forma significativa en la expresión de estos valores. Claude no responde exactamente igual cuando conversa en inglés, español, ruso, árabe o hindi. Por ejemplo, las conversaciones en hindi tienden a reflejar un estilo más cálido y alentador, mientras que las realizadas en ruso presentan respuestas más rigurosas, analíticas y orientadas a solicitar evidencias. En inglés predominan la cautela y la profundidad argumentativa, mientras que otros idiomas muestran combinaciones distintas de franqueza, concisión o deferencia. Anthropic subraya que estas diferencias no implican que un idioma produzca respuestas mejores o peores, sino que reflejan patrones estadísticos derivados de las interacciones reales y de los contextos culturales asociados a cada lengua.

Otro aspecto importante del trabajo es que estas variaciones no fueron obtenidas mediante la traducción de los mismos mensajes a diferentes idiomas, sino analizando conversaciones auténticas desarrolladas por usuarios de todo el mundo. Esto significa que el estudio captura diferencias surgidas de los propios contextos culturales, de las expectativas de los usuarios y de las formas particulares de comunicación presentes en cada comunidad lingüística. Los investigadores advierten, por tanto, que los resultados describen tendencias observadas en la práctica y no permiten establecer relaciones causales ni afirmar que un idioma determine necesariamente un determinado comportamiento del modelo.

Anthropic considera que este tipo de investigaciones constituye un paso importante hacia el desarrollo de sistemas de inteligencia artificial más transparentes y alineados con los valores humanos. Comprender qué valores expresa un modelo, cómo cambian según el contexto lingüístico y cultural y cómo evolucionan entre diferentes generaciones de modelos permitirá diseñar mecanismos de evaluación más precisos y políticas de alineamiento más sofisticadas. En lugar de asumir que los modelos son completamente neutrales, el estudio propone entenderlos como sistemas cuya conducta refleja una compleja interacción entre entrenamiento, diseño, idioma y contexto de uso, abriendo nuevas líneas de investigación sobre la gobernanza ética y la adaptación cultural de los grandes modelos de lenguaje.

Lo que los líderes de la edición científica dicen realmente sobre la IA cuando no están en público

Toler, T., & Cochran, A. (11 de marzo de 2026). What Publishing Leaders Say About AI When They’re Not on Panels: A Pulse on All Things AI. The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/03/11/what-publishing-leaders-say-about-ai-when-theyre-not-on-panels/

El artículo recoge las conclusiones de una serie de conversaciones privadas con catorce directivos de editoriales académicas, principalmente de sociedades científicas y editoriales independientes, con el objetivo de conocer cómo perciben realmente el impacto de la inteligencia artificial más allá de los discursos públicos. Los autores destacan que, lejos del entusiasmo o del alarmismo que suele caracterizar los debates abiertos, los responsables editoriales mantienen una visión mucho más pragmática, centrada en los desafíos estratégicos, económicos y organizativos que plantea la IA para el sector.

Uno de los temas que más preocupa es el uso del contenido editorial para entrenar modelos de inteligencia artificial. Los directivos consideran que los datos y publicaciones científicas representan uno de sus principales activos y que la negociación de licencias con las empresas de IA puede convertirse en una nueva fuente de ingresos. Sin embargo, también reconocen que vender el acceso al contenido para el entrenamiento de modelos puede implicar riesgos, ya que esos modelos podrían reducir el valor futuro de las publicaciones originales al ofrecer respuestas sin necesidad de consultar las fuentes.

Otro aspecto relevante es el cambio en la forma en que los investigadores accederán a la información científica. Si las búsquedas tradicionales son sustituidas por asistentes inteligentes que sintetizan contenidos y responden directamente a las preguntas, los editores tendrán que replantearse su papel en el ecosistema de la comunicación científica. La preocupación ya no es únicamente proteger el contenido, sino garantizar que las publicaciones sigan siendo visibles, citadas y reconocidas como fuentes autorizadas dentro de los nuevos sistemas basados en IA.

Las conversaciones también reflejan que muchas organizaciones están experimentando con herramientas de inteligencia artificial para automatizar tareas editoriales, mejorar los flujos de trabajo y aumentar la eficiencia. No obstante, los líderes insisten en que la implantación de estas tecnologías debe hacerse con cautela, evaluando cuidadosamente sus implicaciones para la calidad editorial, la integridad científica y la confianza de autores, revisores y lectores. La IA se contempla como una herramienta de apoyo y no como un sustituto del criterio humano.

El artículo concluye que la transformación provocada por la inteligencia artificial obligará a las editoriales científicas a redefinir sus modelos de negocio. Más que competir con las empresas tecnológicas, deberán encontrar formas de aportar valor añadido mediante contenidos fiables, metadatos de calidad, sistemas de atribución, licencias sostenibles y relaciones duraderas con investigadores e instituciones. En este nuevo escenario, la confianza, la procedencia verificable de la información y la capacidad para integrarse en los ecosistemas de IA serán factores decisivos para el futuro de la edición académica.

Los centros de datos ya consumen casi tanta electricidad como todos los hogares de Irlanda

Paul Alcorn. Ireland’s data centers consumed nearly as much electricity as every home in the country combined in 2025 — server farms gulped 23% of national power despite years of grid restrictions. Tom’s Hardware, julio de 2026

Texto completo

El crecimiento de la inteligencia artificial está provocando un aumento sin precedentes en la demanda energética de los centros de datos, e Irlanda se ha convertido en uno de los ejemplos más llamativos de este fenómeno. El consumo trimestral de electricidad de los centros de datos aumentó un 584 %, pasando de 291 GWh en el primer trimestre de 2015 a 1.991 GWh en el cuarto trimestre de 2026.

Según los datos de la Oficina Central de Estadística irlandesa, en 2025 los centros de datos consumieron el 23 % de toda la electricidad del país, una cifra que se aproxima al 28 % utilizado por el conjunto de los hogares irlandeses. En términos absolutos, estas instalaciones emplearon 7.663 GWh, un 10 % más que el año anterior y un incremento de alrededor del 360 % desde 2015, reflejando el extraordinario crecimiento de la infraestructura digital asociada a la computación en la nube y, especialmente, a la inteligencia artificial.

El dato resulta especialmente significativo porque este aumento del consumo se ha producido a pesar de que Irlanda mantiene desde 2021 fuertes restricciones para conectar nuevos centros de datos a la red eléctrica, especialmente en la región de Dublín, donde se concentra la mayor parte de estas instalaciones. Sin embargo, los grandes operadores tecnológicos —entre ellos Microsoft, Google, AWS y Meta— han seguido incrementando la capacidad de los centros ya existentes para responder a la explosión de la demanda de servicios de IA y computación en la nube. Como consecuencia, el consumo eléctrico del sector ha continuado creciendo incluso sin un gran aumento del número de instalaciones.

Ante esta situación, el Gobierno irlandés ha sustituido la anterior moratoria por una nueva política energética para grandes consumidores eléctricos. Las futuras instalaciones deberán generar su propia energía o garantizar que una parte muy importante proceda de nuevas fuentes renovables, además de ubicarse preferentemente en zonas donde exista capacidad suficiente de generación eléctrica. El objetivo es evitar que el crecimiento de la infraestructura digital comprometa la estabilidad de la red, eleve los costes energéticos para los ciudadanos o retrase la transición hacia un sistema eléctrico más sostenible.

El caso de Irlanda ilustra un desafío que comienza a extenderse a escala mundial. La rápida expansión de los modelos de inteligencia artificial exige centros de datos cada vez más potentes y con un consumo energético muy superior al de generaciones anteriores. Diversos estudios prevén que el uso de electricidad por parte de los centros de datos seguirá creciendo de forma acelerada durante los próximos años, convirtiendo el acceso a la energía y la disponibilidad de redes eléctricas robustas en uno de los principales factores que condicionarán el desarrollo futuro de la IA.

Hacia un estándar global para declarar el uso de la inteligencia artificial en la investigación científica

Weaver, Kari D.; Seghers, Bert; McNeice, Kiera; Perkins, Mike; Santamarina, Sergio; Lingard, Lorelei; Tsybuliak, Natalia; Dijstal, Felix. «Guest Post — Research Needs a Shared Standard for AI Disclosure.» The Scholarly Kitchen, 13 de julio de 2026. The Scholarly Kitchen (artículo original)

El artículo sostiene que la investigación científica necesita con urgencia un estándar internacional y compartido para declarar el uso de herramientas de inteligencia artificial (IA) durante todo el ciclo de investigación.

Los autores argumentan que la aparición de modelos generativos como ChatGPT ha modificado profundamente la forma en que los investigadores redactan textos, analizan datos, revisan literatura, programan o traducen documentos. Sin embargo, mientras la adopción de estas herramientas se ha generalizado, las normas para informar sobre su utilización continúan siendo fragmentarias, inconsistentes y, en muchos casos, inexistentes. Esta falta de uniformidad genera incertidumbre entre autores, revisores, editores e instituciones y pone en riesgo principios esenciales de la integridad científica, como la transparencia, la reproducibilidad y la responsabilidad sobre los resultados publicados.

Los autores defienden que la declaración del uso de la IA debe entenderse como una práctica equiparable a la divulgación de las fuentes de financiación, los conflictos de interés o las contribuciones de terceros. En su opinión, informar sobre la utilización de herramientas de IA no debe interpretarse como una admisión de debilidad o una sospecha de mala conducta, sino como una manifestación de buenas prácticas científicas. No obstante, diversos estudios muestran que muchos investigadores evitan revelar el uso de estas tecnologías por temor a que disminuya la credibilidad de sus trabajos o influya negativamente en los procesos de evaluación editorial. Este fenómeno ha creado una importante «brecha de divulgación»: aunque la IA ya forma parte de las prácticas habituales de investigación, una proporción significativa de autores nunca informa sobre su utilización al publicar sus resultados.

Para afrontar este problema, el artículo describe la iniciativa impulsada desde la World Conferences on Research Integrity (WCRI), que ha creado un grupo de trabajo internacional con el apoyo de organizaciones como el International Science Council (ISC), COPE, STM y la Global Young Academy. El objetivo consiste en desarrollar un estándar de referencia mundial para la declaración del uso de IA, inspirado en modelos ampliamente aceptados como las normas de Vancouver para publicaciones biomédicas. El proceso se basa en varias rondas de consulta internacional dirigidas a investigadores, editores, responsables de integridad científica y otros actores del ecosistema académico, con el propósito de construir un consenso amplio antes de proponer un marco definitivo.

Los resultados preliminares de la primera consulta muestran que existe un amplio consenso sobre la necesidad de establecer reglas claras, aunque también revelan importantes desafíos. Los participantes coinciden en que cualquier sistema de declaración debe ser suficientemente flexible para adaptarse a disciplinas muy diversas y evitar imponer cargas administrativas excesivas a los investigadores. Asimismo, consideran fundamental determinar con precisión qué aspectos deben declararse, cuál debe ser el nivel adecuado de detalle y cómo integrar esa información en los manuscritos y en las infraestructuras editoriales existentes. También se debatió ampliamente cuál debe ser el verdadero propósito de estas declaraciones: facilitar la reproducibilidad de la investigación, reforzar la transparencia ética, mejorar la rendición de cuentas o combinar todos estos objetivos simultáneamente.

Otro de los mensajes centrales del artículo es que el uso de la inteligencia artificial no debe ser estigmatizado. Los autores sostienen que las herramientas de IA representan una nueva generación de tecnologías avanzadas, pero que los principios clásicos de la integridad científica siguen siendo plenamente aplicables. La responsabilidad última sobre el contenido científico continúa recayendo en los investigadores humanos, independientemente de las herramientas empleadas durante el proceso. Por ello, las declaraciones sobre IA deberían proporcionar únicamente la información necesaria para que revisores y lectores puedan valorar si las contribuciones de estas herramientas podrían haber influido en la fiabilidad de los métodos, los resultados o las conclusiones del estudio, evitando exigir una documentación innecesariamente detallada que dificulte la investigación.

Finalmente, los autores anuncian la apertura de nuevas rondas de consulta durante la segunda mitad de 2026 y principios de 2027 con el objetivo de perfeccionar una propuesta de estándar global. Subrayan que el éxito de esta iniciativa dependerá de la participación activa de investigadores, universidades, editoriales, financiadores y organismos de integridad científica de todo el mundo. Solo mediante un consenso internacional será posible establecer un sistema de divulgación que promueva la confianza en la investigación, facilite la evaluación de los trabajos científicos y permita integrar la inteligencia artificial en la ciencia de forma responsable, transparente y compatible con los principios fundamentales de la investigación académica.

Soberanía digital en Europa: ciudadanos y empresas reclaman una mayor autonomía tecnológica

Fundación Telefónica. Soberanía digital en Europa 2026. Madrid: Fundación Telefónica, 2026. https://www.fundaciontelefonica.com/soberania-digital-europa-2026/

El informe Soberanía digital en Europa 2026, elaborado por Fundación Telefónica en colaboración con Metroscopia, constituye el primer gran barómetro sobre la percepción que tienen ciudadanos y empresas españolas acerca de la autonomía tecnológica europea. El estudio analiza el grado de conocimiento del concepto de soberanía digital, las preocupaciones derivadas de la dependencia tecnológica de terceros países y las prioridades para reforzar la competitividad europea en un contexto marcado por la inteligencia artificial, la economía del dato y la creciente rivalidad geopolítica.

Los resultados muestran un amplio consenso sobre la necesidad de que Europa fortalezca sus capacidades tecnológicas. El 86 % de los ciudadanos y el 87 % de las empresas consideran imprescindible desarrollar tecnologías propias para competir en igualdad de condiciones con Estados Unidos y China. Asimismo, la mayoría percibe que la dependencia de plataformas, infraestructuras y servicios digitales extranjeros supone un riesgo estratégico para la economía, la seguridad y la capacidad de innovación europea.

El informe también pone de manifiesto una creciente preocupación por la protección de los datos personales y corporativos. Aunque el término «soberanía digital» aún es poco conocido entre la población, existe una elevada sensibilidad respecto al control de la información, la privacidad y la necesidad de que los datos críticos permanezcan bajo jurisdicción europea. En este contexto, una parte significativa de la ciudadanía estaría dispuesta a utilizar alternativas europeas si ofrecieran prestaciones equivalentes a las de los grandes proveedores internacionales.

Desde la perspectiva empresarial, la soberanía digital se considera un elemento clave para garantizar la resiliencia económica, impulsar la innovación y reforzar la competitividad. Las organizaciones identifican como prioridades el desarrollo de infraestructuras digitales propias, la inversión en inteligencia artificial, computación en la nube, ciberseguridad y talento tecnológico, junto con una mayor coordinación entre administraciones públicas, empresas y centros de investigación.

El estudio defiende que la soberanía digital debe entenderse no como un aislamiento tecnológico, sino como la capacidad de Europa para decidir sobre sus infraestructuras, datos y tecnologías estratégicas, preservando al mismo tiempo un modelo abierto basado en la innovación, la cooperación y los valores democráticos. Fundación Telefónica propone impulsar un ecosistema europeo que combine inversión, regulación, desarrollo tecnológico y formación para reducir las dependencias estratégicas y fortalecer la autonomía digital del continente