Archivo de la categoría: Tecnologías de la información

Las referencias a consultas en ChatGPT cambian según de sus procesos ocultos de búsqueda

Flowchart depicting ChatGPT refining a user query, retrieving information from scientific journals, web pages, and academic papers, and generating a final response with ranked citations.
Diagram showing ChatGPT’s process for refining queries, retrieving data, and citing credible sources.

Goodwin, Danny. “ChatGPT Citations Change When Hidden Search Pipelines Switch.” Search Engine Land, 9 de julio de 2026. https://searchengineland.com/chatgpt-citations-change-hidden-search-pipelines-481843

Un estudio reciente pone de manifiesto que las citas proporcionadas por ChatGPT no son tan estables como muchos usuarios podrían asumir. Aunque una misma pregunta se formule de manera idéntica, las fuentes citadas pueden variar significativamente cuando el sistema modifica de forma interna los mecanismos de búsqueda o los modelos encargados de recuperar información. Estos cambios, invisibles para el usuario, afectan directamente a qué documentos se consultan y cuáles terminan apareciendo como referencias en la respuesta final.

La investigación muestra que ChatGPT utiliza un proceso de recuperación de información mucho más complejo que una simple consulta a un buscador. El sistema genera múltiples búsquedas paralelas, reformula automáticamente la consulta inicial y selecciona distintas fuentes antes de sintetizar la respuesta. Si alguno de estos componentes cambia —ya sea el modelo de lenguaje, el sistema de recuperación o la estrategia de búsqueda— el conjunto de documentos recuperados también cambia, provocando diferencias en las citas ofrecidas al usuario.

Uno de los hallazgos más relevantes es que la reproducibilidad de las respuestas disminuye. Dos usuarios que planteen exactamente la misma pregunta en momentos diferentes pueden recibir respuestas muy similares desde el punto de vista del contenido, pero sustentadas en referencias completamente distintas. Esto representa un desafío para investigadores, periodistas, bibliotecarios y profesionales de la información, ya que dificulta la verificación de resultados y la documentación precisa de las fuentes utilizadas por la inteligencia artificial.

El artículo también destaca que la evolución de los modelos de ChatGPT modifica los patrones de citación. Cambios introducidos en nuevas versiones pueden reducir el número de dominios citados, favorecer determinadas fuentes consideradas más fiables o concentrar las referencias en un conjunto más reducido de sitios web. En consecuencia, la visibilidad de muchos recursos en Internet puede variar sin que sus contenidos hayan cambiado, simplemente porque el sistema de IA ha modificado sus criterios internos de selección.

Desde la perspectiva del posicionamiento web y de la denominada AI Search Optimization (AISO), estos resultados indican que optimizar un contenido para ser citado por sistemas de inteligencia artificial es un objetivo dinámico. La autoridad del dominio, la claridad de la información, la estructura del contenido y la presencia en índices de búsqueda continúan siendo factores importantes, pero no garantizan una presencia estable en las respuestas de ChatGPT, ya que las actualizaciones del sistema pueden alterar sustancialmente el comportamiento de las citas.

Finalmente, el estudio concluye que las citas generadas por los asistentes de IA deben interpretarse como el resultado de un proceso dinámico y probabilístico, más que como una lista fija de referencias. Para aplicaciones académicas o profesionales, los autores recomiendan verificar siempre las fuentes originales y no asumir que las citas proporcionadas por ChatGPT serán idénticas en futuras consultas, incluso cuando la pregunta permanezca sin cambios.

El impacto de la IA en las bibliotecas universitarias : productividad, mayor capacidad y supervisión humana en los flujos de trabajo

Emerging Strategy. 2026. Academic AI Impact: Measuring the Impact of AI Adoption on Academic Library Workflows. Estudio encargado por Clarivate. Consultado el 10 de julio de 2026. Academic AI Impact Study

PDF

La incorporación de herramientas de inteligencia artificial en las bibliotecas académicas está transformando de manera significativa los flujos de trabajo técnicos y de apoyo a la docencia. El estudio Academic AI Impact, elaborado por Emerging Strategy para Clarivate y comentado por Library Journal, analiza cómo la IA deja de ser una tecnología experimental para convertirse en una infraestructura cotidiana que complementa el trabajo profesional de los bibliotecarios. En lugar de sustituir al personal, la IA automatiza tareas repetitivas y libera tiempo para actividades que requieren criterio profesional, conocimiento especializado y capacidad de decisión.

La investigación se basa en entrevistas realizadas en ocho instituciones académicas que utilizan herramientas como Alma Metadata Assistant y Leganto Syllabus Assistant. Los resultados muestran reducciones del 30 al 60 % en el tiempo dedicado a tareas manuales, un incremento de la capacidad operativa de entre dos y cuatro veces sin necesidad de aumentar las plantillas y una elevada aceptación de los resultados generados por IA, ya que entre el 70 y el 90 % de los registros producidos requieren únicamente pequeñas correcciones antes de su validación definitiva. Asimismo, entre el 50 y el 60 % de las listas de lectura pueden ponerse a disposición de los estudiantes inmediatamente después del procesamiento automatizado.

Uno de los aspectos más relevantes del estudio es que la productividad obtenida no implica una reducción de la intervención humana. Al contrario, la IA se encarga de las fases iniciales de procesamiento —como la extracción de metadatos, la normalización de registros o el análisis de programas docentes— mientras que los bibliotecarios concentran su trabajo en la revisión, validación, resolución de excepciones y control de calidad. Este cambio supone una evolución del perfil profesional, orientándolo hacia funciones de supervisión, gobernanza de datos y toma de decisiones, donde el juicio humano continúa siendo imprescindible.

El informe también pone de relieve que la adopción de la IA mejora la consistencia y estandarización de los procesos. Al automatizar tareas susceptibles de variabilidad, las herramientas producen registros más homogéneos, reducen errores y aceleran la disponibilidad de recursos para estudiantes e investigadores. Esta mayor eficiencia permite además abordar atrasos históricos en catalogación, descubrir colecciones ocultas y responder con mayor rapidez a los picos de demanda asociados al inicio de los cursos académicos.

No obstante, tanto el estudio como el análisis de Library Journal insisten en que el éxito de estas tecnologías depende de mantener un equilibrio entre automatización y supervisión profesional. La IA debe entenderse como un sistema de apoyo y no como un sustituto del bibliotecario. Las instituciones necesitan establecer políticas de gobernanza, mecanismos de evaluación de la calidad, formación continua del personal y procedimientos transparentes que garanticen la fiabilidad, la responsabilidad y el uso ético de estas herramientas. La supervisión humana sigue siendo el elemento que asegura que los resultados producidos por la IA respondan a los estándares bibliográficos y a las necesidades reales de los usuarios.

En conjunto, el estudio presenta una visión optimista, pero prudente, del futuro de la inteligencia artificial en las bibliotecas académicas. Sus conclusiones indican que el principal beneficio no radica únicamente en ahorrar tiempo, sino en permitir que los profesionales dediquen más esfuerzo a actividades de alto valor añadido, como la curación de contenidos, la mejora de los servicios, el apoyo a la investigación y la innovación bibliotecaria. La IA aparece así como una tecnología de ampliación de capacidades, donde la productividad aumenta precisamente porque permanece el control y la experiencia del bibliotecario como elemento central del proceso.

Meta permite que cualquier persona utilice tus fotos públicas de Instagram para generar imágenes con IA

Rogers, Reece. Meta Now Lets Anyone Use Your Instagram Photos in AI Images—Unless You Opt Out. WIRED, 8 de julio de 2026. https://www.wired.com/story/meta-now-lets-anyone-use-your-instagram-photos-in-ai-images-unless-you-opt-out/?utm_source=flipboard&utm_content=user/WIRED

Meta ha introducido Muse Image, su primer modelo propio de generación de imágenes mediante inteligencia artificial, desarrollado por Meta Superintelligence Labs e integrado directamente en Instagram. La principal novedad es que las cuentas públicas de Instagram quedan, por defecto, autorizadas para que otros usuarios puedan utilizar sus fotografías públicas como referencia en la creación de imágenes generadas por IA.

Basta con mencionar el nombre de usuario de una cuenta pública en una solicitud dirigida a Meta AI para que el sistema emplee las imágenes de ese perfil como base para producir nuevas composiciones visuales. Esta decisión representa un importante cambio en la forma en que los contenidos compartidos en redes sociales pueden reutilizarse mediante inteligencia artificial y ha suscitado un intenso debate sobre el consentimiento y la privacidad digital.

El artículo explica que esta función está activada automáticamente para las cuentas públicas y que quienes no deseen participar deben deshabilitar manualmente la opción desde la configuración de Instagram, concretamente en el apartado «Sharing and reuse» (Compartir y reutilizar). Allí pueden desactivarse de forma independiente los permisos para publicaciones y Reels. No obstante, esta medida solo impide usos futuros: las imágenes generadas previamente mediante IA utilizando ese contenido no serán eliminadas. Además, Meta confirma que los propietarios de las fotografías no recibirán ninguna notificación cuando otra persona emplee sus imágenes para crear contenido generado por inteligencia artificial, lo que incrementa la preocupación por la falta de transparencia del sistema.

Desde la perspectiva de Meta, la nueva funcionalidad pretende facilitar la creación de invitaciones, diseños, ilustraciones y otros contenidos personalizados que incorporen personas reales a partir de sus perfiles públicos de Instagram. La empresa presenta esta integración como una forma de hacer más creativas y accesibles las herramientas de IA dentro de su ecosistema. Sin embargo, especialistas en privacidad consideran que la política de «opt-out» (exclusión voluntaria) vuelve a trasladar al usuario la responsabilidad de proteger sus propios datos, en lugar de solicitar previamente un consentimiento explícito mediante un modelo «opt-in». Este enfoque se suma a otras decisiones recientes de grandes compañías tecnológicas que utilizan contenidos públicos para entrenar o alimentar sistemas de inteligencia artificial.

El reportaje concluye señalando que la medida refleja la creciente integración entre las plataformas sociales y la inteligencia artificial generativa. A medida que estas tecnologías evolucionan, se intensifica el debate sobre los límites del uso de contenidos creados por los usuarios, la protección de la identidad digital y el equilibrio entre innovación tecnológica y derechos de privacidad. La recomendación implícita del artículo es que los usuarios revisen cuidadosamente la configuración de privacidad de sus cuentas y decidan de forma consciente si desean permitir que sus fotografías públicas puedan convertirse en materia prima para nuevas creaciones realizadas mediante inteligencia artificial.

La confianza en la interacción entre humanos e inteligencia artificial: un enfoque multidisciplinar para una IA digna de confianza

Coleman, B. (2026). Trust in Human–Artificial Intelligence Interactions: A Multidisciplinary Approach. White Paper. Schwartz Reisman Institute for Technology and Society, University of Toronto. Mayo de 2026. DOI: 10.2139/ssrn.6758420. El documento fue presentado públicamente por el instituto el 11 de junio de 2026. https://srinstitute.utoronto.ca/news/sri-releases-new-white-paper-on-trust-in-human-ai-interaction

El nuevo libro blanco publicado por el Schwartz Reisman Institute de la Universidad de Toronto plantea que la confianza en la inteligencia artificial constituye uno de los mayores desafíos para la adopción responsable de estas tecnologías. Lejos de considerar la confianza como un simple problema técnico o una cuestión de mejorar los algoritmos, el informe sostiene que se trata de un fenómeno complejo en el que intervienen factores tecnológicos, sociales, institucionales, jurídicos, psicológicos y éticos.

La investigación, liderada por Beth Coleman, reúne aportaciones de especialistas en informática, ingeniería, psicología, sociología, filosofía, historia, derecho y políticas públicas para construir un marco conceptual que explique cómo se genera, mantiene o pierde la confianza en los sistemas de IA.

Uno de los principales argumentos del documento es que debe abandonarse el objetivo de lograr que las personas «confíen en la IA» y sustituirlo por el propósito de desarrollar una IA realmente digna de confianza (trustworthy AI). Según los autores, la confianza no puede obtenerse mediante estrategias de persuasión o interfaces más atractivas, sino que debe ser consecuencia de sistemas cuyo funcionamiento sea demostrablemente fiable, transparentemente gobernado y socialmente responsable. En este sentido, la confianza no es una propiedad inherente de la tecnología, sino una relación dinámica entre las personas, los sistemas inteligentes y las instituciones que los diseñan, regulan y utilizan.

El informe identifica seis principios fundamentales sobre los que debe construirse la confianza en la interacción humano-IA. El primero es la fiabilidad y competencia, que exige que los sistemas funcionen de forma consistente y produzcan resultados precisos. El segundo es la conciencia del contexto, reconociendo que el comportamiento apropiado de una IA depende del entorno social, cultural y organizativo donde se aplica. El tercero combina transparencia, responsabilidad y legitimidad, subrayando que los usuarios deben comprender cómo se toman las decisiones y quién responde por ellas. El cuarto principio es la equidad e integridad, orientado a minimizar sesgos y garantizar un tratamiento justo. El quinto es la resiliencia, entendida como la capacidad de los sistemas para responder adecuadamente ante errores, cambios o situaciones imprevistas. Finalmente, el sexto principio destaca la importancia de las dinámicas relacionales, recordando que la confianza surge de la interacción continua entre usuarios, organizaciones y tecnologías, más que de las características técnicas del software por sí solas.

El documento sitúa estas reflexiones en el contexto de las políticas públicas canadienses sobre inteligencia artificial. Los autores señalan que la nueva estrategia nacional del país identifica explícitamente la confianza como el elemento central para conseguir una adopción social efectiva de la IA. Encuestas recientes muestran que la población mantiene una actitud ambivalente: existe un importante optimismo respecto al potencial económico y científico de la inteligencia artificial, pero también una preocupación creciente por sus riesgos. Esta dualidad convierte la confianza en un requisito indispensable para que gobiernos, empresas y ciudadanos acepten el despliegue de sistemas inteligentes en ámbitos sensibles como la sanidad, la educación, la administración pública o la justicia.

Como conclusión, el libro blanco propone un cambio de paradigma en la investigación y la gobernanza de la inteligencia artificial. La cuestión esencial ya no consiste únicamente en diseñar algoritmos más eficientes, sino en desarrollar sistemas capaces de demostrar que merecen la confianza pública mediante mecanismos de gobernanza, supervisión institucional, responsabilidad y alineamiento con los valores sociales. Desde esta perspectiva, la confianza deja de ser un atributo técnico para convertirse en un objetivo compartido entre ingenieros, científicos sociales, legisladores, responsables políticos y organizaciones que participan en el desarrollo y despliegue de la inteligencia artificial.

El mayor escándalo de fraude académico con IA en la Ivy League reabre el debate sobre la evaluación universitaria

Tangermann, V. (2026). Brown University Professor Horrified to Discover Largest AI Cheating Scandal in Ivy League History. Futurism, 30 de junio de 2026. https://futurism.com/artificial-intelligence/brown-university-professor-cheating-scandal-ivy-league?utm_source=flipboard&utm_content=other

El artículo analiza el que podría convertirse en el mayor caso documentado de fraude académico relacionado con inteligencia artificial en una universidad de la Ivy League. El protagonista es Roberto Serrano, profesor de Economía en Brown University, quien sostiene haber reunido pruebas concluyentes de un uso masivo de herramientas como ChatGPT durante un examen de evaluación continua. El caso ha despertado una intensa discusión sobre la eficacia de los actuales sistemas de evaluación y sobre el impacto que la inteligencia artificial generativa está teniendo en la educación superior.

Las sospechas surgieron tras corregir un examen parcial de una asignatura avanzada de Economía Matemática. De los 86 estudiantes matriculados, 40 obtuvieron la máxima calificación (100 sobre 100) y la nota media alcanzó los 96 puntos, unos resultados extraordinariamente inusuales para una prueba de ese nivel. Intrigado por estos datos, Serrano comparó varias respuestas con las generadas por ChatGPT y detectó coincidencias llamativas, incluyendo expresiones poco habituales y razonamientos prácticamente idénticos a los producidos por el modelo de inteligencia artificial. Según el profesor, la evidencia acumulada apuntaba claramente a un uso indebido de herramientas de IA durante un examen que debía resolverse de forma individual y bajo el código de honor de la universidad.

Las sospechas se reforzaron cuando llegó el examen final presencial. En esa prueba, que representaba una parte importante de la calificación definitiva, la nota media descendió hasta 48 puntos sobre 100, una diferencia difícil de explicar únicamente por la distinta naturaleza de los exámenes. Además, 27 estudiantes ni siquiera acudieron al examen final, entre ellos 22 que habían obtenido previamente una puntuación perfecta en la prueba domiciliaria. Para Serrano, esta enorme discrepancia constituye una evidencia empírica muy sólida de que una parte significativa de los estudiantes recurrió a la inteligencia artificial para resolver el examen realizado fuera del aula.

El artículo también pone el foco en la respuesta institucional. Según explica el profesor, la reacción inicial de la dirección universitaria fue muy limitada y no reflejó, a su juicio, la gravedad de los hechos. Aunque el caso terminó siendo remitido al comité encargado de velar por la integridad académica, Serrano lamenta la falta de una respuesta contundente por parte de las autoridades universitarias y advierte de que la defensa de la honestidad académica no puede recaer únicamente sobre el profesorado. Considera que las universidades necesitan políticas más claras y mecanismos de actuación mucho más ágiles para afrontar este nuevo escenario marcado por la inteligencia artificial generativa.

Más allá del episodio concreto, el artículo plantea una reflexión de alcance mucho mayor sobre el futuro de la evaluación universitaria. La aparición de modelos de lenguaje capaces de resolver problemas complejos, redactar ensayos o generar explicaciones de alta calidad cuestiona la validez de muchas formas tradicionales de examen, especialmente aquellas realizadas a distancia o sin supervisión. La experiencia descrita en Brown sugiere que los sistemas basados exclusivamente en la confianza o en el tradicional «Honor Code» pueden resultar insuficientes cuando los estudiantes tienen acceso inmediato a herramientas de IA extremadamente potentes.

En conjunto, el caso ilustra uno de los mayores desafíos que afronta actualmente la educación superior. Más que confiar en la detección del fraude mediante herramientas tecnológicas, el episodio refuerza la necesidad de rediseñar los métodos de evaluación para valorar competencias difíciles de delegar en una IA, como el razonamiento crítico, la argumentación, la resolución de problemas en contextos auténticos o la defensa oral del trabajo realizado. El escándalo de Brown evidencia que la irrupción de la inteligencia artificial no solo obliga a replantear las normas de integridad académica, sino también el propio modelo de enseñanza y evaluación sobre el que se ha sustentado la universidad durante décadas.

¿Qué puede hacer un autor? Las bibliotecas piratas en la era de la inteligencia artificial

Person standing near digital AI output connecting to pirate library bookshelves
A person contemplates AI generation fueled by unlicensed pirate libraries.

Swartz, M. (2026). What’s an Author to Do? Shadow Libraries in the Age of AI. Slaw, 8 de mayo de 2026. https://www.slaw.ca/2026/05/08/whats-an-author-to-do-shadow-libraries-in-the-age-of-ai/

La irrupción de la inteligencia artificial generativa ha transformado profundamente el debate sobre las denominadas shadow libraries o bibliotecas piratas. En este artículo, Mark Swartz analiza cómo plataformas como Anna’s Archive, heredera de LibGen y Sci-Hub, han dejado de ser únicamente repositorios de obras distribuidas sin autorización para convertirse en una fuente estratégica de datos destinada al entrenamiento de grandes modelos de lenguaje (LLM).

El detonante de esta nueva etapa ha sido la demanda presentada por las cinco mayores editoriales comerciales del mundo contra “Anna’s Archive”, en la que ya no solo se denuncia la vulneración de los derechos de autor, sino también el suministro masivo de libros y artículos a empresas desarrolladoras de inteligencia artificial.

El autor sostiene que el desarrollo acelerado de la IA ha generado un vacío ético y normativo en el que los intereses tecnológicos avanzan mucho más deprisa que la legislación. En ese contexto, millones de libros, artículos científicos y otros contenidos protegidos han sido incorporados a los conjuntos de entrenamiento de los modelos de IA sin el consentimiento de sus autores ni una compensación económica. Swartz recuerda que las bibliotecas piratas han adquirido un papel central porque proporcionan enormes colecciones de textos ya digitalizados, accesibles y estructurados, lo que las convierte en una fuente extremadamente atractiva para las empresas tecnológicas que compiten por desarrollar modelos cada vez más potentes.

El artículo repasa algunos de los litigios más relevantes que ilustran esta nueva realidad. Entre ellos destaca el caso contra Meta por el uso del conjunto de datos Books3, formado por cerca de 200.000 libros obtenidos de forma ilícita, así como el procedimiento contra Anthropic, cuya estrategia de digitalización masiva de millones de libros desembocó en uno de los mayores acuerdos económicos relacionados con derechos de autor en el ámbito de la inteligencia artificial. Estos casos muestran que el conflicto jurídico ya no gira únicamente en torno a la copia ilegal de obras, sino sobre el uso sistemático de esos contenidos para entrenar sistemas capaces de generar nuevos textos, imágenes o respuestas basadas en ese conocimiento acumulado.

Swartz también llama la atención sobre el papel de las propias editoriales académicas y comerciales. Mientras denuncian el uso ilícito de sus publicaciones por parte de las bibliotecas piratas, muchas de ellas han comenzado simultáneamente a negociar acuerdos de licencia con compañías de inteligencia artificial para permitir el entrenamiento de modelos utilizando sus catálogos. En algunos casos, los propios autores han conocido estos acuerdos únicamente a través de comunicados de prensa. Frente a este panorama, el autor destaca iniciativas más transparentes, como la de Cambridge University Press, que permite a los autores excluir sus obras del entrenamiento de IA y contempla mecanismos de compensación económica. Esta evolución refleja, según Swartz, una transformación del sector editorial, que pasa de comercializar información a gestionar grandes volúmenes de datos con valor para la industria de la inteligencia artificial.

En la parte final del artículo, el autor se pregunta qué opciones reales conservan escritores e investigadores para proteger sus obras. La respuesta es poco optimista: probablemente la mayor parte de los contenidos publicados en inglés ya han sido utilizados para entrenar uno o varios modelos de lenguaje. Aunque empiezan a surgir iniciativas como Creative Commons (CC) Signals, destinadas a permitir que los titulares de derechos indiquen cómo desean que sus obras sean utilizadas por sistemas de IA, su eficacia dependerá de que las empresas desarrolladoras respeten voluntariamente esas señales. A la vista de los antecedentes de utilización de contenidos procedentes de bibliotecas piratas, Swartz considera que esa confianza resulta difícil de sostener.

En conjunto, el artículo plantea una reflexión de gran actualidad sobre el delicado equilibrio entre innovación tecnológica, acceso al conocimiento y protección de la propiedad intelectual. Más allá del problema jurídico, pone de relieve cómo la inteligencia artificial está alterando las relaciones tradicionales entre autores, editoriales, bibliotecas y empresas tecnológicas, obligando a replantear los modelos de acceso, compensación y gestión de los contenidos en la economía digital.

El sesgo de la verdad y la inteligencia artificial: por qué creemos lo que confirma nuestras ideas

Malespina, E. (2026). Truth Bias and AI #182. The AI School Librarian Newsletter (Substack). https://aischoollibrarian.substack.com/p/truth-bias-and-ai-race-representation

El artículo analiza un fenómeno psicológico conocido como truth bias (sesgo de la verdad), la tendencia humana a aceptar como verdadero aquello que coincide con nuestras creencias previas y a rechazar o cuestionar automáticamente aquello que las contradice. La autora sostiene que la llegada de la inteligencia artificial no ha creado este sesgo, sino que lo ha hecho mucho más visible.

En un entorno saturado de contenidos generados por IA, desinformación y polarización, muchas personas han comenzado a utilizar la mera sospecha de que un texto o una imagen ha sido creada mediante inteligencia artificial como argumento suficiente para desacreditarla, independientemente de las pruebas o de la calidad de la evidencia que la respalde.

Uno de los argumentos centrales del artículo es que la expresión «eso lo ha hecho la IA» se está convirtiendo en una nueva forma de descalificación. Cuando una información confirma nuestras expectativas solemos aceptarla sin demasiadas preguntas; cuando cuestiona nuestras convicciones, con frecuencia la descartamos atribuyéndola a la inteligencia artificial, a un montaje o a una falsificación. Este comportamiento desplaza el foco desde el análisis crítico de las pruebas hacia el origen supuesto del contenido. La autora advierte que esta actitud representa un riesgo para la alfabetización informacional, ya que sustituye la evaluación de las evidencias por juicios basados en prejuicios tecnológicos.

Desde la perspectiva de las bibliotecas y la educación, Malespina sostiene que el desafío ya no consiste únicamente en enseñar a identificar contenidos generados por IA, sino en desarrollar competencias para valorar la calidad de la información independientemente de la herramienta utilizada para producirla. Una afirmación no es verdadera o falsa por haber sido redactada por una persona o por un sistema de inteligencia artificial; su credibilidad depende de la existencia de fuentes verificables, de la coherencia de los argumentos y de la posibilidad de contrastar las evidencias. En este sentido, el pensamiento crítico debe orientarse hacia la evaluación de los hechos y no hacia la búsqueda obsesiva de indicios de uso de IA.

El artículo también llama la atención sobre el peligro de confiar excesivamente en los detectores automáticos de contenido generado por IA. Numerosas investigaciones han demostrado que estos sistemas producen un número significativo de falsos positivos y falsos negativos, llegando incluso a señalar como artificiales textos escritos íntegramente por personas. Basar decisiones académicas o profesionales únicamente en estos detectores puede provocar acusaciones injustificadas y erosionar la confianza entre docentes, estudiantes e investigadores. Por ello, la autora defiende que la evidencia debe prevalecer siempre sobre la sospecha tecnológica.

Otro aspecto destacado es que la inteligencia artificial está modificando la manera en que construimos la confianza. Tradicionalmente, la credibilidad se asociaba a la autoridad de una institución, un medio de comunicación o un experto. En la actualidad, la proliferación de contenidos sintéticos obliga a trasladar esa confianza desde el emisor hacia los procesos de verificación. Esto implica enseñar a comprobar referencias, rastrear el origen de las afirmaciones, contrastar distintas fuentes y comprender las limitaciones tanto de los modelos de IA como de los propios seres humanos, que también están sujetos a sesgos cognitivos.

Finalmente, Malespina concluye que las bibliotecas y los profesionales de la información tienen un papel decisivo en este nuevo escenario. Más que actuar como «detectores de IA», deben convertirse en formadores de ciudadanos capaces de distinguir entre evidencia y opinión, entre verificación y especulación, y entre confianza justificada y aceptación automática. La alfabetización en inteligencia artificial debe integrarse con la alfabetización mediática e informacional para enseñar que el verdadero criterio de calidad de una información no es quién —o qué— la ha producido, sino la solidez de las pruebas que la sustentan. En una sociedad donde la IA participa cada vez más en la creación y difusión del conocimiento, la capacidad para evaluar críticamente la evidencia se convierte en una competencia esencial para preservar la integridad intelectual y el debate democrático.

La inteligencia artificial ya forma parte de la revisión por pares: es hora de que las políticas editoriales lo reconozcan

Vicario, E. (2026). Guest Post — Now is the Time for AI in Peer Review, and Publishing Policies Need to Recognize This. The Scholarly Kitchen, 30 de junio de 2026.

Se plantea que el debate sobre la utilización de la inteligencia artificial en la revisión por pares (peer review) ha dejado de ser una cuestión de futuro para convertirse en una realidad que las políticas editoriales deben afrontar de manera explícita. La autora sostiene que la IA ya está profundamente integrada en numerosos procesos de la comunicación científica —desde la detección de plagio y la identificación de manipulaciones de imágenes hasta el descubrimiento de patrones asociados a las «paper mills» o fábricas de artículos fraudulentos—, por lo que resulta incoherente prohibir o restringir su utilización precisamente en una de las fases más importantes del proceso editorial: la evaluación por pares.

Vicario parte de un diagnóstico ampliamente compartido en la comunidad científica: la inteligencia artificial ha acelerado tanto las posibilidades legítimas de producción científica como las formas industrializadas de fraude académico. Las investigaciones recientes sobre redes organizadas de generación masiva de artículos falsos muestran que las herramientas basadas en IA están siendo utilizadas para fabricar investigaciones fraudulentas a gran escala. Sin embargo, la autora defiende que la respuesta no puede consistir en excluir la IA del ecosistema editorial, sino en emplearla también para combatir esas mismas amenazas. En su opinión, si la inteligencia artificial forma parte del problema, necesariamente debe formar parte de la solución.

El texto subraya que los grandes editores científicos ya utilizan sistemas inteligentes para examinar los manuscritos antes de que lleguen a los revisores humanos. Estas herramientas permiten detectar manipulaciones de imágenes, similitudes textuales, anomalías en las citas, patrones característicos de artículos producidos por «paper mills» y otros indicios de fraude científico. Plataformas como el STM Integrity Hub representan, según la autora, un ejemplo de cómo la IA se ha convertido en una infraestructura habitual para preservar la integridad de la literatura científica. Desde esta perspectiva, la pregunta ya no es si la inteligencia artificial tiene cabida en la publicación científica, sino cómo debe gobernarse su utilización de forma ética y transparente.

El núcleo del artículo se centra en la revisión por pares, un ámbito donde persisten fuertes restricciones debido a preocupaciones relacionadas con la confidencialidad de los manuscritos inéditos, la privacidad de los datos y el riesgo de delegar en algoritmos decisiones que requieren juicio científico. Vicario reconoce que estas preocupaciones son legítimas, pero considera que las políticas actuales han quedado desfasadas respecto a la práctica real. En su experiencia, numerosos revisores ya emplean discretamente herramientas de IA para resumir manuscritos, comprobar análisis estadísticos, revisar código, mejorar la redacción o identificar posibles inconsistencias. La ausencia de normas claras no elimina este uso; simplemente lo convierte en una práctica invisible y no regulada.

La autora también sitúa este debate en el contexto de la creciente crisis del sistema de revisión por pares. El número de manuscritos sometidos a evaluación continúa aumentando mientras disminuye la disponibilidad de revisores expertos, que soportan una carga de trabajo cada vez mayor. Diversos estudios citados muestran un incremento de la fatiga de los revisores y una distribución desigual del esfuerzo de evaluación. En este escenario, la IA podría actuar como una herramienta de apoyo que permitiera automatizar tareas rutinarias y liberar tiempo para aquellas actividades donde el criterio humano resulta insustituible: valorar la originalidad de una investigación, la solidez metodológica, la relevancia de los resultados o la contribución al conocimiento científico.

Uno de los aspectos más relevantes del artículo es su propuesta de sustituir el actual debate dicotómico —permitir o prohibir la IA— por un marco de gobernanza basado en principios comunes para toda la comunidad científica. Vicario propone cinco pilares fundamentales. El primero es la transparencia, de modo que los revisores declaren cuándo y cómo han utilizado herramientas de inteligencia artificial sin temor a ser penalizados. El segundo es la responsabilidad, dejando claro que el juicio científico corresponde siempre al revisor humano, independientemente del apoyo tecnológico recibido. El tercero consiste en establecer límites claros sobre las tareas que la IA puede desempeñar —como resumir textos, mejorar el lenguaje o analizar estructuras— y aquellas que deben permanecer exclusivamente bajo criterio humano, como evaluar la novedad científica o la calidad metodológica. A ello añade la necesidad de garantizar la confidencialidad mediante herramientas que respeten estándares adecuados de protección de datos y, finalmente, implantar mecanismos de supervisión editorial que hagan visible, auditable y controlable el uso de la IA durante todo el proceso de evaluación.

El artículo concede un papel especialmente relevante al Committee on Publication Ethics (COPE), organización que durante años ha establecido las principales referencias éticas para la publicación científica. Aunque COPE ya ha comenzado a elaborar documentos de discusión y posicionamientos sobre inteligencia artificial, Vicario considera que todavía falta una guía práctica específica dirigida a revisores y editores que unifique criterios y reduzca la actual fragmentación de políticas entre editoriales, universidades y organismos financiadores. La autora también menciona las discusiones mantenidas durante la edición de 2026 de la World Conference on Research Integrity como una oportunidad para construir un consenso internacional sobre estos principios.

En conjunto, el texto constituye una defensa de un uso responsable, regulado y transparente de la inteligencia artificial en la revisión por pares. No propone sustituir el juicio de los expertos por algoritmos, sino integrar estas herramientas como apoyo dentro de un sistema donde la responsabilidad última siga correspondiendo a los revisores humanos. Para la autora, ignorar que la IA ya está presente en la práctica cotidiana solo incrementará la distancia entre las normas oficiales y el funcionamiento real de la comunicación científica. El verdadero desafío no consiste en decidir si la inteligencia artificial debe participar en la revisión por pares, sino en establecer un marco común que garantice confianza, transparencia e integridad en su utilización.

¿Es el artículo científico la próxima víctima de la inteligencia artificial? La transformación radical de la comunicación científica

Requarth, Tim. “The next unit of science: Is the scientific paper due to be replaced?” En The Transmitter, sección From Bench to Bot, 11 de mayo de 2026. Publicado en el medio especializado The Transmitter: Neuroscience News and Perspectives

El artículo de plantea una cuestión profundamente disruptiva para el ecosistema académico contemporáneo: si el tradicional artículo científico —la unidad fundamental de comunicación del conocimiento desde hace más de tres siglos— está entrando en una fase terminal debido al avance de la inteligencia artificial.

La reflexión parte de una perspectiva histórica, recordando que antes de la aparición de las revistas científicas en el siglo XVII, los investigadores publicaban extensos tratados, como hizo Johannes Kepler en Astronomia Nova o Isaac Newton en su célebre Principia. La aparición de publicaciones periódicas, como Philosophical Transactions de la Royal Society, permitió acelerar el intercambio de resultados científicos, fragmentando el conocimiento en unidades más pequeñas y dinámicas: el paper. Durante siglos, este modelo fue extraordinariamente exitoso y permitió avances acumulativos que definieron la ciencia moderna.

Sin embargo, según el autor, ese modelo ha comenzado a mostrar signos evidentes de agotamiento, y la irrupción de la inteligencia artificial no hace sino acelerar una crisis que ya existía. Herramientas basadas en modelos de lenguaje permiten hoy producir artículos académicos a una velocidad sin precedentes, hasta el punto de saturar completamente el sistema de revisión por pares. Se menciona el caso de investigadores que generan versiones casi idénticas de estudios reutilizando bases de datos públicas con ligeras modificaciones textuales para evitar sistemas antiplagio, así como el desarrollo de sistemas automatizados como Paper Orchestra, presentado por Google, capaz de transformar notas de laboratorio en un manuscrito científico completo, con figuras y referencias verificadas, en apenas cuarenta minutos. Esta automatización masiva amenaza directamente uno de los pilares del sistema científico: la evaluación rigurosa realizada por expertos humanos, cuyos tiempos y capacidades están siendo desbordados.

Frente a esta situación, diversos científicos comienzan a proponer un replanteamiento radical de la propia estructura de la publicación académica. El artículo analiza especialmente el proyecto OpenEval, desarrollado por investigadores como Lior Pachter y colaboradores, que propone descomponer cada paper en unidades verificables: afirmaciones concretas, evidencias que las sustentan y evaluaciones automatizadas de la consistencia de dichas evidencias. Aplicado a cerca de 16.000 artículos de la revista eLife, el sistema logró identificar casi dos millones de afirmaciones individuales y mostró una capacidad de evaluación comparable a revisores humanos, aunque con una cobertura significativamente superior. La idea central consiste en separar dos funciones que actualmente están fusionadas en el paper: por un lado, la comunicación estructurada de resultados; por otro, la narrativa interpretativa que contextualiza esos hallazgos.

El texto presta especial atención a cómo esta transformación podría beneficiar disciplinas particularmente fragmentadas como la neurociencia. En campos donde conviven investigaciones sobre genética molecular, sinapsis neuronales, comportamiento, neuroimagen o psicología experimental, gran parte del conocimiento permanece aislado en compartimentos estancos porque ningún investigador puede procesar el volumen total de publicaciones existentes. Sistemas de conocimiento estructurado y legible por máquinas permitirían conectar automáticamente descubrimientos relacionados que actualmente permanecen invisibles entre sí. El autor cita ejemplos concretos en los que investigaciones independientes sobre mecanismos sinápticos similares no llegaron a citarse mutuamente pese a sus implicaciones complementarias, un problema que podría resolverse mediante bases de conocimiento interconectadas alimentadas por inteligencia artificial.

Más radical todavía es la propuesta formulada por la física italiana Francesca Colaiori, quien imagina una futura red adaptativa del conocimiento donde el paper desaparece por completo como unidad principal y es sustituido por “objetos de conocimiento”: hipótesis, conjuntos de datos, métodos, preguntas abiertas o resultados experimentales individuales que se conectan dinámicamente entre sí, de manera similar a una gigantesca enciclopedia científica colaborativa. En este escenario, publicar dejaría de consistir en redactar un artículo cerrado y pasaría a parecerse más a editar una red viva de conocimiento colectivo. Paralelamente, revistas como NEJM AI ya experimentan con sistemas híbridos en los que revisores humanos trabajan junto a modelos de lenguaje que generan informes automatizados, reduciendo el tiempo entre envío y aceptación a apenas siete días.

No obstante, Requarth introduce una advertencia crucial frente a este entusiasmo tecnológico. El acto mismo de escribir un artículo científico no es únicamente un mecanismo administrativo de comunicación, sino una parte fundamental del proceso intelectual del investigador. La dificultad de redactar obliga a clarificar ideas, detectar incoherencias metodológicas, reorganizar argumentos y descubrir debilidades conceptuales que a menudo no se perciben durante la experimentación. Automatizar completamente la escritura científica podría eliminar precisamente ese proceso cognitivo donde muchas veces surge una comprensión más profunda del propio descubrimiento. En otras palabras, aunque el artículo científico sea un formato imperfecto como contenedor de datos, podría seguir desempeñando una función intelectual esencial que no resulta fácilmente reemplazable por sistemas automatizados.

El ensayo sitúa a la ciencia en un momento histórico comparable a la transición que siglos atrás llevó del tratado erudito al artículo breve de revista. Así como aquel cambio revolucionó la velocidad y naturaleza del progreso científico, la inteligencia artificial podría estar impulsando una nueva mutación estructural en la forma en que la humanidad organiza, valida y comparte el conocimiento. El paper tradicional, argumenta el autor, ya está siendo superado de facto por un ecosistema caótico formado por archivos suplementarios interminables, repositorios de datos, código sin documentar y bases distribuidas en múltiples plataformas. La pregunta ya no sería si el artículo científico desaparecerá, sino qué nueva arquitectura sustituirá ese modelo y cómo preservar, en medio de esa transición tecnológica, la dimensión profundamente humana del pensamiento científico. El futuro de la investigación, concluye Requarth, dependerá de encontrar un equilibrio entre la eficiencia algorítmica y la reflexión intelectual que durante siglos ha definido el acto mismo de hacer ciencia.

¿De quién es realmente una respuesta generada por inteligencia artificial? Propiedad intelectual, autoría y dilemas emergentes en la era de la IA

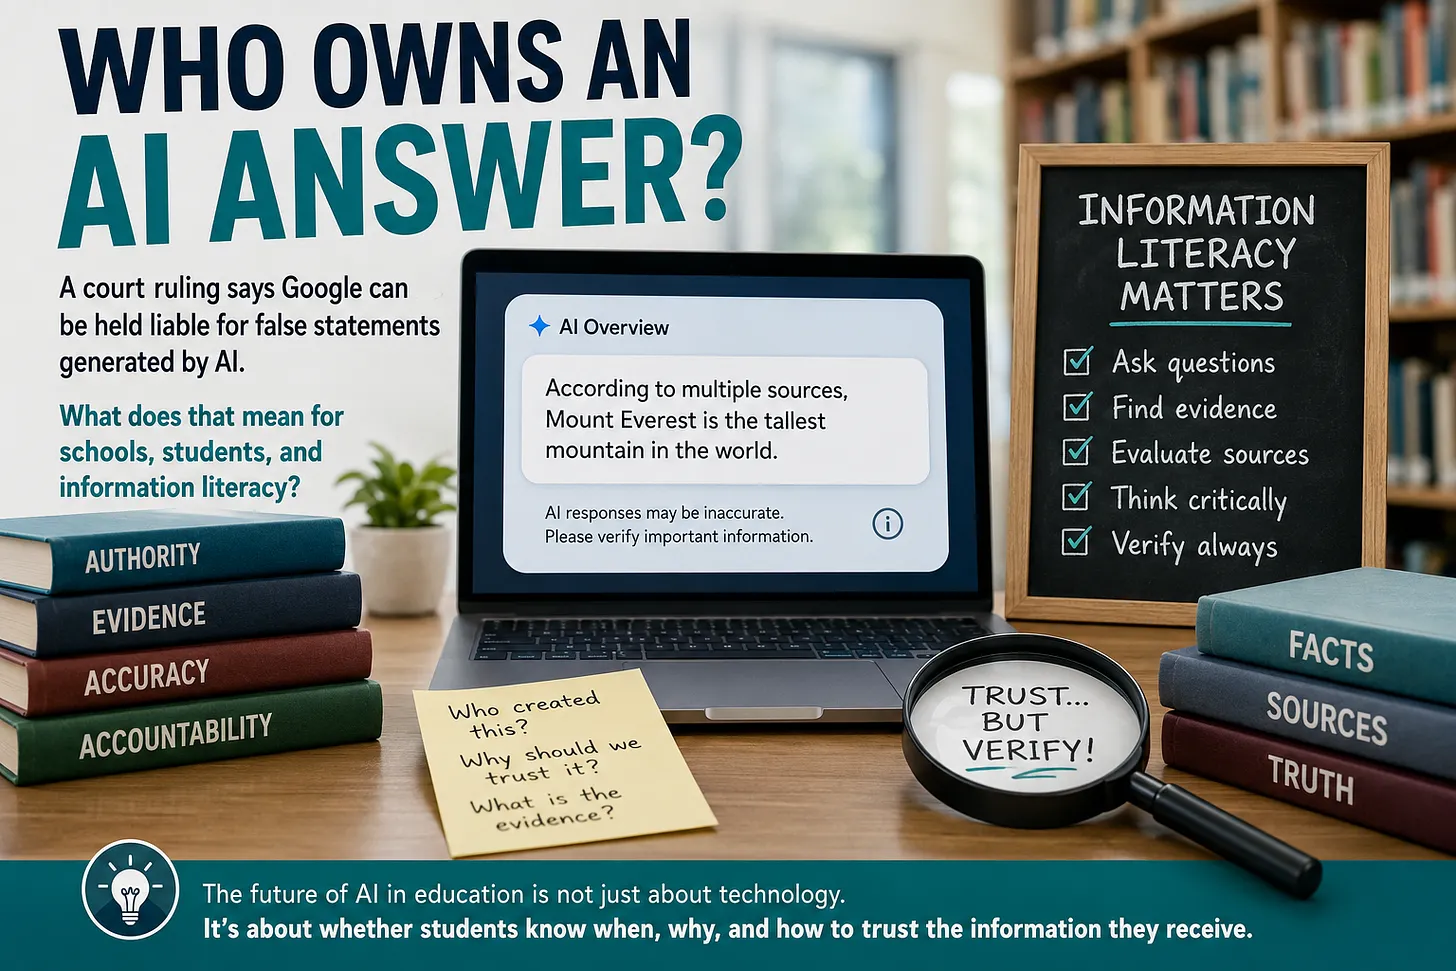
The AI School Librarian. “Who Owns an AI Answer?”. Publicado en Substack, 2026. Disponible en: The AI School Librarian (Substack)

Se aborda una de las cuestiones más complejas surgidas con la expansión de la inteligencia artificial generativa: la propiedad intelectual de los contenidos creados con ayuda de sistemas como ChatGPT, Gemini o Claude. A medida que estas herramientas producen textos, imágenes, código o ideas cada vez más sofisticadas, surge una pregunta central tanto en el ámbito educativo como en el legal: ¿quién puede reclamar la autoría o propiedad de una respuesta producida por una máquina entrenada con datos ajenos?

Durante años, una de las explicaciones más repetidas por las grandes empresas de inteligencia artificial ha sido relativamente sencilla: los sistemas de IA pueden cometer errores. Desde el comienzo, compañías tecnológicas han advertido a sus usuarios que deben contrastar la información generada, verificar las fuentes y mantener una actitud crítica frente a cualquier respuesta producida por estos sistemas. Estas advertencias aparecen de forma habitual en manuales, políticas de uso y declaraciones públicas de prácticamente todas las empresas que desarrollan herramientas de inteligencia artificial.

Sin embargo, una reciente decisión judicial en Alemania parece indicar que esa explicación podría dejar de ser suficiente.

Un tribunal alemán ha dictaminado que Google puede ser considerado legalmente responsable por información falsa generada por su sistema AI Overviews, la función que ofrece resúmenes automáticos en los resultados de búsqueda. El caso se originó cuando el sistema vinculó erróneamente a dos editores con actividades fraudulentas y estafas. La defensa de Google siguió el argumento habitual: la inteligencia artificial puede equivocarse y los usuarios no deberían asumir que todas las respuestas generadas son completamente precisas. El tribunal, sin embargo, rechazó esta justificación.

La relevancia de esta resolución judicial radica en que desplaza el foco del debate. Hasta ahora, gran parte de la discusión sobre inteligencia artificial se había centrado en cómo se entrenan los modelos, qué datos utilizan o si vulneran derechos de autor durante ese proceso. La sentencia introduce otra perspectiva: no importa únicamente cómo funciona la IA internamente, sino también qué tipo de información entrega directamente al usuario y quién asume la responsabilidad cuando esa información resulta falsa o perjudicial.

La cuestión trasciende ampliamente a Google. Durante los últimos años, buena parte del debate sobre inteligencia artificial en educación se ha centrado casi exclusivamente en el comportamiento de los estudiantes: el posible plagio, la integridad académica, el uso adecuado de herramientas generativas o el papel que debe ocupar la IA dentro del aprendizaje. Mucho menos se ha discutido sobre las obligaciones de las empresas tecnológicas cuando sus sistemas generan información errónea y esa información termina afectando a personas reales o condicionando decisiones importantes.

El texto analiza cómo los sistemas de IA generativa funcionan a partir de modelos entrenados sobre enormes cantidades de información extraída de internet, libros, artículos académicos, obras creativas y otros materiales protegidos por derechos de autor. Cuando un usuario introduce una instrucción o prompt, la IA no “crea” en un sentido humano tradicional, sino que genera una respuesta basada en patrones estadísticos aprendidos durante el entrenamiento. Esto complica enormemente la atribución de propiedad, porque la respuesta final puede contener ecos, estructuras o influencias derivadas de miles de obras previas, cuyos autores originales raramente han dado consentimiento explícito para ese uso.

Desde el punto de vista jurídico, el artículo subraya que en muchas legislaciones actuales —especialmente en Estados Unidos y Europa— la protección del copyright exige un grado de creatividad humana identificable. Esto significa que un contenido generado enteramente por inteligencia artificial podría no ser susceptible de protección legal como obra original, o al menos no bajo los marcos tradicionales del derecho de autor. La intervención humana, por tanto, se vuelve decisiva: cuanto mayor sea el nivel de edición, selección, reformulación o dirección creativa del usuario, más sólida resulta su posible reclamación de autoría sobre el resultado final.

El artículo dedica especial atención al ámbito educativo, donde docentes, investigadores y bibliotecarios deben enfrentarse a nuevos escenarios éticos relacionados con el uso de herramientas generativas. Si un estudiante presenta como propio un trabajo elaborado en gran parte por inteligencia artificial, surge un debate no solo sobre plagio, sino sobre autenticidad intelectual y aprendizaje real. Del mismo modo, en la producción académica y editorial aparece la necesidad de establecer criterios transparentes para declarar cuándo un texto ha sido asistido por IA y en qué medida esa asistencia altera la noción tradicional de autor.

La reflexión final plantea que la inteligencia artificial está obligando a redefinir conceptos fundamentales como creación, originalidad, propiedad intelectual y responsabilidad autoral. Más que una simple cuestión tecnológica, el problema revela una transformación profunda en la relación entre conocimiento, producción cultural y derechos de propiedad. En este nuevo escenario, bibliotecas, universidades, editoriales y legisladores deberán desempeñar un papel central en la construcción de marcos éticos y jurídicos capaces de responder a una pregunta cada vez más urgente: cuando una máquina produce conocimiento, ¿a quién pertenece realmente esa creación?