Archivo de la categoría: Noticias

Cuando la nevera piensa por ti: Samsung da un paso decisivo hacia una inteligencia artificial realmente útil en el hogar

Rutherford, Sam. “Samsung’s Bespoke Update Is Big Step Towards A Useful AI For Your Fridge.” Engadget, 10 de mayo de 2026.

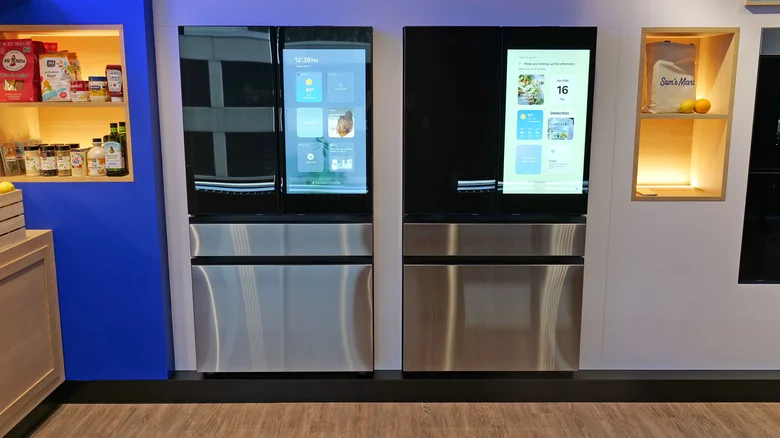
Se analiza una importante actualización de software lanzada por Samsung Electronics para su línea de frigoríficos inteligentes Samsung Bespoke AI Refrigerator, un movimiento que representa uno de los avances más significativos hasta ahora en la incorporación de inteligencia artificial realmente funcional dentro del entorno doméstico.

Aunque la idea de actualizar el software de un frigorífico sigue pareciendo extraña para muchos consumidores, el autor sostiene que esta actualización marca un punto de inflexión en la evolución de los electrodomésticos inteligentes, especialmente porque por primera vez la IA parece aportar utilidades concretas y no simples funciones llamativas con escaso valor práctico.

Hasta este momento, los frigoríficos inteligentes de Samsung ya incorporaban sistemas de reconocimiento visual capaces de identificar alimentos almacenados en su interior. Sin embargo, las versiones anteriores resultaban bastante limitadas: el sistema apenas reconocía alrededor de sesenta tipos de alimentos frescos y aproximadamente cincuenta productos envasados. Además, requería que el usuario introdujera manualmente información adicional, como cantidades o fechas de incorporación, algo que terminaba haciendo la experiencia tediosa y reduciendo considerablemente la utilidad real de la tecnología. Según el análisis, el usuario terminaba dedicando demasiado tiempo a alimentar al sistema, lo que contradecía precisamente la promesa de automatización inteligente que la IA debería ofrecer.

La gran novedad de esta actualización reside en la integración de Google Gemini, el modelo de inteligencia artificial generativa desarrollado por Google, que ahora complementa el sistema de reconocimiento visual propio de Samsung. Gracias a esta combinación entre procesamiento local y capacidades de computación en la nube, la capacidad de identificación del frigorífico se multiplica enormemente: pasa de reconocer poco más de un centenar de productos a ser capaz de identificar más de 2.000 tipos diferentes de alimentos. Esto supone un salto enorme en términos de funcionalidad práctica, ya que el sistema comienza a comportarse más como un verdadero asistente doméstico capaz de comprender el contenido real del frigorífico.

Uno de los aspectos que más destaca el autor del artículo es la mejora en el reconocimiento de productos específicos y marcas concretas. El sistema no solo identifica alimentos genéricos, sino que puede distinguir entre variantes muy concretas de un mismo producto, por ejemplo diferenciando entre una lata de Coca-Cola Zero y una Diet Coke, algo que requiere un nivel considerablemente más avanzado de visión computacional. Incluso ingredientes poco comunes o especializados, como determinadas salsas asiáticas de escasa presencia en mercados occidentales, fueron reconocidos correctamente durante las pruebas realizadas. Esta precisión transforma el frigorífico en una especie de inventario automatizado que monitoriza de manera casi autónoma el estado de los alimentos disponibles.

Otra función especialmente interesante es la capacidad del sistema para realizar seguimiento temporal de los productos almacenados. El frigorífico puede registrar cuánto tiempo lleva un alimento dentro del electrodoméstico y emitir alertas cuando detecta que ciertos productos están próximos a caducar o podrían deteriorarse pronto. Esto introduce una dimensión preventiva muy relevante, ya que permite reducir el desperdicio alimentario, un problema doméstico y medioambiental considerable. La inteligencia artificial deja de ser un mero asistente pasivo para convertirse en un sistema capaz de intervenir activamente en la gestión eficiente del consumo alimentario familiar.

Samsung también ha incorporado nuevas funciones relacionadas con el mantenimiento técnico del aparato mediante lo que denomina Repairability AI. El frigorífico monitoriza constantemente métricas internas de funcionamiento y puede detectar potenciales averías antes de que se produzca un fallo crítico. Con autorización explícita del propietario, esta información puede compartirse con técnicos de reparación, permitiendo que el servicio técnico llegue con un diagnóstico previo y pueda solucionar incidencias de manera más rápida y eficiente. Este enfoque introduce una nueva filosofía en la industria: electrodomésticos cuyo valor evoluciona mediante software incluso después de haber sido comprados, algo similar a lo que ocurre actualmente con automóviles eléctricos o smartphones.

Sin embargo, el artículo también deja entrever algunas dudas y preocupaciones. El crecimiento de la inteligencia artificial integrada en dispositivos domésticos plantea interrogantes sobre privacidad, dependencia tecnológica y posibles problemas de fiabilidad. Algunos sectores críticos han cuestionado si realmente resulta necesario incorporar IA avanzada a electrodomésticos tradicionalmente simples como un frigorífico. Durante el Consumer Electronics Show 2026 (CES 2026) incluso aparecieron críticas hacia este tipo de productos por considerar que representan un ejemplo de sobreingeniería tecnológica: añadir complejidad innecesaria a dispositivos cuya función básica históricamente ha sido sencilla y robusta. También existen preocupaciones sobre la recopilación constante de datos domésticos y sobre la dificultad futura de reparación si el software falla o queda obsoleto.

Esta actualización del ecosistema Samsung Bespoke AI Family Hub muestra un escenario diferente: una tecnología capaz de reconocer alimentos, organizar inventarios, sugerir recetas, reducir desperdicios, anticipar averías y personalizar información para cada miembro del hogar. Aunque persisten desafíos importantes relacionados con privacidad, mantenimiento y confianza del consumidor, el artículo plantea que quizás estamos viendo el inicio de una nueva generación de hogares donde la inteligencia artificial deja de ser experimental y empieza a convertirse en una infraestructura invisible integrada en la vida cotidiana

Librerías

«Librerías. Ese olor. Me puedo tirar horas curioseando en los anaqueles. Al final salgo con tres o cuatro, entre los que no suele estar el que buscaba. Algunos libros simplemente te llaman. Estos relatos tradicionales de los indígenas norteamericanos, además, me miran fijamente y me prometen momentos memorables. Desde que lo leí respeto profundamente la tierra, el cielo y a los locos. Los indios los respetan. Hacen muy bien, porque los cuerdos no hacemos más que destrozar vidas y hacer preguntas estúpidas. Con lo cerca que están las respuestas.»

JOSELE SANTIAGO
«Desde el jergón» (2026)

Un manuscrito medieval del rey Arturo y el Santo Grial saldrá a subasta tras 700 años en colecciones privadas

A rare King Arthur manuscript is going up for auction. Scholars hope it won’t end up in a private collection CBC Radio – As It Happens: https://www.cbc.ca/radio/asithappens/king-arthur-manuscript-auction-9.7195653

El programa de CBC Radio As It Happens aborda la próxima subasta de un extraordinario manuscrito medieval relacionado con las leyendas del rey Arturo, Merlin y la búsqueda del Santo Grial. El documento, que ha permanecido en manos privadas durante aproximadamente 700 años, saldrá a la venta en Christie’s en julio de 2026 y se estima que podría alcanzar entre 1,5 y 2 millones de libras esterlinas (aproximadamente hasta 2,7 millones de dólares) en la puja internacional.

El manuscrito, fechado entre 1290 y 1310, pertenece al ciclo del Lancelot-Graal, una de las compilaciones más influyentes de la materia artúrica en la literatura medieval europea. Está escrito en francés antiguo y contiene alrededor de 126 miniaturas iluminadas con pan de oro, que representan escenas clave de las aventuras de Arturo, los caballeros de la Mesa Redonda y el mago Merlín. Estas ilustraciones destacan por su riqueza visual y su técnica refinada, lo que convierte al códice en una obra excepcional tanto desde el punto de vista literario como artístico.

La pieza, conocida en algunas fuentes como el “manuscrito Lebaudy”, es una de las pocas copias de este tipo que permanecen en colecciones privadas. Los especialistas destacan su importancia porque, hasta ahora, no ha sido completamente estudiada ni exhibida públicamente, lo que ha limitado el acceso académico a su contenido. Su aparición en el mercado supone, por tanto, una oportunidad única para su posible adquisición por parte de instituciones públicas y su futura puesta a disposición de investigadores y del público general.

Expertos en manuscritos medievales subrayan también el valor cultural del códice dentro de la tradición artúrica, ya que recoge versiones tempranas de relatos fundamentales para la literatura occidental, como la búsqueda del Grial o las aventuras de Gawain y Lancelot. Además, se destaca el interés histórico de sus variantes textuales, que muestran cómo los escribas medievales adaptaban y reescribían las historias según sus contextos y patronos.

Tendencias en mobiliario para bibliotecas públicas en 2026: flexibilidad, diseño humano y espacios multifuncionales

“Public Library Furniture Trends – 2026 Market Predictions”. Library Journal (LJ), 2026. Disponible en: https://www.libraryjournal.com/story/public-library-furniture-trends—2026-market-predictions-lj260601

AGATI Furniture

Ver

El artículo de Library Journal analiza cómo está evolucionando el mobiliario en bibliotecas públicas hacia 2026 en un contexto de crecimiento sostenido del uso de estos espacios y de transformación de su función social. Las bibliotecas ya no se conciben únicamente como depósitos de libros, sino como infraestructuras comunitarias activas, lo que obliga a replantear el diseño del espacio interior y, especialmente, del mobiliario.

Uno de los ejes centrales del texto es la idea de que las bibliotecas están pasando de modelos uniformes a entornos altamente diferenciados. Esto implica la creación de zonas específicas para distintos tipos de usuarios: infancia, adolescencia, trabajo individual, colaboración, formación o reuniones comunitarias. Cada grupo requiere condiciones espaciales y mobiliario distintos, lo que impulsa la diversificación del diseño.

El artículo destaca también el auge de la flexibilidad espacial como principio rector. Las bibliotecas necesitan mobiliario que pueda reconfigurarse fácilmente para adaptarse a actividades cambiantes a lo largo del día: desde sesiones de lectura infantil por la mañana hasta talleres comunitarios o reuniones por la tarde. Esta lógica responde a la presión creciente sobre los espacios públicos, que deben hacer más con menos superficie disponible.

Otro elemento clave es la incorporación de soluciones para el trabajo digital. El mobiliario contemporáneo debe integrar tecnología, conectividad y ergonomía, permitiendo el uso de portátiles, dispositivos móviles y estaciones de trabajo híbridas. Esto incluye mesas con acceso a energía, estaciones de estudio individual y carrels diseñados para ofrecer concentración en entornos de alta afluencia.

El texto subraya igualmente la importancia de la diversidad de productos de mobiliario. No existe ya un único modelo de silla, mesa o puesto de lectura válido para toda la biblioteca. En su lugar, se busca una combinación de soluciones que respondan a distintos modos de uso: lectura silenciosa, trabajo colaborativo, aprendizaje informal o interacción comunitaria.

En paralelo, se observa un incremento del interés por la ergonomía y el confort, especialmente en contextos de uso prolongado. Las bibliotecas incorporan mobiliario más cómodo, ajustable y pensado para largas estancias, en contraste con modelos más rígidos del pasado. Esto responde a la función creciente de la biblioteca como espacio de estudio, trabajo y permanencia prolongada.

El artículo también conecta estas tendencias con factores estructurales del sector: aumento del uso de bibliotecas, mayor demanda de servicios comunitarios y presión presupuestaria. En este contexto, el mobiliario no es solo un elemento estético o funcional, sino una herramienta estratégica para maximizar el uso del espacio y mejorar la experiencia del usuario.

Se apunta a la consolidación de un modelo de biblioteca como “infraestructura social flexible”, donde el diseño interior debe ser capaz de adaptarse a cambios constantes en programación, tecnología y necesidades comunitarias. El mobiliario, por tanto, deja de ser estático para convertirse en un componente dinámico del ecosistema bibliotecario.

CNN demanda a Perplexity por reproducir artículos de forma casi literal

«CNN sues Perplexity AI over ‘verbatim‘ copies of articles». Boing Boing, 29 de mayo de 2026. Disponible en: https://boingboing.net/2026/05/29/cnn-sues-perplexity-ai-over-verbatim-copies-of-articles.html.

La cadena de noticias CNN ha presentado una demanda judicial contra la empresa de inteligencia artificial Perplexity AI, acusándola de infringir sistemáticamente los derechos de autor mediante la copia y redistribución de contenidos periodísticos. La demanda sostiene que Perplexity habría rastreado, extraído y reutilizado miles de artículos, vídeos e imágenes de CNN para alimentar sus sistemas de búsqueda y generación de respuestas basadas en inteligencia artificial.

Según la documentación judicial, CNN afirma haber identificado más de 17.000 ejemplos de contenido supuestamente utilizado sin autorización. La acusación no se limita al empleo de esos materiales para entrenar modelos de IA, sino que sostiene que las respuestas ofrecidas a los usuarios contienen fragmentos idénticos o sustancialmente similares a los artículos originales. En algunos casos, bastaría con introducir el título de una noticia para que el sistema devolviera extensos pasajes muy próximos al texto publicado por CNN, incluyendo contenidos protegidos por suscripción.

CNN argumenta que esta práctica socava el modelo económico del periodismo profesional. La cadena señala que sus noticias son fruto del trabajo de periodistas, investigadores, editores y productores que invierten recursos significativos en la creación de información original. Desde esta perspectiva, permitir que una plataforma de IA reproduzca esos contenidos sin licencia ni compensación económica equivaldría a apropiarse del valor generado por los medios de comunicación tradicionales.

Otro aspecto relevante del caso es que CNN asegura haber intentado previamente negociar con Perplexity un acuerdo de licencia para regular el uso de sus contenidos. Sin embargo, las conversaciones habrían terminado sin acuerdo a finales de 2025. Tras la ruptura de las negociaciones, CNN sostiene que la empresa continuó utilizando sus materiales y que incluso ignoró requerimientos formales para cesar dichas actividades.

Por su parte, Perplexity rechaza las acusaciones. La compañía mantiene que los hechos y la información en sí mismos no están protegidos por derechos de autor y que su tecnología se limita a recopilar, sintetizar y presentar información procedente de múltiples fuentes. Esta línea de defensa coincide con la utilizada por diversas empresas de inteligencia artificial que sostienen que existe una diferencia jurídica entre copiar una obra protegida y extraer hechos o conocimientos contenidos en ella.

La demanda de CNN se inscribe en un contexto más amplio de conflictos legales entre medios de comunicación y empresas de IA. En los últimos años, organizaciones como The New York Times, Reddit, Dow Jones, Merriam-Webster y Encyclopaedia Britannica han emprendido acciones similares, denunciando el uso no autorizado de sus contenidos para entrenar o alimentar sistemas de inteligencia artificial.

Más allá del caso concreto, el litigio plantea una cuestión fundamental para el futuro de la inteligencia artificial generativa: dónde se encuentra el límite entre el uso legítimo de información pública y la reproducción indebida de obras protegidas. El resultado de este y otros procedimientos judiciales podría definir las reglas de juego para la relación entre las empresas tecnológicas y los productores de contenido durante los próximos años, afectando tanto a la sostenibilidad económica del periodismo como al desarrollo de los sistemas avanzados de IA.

Wiley compra Emerald para reforzar su estrategia de contenidos en la economía del conocimiento impulsada por IA

Wiley. “Wiley Acquires Emerald, Expanding Research Scale and Deepening Proprietary Content Across the AI-Driven Knowledge Economy.” Business Wire / Wiley Newsroom, 2 de junio de 2026. https://johnwiley2020news.q4web.com/press-releases/press-release-details/2026/Wiley-Acquires-Emerald-Expanding-Research-Scale-and-Deepening-Proprietary-Content-Across-the-AI-Driven-Knowledge-Economy/default.aspx

Wiley ha anunciado la adquisición de Emerald Publishing en una operación totalmente en efectivo valorada en aproximadamente 337 millones de libras esterlinas (unos 452 millones de dólares). El objetivo estratégico de la compra es ampliar la escala del negocio editorial académico de Wiley y reforzar su posición en la llamada “economía del conocimiento” impulsada por la inteligencia artificial.

La integración de Emerald supone un aumento significativo del catálogo de Wiley, que alcanzará alrededor de 2.500 revistas científicas, consolidando su liderazgo en áreas como economía, empresa, finanzas y ciencias sociales. Además, la operación añade cerca de 500 revistas, miles de libros y una amplia base de estudios de caso, fortaleciendo su cartera de contenidos académicos de alto valor.

Uno de los elementos centrales del comunicado es el papel de estos contenidos en el desarrollo de sistemas de inteligencia artificial. Wiley subraya que el acceso a investigación revisada por pares y datos propietarios es cada vez más relevante para entrenar modelos de IA y alimentar aplicaciones analíticas, en un contexto en el que las empresas tecnológicas demandan fuentes fiables y estructuradas.

La operación también tiene una dimensión financiera relevante: se espera que la adquisición sea positiva para el beneficio por acción (EPS) desde el primer año y genere sinergias de costes significativas en los próximos ejercicios, reforzando el modelo de negocio basado en suscripciones y contenidos recurrentes.

En conjunto, la compra de Emerald refleja una tendencia más amplia en el sector editorial académico: la consolidación de grandes grupos que buscan escalar su producción de conocimiento y posicionarse como proveedores clave de contenido para la infraestructura global de inteligencia artificial y análisis de datos.

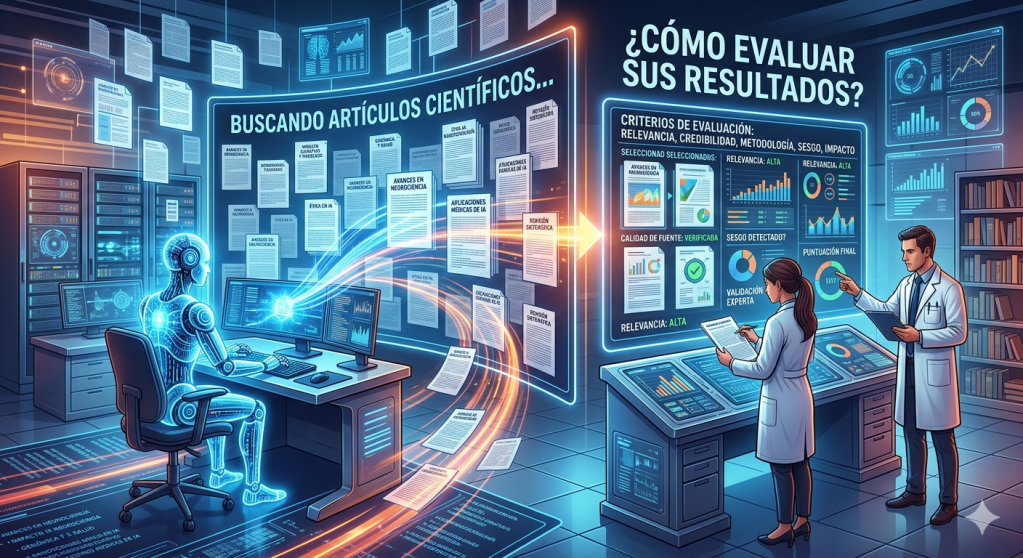
La inteligencia artificial busca artículos científicos, pero ¿Cómo evaluar sus resultados?

Aaron Tay. “AI Academic Search and the Missing Benchmark Problem”. Aaron Tay’s Musings about Librarianship, 2026.

Uno de los problemas más importantes en la evaluación de los sistemas de búsqueda académica basados en inteligencia artificial: la ausencia de estándares de referencia sólidos y compartidos. Mientras proliferan herramientas como Elicit, Consensus, Scite, Scopus AI o los sistemas de “Deep Research”, existe una gran dificultad para determinar objetivamente cuál de ellas ofrece mejores resultados, ya que no disponemos de benchmarks ampliamente aceptados que permitan comparar su rendimiento de forma rigurosa.

Tay señala que la situación recuerda a los primeros años de otros campos de la inteligencia artificial, donde los avances tecnológicos fueron más rápidos que los mecanismos de evaluación. Muchas plataformas promocionan capacidades como la búsqueda semántica, la recuperación aumentada por generación (RAG), la identificación automática de literatura relevante o la elaboración de revisiones bibliográficas asistidas por IA. Sin embargo, los usuarios suelen disponer únicamente de demostraciones comerciales o ejemplos seleccionados por los propios desarrolladores, lo que dificulta conocer el rendimiento real de estas herramientas en contextos de investigación auténticos.

Uno de los argumentos centrales del autor es que la búsqueda académica constituye un problema mucho más complejo que responder preguntas generales. No basta con recuperar documentos relacionados; también es necesario encontrar trabajos relevantes aunque utilicen terminología diferente, identificar literatura seminal, reconocer relaciones de citación y ofrecer resultados adecuados para distintas etapas del proceso investigador. Debido a ello, evaluar únicamente la precisión de una respuesta generada por IA resulta insuficiente.

El artículo destaca además que muchas pruebas actuales se centran en tareas demasiado simples. Un sistema puede responder correctamente a preguntas factuales concretas y aun así fracasar cuando se enfrenta a necesidades reales de investigación, como localizar artículos fundamentales omitidos en una revisión bibliográfica, detectar debates emergentes o construir estrategias de búsqueda exhaustivas. Tay sostiene que los escenarios de evaluación deberían reflejar mejor las tareas cotidianas de investigadores, estudiantes y bibliotecarios.

Otro problema importante es la falta de transparencia. Muchas herramientas académicas basadas en IA funcionan mediante modelos propietarios cuyos índices documentales, algoritmos de recuperación y mecanismos de clasificación no son públicos. Como consecuencia, resulta difícil reproducir experimentos o comprender por qué dos sistemas ofrecen resultados distintos ante la misma consulta. Esta opacidad limita la posibilidad de desarrollar evaluaciones comparables y acumulativas.

Tay también subraya que la calidad de un sistema RAG depende de dos componentes distintos: la recuperación de información y la generación de respuestas. Un modelo puede producir un texto aparentemente convincente pero basado en documentos poco relevantes, o bien recuperar excelentes artículos y resumirlos de forma deficiente. Por ello, propone evaluar por separado la capacidad de recuperación y la fidelidad de la síntesis generada.

En sus análisis previos sobre herramientas de búsqueda académica, el autor ha mostrado que algunos sistemas especializados fracasan en tareas relativamente sencillas para un investigador humano, mientras que modelos generales pueden resolverlas con más eficacia. Estos resultados sugieren que muchas plataformas funcionan mediante flujos de trabajo predefinidos que son muy eficaces en determinados escenarios, pero menos flexibles cuando la consulta se aparta de los casos previstos por sus diseñadores.

El texto conecta además con una cuestión más amplia dentro de la inteligencia artificial: la importancia de los benchmarks. Históricamente, disciplinas como el procesamiento del lenguaje natural o la visión artificial han avanzado gracias a conjuntos de pruebas estandarizados que permiten comparar sistemas bajo condiciones comunes. Sin estándares equivalentes para la búsqueda académica asistida por IA, resulta difícil distinguir entre mejoras reales y simples estrategias de marketing.

Aaron Tay defiende la necesidad de construir marcos de evaluación abiertos, transparentes y orientados a tareas reales de investigación. Solo mediante benchmarks compartidos será posible determinar qué herramientas mejoran verdaderamente el descubrimiento académico y cuáles simplemente generan respuestas convincentes. Para bibliotecarios, investigadores y responsables institucionales, esta cuestión resulta especialmente relevante en un momento en que las plataformas de búsqueda basadas en IA comienzan a integrarse en bases de datos científicas, catálogos bibliotecarios y servicios de apoyo a la investigación.

Libros para las trincheras: el servicio bibliotecario de la ALA durante la Primera Guerra Mundial

Barcelona, Leanna. “The Books They Read: Library War Service in WWI.” American Library Association Archives, 20 de marzo de 2017. https://www.library.illinois.edu/ala/2017/03/20/the-books-they-carried/

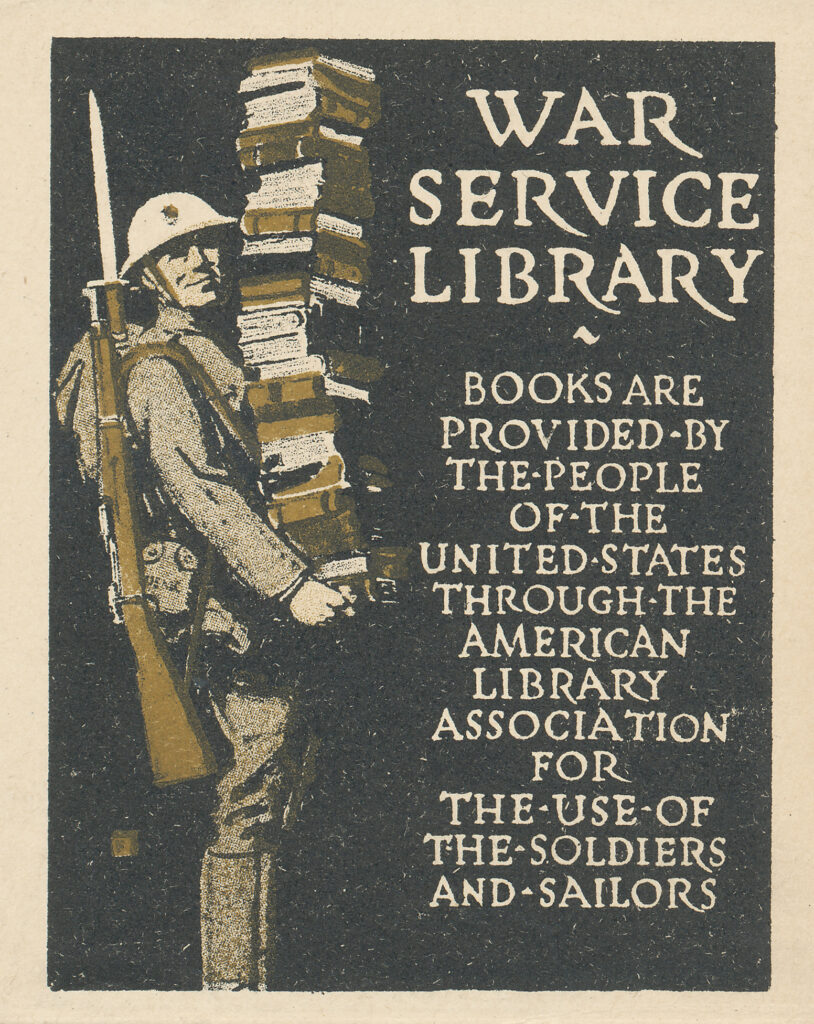
Se analiza uno de los episodios más singulares de la historia de las bibliotecas: el esfuerzo de los bibliotecarios estadounidenses por llevar libros y lectura a soldados y marineros durante la Primera Guerra Mundial. El texto explica cómo la llamada Library War Service transformó a las bibliotecas en instrumentos de apoyo moral, educativo y psicológico en medio del conflicto bélico.

La iniciativa comenzó en 1917, cuando la American Library Association organizó una enorme campaña nacional de recogida de fondos y donación de libros. El objetivo era proporcionar “un libro para cada hombre”, es decir, garantizar que todos los soldados estadounidenses, tanto en los campos de entrenamiento como en Europa, tuvieran acceso a materiales de lectura. La campaña alcanzó dimensiones extraordinarias: se recaudaron alrededor de cinco millones de dólares, se distribuyeron entre siete y diez millones de libros y revistas, y se construyeron treinta y seis bibliotecas militares financiadas por la Carnegie Corporation.

El artículo subraya que las bibliotecas de guerra no eran simples depósitos de libros, sino espacios de refugio emocional y cultural para los combatientes. Los soldados encontraban en la lectura una forma de evasión frente al horror de la guerra, pero también un medio para mantener la conexión con la vida civil y con la idea de un futuro después del conflicto. Según testimonios recogidos en el texto, los libros circulaban constantemente entre marineros y soldados, que tenían acceso libre a ellos sin restricciones ni controles estrictos.

Uno de los aspectos más interesantes del artículo es la reflexión sobre qué leían realmente los soldados. Aunque existía la imagen romántica de militares leyendo novelas de aventuras o relatos patrióticos, gran parte de las obras solicitadas eran libros técnicos y prácticos. Muchos combatientes buscaban prepararse para la reintegración laboral tras la guerra y leían manuales de mecánica, carpintería, ingeniería, negocios o transporte ferroviario. La lectura aparecía así vinculada a la formación profesional y a la movilidad social.

Al mismo tiempo, las novelas de ficción seguían teniendo un enorme éxito. Los relatos de aventuras, detectives y westerns ayudaban a aliviar la ansiedad y el agotamiento emocional. Algunas investigaciones posteriores sobre biblioterapia señalaron incluso que muchos soldados hospitalizados preferían historias sentimentales o novelas románticas, algo que sorprendió a los propios bibliotecarios militares. Estas observaciones contribuyeron al desarrollo temprano de la biblioterapia, entendida como el uso terapéutico de la lectura para mejorar el bienestar psicológico.

El texto también muestra el lado ideológico y censor de la iniciativa. No todos los libros eran aceptados. La ALA retiró determinadas obras consideradas pacifistas o favorables al bolchevismo, especialmente tras el aumento del miedo al comunismo después de la Revolución Rusa. Títulos relacionados con León Trotski o con análisis simpatizantes de Rusia revolucionaria fueron eliminados de las bibliotecas militares por considerarse peligrosos para “jóvenes impresionables”. Esto revela cómo las bibliotecas, incluso en contextos humanitarios, podían convertirse también en instrumentos de control ideológico.

El artículo destaca asimismo la importancia histórica de este programa para la evolución de las bibliotecas estadounidenses. La Library War Service convirtió a la American Library Association en una organización nacional de gran relevancia pública y consolidó la idea de la biblioteca como servicio esencial para la democracia y el bienestar social. La experiencia de guerra fortaleció la percepción de que las bibliotecas no solo debían conservar libros, sino también actuar como agentes activos de educación, integración y apoyo comunitario.

Google publica una guía oficial para optimizar contenidos en la búsqueda generativa basada en IA

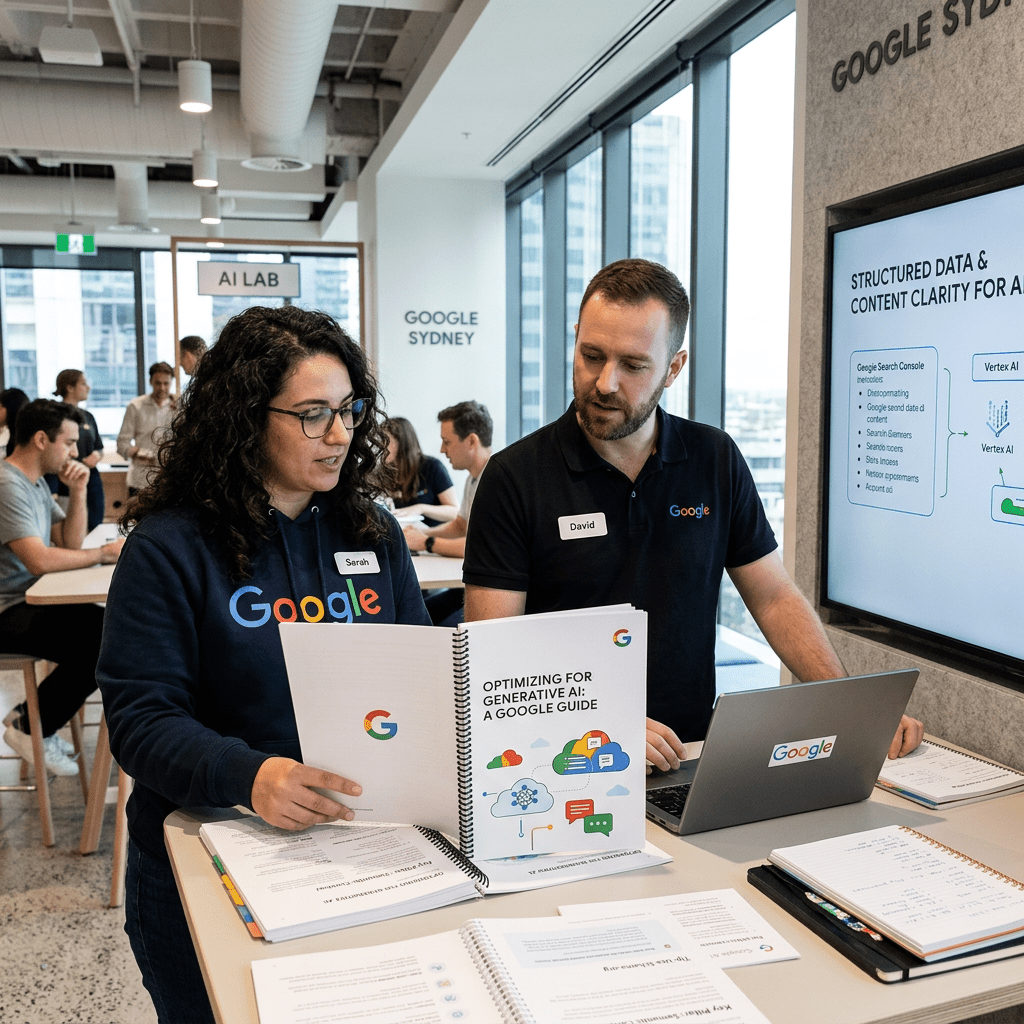
Two people at a table reviewing a guide titled Optimizing for Generative AI, with a screen showing structured data concepts
Two Google employees discuss strategies for optimizing generative AI using a detailed guide

Google Developers. “Optimizing Your Website for Generative AI Features on Google Search.” Google Search Central. Consultado el 24 de mayo de 2026.

Google ha publicado una nueva guía oficial destinada a explicar cómo deben adaptarse los sitios web al nuevo ecosistema de búsqueda impulsado por inteligencia artificial. El documento forma parte de la documentación de Google Search Central y está centrado en las funciones generativas de búsqueda, especialmente los denominados “AI Overviews” y el “AI Mode”, sistemas que utilizan modelos de IA para sintetizar respuestas directamente en el buscador.

La guía representa uno de los posicionamientos más claros de Google sobre el futuro del SEO en la era de la IA generativa y busca desmontar muchas prácticas especulativas que habían proliferado en torno al llamado GEO (Generative Engine Optimization) o AEO (Answer Engine Optimization).

El mensaje central del documento es que la optimización para la IA no constituye una disciplina independiente del SEO tradicional. Google insiste en que las funciones generativas continúan utilizando los mismos sistemas de indexación, calidad y clasificación que alimentan la búsqueda convencional. Según la compañía, no existe un “índice especial para IA” ni un algoritmo paralelo destinado exclusivamente a las respuestas generadas automáticamente. En consecuencia, las prácticas fundamentales del SEO —como la creación de contenido útil, original, fiable y técnicamente accesible— siguen siendo el núcleo de la visibilidad digital en los nuevos entornos de búsqueda asistida por IA.

La guía también dedica un espacio importante a desmontar ciertos mitos que se habían popularizado entre consultores y empresas de marketing digital. Google afirma explícitamente que no son necesarias estrategias específicas como el uso de archivos “llms.txt”, la creación de marcado estructurado exclusivo para IA, la fragmentación artificial de contenidos (“chunking”) o la reescritura de textos para adaptarlos a supuestos patrones de lectura de modelos generativos. La empresa considera que muchas de estas prácticas no aportan beneficios reales y, en algunos casos, pueden derivar en estrategias artificiales o spam.

Otro aspecto relevante del documento es la importancia que Google concede al contenido “no commodity”, es decir, a la información original, experiencial y difícilmente replicable por sistemas automáticos. La guía sugiere que la IA tenderá a valorar especialmente testimonios, experiencias directas, análisis especializados y contenidos elaborados desde una perspectiva humana auténtica. Esto implica que los materiales genéricos, fácilmente reproducibles por herramientas de IA, podrían perder visibilidad frente a contenidos con mayor profundidad contextual y autoridad temática.

La publicación de esta guía se enmarca dentro de una transformación mucho más amplia del buscador de Google. En los últimos meses, la compañía ha anunciado cambios profundos en Search mediante la integración de modelos Gemini y nuevas experiencias conversacionales capaces de interpretar consultas complejas, imágenes, documentos y contextos personalizados. Estas funciones convierten progresivamente el buscador en una plataforma híbrida entre motor de búsqueda y asistente conversacional inteligente.

El debate generado alrededor de estas tecnologías también ha despertado preocupación en el ámbito académico y editorial. Investigaciones recientes advierten de que las respuestas generadas por IA modifican profundamente la relación entre usuarios, buscadores y medios de comunicación, ya que el sistema sintetiza información procedente de múltiples fuentes reduciendo potencialmente el tráfico hacia los sitios originales. Algunos estudios señalan además que una parte significativa de las afirmaciones generadas por los sistemas AI Overviews pueden contener omisiones o referencias insuficientemente respaldadas.

En conjunto, la nueva guía de Google supone un intento de estabilizar el ecosistema SEO frente a la proliferación de tácticas oportunistas surgidas con el auge de la IA generativa. La empresa reafirma que la calidad del contenido, la experiencia del usuario, la autoridad temática y la accesibilidad técnica continúan siendo los pilares fundamentales de la visibilidad digital, incluso en una etapa en la que las respuestas automatizadas y los agentes inteligentes están redefiniendo el funcionamiento tradicional de la web.

Papel de la automatización y la inteligencia artificial en el ciclo completo de la investigación científica

Frechette, John, and Heather Pierce-Lopez. 2026. “A Friendly Debate: Where Automation Will (And Should) Land in the Research Lifecycle.” The Scholarly Kitchen, 22 de mayo de 2026. https://scholarlykitchen.sspnet.org/2026/05/22/guest-post-a-friendly-debate-where-automation-will-and-should-land-in-the-research-lifecycle/

El artículo de The Scholarly Kitchen plantea un debate estructurado sobre el papel de la automatización y la inteligencia artificial en el ciclo completo de la investigación científica. Más que discutir si la IA “debe” o “no debe” utilizarse, el texto propone una reflexión más matizada: en qué fases del proceso investigador la automatización puede mejorar la eficiencia y en cuáles es imprescindible preservar el juicio humano.

El punto de partida es la constatación de que la IA ya está integrada de forma implícita en numerosas herramientas académicas, desde motores de búsqueda hasta sistemas de descubrimiento y gestión bibliográfica, aunque muchas veces no se perciba como tal.

El artículo identifica varias fases del ciclo de investigación donde la automatización ya está avanzando o podría hacerlo con mayor intensidad. Entre ellas se encuentran la búsqueda y descubrimiento de literatura, la organización de información, el apoyo a la redacción científica, la revisión preliminar de manuscritos y ciertas tareas administrativas dentro de las instituciones académicas. En estos ámbitos, la IA se presenta como un mecanismo de ampliación de capacidades, especialmente relevante para equipos con recursos limitados, como bibliotecas universitarias pequeñas o centros de investigación con alta carga operativa. La automatización permite reducir tareas repetitivas y liberar tiempo para actividades de mayor valor intelectual o pedagógico.

Sin embargo, el texto subraya que existen dimensiones del proceso de investigación que no pueden ni deberían ser completamente automatizadas. Entre ellas destacan la curación crítica del conocimiento, la interpretación contextual de los resultados, la toma de decisiones éticas y la integración del conocimiento en marcos institucionales específicos. Estas funciones requieren experiencia acumulada, sensibilidad disciplinar y comprensión del entorno académico que la IA no puede replicar plenamente. También se enfatiza la importancia del juicio humano en cuestiones relacionadas con la integridad científica, el riesgo institucional y la responsabilidad legal.

Un eje central del debate es la tensión entre eficiencia y confianza. Aunque la automatización puede acelerar significativamente el ciclo de producción del conocimiento, también introduce problemas de opacidad, reproducibilidad y gobernanza. El artículo señala que muchas de las herramientas actuales operan como “cajas negras”, lo que genera preocupación entre bibliotecarios, editores y gestores de investigación. La cuestión no es solo técnica, sino estructural: cómo garantizar que los sistemas automatizados sean transparentes, auditables y alineados con los valores de la ciencia abierta.

Finalmente, el texto propone una visión intermedia en la que la IA no sustituye el proceso de investigación, sino que se inserta en él como infraestructura. Esto implica rediseñar flujos de trabajo completos, definir claramente los puntos de intervención humana y establecer mecanismos de control y supervisión. En este modelo, la automatización no elimina la necesidad del investigador, sino que redefine su papel, desplazándolo hacia funciones de mayor nivel cognitivo, como la interpretación, la supervisión crítica y la toma de decisiones estratégicas dentro del ecosistema de producción científica.