Archivo del Autor: Julio Alonso Arévalo

Avatar de Desconocido

Acerca de Julio Alonso Arévalo

Bibliotecario de la Facultad de Traducción y Doc. de la USAL. Ex-Miembro del Grupo de Investigación E-LECTRA. Premio Nacional de Investigación por la UNE Premio mejor Profesional Social Media INFOAWARDS 2019. Creador y editor del repositorio E-LIS. Más de 80 artículos científicos publicados - Ver en E-LIS -en revistas científicas. El profesional de la información, Library Hi-Tech, Electronic Library. Investigación Bibliotecológica, Anales de Documentación... 12 libros publicados: Nueva fuentes de información en el contexto de la web 2.0 (Pirámide), Gutemberg 2.0 (TREA). Social Reading (Elsevier), eBooks en bibliotecas universitarias (TREA), El ecosistema del libro electrónico universitario (UNE), Un viaje a la cultura open (Amazon), GRATIS Zotero (Creative Spaces), Leyendo entre Pantallas (Trea), GRATIS Literaçia da infomrçao (ISPA) GRATIS Espistemologia y acceso abierto (UCE) GRATIS Makerspaces y bibliotecas. Barcelona: El Profesional de la Información EPI-UOC, 2018. Makerspaces. Espacios creativos en bibliotecas: creación, planificación y programación de actividades. Salamanca: Ediciones del Universo, 2019. Los libros, la lectura y los lectores a través de la literatura y las artes. Buenos Aires : Alfagrama Ediciones, 2019 Más de 2000 citas en Google Schoolar Creador y gestor del blog Universo abierto Director del programa de Radio Planeta Biblioteca Más de 250.000 seguidores en los grupos profesionales de Facebook.

Urban Libraries Council y la Universidad de Albany se asocian para estudiar el impacto de la IA en bibliotecas

«RELEASE: Public Libraries Set the Stage for Integration of Artificial Intelligence in Their Services and Resources». s. f. Urban Libraries Council. Accedido 20 de diciembre de 2023. https://www.urbanlibraries.org/newsroom/release-public-libraries-set-the-stage-for-integration-of-artificial-intelligence-in-their-services-and-resources-1-1.


El Urban Libraries Council (ULC) y el Center for Technology in Government (CTG UAlbany) de la Universidad de Albany se han asociado para analizar cómo las bibliotecas pueden capacitar a las comunidades para comprender mejor la Inteligencia Artificial y garantizar su diseño y aplicación éticos. Este proyecto de investigación de tres años, financiado mediante una subvención del Instituto de Servicios de Museos y Bibliotecas, incluirá encuestas e entrevistas a las bibliotecas miembros del ULC, estudios de caso, un informe integral y una guía para profesionales de bibliotecas.

«Estar en la primera línea de la nueva tecnología es una posición común para las bibliotecas, y el rápido crecimiento de la IA ha convertido esto en un tema urgente para los líderes bibliotecarios», dijo Brooks Rainwater, Presidente y CEO de ULC. «Estamos emocionados de asociarnos con CTG UAlbany para demostrar cómo las bibliotecas públicas pueden actuar como catalizadores que fortalezcan la comprensión, el uso y el avance de la IA en nuestras vidas».

La investigación de CTG UAlbany abordará tres preguntas:

  1. ¿Qué papel pueden desempeñar las bibliotecas públicas en aumentar el conocimiento sobre la IA en la comunidad?
  2. ¿Cómo pueden las bibliotecas públicas fomentar la participación cívica inclusiva en iniciativas de IA?
  3. ¿Cuáles son las oportunidades, amenazas, beneficios y desafíos de que las bibliotecas públicas lideren la participación cívica inclusiva en iniciativas de IA?

«Aunque académicos y profesionales recomiendan la participación pública en la IA para identificar posibles perjuicios, mejorar la calidad de los conjuntos de datos y abordar mejor las necesidades de la comunidad, no hay estrategias claras para involucrar a las comunidades en iniciativas de IA ni espacios disponibles donde pueda tener lugar este compromiso», dijo Mila Gascó-Hernández, Directora de Investigación de CTG UAlbany. «Creemos que las bibliotecas públicas, como espacios de aprendizaje y socios comunitarios de confianza, pueden desempeñar un papel crucial en la promoción y el avance de la participación cívica inclusiva en iniciativas de IA».

La investigación se basará en el trabajo realizado por ambos socios. La iniciativa sigue a la investigación anterior de CTG UAlbany sobre el papel de las bibliotecas públicas en mejorar los ecosistemas de gobiernos abiertos y en el desarrollo de comunidades inteligentes. En octubre de 2023, ULC lanzó un informe de liderazgo sobre cómo las bibliotecas públicas pueden prepararse para una rápida integración de la IA en los servicios, recursos y operaciones de la biblioteca. Desde aprovechar las habilidades de ingeniería de los miembros del personal hasta utilizar la IA para avanzar en la alfabetización informacional, ULC recomienda que las bibliotecas deben estar preparadas para una rápida integración de la IA en sus servicios, recursos y operaciones.

Retos presentes y futuros sobre la adopción e implementación de RDA en las bibliotecas de América Latina

Martínez Arellano, Filiberto Felipe, y Patricia De la Rosa Valgañón (eds). Retos presentes y futuros sobre la adopción e implementación de RDA en las bibliotecas de América Latina. Universidad Nacional Autónoma de México. Instituto de Investigaciones Bibliotecológicas y de la Información, 2023.

Texto completo

Esta obra presenta los resultados de una reunión académica entre investigadores, profesores y bibliotecólogos vinculados con la teoría y la práctica de la catalogación, los catálogos y los metadatos, en donde se discutió el tema “Retos presentes y futuros sobre la adopción e implementación de RDA en las bibliotecas de América Latina” En la discusión académica, convocada por la Biblioteca Nacional de México (BNM), el Grupo RDA América Latina y el Caribe de ABINIA, el Instituto de Investigaciones Bibliotecológicas y de la Información (IIBI) y la Dirección General de Bibliotecas y Servicios Digitales de Información (DGBSDI) de la Universidad Nacional Autónoma de México (UNAM), se contó con la participación de representantes de estas instituciones, así como de otras instituciones nacionales e internacionales. La obra reúne valiosas contribuciones sobre el proceso de adopción e implementación del estándar de catalogación RDA (Resource Description and Access) en diversas bibliotecas y otras instituciones, así como contribuciones sobre las principales tendencias en la organización de la información y la catalogación: modelo LRM (Library Reference Model), Datos vinculados (Linked Data) y Grafos del conocimiento (Knowledge Graph). La publicación proporciona un mayor conocimiento de los cambios que han sido incorporados en RDA para afrontar de mejor forma su adopción e implementación en las bibliotecas de México y América Latina, así como su enseñanza e investigación

¿Qué es Copilot de Microsoft? ¿Es mejor que ChatGPT? 

Acceder a Coplitot

El año pasado, Microsoft presentó una versión especial de su motor de búsqueda Bing impulsada por inteligencia artificial (IA). A lo largo del último año y algunos meses, la compañía ha continuado expandiendo sus ofertas, utilizando el mismo servicio de motor de búsqueda como un chatbot de IA llamado Bing Chat, que ahora ha sido renombrado como Copilot. ¿Qué es exactamente Copilot y cómo se compara con otros chatbots de IA como ChatGPT y Claude? Aquí tienes lo que necesitas saber.

Microsoft Copilot es una herramienta de colaboración inteligente que utiliza técnicas de lenguaje natural y aprendizaje automático para proporcionar sugerencias útiles y personalizadas en tiempo real mientras trabajas.

¿Qué es Copilot? Esencialmente, Copilot es la versión de Microsoft de ChatGPT, utilizando el mismo lenguaje. Puedes hacerle preguntas similares y utilizarlo para resolver tareas complejas, como problemas matemáticos y crear imágenes. Copilot se basa en GPT-4, con acceso a internet para proporcionar información actualizada sobre las consultas.

¿Cuánto cuesta Copilot? Copilot es gratuito y es la única forma de acceder gratuitamente a GPT-4. Solo necesitas una cuenta de Microsoft, también gratuita.

¿Por qué hay múltiples aplicaciones Copilot? Hay varias ofertas bajo el paraguas de Copilot, como el chatbot Copilot, Windows Copilot, Copilot for Microsoft 365, Copilot for service, Copilot for Sales, entre otros. Aunque existen múltiples versiones, Copilot es el chatbot principal y es gratuito.

¿Qué modelo de lenguaje utiliza Copilot? Copilot se basa en la última versión del modelo GPT de OpenAI, GPT-4, que es el mismo modelo al que acceden los usuarios de ChatGPT Plus.

¿Cuál es el límite de chat de Copilot? Actualmente, Copilot tiene un límite de 2.000 caracteres por chat, menor que el límite de 4.096 de ChatGPT.

¿Cómo se accede a Copilot? Copilot es accesible de forma gratuita con una cuenta de Microsoft. Puedes ingresar a través del sitio web de Copilot. Microsoft no ha anunciado una opción premium para Copilot hasta ahora.

¿Hay una aplicación Copilot? Si no deseas usar el sitio web, puedes acceder a Copilot a través de la aplicación Bing en dispositivos iPhone y Android.

¿Es Copilot mejor que ChatGPT? Ambos operan de manera similar, ya que utilizan los mismos modelos de lenguaje. Copilot puede ser más eficiente y preciso que la versión gratuita de ChatGPT (GPT-3.5). Copilot se destaca en su integración con la búsqueda en línea, aprovechando la conexión a Internet a través de Bing, lo que lo hace eficiente para acceder a información actualizada. Ambos responderán de manera similar ya que utilizan el mismo modelo de lenguaje. Copilot también proporciona el enlace al contenido del que ha tomado la información.

FUENTE

El uso legítimo: mitos y conceptos erróneos sobre los derechos de autor

Carrie Russell «Figuring Out Fair Use». 2023. American Libraries Magazine. 1 de noviembre de 2023. https://americanlibrariesmagazine.org/?p=140589.

Libreros y maestros, profesionales bibliotecarios especializados en alfabetización informacional, acceso equitativo a la información y avance del aprendizaje, a menudo enfrentan ansiedades y conceptos erróneos sobre el copyright. El miedo infundado a litigios de copyright y la falta de educación sobre el tema contribuyen a esta situación.

El desconocimiento sobre el copyright se agrava en entornos educativos saturados de trabajo, donde el personal, ya sobrecargado, carece de tiempo para abordar cuestiones legales como el copyright. La complejidad añadida de los formatos digitales y las licencias privadas complica aún más la gestión efectiva del copyright en las escuelas.

La Constitución de EE.UU. dice que la ley de derechos de autor se crea «para promover el progreso de la ciencia y de las artes útiles». Su intención es, ante todo, fomentar la creación y difusión de obras originales y creativas que beneficien al público. Estas políticas también están diseñadas para avanzar en el bienestar público poniendo a disposición obras que promuevan el aprendizaje, inspiren la creación de nuevas obras, produzcan ciudadanos bien informados y fomenten la búsqueda de la felicidad.

La noción de que la ley de derechos de autor sirve al interés público puede sonar pintoresca cuando gran parte de la discusión pública, y ciertamente gran parte del debate político, gira en torno al valor monetario de los derechos de autor. Aunque los derechos de autor tienen un importante valor económico en la economía global de la información, el propósito fundamental de estas leyes es el bienestar público. Por lo tanto, los valores que subyacen a la ley de derechos de autor son totalmente coherentes con los valores profesionales de profesores y bibliotecarios.

A menudo se confunde a la gente o se le hace creer que la ley de derechos de autor es lo mismo que la ley de propiedad. Esta confusión se ve agravada por términos como propiedad intelectual, que es un término equivocado. En cambio, la ley de derechos de autor se asemeja a la regulación gubernamental en que el Congreso crea la ley para intervenir en el mercado mediante la concesión a los titulares de derechos de un monopolio -a través de los derechos exclusivos de autor- para lograr un propósito público.

A muchos bibliotecarios y profesores les molesta que no existan normas claras. A menudo, la respuesta a una pregunta concreta sobre derechos de autor exige analizar la situación para determinar si se trata de un uso legítimo. Puede que sea molesto, pero nos conviene que la ley sea ambigua. Fijar las normas de derechos de autor en piedra sería congelar la ley. La ley debe ser maleable para servir a nuestra sociedad ahora y en el futuro, un futuro sobre el que sólo podemos especular. El uso legítimo nos servirá porque está abierto a las nuevas tecnologías.

Cinco conceptos erróneos comunes sobre el copyright se destacan en el artículo:

  1. Erróneamente se cree que el propósito principal del copyright es compensar monetariamente a los autores y creadores, cuando en realidad busca fomentar el progreso de la ciencia y las artes útiles en beneficio del público.
  2. Existe el temor de que los titulares de derechos demanden a bibliotecarios, maestros y escuelas con frecuencia, cuando los casos reales en los tribunales son raros. Además, existen limitaciones legales y protecciones para instituciones educativas y bibliotecas.
  3. La confusión entre la ley de copyright y la propiedad intelectual lleva a la creencia errónea de que las obras protegidas son propiedad exclusiva de los creadores. En realidad, el copyright otorga derechos exclusivos para comercializar la obra, no para poseerla.
  4. Muchos esperan reglas legales definitivas para cuestiones de copyright, pero la ley es flexible y la determinación de uso justo a menudo requiere análisis caso por caso.
  5. Se percibe que el uso justo es difícil de entender y aplicar, cuando, en realidad, comprender y aplicar los cuatro factores del uso justo puede ser más natural con la práctica.

En conclusión, a pesar de las dificultades y malentendidos, es crucial para los profesionales de bibliotecas y educación comprender el copyright y aplicar el uso justo para equilibrar los derechos de los usuarios con los intereses de los titulares de derechos.

El alfagrama y el Manuscrito Voynich

El «Manuscrito Voynich» es conocido por su contenido encriptado y las ilustraciones desconcertantes, pero el método específico utilizado para cifrar el texto aún no se ha identificado. Se cree que el manuscrito fue redactado con alfagramas hebreos, lo que significa que las palabras originales se han modificado para que no sean reconocibles

Este enigmático libro ilustrado, que se remonta al siglo XV, ha resistido todos los intentos de descifrar su contenido. Nombrado en honor a Wilfrid Voynich, un librero polaco que lo adquirió en 1912, el manuscrito ha desconcertado a criptógrafos, lingüistas y académicos debido a su contenido incomprensible y a las detalladas e inusuales ilustraciones que lo acompañan.

Escrito en un sistema de escritura desconocido, el texto del manuscrito ha desafiado la comprensión a pesar de numerosos esfuerzos a lo largo de los años. Además, destaca por sus ilustraciones meticulosas de plantas, estrellas, anatomía humana y escenas que no tienen paralelo en ninguna realidad conocida. Muchas de estas imágenes son genuinamente únicas y peculiares.

El uso de alfagramas, que implica la reorganización alfabética de las letras de una palabra original, se ha sugerido como parte del método de cifrado del «Manuscrito Voynich». Este proceso desempeña un papel esencial en criptografía, donde la escritura se cifra para alterar la apariencia de la palabra original. Por ejemplo, al reordenar alfabéticamente las letras de «alfagrama», se obtiene «aaaafglmr», y para «escritura» se forma «aceirrstu». Aunque se especula sobre el uso de alfagramas hebreos en el manuscrito, hasta ahora no se ha logrado demostrar ni traducir ninguna de sus páginas.

A pesar de los persistentes esfuerzos de expertos en criptografía y lingüística, el contenido del «Manuscrito Voynich» permanece sin descifrar, manteniendo su significado en el misterio. Las teorías sobre su origen y propósito varían ampliamente, desde la posibilidad de ser un sofisticado fraude hasta la idea de contener información codificada sobre prácticas médicas o alquímicas de la época. La incertidumbre que rodea al manuscrito ha generado un considerable interés tanto en la comunidad académica como entre los entusiastas de los misterios históricos.

ACRL y CNI designan un grupo de trabajo conjunto sobre planificación de escenarios para futuros de IA y aprendizaje automático en bibliotecas

«Association of Research Libraries and Coalition for Networked Information Appoint Joint Task Force on Scenario Planning for AI and Machine-Learning Futures». s. f. Association of Research Libraries (blog). Accedido 19 de diciembre de 2023.

Texto completo

La planificación de escenarios para los futuros de la inteligencia artificial (IA) y el aprendizaje automático implica desarrollar varios escenarios plausibles y diversos para ayudar a las organizaciones y personas a anticipar posibles desafíos y oportunidades. Dada la rápida innovación en estos campos, considerar diferentes futuros es crucial para la planificación estratégica y la toma de decisiones.

Un grupo de trabajo conjunto, representando a los miembros de la Asociación de Bibliotecas de Investigación (ARL) y la Coalición para la Información en Red (CNI), ha comenzado a trabajar en una iniciativa de seis meses para desarrollar un conjunto de posibles escenarios futuros que examinen cómo la inteligencia artificial (IA) y el aprendizaje automático podrían transformar la empresa de investigación. Esperamos que estos escenarios sean útiles para nuestras instituciones miembros y la comunidad en general para comprender, planificar y explorar las implicaciones de estas tecnologías.

Las oportunidades para contribuir al desarrollo de estos escenarios se llevarán a cabo a través de reuniones que coincidan con las reuniones de ARL y CNI, y mediante grupos de enfoque virtuales abiertos a la comunidad en general. ARL y CNI han contratado a Stratus, Inc. para facilitar el desarrollo del conjunto de escenarios. Susan Stickley, CEO de Stratus, trabajó anteriormente con ARL en los Escenarios 2030, publicados en 2010.

Servicios de referencia con chatbots en las bibliotecas universitarias canadienses

Guy, J., Pival, P. R., Lewis, C. J., & Groome, K. (2023). Reference Chatbots in Canadian Academic LibrariesInformation Technology and Libraries42(4). Retrieved from https://ital.corejournals.org/index.php/ital/article/view/16511

Los chatbots son «agentes informáticos que pueden interactuar con el usuario» de una forma parecida a una conversación entre humanos. Aunque el uso de chatbots para el servicio de referencia en las bibliotecas universitarias es un tema de interés tanto para los profesionales de las bibliotecas como para los investigadores, se sabe poco sobre cómo se utilizan en el servicio de referencia de las bibliotecas, especialmente en las bibliotecas universitarias de Canadá.

Este artículo tiene como objetivo llenar este vacío mediante la realización de una encuesta basada en la web de 106 sitios web de bibliotecas académicas en Canadá y el análisis de la prevalencia y las características de los servicios de chatbot y chat en vivo ofrecidos por estas bibliotecas. Los autores descubrieron que sólo dos bibliotecas utilizaban chatbots para el servicio de referencia. En cuanto a los servicios de chat en vivo, los autores descubrieron que 78 bibliotecas ofrecían este servicio. El artículo analiza las posibles razones de la escasa adopción de chatbots en las bibliotecas universitarias, como la accesibilidad, la privacidad, el coste y los problemas de identidad profesional. El artículo también ofrece un estudio de caso de la institución de los autores, la Universidad de Calgary, que integró un servicio de chatbot en 2021. El artículo concluye con sugerencias para futuras investigaciones sobre el uso de chatbot en bibliotecas.

Estafadores que se hacen pasar por editores invitados para publicar documentos falsos

Else, Holly. 2021. «Scammers Impersonate Guest Editors to Get Sham Papers Published». Nature 599 (7885): 361-361. https://doi.org/10.1038/d41586-021-03035-y.

Cientos de artículos publicados en revistas revisadas por pares están siendo retractados después de que estafadores explotaran los procesos para publicar números especiales con el fin de incluir documentos de baja calidad, a veces compuestos completamente de incoherencias, en revistas establecidas. En algunos casos, los defraudadores se hicieron pasar por científicos y ofrecieron editar números especiales que luego llenaron con documentos fraudulentos.

Elsevier está retirando 165 artículos actualmente en prensa y planea retractar 300 más que se han publicado como parte de 6 números especiales en una de sus revistas, mientras que Springer Nature está retractando 62 artículos publicados en un número especial de una revista. Las retractaciones se producen después de que ambos editores emitieran comunicados de preocupación a principios de este año, que cubrían cientos de artículos.

Expertos en integridad científica esperan que haya más investigaciones en los próximos meses a medida que otros títulos se den cuenta de que han sido engañados.

«Es muy preocupante», dice Guillaume Cabanac, un científico informático de la Universidad de Toulouse en Francia, quien ha trabajado para descubrir documentos de ciencia sin sentido en números especiales. Añade que es impactante ver tales documentos en revistas de editores «emblemáticos» y que «no solo son las revistas depredadoras las que publican tonterías».

Un portavoz de Springer Nature dijo que una investigación reveló «intentos deliberados de subvertir el proceso editorial basado en la confianza y manipular el registro de publicación». Agregaron que aún no saben quién es responsable Elsevier dice que ha implementado medidas para evitar problemas similares en el futuro.

Muchas revistas publican números especiales, colecciones de artículos que se centran en un tema particular de relevancia para sus lectores. Estos números a menudo son supervisados por editores invitados que son expertos en el tema de investigación, pero que generalmente no están involucrados en el trabajo editorial diario de la revista.

Los estafadores han sido descubiertos varias veces en los últimos años al intentar utilizar números especiales como una forma de publicar documentos de baja calidad en revistas legítimas, pero el número de documentos afectados parece estar aumentando.

En 2016, Retraction Watch informó que los estafadores se hicieron pasar por un científico conocido para engañar a The Scientific World Journal, publicado por Hindawi, para que los nombrara editor invitado de un número especial sobre metaheurísticas. Una investigación posterior del editor encontró que varios informes de revisión por pares para documentos publicados en el número especial provenían de cuentas de correo electrónico comprometidas pertenecientes a otros investigadores. Hindawi le dijo a Retraction Watch que no tenía idea de quién estaba detrás de la estafa y dijo que había implementado medidas para ayudar a prevenir que el problema vuelva a ocurrir.

En diciembre de 2020, el Journal of Nanoparticle Research de Springer Nature escribió que había sido «atacado de una nueva manera por una red sofisticada y organizada». Un grupo de lo que parecían ser eminentes científicos e ingenieros de instituciones conocidas en Alemania y el Reino Unido escribieron a los editores de la revista sugiriendo un número especial sobre el papel de la nanotecnología en la atención médica en septiembre de 2019. La junta editorial aceptó la propuesta, creó una entrada para el número especial en su sistema de gestión editorial y dio acceso a tres miembros del grupo para que pudieran manejar los manuscritos.

Meses después, algunos miembros de la junta editorial comenzaron a notar que la mayoría de los manuscritos presentados para el número especial eran de baja calidad o no se ajustaban al tema. Iniciaron una investigación, pero para entonces, 19 de las 80 presentaciones ya habían sido aceptadas o publicadas. Estos documentos han sido retractados desde entonces.

La investigación reveló que las personas que sugirieron el número especial no eran quienes decían ser, sino estafadores que usaban nombres de dominio de Internet que se parecían mucho a las direcciones de correo electrónico institucionales reales de los científicos. Estos incluían un sufijo de correo electrónico con ‘univ’ en lugar de ‘uni’ y ‘-ac.uk’ en lugar de ‘.ac.uk’. También hubo anomalías con las identidades de los revisores y los informes de revisión por pares.

«Todo apunta a una red organizada que intenta, en este caso con éxito, infiltrarse en revistas científicas con el objetivo de publicar fácilmente manuscritos de seudo científicos o investigadores menos productivos que desean aparecer en revistas respetables», escribieron tres miembros de la junta editorial de la revista en el artículo de diciembre.

Todavía no está claro por qué los estafadores están manipulando el sistema para publicar artículos falsos. Cabanac sugiere que podría deberse a la presión sobre los investigadores para publicar artículos y continuar con sus carreras. La capacidad de publicar en revistas específicas, incluso si los documentos son claramente sin sentido, podría permitir que algunos investigadores «obtengan publicaciones para su currículum y un pase verde para permanecer en la academia», dice.

Pero las motivaciones de los estafadores siguen siendo un misterio para Ivan Oransky, un periodista que dirige Retraction Watch. Incluso los títulos de los artículos, que se listarían como parte del historial de publicaciones de un individuo, a menudo no tienen sentido, dice. «Los artículos son tan obviamente terribles, ¿por qué querrías tenerlos en tu currículum?»

Las últimas retractaciones de importantes editoriales académicas, Springer Nature y Elsevier, señalan una creciente sofisticación y prevalencia de prácticas engañosas en la publicación académica. A pesar de estos esfuerzos, persisten preocupaciones sobre la credibilidad de los números especiales, con una posible culpabilidad por asociación planteando un desafío. Ivan Oransky, cofundador de Retraction Watch, anticipa más retractaciones en el futuro, subrayando la necesidad de una vigilancia continua y medidas preventivas dentro de la comunidad de publicaciones académicas.

Récord de retracciones en investigación en 2023: Más de 10.000 artículos retirados

Van Noorden, Richard. 2023. «More than 10,000 Research Papers Were Retracted in 2023 — a New Record». Nature, diciembre. https://doi.org/10.1038/d41586-023-03974-8.


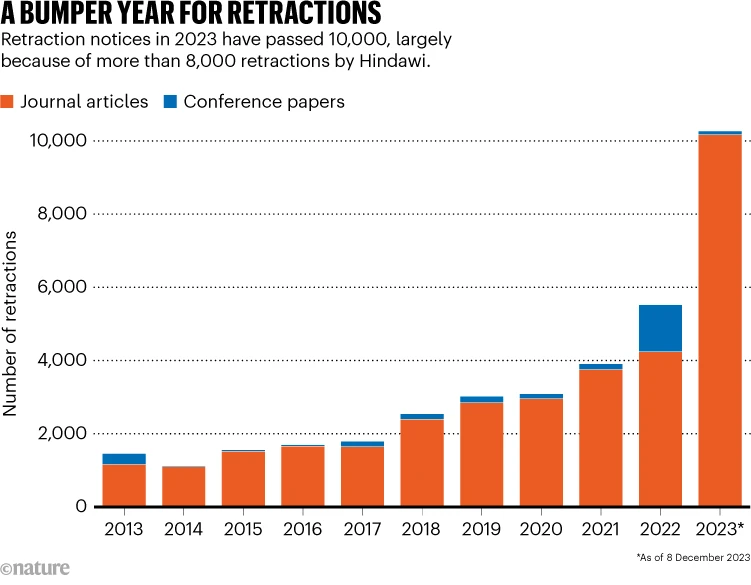
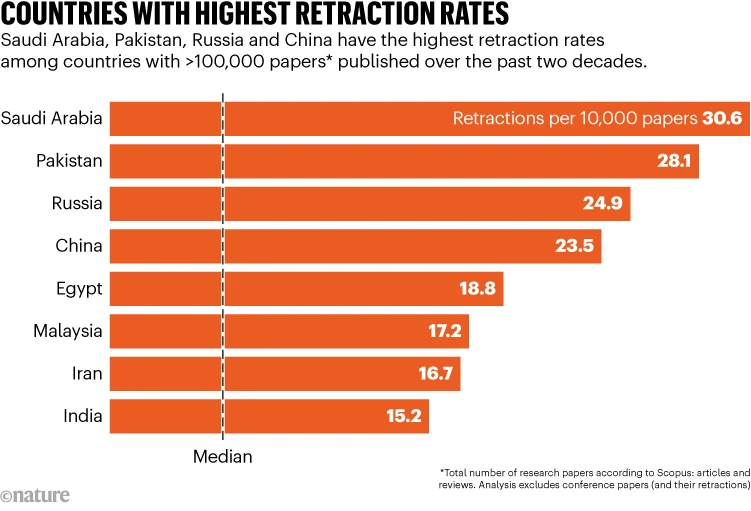
Durante el año 2023, se ha registrado un número sin precedentes de retractaciones para artículos de investigación, superando los 10,000, en medio de esfuerzos editoriales por abordar una proliferación de documentos fraudulentos y prácticas fraudulentas en la revisión por pares. Un análisis realizado por Nature revela que entre las naciones líderes en producción de investigación, Arabia Saudita, Pakistán, Rusia y China destacan por tener las tasas de retractación más elevadas en las últimas dos décadas.

El año 2023 ha experimentado un aumento significativo en la retractación de artículos de investigación, con más de 10.000 retracciones, marcando un nuevo récord. Este aumento se atribuye a los esfuerzos de los editores para abordar documentos fraudulentos y manipulación de la revisión por pares. Entre los países líderes con altas tasas de retractación en las últimas dos décadas se encuentran Arabia Saudita, Pakistán, Rusia y China. Hindawi, una subsidiaria con sede en Londres de Wiley, es responsable de la mayoría de las retractaciones en 2023, con más de 8.000 artículos retirados debido a preocupaciones sobre la revisión por pares comprometida y manipulación del proceso de publicación.

Wiley ha decidido deshacerse la marca Hindawi y ha implementado procesos más rigurosos para garantizar la integridad del proceso de publicación y revisión por pares. El editor espera una pérdida de ingresos de 35-40 millones de dólares debido a estos problemas. A pesar de ser en su mayoría artículos falsos, los documentos retirados de Hindawi fueron citados colectivamente más de 35.000 veces, indicando su impacto.

.

.

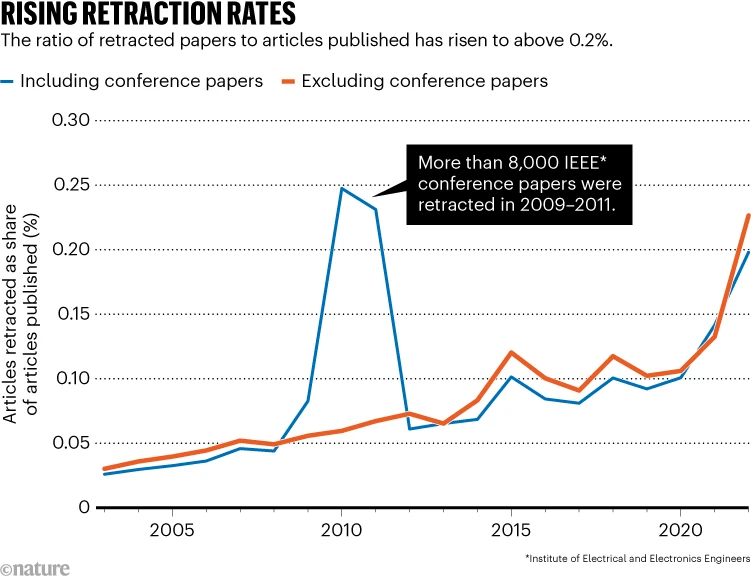
La tendencia general de retractaciones supera el crecimiento de los documentos científicos, con el número total de retractaciones superando las 50.000. El análisis de Nature sugiere que la tasa de retractación se ha triplicado en la última década, alcanzando más del 0.2% en 2022. Arabia Saudita tiene la tasa de retractación más alta entre los países que han publicado más de 100.000 artículos en las últimas dos décadas.

.

.

El análisis también revela que alrededor de una cuarta parte de las retractaciones son documentos de conferencias, siendo el Instituto de Institute of Electrical and Electronics Engineers (IEEE) líder en esta categoría. IEEE ha enfrentado críticas por problemas como el fraude de citas y el plagio en algunos de sus documentos.

.

.

Los expertos en integridad enfatizan que las retractaciones registradas son solo la punta del iceberg, con potencialmente cientos de miles de artículos de «fábricas de documentos» (empresas que venden investigación falsa) que aún no se han abordado. Estos documentos fraudulentos representan un problema, ya que pueden agregarse a artículos de revisión y integrarse en la literatura convencional.

Puntos Clave:

  • Más de 10.000 artículos de investigación retractados en 2023, estableciendo un nuevo récord.
  • Hindawi, una subsidiaria de Wiley, es responsable de la mayoría de las retractaciones, con más de 8.000 artículos retirados.
  • Wiley discontinúa la marca Hindawi y anticipa una pérdida de ingresos de 35-40 millones de dólares.
  • Las tasas de retractación están aumentando, superando el crecimiento de los documentos científicos, con un número total que supera las 50.000.
  • Arabia Saudita tiene la tasa de retractación más alta entre los países que publican más de 100.000 artículos.
  • El IEEE lidera las retractaciones de documentos de conferencias, con medidas preventivas en su lugar pero enfrentando críticas por fraude de citas y plagio.
  • Los expertos en integridad sugieren que las retractaciones registradas son solo una fracción del problema, con potencialmente cientos de miles de documentos fraudulentos de «fábricas de documentos» aún por abordar.

El Proyecto y la Metodología de la Investigación

Ynoub, Roxana Cecilia. El Proyecto y la Metodología de la Investigación. 1a ed. Buenos Aires: Cenage, 2011

Texto completo

¨El Proyecto y la Metodología de la Investigación¨ de la Editorial CENGAGE Learning (Argentina) que Roxana Cecilia Ynoub ha creado. Este libro resume los principales conceptos del mundo de la metodología y la investigación científica. Pensado para quienes se inician en este campo, reúne de manera sencilla y con ejemplos claros las distintas metodologías de investigación. El primer capítulo ahonda en las distintas acepciones del concepto, el segundo se dedica específicamente a la investigación científica. Los siguientes capítulos detallan los diferentes pasos a seguir en cualquier proceso investigativo.