Archivo de la categoría: Tecnologías de la información

Los detectores de IA se están utilizando para sancionar a los estudiantes: ¿son realmente fiables?

CNET. “AI Detectors Are Being Used to Discipline Students. I Tested Whether They Should Be.” CNET, 2026. Artículo original en CNET

Los detectores de IA pueden proporcionar indicios, pero no deberían considerarse una prueba concluyente de autoría ni constituir, por sí solos, la base para sancionar a un estudiante. La cuestión fundamental no es solamente si podemos detectar IA, sino cómo garantizar procesos de evaluación académica justos y fiables en un contexto en el que humanos e inteligencia artificial colaboran cada vez más en la producción de textos.

Se aborda un problema cada vez más controvertido en el ámbito educativo: el uso de detectores de inteligencia artificial para determinar si un estudiante ha utilizado ChatGPT u otras herramientas generativas en la elaboración de un trabajo. La cuestión adquiere especial importancia porque algunas instituciones educativas están utilizando estas herramientas como elemento de prueba para investigar o incluso sancionar a estudiantes, pese a que la detección de textos generados por IA no ofrece una certeza equivalente a la de una prueba objetiva de autoría.

La experiencia descrita en el artículo pone de manifiesto una de las principales debilidades de estos sistemas: los detectores pueden equivocarse tanto al identificar textos humanos como textos generados por IA. El problema de los falsos positivos resulta especialmente preocupante en contextos académicos, ya que un texto redactado íntegramente por un estudiante puede ser clasificado como producido por inteligencia artificial. Del mismo modo, pequeñas modificaciones o procesos de edición pueden alterar considerablemente el resultado de la detección.

El artículo también cuestiona la idea de que exista una especie de “huella digital” inequívoca de la IA en un texto. Los modelos de detección trabajan mediante estimaciones probabilísticas relacionadas con características lingüísticas y patrones estadísticos, pero no pueden demostrar por sí mismos quién ha escrito un documento. Por ello, un porcentaje elevado de probabilidad de utilización de IA no debería interpretarse como una prueba definitiva de que un estudiante ha cometido una infracción académica.

Una cuestión particularmente relevante es la asimetría entre el poder de estas herramientas y las consecuencias de sus errores. Cuando un detector se emplea simplemente como instrumento orientativo para iniciar una conversación con el estudiante, sus limitaciones pueden resultar manejables. Sin embargo, cuando el resultado se transforma directamente en una acusación o en una sanción académica, un falso positivo puede tener consecuencias importantes para la trayectoria educativa de una persona. El artículo invita, por tanto, a diferenciar claramente entre detectar una anomalía estadística y demostrar una conducta académicamente deshonesta.

El texto resulta especialmente pertinente para el debate sobre integridad académica en la era de la IA generativa. La aparición de ChatGPT y de otras herramientas similares obliga a las universidades a replantearse no solamente cómo detectar posibles usos indebidos de IA, sino también qué significa actualmente escribir, investigar, aprender y demostrar competencias. En lugar de depositar una confianza excesiva en los detectores, parece más razonable combinar diferentes evidencias: proceso de elaboración del trabajo, versiones anteriores, referencias utilizadas, capacidad del estudiante para explicar sus argumentos y diálogo con el docente.

En este sentido, el artículo plantea indirectamente un cambio de enfoque: la respuesta a la IA generativa no debería basarse exclusivamente en una tecnología destinada a “policiar” los textos, sino en estrategias educativas que permitan enseñar un uso responsable, transparente y crítico de estas herramientas. Para las bibliotecas universitarias y los programas de alfabetización informacional, esto supone una oportunidad para incorporar nuevas competencias relacionadas con la IA, la evaluación crítica de sus resultados, la transparencia en su utilización y la comprensión de sus limitaciones.

Destruir libros para construir una mente artificial: Anthropic y el futuro de la lectura

Mancino, Francesca. “Destroying Books to Build a Mind.” The New Yorker, 8 de septiembre de 2026. https://www.newyorker.com/culture/the-lede/destroying-books-to-build-a-mind

Anthropic adquirió y digitalizó masivamente libros, incluso destruyendo físicamente algunos ejemplares, para utilizarlos en el entrenamiento de sus modelos de IA. El caso plantea un debate sobre copyright, preservación, transparencia y el futuro del libro, diferenciando entre conservar información y conservar realmente los libros como objetos culturales.

A principios de 2026, numerosos libreros de segunda mano estadounidenses y canadienses comenzaron a recibir pedidos masivos de libros extraños, especializados y de escasa demanda. Eran títulos sobre arquitectura, derecho, historia, ciencias sociales, literatura o incluso cuestiones muy específicas como el tratamiento de aguas residuales. Los pedidos procedían en ocasiones de sociedades de responsabilidad limitada con nombres poco reconocibles, lo que despertó la curiosidad de los vendedores. Una investigación permitió relacionar parte de estas compras con Anthropic, la empresa responsable de Claude. Los documentos judiciales posteriormente revelados permitieron conocer la existencia de Project Panama, una iniciativa cuyo objetivo era adquirir enormes cantidades de libros impresos para convertirlos en datos digitales destinados al entrenamiento de modelos de IA.

La particularidad del procedimiento es que se trataba de digitalización destructiva. Los libros se compraban físicamente, se les retiraba la encuadernación, las páginas se cortaban para facilitar su procesamiento y posteriormente se escaneaban industrialmente, mientras que el ejemplar físico era descartado. El artículo explica que esta técnica no es completamente nueva: determinadas bibliotecas y departamentos de preservación digital también desmontan libros para conseguir una digitalización más rápida y eficiente. La diferencia fundamental está en la escala y en el propósito. Anthropic pretendía obtener millones de páginas para alimentar sus sistemas de inteligencia artificial. En Princeton, por ejemplo, se ha optado deliberadamente por métodos de digitalización que permiten conservar los ejemplares físicos, aunque sean más costosos.

Uno de los matices importantes del reportaje es que la imagen de Anthropic destruyendo ejemplares únicos y valiosísimos de libros antiguos resulta más espectacular que la realidad documentada. Según la investigación de The New Yorker, los libreros consultados no identificaron una adquisición sistemática de libros verdaderamente antiguos o antiquarios. Muchos de los ejemplares tenían ISBN y eran publicaciones relativamente recientes, aunque con tiradas pequeñas y escasa circulación. Una lista de más de 600 títulos proporcionada por libreros mostró que buena parte correspondía a publicaciones académicas, especialmente de editoriales universitarias, y que abarcaban historia, biografía, ficción, poesía, crítica literaria, derecho y ciencias sociales. Precisamente estos libros especializados y poco populares pueden resultar especialmente valiosos para entrenar modelos de IA porque contienen conocimientos que difícilmente se encuentran en grandes corpus comerciales o en la web generalista.

Aquí aparece una de las cuestiones más interesantes del artículo: la IA puede estar rescatando digitalmente conocimientos que, de otro modo, permanecerían prácticamente invisibles, pero lo hace transformando los libros en materia prima para modelos computacionales. Algunos de los títulos adquiridos probablemente estaban destinados a quedar olvidados en almacenes, librerías de segunda mano o colecciones con muy poca circulación. Desde esta perspectiva, introducirlos en un modelo de IA puede aumentar enormemente su capacidad de supervivencia informativa. El problema es que esa preservación no equivale necesariamente a conservación cultural. El libro deja de existir como objeto accesible y pasa a convertirse en información procesada por una máquina, sin que investigadores, lectores o bibliotecas puedan necesariamente consultar o reconstruir el conjunto documental que alimentó al modelo.

El artículo aborda también la compleja cuestión de los derechos de autor y del uso legítimo (fair use). Anthropic se enfrentó a demandas por utilizar libros para entrenar sus modelos y en 2025 aceptó pagar 1.500 millones de dólares para resolver una demanda colectiva relacionada con infracciones de copyright. El juez William Alsup, sin embargo, distinguió entre determinadas prácticas ilícitas —como la descarga masiva de millones de copias pirateadas— y el uso de libros adquiridos legalmente para entrenar modelos. Según su interpretación, utilizar esas obras para entrenamiento de IA podía considerarse fair use, de manera comparable a cómo una persona lee libros y posteriormente utiliza lo aprendido para producir nuevos textos. También consideró legítimo que Anthropic destruyera ejemplares físicos comprados legalmente cuando los sustituía por copias digitales destinadas exclusivamente a su biblioteca interna.

Pero la legalidad no resuelve el problema cultural y bibliotecario. El artículo plantea una cuestión fundamental: ¿podemos llamar «biblioteca» a una colección creada exclusivamente para alimentar una inteligencia artificial? En una biblioteca tradicional, los libros se conservan para que puedan ser leídos, investigados, comparados y reinterpretados por personas. En el modelo de Anthropic, los libros se convierten esencialmente en datos destinados a ampliar la «memoria» y las capacidades lingüísticas del modelo. El resultado puede contener el conocimiento de millones de libros, pero los seres humanos no tienen necesariamente acceso directo a ese corpus ni pueden saber con precisión qué documentos contiene, cómo fueron procesados o de qué manera intervienen en las respuestas generadas por la IA.

Esta cuestión conduce directamente a la transparencia de los corpus de entrenamiento. Mike Furlough, director ejecutivo de HathiTrust, señala que existe un interés legítimo en conocer cómo se construyen estos conjuntos de datos. En el mundo académico, cuando un investigador desarrolla un modelo, se espera que indique qué fuentes ha utilizado para permitir la reproducibilidad y evaluación de su trabajo. La misma lógica debería plantearse para las herramientas de IA que utilizan millones de personas para investigar, estudiar o tomar decisiones. Si un sistema responde utilizando conocimiento extraído de cientos de miles o millones de libros, resulta relevante saber qué libros fueron utilizados, bajo qué condiciones, con qué criterios y con qué mecanismos de atribución.

El aspecto quizás más profundo del artículo tiene que ver con qué significa leer. La historiadora Leah Price recuerda que el libro ha sobrevivido a numerosas predicciones sobre su desaparición y ha demostrado una extraordinaria capacidad de adaptación tecnológica. Sin embargo, la inteligencia artificial introduce una diferencia importante: no se limita a cambiar el soporte del libro, sino que puede cambiar el propio proceso mediante el cual el conocimiento es leído y utilizado. Cuando una persona lee una novela, debe dedicar tiempo, interpretar, anticipar, relacionar ideas y construir significados. Cuando una IA procesa millones de libros, convierte ese universo textual en datos que posteriormente puede recombinar para generar respuestas. El riesgo, según la reflexión del artículo, es que la lectura humana sea sustituida progresivamente por una lectura maquínica cuyo objetivo no es comprender una obra en su totalidad, sino extraer información útil de ella.

La frase que resume mejor esta tensión es la idea de que «un libro no es simplemente un recipiente de frases». El orden de las frases, la estructura, el contexto, la materialidad, las anotaciones, la procedencia del ejemplar y la experiencia del lector forman parte de su significado. Cuando un libro se desmonta y se convierte en miles de imágenes o fragmentos de texto destinados al entrenamiento de una IA, puede conservarse su contenido lingüístico, pero pueden perderse muchas dimensiones de su existencia como objeto cultural. El artículo plantea así una distinción crucial entre preservar información y preservar libros: digitalizar un texto puede salvar sus palabras, pero no necesariamente conserva toda la experiencia intelectual, material e histórica asociada al ejemplar.

Desde la perspectiva de las bibliotecas y de la gestión del conocimiento, el artículo plantea un debate especialmente relevante. Durante décadas, las bibliotecas han digitalizado colecciones para facilitar su conservación, búsqueda y acceso. Ahora las grandes empresas de IA están realizando una operación parecida, pero con una finalidad diferente: convertir las colecciones documentales en infraestructura para construir modelos de inteligencia artificial. Esto obliga a replantear qué entendemos por preservación, acceso, propiedad, colección y biblioteca. La cuestión ya no es solamente quién posee un libro, sino quién posee los datos derivados de millones de libros y quién controla las infraestructuras capaces de transformar ese conocimiento en respuestas.

La inteligencia artificial ya interviene en un tercio del descubrimiento de información científica

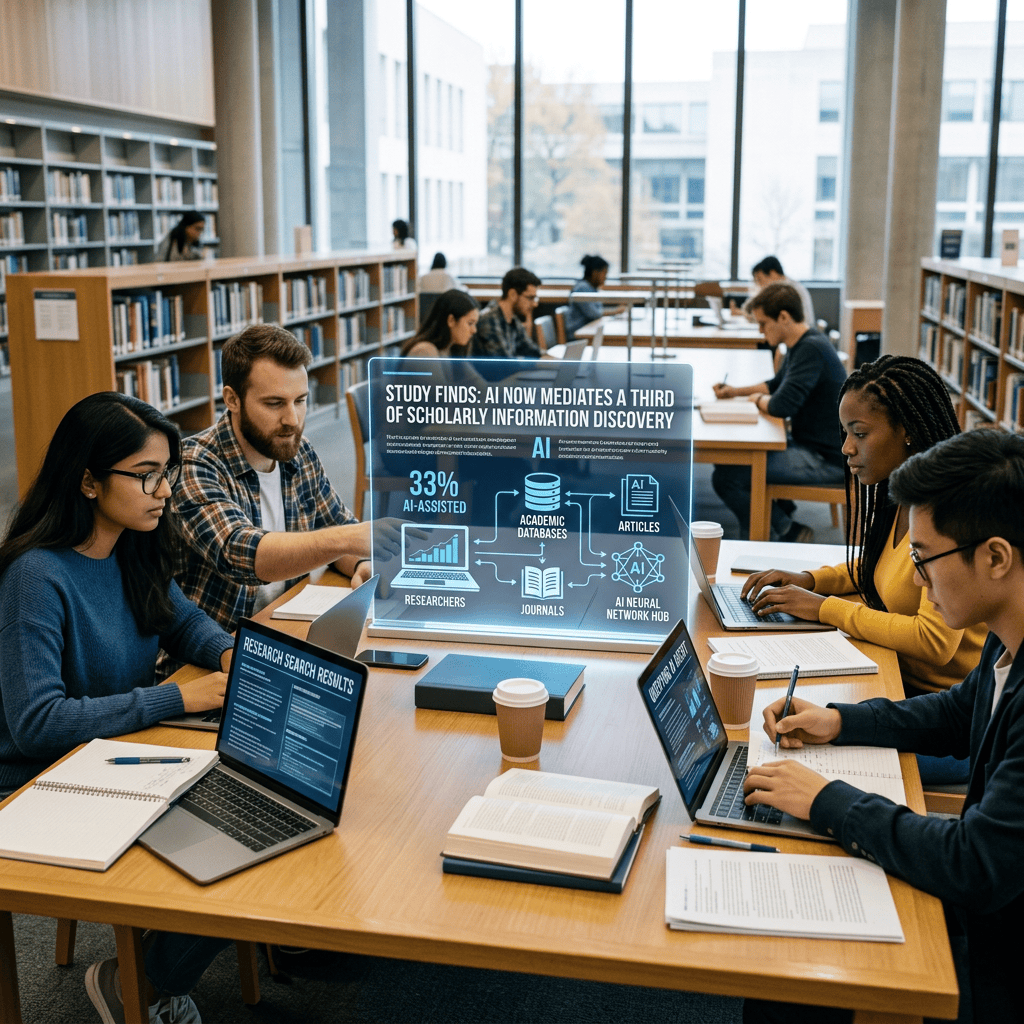
Students studying in a library beside graphic reading “STUDY FINDS: AI NOW MEDIATES A THIRD OF SCHOLARLY INFORMATION DISCOVERY,” “33% AI-ASSISTED,” and labels for academic databases, articles, researchers, journals, and an AI neural network hub.

“AI now mediates a third of scholarly information discovery, study finds”. Research Information (16 de julio de 2026), https://www.researchinformation.info/news/ai-now-mediates-a-third-of-scholarly-information-discovery-study-finds/

El artículo recoge los resultados de la primera fase del estudio Taming the Crocodile, impulsado por Kudos, que analiza cómo está cambiando la forma en que investigadores, estudiantes y bibliotecarios descubren información científica en un entorno cada vez más mediado por herramientas de inteligencia artificial.

El estudio revela un cambio profundo en las prácticas de búsqueda de información académica: aproximadamente un tercio del descubrimiento de información científica ya está mediado por la inteligencia artificial. La investigación combina encuestas realizadas a 11.500 investigadores y 200 bibliotecarios, además de un análisis de más de 300 fuentes. Uno de los datos más significativos es que uno de cada diez investigadores comienza directamente sus búsquedas en herramientas de IA, mientras que otro 25 % utiliza buscadores generales en los que las respuestas generadas por inteligencia artificial están cada vez más integradas. El fenómeno es todavía más intenso entre los investigadores que se encuentran en las primeras etapas de su carrera y entre quienes trabajan en organizaciones empresariales, donde el porcentaje que inicia sus búsquedas directamente mediante IA llega a duplicarse.

El problema no es únicamente que cambien los instrumentos de búsqueda, sino que muchos investigadores no son plenamente conscientes del papel que desempeña la IA en los resultados que reciben. El estudio señala que un 40 % de los investigadores cree que los resúmenes generados por IA que aparecen en los buscadores han sido elaborados o seleccionados por personas; entre los estudiantes esta percepción asciende al 46 %. Esta falta de comprensión tiene consecuencias prácticas: los bibliotecarios están observando que algunos usuarios solicitan artículos que en realidad no existen porque han recibido referencias bibliográficas alucinadas por sistemas de inteligencia artificial. Por tanto, la alfabetización en IA se convierte también en una cuestión de alfabetización informacional y científica: no basta con saber formular preguntas a un chatbot, sino que es necesario comprender cómo se generan las respuestas, de dónde proceden las fuentes y cómo comprobar su existencia y fiabilidad.

Otro aspecto especialmente relevante para las bibliotecas es que esta transformación puede estar modificando las propias formas de acceso y utilización de la literatura científica. Los bibliotecarios participantes en el estudio señalan una posible disminución del uso de las fuentes primarias, ya que los investigadores pueden quedarse con la síntesis o respuesta proporcionada por un sistema de IA sin llegar necesariamente al artículo original. Esto introduce una tensión importante porque las estadísticas tradicionales de uso continúan teniendo un peso considerable en decisiones como la renovación de suscripciones. Si los investigadores encuentran información a través de interfaces de IA y dejan de acceder directamente a los documentos originales, las métricas tradicionales podrían dejar de reflejar adecuadamente el verdadero impacto o valor de una colección científica.

El estudio también plantea una nueva responsabilidad para editores y proveedores de información científica. Los bibliotecarios reclaman mayor transparencia sobre la forma en que los contenidos editoriales son incorporados y representados por los sistemas de IA, así como criterios claros para la utilización de contenidos en el entrenamiento de modelos y en las nuevas formas de consulta mediante agentes de inteligencia artificial. En este escenario, ya no es suficiente con que un artículo esté correctamente indexado en una base de datos o sea recuperable mediante un buscador tradicional: las editoriales tendrán que conseguir que sus contenidos sean legibles, interpretables, atribuibles y correctamente representados por los sistemas de IA.

Una de las principales recomendaciones del informe es precisamente desarrollar contenidos “answer-ready”, es decir, preparados para ser comprendidos y utilizados por sistemas de inteligencia artificial. Esto implica utilizar estructuras claras, lenguaje comprensible, metadatos adecuados y mecanismos que permitan identificar inequívocamente autores, artículos, instituciones, resultados y fuentes. La segunda fase del proyecto se centrará precisamente en establecer buenas prácticas relacionadas con esquemas, metadatos y marcado estructurado, con el objetivo de mejorar la visibilidad de la investigación en los entornos de IA y, sobre todo, garantizar una correcta atribución.

Para las bibliotecas, el informe tiene una implicación especialmente importante: la alfabetización informacional debe evolucionar hacia una alfabetización crítica en inteligencia artificial. Los profesionales no solo tendrán que enseñar a localizar información en bases de datos, catálogos y buscadores, sino también a comprender cómo los sistemas de IA seleccionan, resumen y presentan el conocimiento. Esto incluye aprender a verificar referencias, rastrear una afirmación hasta su fuente original, distinguir entre una respuesta generada y una evidencia científica, reconocer posibles sesgos y comprender que una respuesta aparentemente convincente puede contener información falsa. El propio estudio recomienda desarrollar materiales educativos específicos para bibliotecarios e investigadores y establecer métodos para evaluar la visibilidad de los contenidos científicos en los sistemas de IA.

En definitiva, la IA está pasando de ser una herramienta complementaria para buscar información a convertirse en una nueva capa de intermediación del conocimiento científico. El cambio afecta simultáneamente a investigadores, bibliotecas, editoriales, autores y proveedores de información. La cuestión ya no es únicamente cómo conseguir que un artículo aparezca en Google Scholar, Scopus o Web of Science, sino también cómo conseguir que sea encontrado, interpretado y citado correctamente por los sistemas de inteligencia artificial. El estudio Taming the Crocodile apunta así hacia un nuevo escenario de comunicación científica en el que los metadatos, la trazabilidad, la atribución, la transparencia y la calidad de las fuentes adquieren una importancia todavía mayor.

Oxford University Press reclama una mayor claridad para declarar el uso de inteligencia artificial en la investigación

Oxford University Press (OUP). (2026, 10 de septiembre). Supporting researchers to disclose AI use with confidence. Oxford University Press. https://fdslive.oup.com/www.oup.com/Group_comms/pdf/Disclosing_AI_use_in_academic_research.pdf

Oxford University Press ha actualizado sus directrices para autores y editores sobre el uso responsable, apropiado y transparente de la inteligencia artificial, con el objetivo de ayudar a los investigadores a declarar con mayor seguridad cuándo y cómo han utilizado herramientas de IA durante sus procesos de investigación y publicación.

El informe muestra que la IA ya forma parte habitual del trabajo investigador. El 64 % de los investigadores afirma haberse beneficiado de su utilización, aunque únicamente el 20 % confía en los resultados generados por las herramientas de IA. Existe, por tanto, una actitud bastante pragmática: los investigadores encuentran utilidad en estas tecnologías, pero mantienen una considerable cautela respecto a su fiabilidad. Esta prudencia se refleja en que el 83 % comprueba las fuentes de las citas y el 80 % contrasta los resultados proporcionados por la IA, mientras que solo alrededor del 36 % conserva un registro de cómo ha utilizado estas herramientas durante su investigación.

Uno de los principales problemas identificados es precisamente la falta de claridad sobre qué usos de la IA deben declararse. El 74 % de los investigadores considera que existe una falta general de claridad sobre las situaciones que requieren divulgación, y un 44 % teme que declarar el uso de IA pueda afectar negativamente a la percepción que otros investigadores tengan de su trabajo. El informe señala así una tensión entre el creciente uso cotidiano de estas tecnologías y unas normas de transparencia que todavía están evolucionando. Algunos investigadores reclaman una declaración obligatoria y exhaustiva, mientras que otros prefieren distinguir entre usos aceptables e inaceptables o normalizar la IA como una herramienta más del proceso investigador.

La utilización de IA se concentra especialmente en determinadas fases de la investigación. Los usos más frecuentes son descubrir investigaciones existentes (55 %), resumir literatura científica (46 %) y editar los textos de investigación (45 %). También se emplea para generar ideas, diseñar investigaciones, analizar datos, programar, traducir, corregir textos y preparar solicitudes de financiación. En cuanto a las herramientas, los chatbots de IA disponibles en la web abierta son utilizados por el 68 % de los investigadores que emplean IA, mientras que la traducción automática alcanza aproximadamente al 49 %.

El estudio identifica además una importante infra-declaración del uso de IA en la comunicación científica. El 46 % de los autores de artículos de revista y el 39 % de los autores de libros reconocen que no habían declarado completamente el empleo de IA durante la preparación de sus manuscritos, especialmente cuando se utilizó para redactar textos. La situación también afecta a otros procesos: el 48 % de quienes prepararon solicitudes de financiación no había declarado completamente su utilización de IA, particularmente en redacción narrativa, traducción/edición y elaboración de resúmenes en lenguaje sencillo. Entre los revisores por pares, el 25 % tampoco había declarado completamente su uso, especialmente cuando recurrieron a IA para la edición lingüística.

El informe resulta especialmente interesante porque muestra que los investigadores no constituyen un grupo homogéneo frente a la IA. OUP identifica cinco perfiles: escépticos persistentes, que confían muy poco en la IA; conversos cautelosos, preocupados sobre todo por la falta de claridad de las normas; usuarios despreocupados, que utilizan las herramientas sin prestar demasiada atención a sus implicaciones; entusiastas comprometidos, que confían más en sus resultados y conocen mejor las herramientas disponibles; y pioneros frustrados, que obtienen importantes beneficios de la IA pero encuentran obstáculos relacionados con costes, créditos y carga administrativa.

Otro aspecto relevante es que una parte importante de los investigadores no utiliza IA deliberadamente. Entre quienes no la emplean, el principal motivo son las dudas sobre su exactitud, sesgos y fiabilidad (37 %). También aparecen preocupaciones éticas, morales y sociales (24 %), cuestiones relacionadas con la integridad académica (22 %), falta de utilidad para determinadas áreas de investigación (22 %) y preocupaciones medioambientales (20 %). Un 18 % expresa además temor a que la IA perjudique el pensamiento crítico y la calidad de la investigación.

En conjunto, el estudio plantea que el problema ya no consiste simplemente en si los investigadores utilizan IA, sino en cómo la utilizan, cómo verifican sus resultados y cómo documentan y comunican ese uso. La IA está modificando los procesos de búsqueda, análisis, escritura, traducción y revisión, pero las políticas institucionales y editoriales todavía no ofrecen siempre respuestas suficientemente claras. De hecho, el 45 % considera que la posición de su institución ante la IA es «mixta o poco clara», frente a un 43 % que percibe una actitud al menos parcialmente facilitadora.

Inteligencia Artificial competencias, marcos de referencia y el papel de las bibliotecas en la era de la IA. Planeta biblioteca 2026/09/10


Inteligencia Artificial competencias, marcos de referencia y el papel de las bibliotecas

Planeta Biblioteca 2026/09/10.

ESCUCHAR

Descargar

La alfabetización en inteligencia artificial (IA) se ha consolidado como una competencia esencial del siglo XXI ante el impacto omnipresente de las tecnologías generativas en la sociedad actual. Más allá del mero uso instrumental, se configura como un fenómeno multidimensional que integra pilares técnicos, críticos, éticos y comunicativos indispensables para comprender los algoritmos y evaluar fenómenos como sesgos y alucinaciones. Diversos marcos internacionales, como los desarrollados por la UNESCO, EDUCAUSE y la ACRL, buscan estandarizar el desarrollo de estas competencias en los ámbitos educativo e investigador. En este escenario, las bibliotecas y sus profesionales emergen como agentes estratégicos y espacios de confianza clave para promover la formación ciudadana y garantizar el acceso equitativo y ético a la información. No obstante, la acelerada evolución tecnológica exige capacitar prioritariamente al propio personal bibliotecario para superar la brecha existente entre el uso cotidiano de las herramientas y su conocimiento profundo. Para dar respuesta a este desafío, se propone una estructura de aprendizaje articulada en tres dimensiones fundamentales: conceptual (fundamentos), práctica (experimentación y auditoría de resultados) y crítica (ética e impacto social).

Alfabetización e inteligencia artificial: recuperar la confianza en nuestro futuro

Foro sobre alfabetización e inteligencia artificial; “Recuperar la confianza en nuestro futuro”

Library Journal. “Literacy, AI, and the Shock of Faith in Our Future.” Library Journal, 2026. Artículo original en Library Journal

Se plantea que el verdadero desafío de la IA no es simplemente aprender a utilizar ChatGPT u otras herramientas, sino preservar y reforzar las capacidades que permiten a las personas orientarse en un ecosistema informativo cada vez más complejo. Para las bibliotecas, esto supone una oportunidad para situarse nuevamente en el centro de la educación ciudadana: promover lectura crítica, pensamiento independiente, verificación de información y una alfabetización en IA que permita afrontar el futuro con conocimiento, autonomía y confianza.

Una reflexión sobre la relación entre alfabetización, inteligencia artificial y futuro, partiendo de la idea de que cada gran transformación tecnológica modifica también nuestra manera de acceder al conocimiento, leer, pensar y relacionarnos con la información. La llegada de la IA generativa representa un cambio especialmente profundo porque no solo facilita el acceso a contenidos, sino que puede producir textos, imágenes, respuestas y explicaciones que antes requerían una intervención humana directa. Ante esta transformación, la alfabetización ya no puede limitarse a saber leer y escribir o a manejar herramientas digitales: debe incluir la capacidad de comprender cómo funcionan estas tecnologías, valorar críticamente sus resultados y reconocer sus limitaciones.

Uno de los planteamientos centrales es que la IA no debería conducir al abandono de las capacidades humanas asociadas a la lectura, la reflexión y el pensamiento crítico. El acceso inmediato a respuestas generadas por máquinas puede resultar extraordinariamente útil, pero también puede crear una dependencia que reduzca el esfuerzo necesario para investigar, comparar fuentes, construir argumentos y elaborar conocimiento propio. En este contexto, la alfabetización adquiere una dimensión todavía más importante: enseñar a las personas no solamente a obtener información, sino a preguntarse de dónde procede, qué evidencias la sustentan, qué sesgos puede contener y qué grado de confianza merece.

Desde la perspectiva de las bibliotecas, el debate resulta especialmente significativo. Las bibliotecas han desempeñado históricamente un papel fundamental en la democratización del acceso al conocimiento y en la formación de ciudadanos capaces de utilizar la información de manera autónoma. La expansión de la IA amplía esa responsabilidad: los bibliotecarios deben ayudar a los usuarios a comprender los sistemas generativos, evaluar sus respuestas, detectar información falsa o inventada, contrastar referencias y mantener una relación crítica con los algoritmos. La alfabetización en IA aparece así como una prolongación natural de la alfabetización informacional y mediática.

El texto invita también a superar una visión exclusivamente negativa de la tecnología. La IA puede generar incertidumbre, pérdida de confianza y temor ante el futuro, pero también puede abrir posibilidades extraordinarias para el aprendizaje, la investigación y el acceso al conocimiento. El desafío consiste en evitar tanto el rechazo indiscriminado como una confianza ciega en las máquinas. Para ello es necesario construir una cultura en la que las personas comprendan que la tecnología es una herramienta poderosa, pero que la responsabilidad última sobre la interpretación, las decisiones y el uso del conocimiento continúa siendo humana.

El 75 % de los estudiantes ya utiliza IA en sus trabajos académicos lo que preocupa a los docentes

KPMG Canada. “Majority of students use AI, but educators sound alarm.” KPMG Canada, 4 de septiembre de 2026. KPMG Canada – Majority of students use AI, but educators sound alarm

El 75 % de los estudiantes canadienses utiliza IA generativa en sus trabajos, pero el 59 % de los docentes cree que el sistema educativo no los prepara adecuadamente para este nuevo escenario. Aunque la IA mejora el aprendizaje para muchos estudiantes, el 51 % reconoce un deterioro de sus capacidades de pensamiento crítico. Los docentes reclaman formación explícita en un uso ético y responsable de la IA, especialmente ante problemas de plagio, dependencia y deshonestidad académica

KPMG Canada encuestó a 1.009 personas mayores de 18 años vinculadas a universidades, colegios, centros de formación profesional o educación secundaria, entre el 22 de julio y el 5 de agosto de 2026, utilizando la plataforma Methodify de Sago. En total fueron examinadas 1.864 personas para establecer la muestra

El informe de KPMG Canada pone de manifiesto una brecha cada vez mayor entre la rápida adopción de la inteligencia artificial generativa por parte de los estudiantes y la capacidad de las instituciones educativas para proporcionar orientación, formación y normas claras sobre su utilización. Según la encuesta, el 75 % de los estudiantes canadienses utiliza herramientas de IA generativa para realizar sus trabajos académicos, y casi el 70 % las emplea al menos varias veces por semana. Sin embargo, el 59 % de los docentes considera que el sistema educativo canadiense no está preparando adecuadamente a los estudiantes para un futuro laboral en el que la IA será una herramienta habitual. La situación evidencia que el uso de estas tecnologías se ha extendido mucho más rápidamente que la alfabetización necesaria para utilizarlas de manera crítica, responsable y ética.

Los estudiantes reconocen importantes beneficios de la IA. Más de tres cuartas partes consideran que estas herramientas han mejorado la calidad de sus trabajos y el 81 % afirma que les han ayudado a comprender mejor los contenidos de las asignaturas. Sin embargo, el mismo estudio revela una importante contradicción: el 51 % de los estudiantes afirma que sus capacidades de pensamiento crítico se han deteriorado desde que comenzó a utilizar IA, mientras que el 69 % considera que sus compañeros recurren a ella para evitar pensar críticamente. Esta percepción también preocupa a los docentes: el 89 % cree que, sin una orientación adecuada, los estudiantes pueden desarrollar hábitos perjudiciales para su aprendizaje.

Uno de los principales problemas identificados es la falta de formación específica en uso responsable de la IA. Solo el 53 % de los estudiantes afirma haber recibido algún tipo de formación formal sobre cómo utilizarla responsablemente en sus trabajos académicos y únicamente el 46 % de los educadores considera que sus estudiantes reciben suficiente preparación en este ámbito. Al mismo tiempo, existe una demanda clara de formación: el 79 % de los docentes cree que el uso responsable y ético de la IA debería enseñarse explícitamente, mientras que el 70 % de los estudiantes reclama que las instituciones educativas ofrezcan más cursos sobre IA generativa. El problema, por tanto, no parece ser la resistencia de los estudiantes a aprender sobre estas tecnologías, sino la falta de una respuesta educativa suficientemente estructurada.

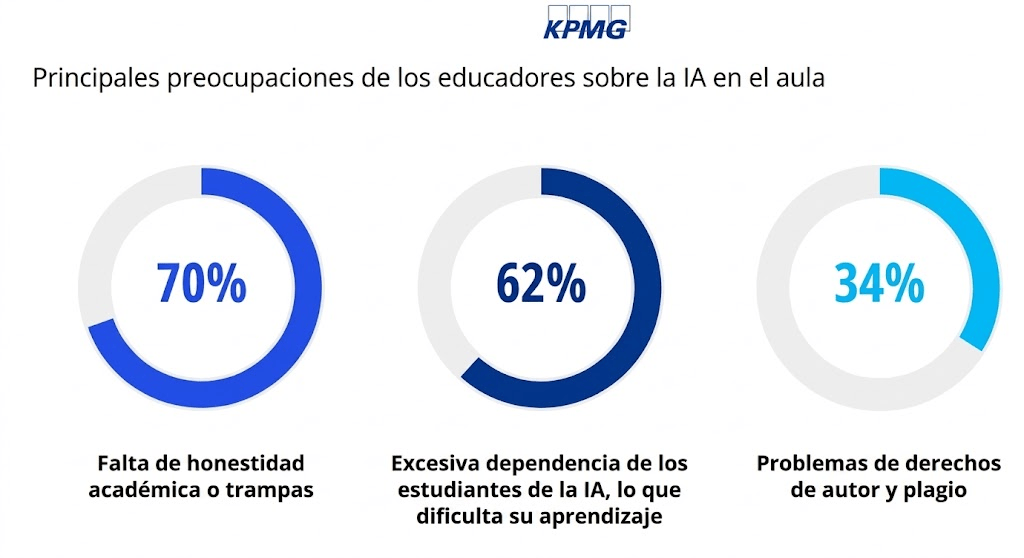
La integridad académica constituye otra de las grandes preocupaciones. Los docentes sitúan entre sus principales problemas el fraude o la trampa académica, la dependencia excesiva de la IA y las cuestiones relacionadas con el copyright y el plagio. Existe además una importante diferencia de percepción entre profesores y estudiantes: el 72 % de los educadores considera que utilizar IA generativa para ayudar a realizar trabajos académicos constituye una forma de trampa, frente al 50 % de los estudiantes. Al mismo tiempo, resulta significativo que el 67 % de los estudiantes manifieste que cuestionaría el resultado de una evaluación si supiera que su profesor había utilizado IA para corregir su trabajo. Es decir, los estudiantes aceptan ampliamente la IA como herramienta para su propio aprendizaje, pero muestran mayores reservas cuando la tecnología interviene en la evaluación de su rendimiento.

El informe plantea, por ello, que la respuesta no debería consistir simplemente en prohibir la IA, sino en transformar las estrategias docentes y de evaluación. KPMG propone avanzar hacia actividades que obliguen a los estudiantes a demostrar comprensión, razonamiento y capacidad de juicio independiente, mediante aprendizaje basado en proyectos, evaluaciones orales, debates y actividades interactivas. El objetivo sería que la IA funcione como una herramienta para potenciar el aprendizaje y no como un sustituto del pensamiento. Esta perspectiva supone pasar de preguntarse si los estudiantes utilizan IA —algo que ya ocurre de manera generalizada— a plantearse cómo diseñar entornos educativos en los que su utilización contribuya realmente al desarrollo de competencias intelectuales.

Otro aspecto especialmente relevante es la desigualdad en el acceso a la inteligencia artificial. Casi una cuarta parte de los estudiantes encuestados paga actualmente por herramientas de IA para sus trabajos académicos, y casi la mitad considera que quienes pueden pagar por estos servicios disfrutan de una ventaja académica frente a quienes utilizan únicamente herramientas gratuitas. La preocupación es todavía mayor entre los docentes: el 84 % teme que las diferencias en el acceso a herramientas y formación en IA puedan generar nuevas desigualdades educativas. De este modo, la IA puede convertirse simultáneamente en una herramienta de democratización del conocimiento y en un nuevo factor de brecha educativa si no existen políticas que garanticen un acceso equitativo

En conjunto, el estudio dibuja una situación que resulta especialmente significativa para el debate sobre alfabetización en inteligencia artificial: los estudiantes ya están utilizando la tecnología antes de que las instituciones hayan establecido plenamente las competencias, normas y criterios necesarios para hacerlo de manera responsable. La cuestión fundamental ya no es enseñar únicamente a utilizar una herramienta o a formular mejores prompts, sino desarrollar la capacidad para evaluar las respuestas de la IA, detectar errores, contrastar fuentes, reconocer sesgos, respetar la propiedad intelectual y decidir cuándo utilizarla y cuándo recurrir al razonamiento propio. El reto para universidades, centros educativos y bibliotecas es, por tanto, integrar la IA dentro de una formación más amplia en pensamiento crítico, alfabetización informacional y ciudadanía digital.

La IA avanza en las bibliotecas, pero a distintas velocidades según el país

Clarivate. “Pulse of the Library 2026 Report Reveals AI Adoption Gaps Across Geographies, Mainland China Advancing Fastest”. Clarivate, 2026. El informe Pulse of the Library 2026 recoge las opiniones de más de 1.800 profesionales de bibliotecas académicas, públicas y nacionales de todo el mundo. https://clarivate.com/news/clarivate-pulse-of-the-library-2026-report-reveals-ai-adoption-gaps-across-geographies-mainland-china-advancing-fastest/

El informe Pulse of the Library 2026 de Clarivate analiza cómo las bibliotecas universitarias, públicas y nacionales están afrontando la rápida expansión de la inteligencia artificial y muestra que el sector se encuentra todavía en una fase relativamente prudente de adopción.

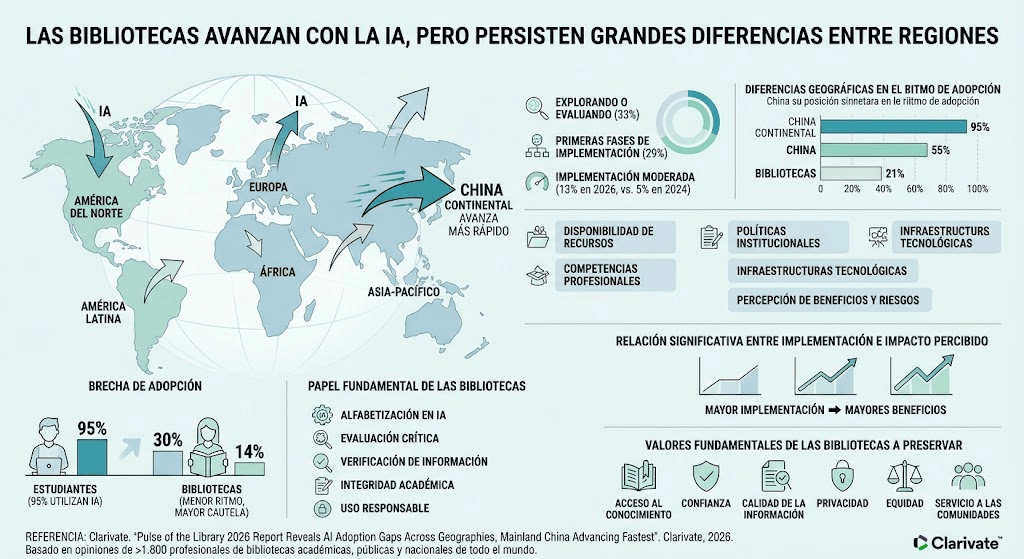
Aunque la IA está cada vez más presente en las estrategias y conversaciones profesionales, la mayoría de las instituciones todavía se encuentran en etapas iniciales: un 33 % está explorando o evaluando tecnologías de IA, mientras que otro 29 % se encuentra en las primeras fases de implementación. No obstante, aumenta progresivamente el número de bibliotecas que han alcanzado niveles de implantación más avanzados: la proporción que declara una implementación moderada ha pasado del 5 % en 2024 al 13 % en 2026.

Uno de los aspectos más interesantes del estudio es la existencia de importantes diferencias geográficas en el ritmo de adopción. El informe señala que China continental está avanzando especialmente rápido en la incorporación de la IA en las bibliotecas, lo que refleja probablemente un contexto tecnológico e institucional particularmente favorable a su desarrollo. Esta desigualdad geográfica pone de manifiesto que no existe un único modelo mundial de transformación digital: las posibilidades de adoptar IA dependen de factores como la disponibilidad de recursos, las políticas institucionales, las competencias profesionales, las infraestructuras tecnológicas y la percepción de los beneficios y riesgos asociados a estas herramientas.

El estudio también encuentra una relación estadísticamente significativa entre el grado de implementación de la IA y el impacto que las bibliotecas perciben de sus iniciativas. En otras palabras, las instituciones que han avanzado más allá de la fase experimental tienden a declarar mayores beneficios en diferentes ámbitos. Esto resulta relevante porque sugiere que la prudencia inicial puede transformarse en resultados concretos cuando la IA deja de considerarse únicamente una tecnología que hay que evaluar y comienza a integrarse de manera sistemática en los procesos y servicios bibliotecarios.

Otro elemento destacado es la brecha entre bibliotecas, instituciones educativas y estudiantes. Mientras las bibliotecas avanzan con cautela, los estudiantes están incorporando la IA a una velocidad mucho mayor: investigaciones relacionadas de Clarivate señalan que el 95 % de los estudiantes utiliza IA para actividades relacionadas con sus cursos. Esta diferencia plantea un desafío importante para las bibliotecas universitarias, que pueden desempeñar un papel fundamental en la formación en alfabetización en IA, evaluación crítica de resultados, verificación de información, integridad académica y uso responsable de estas tecnologías.

Pulse of the Library 2026 presenta una imagen de un sector que está pasando progresivamente de la experimentación a la implementación, pero a velocidades muy diferentes según las regiones. El informe sugiere que el debate ya no debería centrarse exclusivamente en si las bibliotecas deben utilizar IA, sino en cómo incorporarla estratégicamente, con qué objetivos y bajo qué principios de responsabilidad y supervisión profesional. Para las bibliotecas, el reto consiste en aprovechar el potencial de la inteligencia artificial sin perder de vista sus valores fundamentales: acceso al conocimiento, confianza, calidad de la información, privacidad, equidad y servicio a las comunidades.

La IA ayuda a visibilizar colecciones digitales ocultas

Clarivate. “Responsible AI in Digital Collections: Part 1. How AI Helps Reveal Hidden Digital Collections”. Clarivate, 17 de agosto de 2026.

Se plantea un cambio interesante en la concepción de la digitalización bibliotecaria: el objetivo ya no debería limitarse a convertir documentos físicos en archivos digitales y ponerlos en línea, sino conseguir que todo el conocimiento contenido en ellos pueda ser descubierto y relacionado. La IA puede actuar como una herramienta de enriquecimiento de metadatos capaz de sacar a la luz conexiones que permanecían invisibles, mejorar la recuperación de información y facilitar nuevas formas de investigación. El reto para las bibliotecas será desarrollar estos sistemas de manera responsable, manteniendo al bibliotecario y al archivero en el centro del proceso de validación y descripción

Las bibliotecas, archivos e instituciones de patrimonio cultural han realizado durante años importantes inversiones en digitalización de fotografías, manuscritos, periódicos, grabaciones audiovisuales y documentos históricos. Sin embargo, digitalizar una colección no garantiza que sus contenidos sean fácilmente localizables. El artículo señala que una parte importante del conocimiento contenido en estos fondos permanece «oculto» porque no aparece reflejado en los metadatos. Una fotografía puede contener personajes relevantes cuyos nombres no figuran en su descripción, mientras que un manuscrito puede mencionar personas, lugares, organizaciones o acontecimientos que tampoco han sido identificados documentalmente.

En este contexto, la inteligencia artificial puede utilizarse para enriquecer automáticamente los metadatos y mejorar las posibilidades de descubrimiento. Una de las aplicaciones destacadas es la extracción de entidades, mediante la cual los sistemas de IA identifican en los contenidos elementos significativos como personas, lugares y organizaciones. En lugar de obligar al personal bibliotecario o archivístico a revisar manualmente cada documento para localizar estas entidades, la IA genera propuestas que posteriormente son examinadas, corregidas o rechazadas por los profesionales. De este modo, se pretende combinar la capacidad de procesamiento de grandes volúmenes de información de la IA con el conocimiento especializado y el control de calidad de los bibliotecarios y archiveros.

El beneficio más importante, por tanto, no sería únicamente ahorrar tiempo en la catalogación, sino transformar la manera en que los usuarios descubren las colecciones. Un investigador podría encontrar materiales relacionados con una determinada persona, institución o lugar aunque esos elementos no hubieran sido incluidos originalmente en los registros bibliográficos. La extracción y vinculación de entidades permite establecer relaciones entre diferentes documentos y colecciones, ofreciendo un contexto más rico y abriendo nuevas vías de investigación que resultarían difíciles de encontrar mediante una búsqueda tradicional basada exclusivamente en palabras clave.

El artículo insiste además en la importancia de un enfoque de IA responsable y supervisada por profesionales. Las sugerencias generadas automáticamente no deberían incorporarse sin control a los registros: los bibliotecarios y archiveros mantienen la capacidad de aceptar, modificar o rechazar las entidades y metadatos propuestos. Esta supervisión permite aprovechar la automatización sin renunciar a la precisión, la normalización y el criterio profesional. En el caso presentado de la University of Texas at Dallas Libraries, la herramienta de IA detecta personas, objetos y lugares en los archivos digitales y propone su vinculación con entidades de vocabularios controlados, dejando la decisión final en manos de los especialistas en metadatos.

La paradoja de la IA en las aulas: más uso, peores resultados según el informe PISA

Richter, Felix. “PISA Links Frequent AI Use With Lower Science Scores.” Statista, 8 septiembre 2026. Statista, “PISA Links Frequent AI Use With Lower Science Scores”

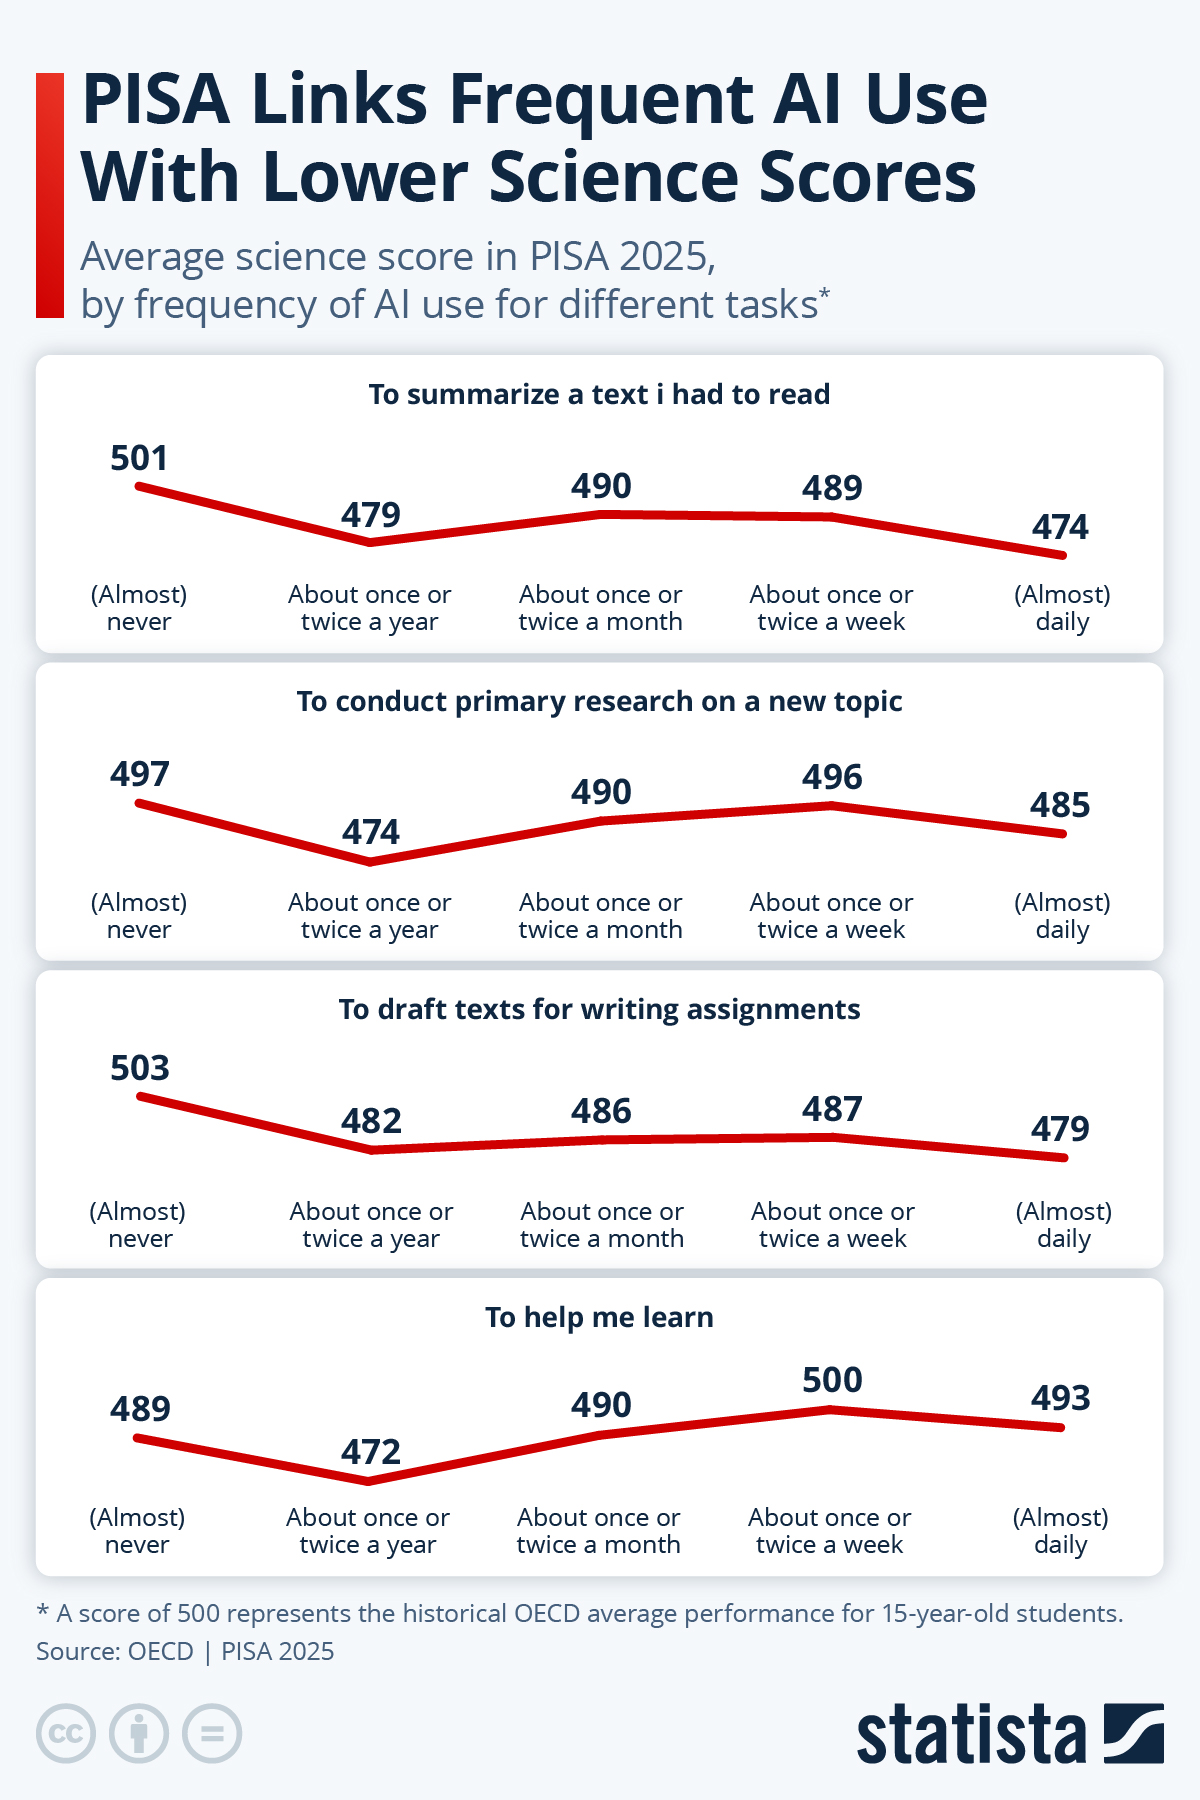
Los resultados de PISA 2025 introducen una importante advertencia sobre la relación entre el uso de la inteligencia artificial y el rendimiento académico. El análisis de Statista, basado en los datos de la OCDE, muestra que los estudiantes de 15 años que utilizan herramientas de IA casi todos los días para realizar tareas escolares concretas, como redactar trabajos, resumir textos o realizar investigaciones preliminares, obtienen en promedio peores resultados en ciencias que aquellos que utilizan la IA con menor frecuencia o que no la utilizan. La diferencia entre los usuarios intensivos y los estudiantes que no emplean IA llega a ser equivalente, según Statista, a aproximadamente un año de escolarización.

Sin embargo, los datos no permiten concluir que la inteligencia artificial sea perjudicial por sí misma. La investigación de PISA muestra una relación mucho más compleja, en la que importan tanto la frecuencia como el propósito del uso. Los estudiantes que utilizan la IA para una finalidad general de aprendizaje presentan un comportamiento diferente al de quienes recurren a ella para que realice directamente determinadas tareas académicas. De hecho, los alumnos que utilizan la IA de manera moderada para «ayudarles a aprender» pueden alcanzar resultados similares o incluso ligeramente superiores a los de quienes no la utilizan.

La diferencia resulta especialmente significativa cuando se analiza el uso de la IA para tareas específicas. Los estudiantes que no utilizan chatbots para determinadas actividades escolares tienden a obtener mejores resultados científicos que quienes los utilizan, mientras que los usuarios moderados pueden situarse por encima de los usuarios muy frecuentes en algunas actividades, como resumir textos o realizar investigaciones preliminares. Esto apunta a que el problema no reside necesariamente en disponer de ChatGPT u otras herramientas similares, sino en delegar en ellas procesos cognitivos que el estudiante debería realizar por sí mismo.

El informe introduce así el concepto de «atrofia de habilidades»: cuando una persona deja de ejercitar regularmente una capacidad porque una herramienta tecnológica la realiza por ella, puede perder progresivamente esa competencia. En educación, esto resulta particularmente importante. Si un estudiante utiliza la IA para generar una respuesta, escribir un trabajo, resumir una lectura o resolver un problema sin comprender el proceso, obtiene una ventaja inmediata, pero puede estar renunciando al aprendizaje que precisamente pretendía conseguir la actividad. La propia OCDE señala que la IA debería complementar el esfuerzo intelectual del alumno y no sustituirlo.

Uno de los aspectos más interesantes de PISA 2025 es que aprender a utilizar críticamente la IA parece marcar una diferencia. Alrededor de seis de cada diez estudiantes de los países de la OCDE señalan que en sus clases se les ha pedido evaluar la calidad de información generada por IA. Entre los estudiantes que utilizan frecuentemente estas herramientas para aprender, quienes además reciben en la escuela formación para valorar críticamente sus resultados presentan un rendimiento científico ligeramente superior. Esto sugiere que la respuesta educativa no debería ser simplemente prohibir o permitir la IA, sino enseñar a interrogarla, verificarla, contrastarla y comprender sus limitaciones.

El estudio también plantea una cuestión de equidad educativa. Las oportunidades para aprender a evaluar críticamente contenidos generados por inteligencia artificial no están distribuidas de manera uniforme: los estudiantes socioeconómicamente favorecidos tienen más probabilidades de recibir este tipo de formación en sus centros. Esto podría generar una nueva brecha digital: no tanto entre quienes tienen acceso a la IA y quienes no lo tienen, sino entre quienes saben utilizarla como herramienta de aprendizaje y quienes simplemente la emplean como sustituto del esfuerzo intelectual.

La cuestión no es cuánta inteligencia artificial utilizan los estudiantes, sino cómo la utilizan. Un uso intensivo y pasivo puede estar asociado a peores resultados, mientras que un uso moderado, consciente y acompañado de alfabetización crítica puede convertirse en una herramienta educativa de gran valor. PISA 2025 apunta, por tanto, hacia un modelo en el que la IA debe utilizarse para ampliar la capacidad del estudiante —ayudarle a comprender, formular preguntas, recibir retroalimentación o explorar conceptos—, pero sin sustituir las actividades cognitivas fundamentales que permiten aprender