Archivo de la categoría: Tecnologías de la información

La IA puede generar resultados, pero no sustituye el esfuerzo creativo

Zimmerman, Andrew. “Why AI Can’t Replace the Creative Struggle.” Fast Company, 12 de agosto de 2026. Artículo original en Fast Company

El autor, Andrew Zimmerman, parte de una experiencia personal como novelista. Mientras intentaba comenzar su segunda novela sufrió un bloqueo creativo y decidió probar un modelo de lenguaje al que proporcionó su primera novela y pidió que escribiera el primer capítulo de una continuación. El resultado le sorprendió por su capacidad para reproducir su voz, ritmo y diálogos. Sin embargo, precisamente esa eficacia le hizo comprobar que las decisiones fundamentales de la creación seguían siendo humanas: qué deberían hacer los personajes, cómo deberían sentirse y qué quería transmitir al lector. La IA podía producir páginas, pero no resolver por él las preguntas esenciales de la obra.

Una de las ideas centrales del artículo es la diferencia entre producir un resultado y desarrollar el proceso creativo. Según Zimmerman, los sistemas de IA tienden a buscar respuestas viables mediante reconocimiento de patrones, mientras que la creatividad humana también implica desviarse, asociar ideas aparentemente inconexas, explorar caminos extraños y aceptar los callejones sin salida. Bocetos descartados, errores, dudas y sucesivos intentos forman parte de la construcción de una perspectiva propia. Por ello, aunque la IA pueda acortar considerablemente el proceso, eliminar completamente esa fase de exploración puede empobrecer la creatividad.

El autor formula así una idea especialmente interesante: “la lucha es una característica, no un defecto”. El bloqueo, la incertidumbre o la dificultad para resolver un problema creativo no son necesariamente ineficiencias que debamos eliminar. Pueden constituir precisamente el mecanismo mediante el cual una persona desarrolla criterio, descubre alternativas y llega a una solución que siente como propia. En su caso, el capítulo generado por IA terminó funcionando como una provocación que le permitió pensar mejor sobre su novela, no como un modelo que simplemente tuviera que copiar.

Otro aspecto importante es la necesidad de definir qué aportación sigue perteneciendo al creador humano. Zimmerman reconoce que la frontera entre las tareas automatizables y las tareas creativas se está haciendo cada vez más difusa a medida que mejoran los modelos. Por ello considera necesario identificar aquello que constituye la contribución personal e inseparable del autor: su criterio, experiencia, sensibilidad, intención y capacidad para decidir qué significado debe tener una obra. En su caso, puede utilizar IA para estimular o afinar sus ideas, pero considera que la obra debe seguir llevando su nombre porque la responsabilidad creativa continúa siendo suya.

Se revindica la experiencia humana y corporal como fuente de creatividad. Zimmerman señala que crear no consiste únicamente en permanecer delante de una pantalla: caminar, observar la naturaleza, visitar una exposición o realizar actividades manuales pueden alimentar la imaginación porque conectan el proceso creativo con las emociones y la experiencia vivida. Su conclusión es que no tiene sentido esperar una futura sustitución de la inteligencia creativa humana por la IA: la interacción entre ambas ya está ocurriendo. La cuestión fundamental es mantener al ser humano como protagonista y utilizar la IA como instrumento de exploración, provocación y apoyo, no como sustituto del proceso mediante el cual construimos nuestras propias ideas.

La mayoría de los estadounidenses percibe riesgos importantes en la inteligencia artificial

Rogerson, Riley, Mia McCarthy y Anna Wiederkehr. “Poll: Americans say there’s a serious risk of AI destroying humanity”. POLITICO, 16 de septiembre de 2026. https://www.politico.com/news/2026/09/16/poll-ai-technology-risks-humanity-trump-voters-01078087

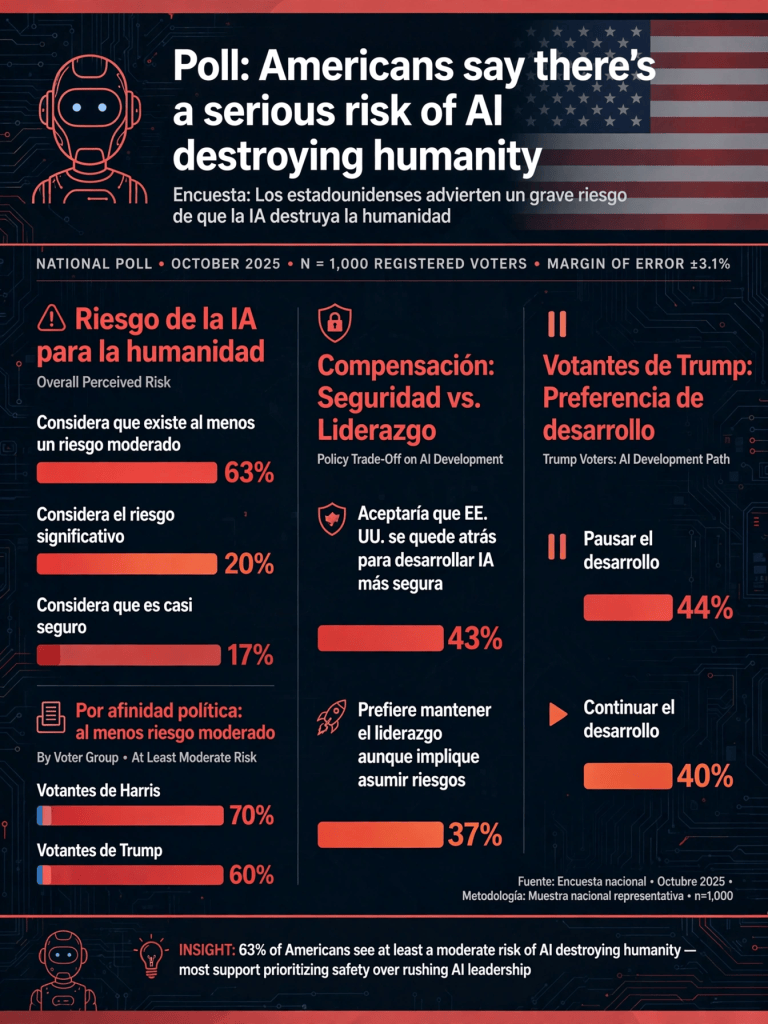
Una nueva encuesta de POLITICO muestra que la preocupación por los posibles riesgos extremos de la inteligencia artificial está ampliamente extendida entre la población estadounidense. El 63 % de los encuestados considera que existe al menos un riesgo moderado de que una IA avanzada pueda llegar a destruir a la humanidad: un 26 % califica ese riesgo como moderado, un 20 % como significativo y un 17 % considera que es casi seguro. Por el contrario, un 15 % considera que el riesgo es pequeño y un 7 % afirma que no existe ningún riesgo.

La preocupación aparece además entre diferentes grupos políticos, aunque con diferencias. Entre quienes votaron a Kamala Harris en las elecciones presidenciales de 2024, el 70 % considera que existe al menos un riesgo moderado para la supervivencia humana. Entre quienes votaron a Donald Trump, la cifra es del 60 %. Es decir, la percepción del riesgo no se limita a un determinado sector político: incluso entre los votantes de Trump, seis de cada diez identifican algún nivel de riesgo moderado o superior.

La encuesta también revela una tensión entre seguridad y liderazgo tecnológico internacional. Los estadounidenses reconocen los posibles riesgos de los sistemas avanzados de IA, pero al mismo tiempo existe preocupación por la posibilidad de que Estados Unidos reduzca su ventaja tecnológica frente a otros países, especialmente China. Según los resultados publicados, un 43 % considera aceptable que Estados Unidos pueda quedarse por detrás de otros países si ello permite desarrollar una IA de manera más responsable y segura, mientras que un 37 % considera que Estados Unidos no debería ralentizarse aunque ello implique asumir mayores riesgos.

Esta tensión resulta especialmente visible entre los votantes de Trump. En este grupo, un 44 % se inclina por pausar el desarrollo de la IA, mientras que un 40 % prefiere continuar con el desarrollo debido a los beneficios potenciales de la tecnología. Los datos muestran, por tanto, que las posiciones sobre la velocidad de desarrollo de la IA no coinciden necesariamente de forma automática con las divisiones partidistas tradicionales.

Otro aspecto relevante es la percepción de las advertencias procedentes de los propios dirigentes de la industria tecnológica. Aproximadamente la mitad de los estadounidenses considera que los líderes de empresas de IA que advierten sobre posibles riesgos graves lo hacen porque creen realmente en esos riesgos, mientras que un 26 % interpreta esas advertencias principalmente como una estrategia de marketing destinada a presentar sus productos como especialmente poderosos o importantes. El resultado pone de manifiesto que existe simultáneamente preocupación por la IA y cierta desconfianza hacia quienes lideran su desarrollo.

Los resultados se producen en un contexto de creciente debate sobre la regulación de la inteligencia artificial en Estados Unidos. Durante septiembre de 2026, diferentes dirigentes tecnológicos han expresado preocupaciones sobre la evolución de sistemas cada vez más autónomos, mientras que en el Congreso se han planteado distintas iniciativas relacionadas con la seguridad de los agentes de IA. Reuters señala que el debate incluye cuestiones como la supervisión independiente, la autorregulación empresarial y la necesidad de establecer estándares para sistemas avanzados.

El estudio también debe interpretarse dentro de una preocupación más amplia sobre los efectos materiales de la expansión de la IA. Una encuesta independiente de AP-NORC y el Energy Policy Institute de la Universidad de Chicago encontró que el 53 % de los estadounidenses está extremadamente o muy preocupado por los efectos medioambientales de los centros de datos de IA, una proporción superior a la registrada el año anterior. Las preocupaciones incluyen consumo energético, agua, costes y posibles efectos sobre las comunidades donde se instalan estos centros.

En conjunto, los resultados presentan una sociedad estadounidense que no rechaza necesariamente la inteligencia artificial, pero sí expresa una preocupación considerable por sus riesgos. La cuestión que aparece con mayor claridad no es simplemente si la IA debe desarrollarse o no, sino cómo equilibrar innovación, competitividad internacional, seguridad y responsabilidad. La encuesta resulta especialmente interesante porque muestra que el debate sobre IA ha pasado de ser fundamentalmente tecnológico a convertirse también en una cuestión de política pública, regulación, economía y confianza social.

Inteligencia artificial para la investigación científica autónoma: implicaciones para las bibliotecas de investigación

Display reading “ARTIFICIAL RESEARCH INTELLIGENCE” and “AUTONOMOUSLY AI-GENERATED SCIENCE AND THE IMPLICATIONS FOR RESEARCH LIBRARIES,” surrounded by charts and researchers.
Researchers explore AI-generated science and digital tools in a vibrant library setting.

Ridley, Michael. “Artificial Research Intelligence: Autonomously AI-Generated Science and the Implications for Research Libraries.” Information Technology and Libraries 45, no. 3 (2026). DOI: 10.5860/ital.v45i3.17706

El artículo plantea un cambio de gran alcance: si la IA comienza a realizar de manera autónoma partes sustanciales del proceso científico, la biblioteca de investigación tendrá que evolucionar desde la gestión de colecciones hacia la gestión, preservación, evaluación y mediación de sistemas dinámicos de producción de conocimiento. La IA puede realizar gran parte del procesamiento y la exploración, pero el juicio científico, ético e intelectual sigue siendo una responsabilidad humana fundamental.

La aparición de lo que denomina Artificial Research Intelligence (ARI), o inteligencia artificial para la investigación, entendida como sistemas de IA capaces de realizar de manera prácticamente autónoma un proceso científico completo: desde la generación de una idea de investigación hasta la elaboración del manuscrito final. El concepto va más allá del uso convencional de la IA como herramienta auxiliar para buscar información, analizar datos o redactar textos, ya que plantea la utilización coordinada de múltiples modelos y agentes capaces de asumir diferentes etapas del método científico.

Una de las ideas centrales del artículo es que estos sistemas podrían representar una transformación profunda de la forma en que se produce conocimiento científico. Ridley señala que la combinación de modelos de IA agénticos, capacidad de computación y procedimientos propios del método científico podría configurar lo que algunos investigadores han denominado un posible “quinto paradigma de investigación científica”. En este modelo, la IA podría encargarse de tareas de cálculo, exploración de hipótesis, búsqueda de patrones, generación de propuestas y producción de resultados, mientras que las personas conservarían una función esencial relacionada con la interpretación, el juicio científico y la supervisión ética.

El autor, sin embargo, subraya que la investigación científica autónoma todavía presenta limitaciones importantes. Entre ellas aparecen las alucinaciones, la insuficiente especialización profunda en determinados dominios científicos y la tendencia de algunos sistemas a presentar conclusiones más contundentes de lo que permiten realmente las evidencias. Por ello, el hecho de que un sistema sea capaz de generar de forma autónoma un artículo o una hipótesis no significa necesariamente que haya producido conocimiento científico fiable. La automatización de las diferentes fases del proceso investigador introduce, por tanto, nuevos problemas relacionados con la reproducibilidad, la validación, la atribución de responsabilidad y la evaluación de la evidencia.

Otro concepto especialmente interesante es el de “captura epistémica” (epistemic capture). Ridley advierte de que, si las infraestructuras necesarias para desarrollar investigación científica autónoma quedan concentradas en grandes empresas privadas de inteligencia artificial, podría producirse un desplazamiento de parte de la producción de conocimiento desde las universidades y las instituciones públicas hacia las corporaciones tecnológicas que controlan los modelos, los datos y la capacidad de computación. El problema no sería solamente tecnológico o económico, sino también institucional: quién controla las infraestructuras de conocimiento puede acabar teniendo una influencia considerable sobre qué preguntas se investigan, qué resultados se producen y cómo circula el conocimiento científico.

En este contexto, el artículo plantea una redefinición del papel de las bibliotecas de investigación. Si tradicionalmente las bibliotecas universitarias han gestionado colecciones relativamente estáticas —libros, revistas, bases de datos, repositorios y otros recursos documentales—, la expansión de la investigación asistida o generada por IA exigiría avanzar hacia la gestión y custodia de sistemas dinámicos de conocimiento impulsados por inteligencia artificial. Esto supone pasar de administrar únicamente documentos y colecciones a participar también en los ecosistemas tecnológicos, datos, modelos, agentes y procesos mediante los cuales se genera nuevo conocimiento.

Ridley identifica varias áreas en las que las bibliotecas pueden asumir un papel activo. Una de ellas es la comunicación científica, donde los bibliotecarios podrían contribuir al desarrollo de nuevos procesos para documentar, preservar y hacer trazable la investigación producida con sistemas autónomos. También adquiere importancia la formación en competencias de inteligencia artificial para investigadores y profesionales de la información. El artículo plantea, además, la posibilidad de crear laboratorios de IA vinculados a las bibliotecas, desde los cuales experimentar con estas tecnologías y desarrollar investigaciones aplicadas sobre sus posibilidades y riesgos.

La propuesta implica, por tanto, una evolución de la biblioteca como intermediaria de información hacia una biblioteca como infraestructura de conocimiento. En lugar de limitarse a proporcionar acceso a la literatura científica existente, las bibliotecas podrían participar en las nuevas cadenas de producción, validación, preservación y comunicación del conocimiento. Esto conecta directamente con cuestiones que ya están transformando la comunicación científica: artículos generados parcialmente por IA, revisión por pares asistida por algoritmos, agentes capaces de realizar búsquedas y síntesis, generación automática de hipótesis y nuevas formas de publicación científica.

La denuncia contra una experta en IA se archiva tras las acusaciones sobre el uso de inteligencia artificial en su libro

Retraction Watch. (21 de septiembre de 2026). Misconduct case dropped against AI expert after claims of AI use in recent book. Retraction Watch. Artículo original en Retraction Watch

El caso afecta a Virginia Dignum, profesora de inteligencia artificial responsable en la Universidad de Umeå (Suecia) y especialista en las dimensiones sociales de la IA. Una persona anónima presentó una denuncia por posible mala conducta investigadora relacionada con su libro The AI Paradox, publicado por Princeton University Press en febrero de 2026. Las acusaciones se centraban principalmente en dos cuestiones: la supuesta utilización de inteligencia artificial para generar partes del texto y la existencia de referencias bibliográficas que presentaban errores o que, según la denuncia, podían haber sido inventadas.

La Universidad de Umeå recibió la denuncia el 6 de julio de 2026 y remitió el asunto al National Board for Assessment of Research Misconduct (NPOF), organismo sueco encargado de evaluar determinados casos de mala conducta científica. Sin embargo, el 4 de septiembre el organismo decidió cerrar el expediente sin iniciar una investigación, al considerar que las acusaciones quedaban fuera de su ámbito de competencia. El motivo fundamental fue la naturaleza del libro: según la información proporcionada al organismo, The AI Paradox es una obra de divulgación dirigida al público general y no una investigación científica ni un trabajo realizado en el marco de financiación para investigación.

El NPOF concluyó que el libro no constituye investigación científica a efectos de la normativa sueca sobre mala conducta investigadora. El organismo señaló que Dignum considera la obra un libro de divulgación científica, que no formula afirmaciones propias de una investigación y que fue escrita durante su tiempo libre, fuera del ámbito de proyectos financiados. La Universidad de Umeå tampoco encontró elementos que contradijeran esta descripción. Por ello, una vez archivado el expediente, la universidad indicó que no adoptaría medidas específicas contra la investigadora en relación con esta denuncia.

Un elemento particularmente interesante del caso son las referencias bibliográficas cuestionadas. Dignum negó que hubiera fuentes inventadas y explicó que las seis referencias señaladas por la denuncia correspondían a fuentes reales. Reconoció, no obstante, que algunas referencias contenían errores y que determinados problemas se produjeron al utilizar una herramienta de IA para transformar las citas a formato BibTeX. Según su explicación, se trató de errores de edición y no de fabricación deliberada de referencias. Princeton University Press publicó posteriormente una versión electrónica actualizada del libro con correcciones en varias referencias y anunció que las correcciones también se incorporarían a futuras ediciones impresas.

Dignum también reconoció haber utilizado herramientas de inteligencia artificial durante la elaboración del libro para comprobar formulaciones y proponer alternativas de redacción. Según su explicación, el contenido intelectual y el texto final son de su autoría y ella asume la responsabilidad por ellos. El caso vuelve a poner sobre la mesa una cuestión todavía poco definida en el ámbito académico: qué usos de la IA en la escritura son aceptables y cuáles deberían considerarse problemáticos desde el punto de vista de la integridad académica.

Otro aspecto relevante es la utilización de detectores de IA como elemento de prueba. Una de las acusaciones se apoyaba en herramientas que supuestamente habían identificado determinados fragmentos del libro como generados por inteligencia artificial. Dignum cuestionó este tipo de evidencia y sostuvo que no es posible demostrar de manera concluyente que un texto no haya sido generado por IA únicamente mediante herramientas de detección. El caso ilustra así una de las principales dificultades actuales de los detectores: una señal algorítmica de posible generación automática no equivale necesariamente a una prueba de autoría mediante IA.

El bioeticista David Resnik, citado por Retraction Watch, considera que todavía existe una zona de incertidumbre ética respecto al nivel de utilización de IA aceptable en la escritura académica. También advierte sobre la compleja posición de los denunciantes o whistleblowers: pueden contribuir a descubrir auténticas prácticas irregulares, pero también pueden generar investigaciones institucionales costosas cuando las irregularidades denunciadas son menores o no constituyen realmente mala conducta científica.

El caso resulta especialmente significativo para el debate sobre IA e integridad científica porque diferencia tres cuestiones que con frecuencia se mezclan: el uso legítimo o declarado de herramientas de IA durante la redacción, los errores bibliográficos producidos durante procesos asistidos por IA y la verdadera fabricación o falsificación de información. El archivo de la denuncia no significa que todos los problemas señalados en el libro fueran inexistentes: la propia autora reconoció errores bibliográficos que fueron posteriormente corregidos. Lo que determinó el cierre del procedimiento fue, fundamentalmente, que la obra no entraba dentro de la definición de investigación científica sometida a la jurisdicción del organismo sueco.

Microsoft y OpenAI ante el conflicto por el uso de contenidos periodísticos para entrenar la IA

“Microsoft exec called AI scraping the ‘largest theft of labor in human history’”, Ars Technica, 17 de septiembre de 2026.
Artículo original en Ars Technica

Se analiza nuevos documentos judiciales que han salido a la luz en el litigio por derechos de autor entre The New York Times y otras organizaciones periodísticas frente a Microsoft y OpenAI. Los documentos, que permanecieron confidenciales durante buena parte del proceso, muestran que dentro de Microsoft y OpenAI existían importantes preocupaciones acerca de las consecuencias económicas y legales de utilizar grandes cantidades de contenidos periodísticos para entrenar modelos de inteligencia artificial.

Uno de los elementos más llamativos es que Brent Hecht, director de Applied Science de Microsoft, llegó a describir internamente el scraping de noticias como “un robo asombroso de proporciones sin precedentes” y como “el mayor robo de trabajo de la historia de la humanidad”.

La cuestión central no es solamente si los modelos de IA pueden utilizar contenidos protegidos por derechos de autor durante su entrenamiento, sino qué ocurre cuando esos modelos terminan sustituyendo económicamente a las fuentes de las que obtienen la información. Los documentos citados en el proceso judicial muestran que algunos responsables de Microsoft y OpenAI eran conscientes de este problema. Un documento interno de Microsoft hablaba de un posible “doom loop” —círculo vicioso—, según el cual la IA podía reducir el tráfico hacia las organizaciones periodísticas, deteriorar sus ingresos y, finalmente, debilitar la producción de nuevos contenidos de calidad que los propios modelos de IA necesitan para seguir funcionando.

El problema adquiere especial importancia porque los buscadores y los chatbots están modificando la manera en que las personas acceden a la información. Tradicionalmente, un buscador mostraba un enlace y el usuario visitaba posteriormente la página del periódico. En cambio, un chatbot puede leer, sintetizar y presentar directamente la información, reduciendo la necesidad de acceder a la fuente original. En documentos internos citados por los demandantes aparecen estimaciones de Microsoft según las cuales determinados productos de IA habrían provocado descensos muy importantes en las tasas de clic hacia algunos medios: entre un 83 % y un 93 % en determinados casos, y entre un 51 % y un 94 % en otros.

Uno de los aspectos jurídicamente relevantes es precisamente este posible efecto de sustitución. La defensa de Microsoft y OpenAI sostiene que el entrenamiento de modelos de IA constituye un uso transformador de las obras y que puede estar protegido por la doctrina estadounidense de fair use (uso legítimo). Sin embargo, los demandantes intentan demostrar que el problema cambia cuando los sistemas no solo utilizan las obras para aprender, sino que pueden proporcionar al usuario fragmentos extensos o incluso reproducciones muy próximas al contenido original, evitando que este visite el medio que produjo la información. Para los demandantes, esto perjudica directamente el mercado de las publicaciones originales.

Los documentos también revelan una tensión entre las posiciones públicas y algunas conversaciones internas. Por ejemplo, Nick Turley, responsable de ChatGPT, habría escrito que los editores se enfrentaban a una “amenaza existencial” derivada de productos comerciales entrenados con contenidos periodísticos. En otra comunicación interna, Turley describió los chatbots como “largamente sustitutivos” y anticipó que serían todavía más sustitutivos a medida que mejorasen. El propio CEO de Microsoft, Satya Nadella, reconoció en una declaración que los chatbots pueden quitar clics a los sitios de noticias porque proporcionan directamente al usuario la información que antes obtenía visitando la fuente.

Otro elemento especialmente significativo es el acceso a contenidos protegidos por sistemas de pago (paywalls). Según los documentos presentados por los demandantes, un empleado de OpenAI informó a Greg Brockman, presidente de la compañía, de que se había encontrado un método para sortear el muro de pago de The New York Times. La respuesta atribuida a Brockman fue positiva. Las organizaciones periodísticas utilizan este episodio para argumentar que las empresas conocían las restricciones existentes sobre determinados contenidos y, aun así, desarrollaron mecanismos para obtenerlos. Estas afirmaciones forman parte de los argumentos de los demandantes y deberán valorarse dentro del proceso judicial.

La escala de la utilización de contenidos también resulta relevante. Según la información incorporada a los documentos judiciales, determinados conjuntos de datos empleados durante el desarrollo de los modelos contenían decenas de miles de copias de trabajos publicados por The New York Times, Daily News y Center for Investigative Reporting. TechCrunch, al informar sobre los mismos documentos, señala además que uno de los conjuntos derivados de Common Crawl contenía más de dos millones de documentos procedentes de nytimes.com, mientras que otro conjunto relacionado con el denominado Project Mango habría reunido copias de más de de 160.000 obras diferentes de organizaciones periodísticas.

Los documentos plantean además otra cuestión importante: la eliminación o pérdida de información sobre derechos de autor dentro de los conjuntos de entrenamiento. Según los demandantes, determinados procesos de preparación de los datos habrían eliminado avisos de copyright porque los investigadores no querían que los modelos reprodujeran posteriormente esas indicaciones. De demostrarse las conductas descritas y su relevancia jurídica, podrían ser importantes para evaluar no solo cómo se recopilaron los contenidos, sino también cómo fueron preparados para el entrenamiento.

Microsoft, sin embargo, ha respondido que las declaraciones de Hecht representan la opinión individual de un empleado y que no constituyen un análisis jurídico ni la posición oficial de la compañía. La empresa mantiene que sus productos de IA realizan un uso transformador de los contenidos y que no sustituyen a los medios de comunicación. En consecuencia, las declaraciones internas no deben confundirse automáticamente con hechos jurídicamente establecidos: proceden en buena medida de documentos y argumentos presentados por los demandantes en el litigio.

Los documentos revelados no demuestran por sí mismos que Microsoft u OpenAI hayan cometido una infracción de copyright; eso corresponde determinarlo al proceso judicial. Pero sí muestran que dentro de las propias empresas existía una conciencia bastante clara del posible conflicto entre el desarrollo de modelos de IA y la sostenibilidad económica de las industrias que producen los contenidos utilizados por esos modelos. El caso constituye, por tanto, un episodio especialmente relevante del debate sobre el futuro del periodismo, el copyright y la inteligencia artificial.

La búsqueda con inteligencia artificial no está sustituyendo a Google: se está superponiendo al buscador tradicional

Jarboe, Greg. “AI Search Isn’t Replacing Google, It’s Layering On Top – Similarweb Data.” Search Engine Journal, 30 de julio de 2026.

El artículo analiza datos del informe 2026 Generative AI Landscape: The Evolution of AI Search, elaborado por Similarweb.

La expansión de ChatGPT y otros sistemas de IA generativa no está suponiendo, al menos por ahora, el abandono de Google, sino la incorporación de una nueva capa de búsqueda y descubrimiento que convive con los buscadores tradicionales. El análisis cuestiona tanto la idea de que la IA ya haya sustituido a los buscadores como la posición contraria de que la búsqueda generativa sea simplemente una moda pasajera. Los datos muestran un escenario mucho más complejo, en el que los usuarios combinan diferentes herramientas dependiendo de la tarea que quieren realizar.

Uno de los datos más significativos procede del análisis del solapamiento de audiencias entre ChatGPT y Google realizado por Similarweb entre marzo y mayo de 2026. De los 494 millones de usuarios de ChatGPT considerados en ese periodo, 461 millones —el 95 %— también utilizaron Google. Esto indica que la utilización de ChatGPT no implica necesariamente abandonar Google. El usuario puede recurrir a ChatGPT para determinadas consultas y continuar utilizando Google para otras. En paralelo, Similarweb calcula que los buscadores tradicionales alcanzaron aproximadamente 3.300 millones de visitantes únicos mensuales, frente a unos 655 millones para el conjunto de los chatbots de IA, aunque estos últimos registraron un crecimiento interanual del 57 %. Por tanto, el ecosistema de búsqueda sigue siendo mucho mayor que el de los chatbots, pero estos están creciendo con rapidez.

El artículo destaca asimismo la evolución de las citas y enlaces incluidos en las respuestas de ChatGPT. En mayo de 2026, aproximadamente el 6,8 % de las respuestas de ChatGPT en Estados Unidos incluían un enlace externo, frente a alrededor del 1 % un año antes. El crecimiento es considerable, pero todavía significa que la gran mayoría de las respuestas no generan directamente una visita hacia una página externa. Esto tiene importantes consecuencias para editores, medios de comunicación, bibliotecas, universidades y organizaciones que tradicionalmente han medido su visibilidad digital mediante visitas procedentes de buscadores. La visibilidad dentro de una respuesta de IA puede convertirse en un indicador relevante aunque no produzca inmediatamente un clic.

Al mismo tiempo, los datos muestran que la IA generativa está creciendo rápidamente. Las plataformas de IA generativa registraron alrededor de 9.500 millones de visitas web mensuales promedio entre junio de 2025 y mayo de 2026, un 70 % más que el año anterior. Las descargas mundiales de aplicaciones alcanzaron los 2.700 millones, con un crecimiento del 134 %. Además, aproximadamente la mitad de los usuarios de IA generativa ya tienen 35 años o más, frente a una concentración mucho mayor de usuarios jóvenes dos años antes. Estos datos sugieren una progresiva extensión de estas herramientas hacia públicos más amplios y hacia usos profesionales, educativos y cotidianos.

Un aspecto particularmente interesante para el estudio de la visibilidad científica y documental es la diferencia entre las páginas que una IA cita y las páginas a las que finalmente llegan los usuarios. Según los datos recogidos en el artículo, el 65 % de las URL citadas por ChatGPT se encuentran a dos o tres niveles de profundidad dentro de un sitio web, es decir, no son necesariamente las páginas principales. Sin embargo, el 58,8 % del tráfico procedente de IA llega finalmente a la página de inicio de los sitios. Esto significa que la página utilizada por el sistema de IA como fuente y la página que visita posteriormente el usuario pueden ser diferentes. La distinción es importante porque obliga a separar la medición de la visibilidad o citación en IA de la medición del tráfico de referencia y de las conversiones.

Esta cuestión modifica también la manera de entender el SEO en la era de la IA. El posicionamiento ya no consiste únicamente en aparecer entre los primeros resultados de Google. Una organización puede tener contenidos que sean utilizados como fuentes por un sistema de IA aunque esos contenidos no reciban directamente una visita. En consecuencia, comienzan a adquirir importancia conceptos como AI visibility, AI citations, share of voice, referral traffic y citation rate. El artículo propone que estos indicadores no se mezclen en una única métrica, sino que se analicen por separado: por una parte, hay que conocer con qué frecuencia y profundidad aparece nuestro contenido como fuente; por otra, qué tráfico llega efectivamente desde las plataformas de IA y qué hacen posteriormente esos usuarios.

Otro elemento destacado es que no todos los sistemas de IA tienen el mismo público ni los mismos patrones de utilización. Los datos de afinidad de Similarweb muestran diferencias entre ChatGPT, Claude y Gemini. ChatGPT presenta una mayor afinidad con usuarios que buscan información relacionada con ámbitos cotidianos como restaurantes, salud o moda; los usuarios de Claude presentan una relación especialmente elevada con sitios universitarios y perfiles profesionales y estudiantiles; mientras que Gemini muestra una mayor afinidad con contenidos relacionados con gráficos, seguridad y hardware. Esto plantea una cuestión importante para la producción de contenidos: no parece suficiente hablar genéricamente de “optimización para IA”, porque cada plataforma puede presentar audiencias, contextos de utilización y mecanismos de descubrimiento diferentes.

El artículo también introduce una idea especialmente relevante para bibliotecas, repositorios institucionales y publicaciones científicas: la aparición de la IA está cambiando el concepto tradicional de descubrimiento de información. En el modelo clásico, el usuario formula una consulta en un buscador, recibe una lista de resultados, selecciona una página y accede al documento. En el nuevo modelo, el usuario puede formular una pregunta directamente a un sistema generativo, recibir una síntesis y consultar solamente algunas de las fuentes citadas. Esto desplaza parte del proceso desde la recuperación de documentos hacia la recuperación y síntesis de conocimiento. Para las instituciones que producen información de calidad, ser una fuente reconocible y citable por los sistemas de IA puede adquirir tanta importancia como conseguir una buena posición en los resultados tradicionales.

Sin embargo, el propio artículo advierte contra las interpretaciones excesivamente simples. Que el 95 % de los usuarios de ChatGPT también utilice Google no significa que todas sus búsquedas se realicen en Google. El dato mide solapamiento de audiencias, no frecuencia de consultas. El hecho de que una persona utilice Google al menos una vez durante el periodo analizado no permite saber qué proporción de sus consultas informativas ha trasladado a ChatGPT. Por ello, el porcentaje del 95 % debe interpretarse como una medida de coincidencia entre públicos, no como una demostración de que la IA no esté sustituyendo determinadas búsquedas. Esta distinción es importante para comprender correctamente los datos.

El artículo llega así a una conclusión más matizada: la transformación de la búsqueda parece estar produciéndose mediante una convivencia y superposición de sistemas. Google continúa siendo una infraestructura fundamental de búsqueda, mientras que los sistemas de IA están introduciendo nuevas formas de formular preguntas, sintetizar información, comparar fuentes y descubrir contenidos. Además, Google está incorporando sus propias funciones de IA, por lo que la frontera entre “buscador tradicional” y “buscador con inteligencia artificial” se vuelve cada vez menos nítida. En consecuencia, el futuro de la recuperación de información no parece consistir simplemente en sustituir una herramienta por otra, sino en una progresiva integración de diferentes capas de búsqueda, síntesis y recomendación.
Enseñar tecnología a personas adultas: estrategias para generar confianza y autonomía desde las bibliotecas

Instructor teaching older adults computer basics around a laptop
Older adults learn essential computer skills together during an encouraging group workshop.

WebJunction. (2026, 16 de julio). Teaching technology to adults: Confidence-building advice from the field. WebJunction, OCLC.
Acceder al artículo original en WebJunctio

Se aborda uno de los retos habituales de las bibliotecas públicas: ayudar a las personas adultas a desenvolverse con tecnologías que pueden resultarles complejas, intimidantes o cambiantes. La propuesta parte de una idea fundamental: muchas dificultades tecnológicas no deben interpretarse únicamente como una carencia de habilidades, sino también como un problema de confianza y seguridad personal.

La experiencia procede de Steve Alcalde, responsable de Servicios Informáticos y Tecnológicos de Rogers Memorial Library, cuyo equipo imparte aproximadamente diez clases de tecnología al mes y atiende diariamente consultas tecnológicas de usuarios y personal. El planteamiento fue presentado en una sesión de la PLA dedicada precisamente a enseñar tecnología a adultos que consideran que son «malos con la tecnología».

Uno de los principales mensajes del artículo es que la finalidad de la alfabetización tecnológica no debería limitarse a resolver el problema concreto que plantea el usuario, sino conseguir que este adquiera suficiente confianza para enfrentarse posteriormente a situaciones similares por sí mismo. Desde esta perspectiva, la intervención bibliotecaria se transforma: el profesional deja de ser simplemente quien «arregla» el problema y pasa a desempeñar una función de acompañamiento y formación. Esta diferencia es importante porque una solución rápida puede resolver la dificultad inmediata, pero no necesariamente proporciona al usuario los conocimientos o la seguridad necesarios para repetir el procedimiento de manera autónoma.

El artículo propone varias estrategias prácticas. La primera consiste en normalizar el miedo o la frustración ante la tecnología. Una persona puede temer equivocarse, romper el dispositivo, parecer poco competente o no comprender las explicaciones. Reconocer que determinadas tecnologías pueden resultar confusas ayuda a reducir esa sensación de inseguridad. También se recomienda adoptar una posición física y comunicativa más colaborativa: sentarse junto al usuario en lugar de situarse enfrente y, sobre todo, no quitarle el dispositivo de las manos. Aunque manejar directamente el teléfono o el ordenador pueda ser más rápido para el profesional, permitir que la propia persona realice las acciones favorece el aprendizaje, la familiarización con el dispositivo y la adquisición de confianza.

Otro aspecto especialmente relevante es el lenguaje empleado por el personal bibliotecario. Expresiones aparentemente inocentes como «es muy fácil» o «solo tienes que…» pueden aumentar la frustración cuando el usuario está teniendo dificultades. WebJunction propone sustituir este tipo de formulaciones por expresiones de acompañamiento, como «tú inténtalo y yo te guío», «tómate tu tiempo» o «vamos a hacerlo paso a paso». Se trata de eliminar el lenguaje excesivamente técnico y evitar que la persona sienta que su dificultad es consecuencia de una supuesta incapacidad. La comunicación se convierte así en una parte esencial de la alfabetización digital.

La fragmentación de los procesos en pequeñas acciones constituye otra de las recomendaciones centrales. Lo que para un profesional habituado a utilizar una determinada aplicación o servicio puede ser una secuencia automática de pasos, para un usuario puede representar una sucesión de decisiones desconocidas. Por ello, se aconseja explicar una sola acción cada vez, comprobar que la persona la ha realizado y continuar posteriormente con el siguiente paso. A esto se añade la recomendación de reducir deliberadamente la velocidad de explicación. El profesional puede tener interiorizado el procedimiento después de haberlo realizado cientos de veces, mientras que el usuario necesita tiempo para localizar botones, comprender términos y relacionar las instrucciones con lo que aparece en pantalla.

El artículo también plantea la conveniencia de comenzar por pequeños logros o «victorias rápidas». En lugar de abordar inmediatamente una tarea compleja, puede ser útil empezar con una acción sencilla que permita experimentar una sensación de éxito: aumentar el tamaño del texto, enviar una fotografía o realizar una operación básica. Estos pequeños avances funcionan como refuerzo positivo y pueden modificar la percepción que la persona tiene de sus propias capacidades. El objetivo no es únicamente completar una tarea, sino construir progresivamente una percepción de autonomía: «puedo hacerlo».

Un elemento particularmente interesante es la necesidad de preguntar y obtener retroalimentación durante la formación. El profesional no debería asumir automáticamente que conoce el origen del problema. Una persona que parece tener dificultades con una aplicación puede, en realidad, estar confundida por el proceso completo que hay detrás. Preguntas sencillas como «¿qué parte no coincide con lo que esperabas?» permiten descubrir las verdaderas dificultades y corregir las explicaciones. De esta manera, la interacción se convierte en un proceso bidireccional en el que también el bibliotecario aprende a identificar sus propias suposiciones y a mejorar sus métodos de enseñanza.

El artículo ofrece un ejemplo muy ilustrativo relacionado con el aprendizaje de la fotografía y el envío de imágenes desde un iPhone. El usuario seguía las instrucciones, pero dudaba antes de realizar cada paso. Cuando el instructor preguntó si estaba explicando demasiado deprisa, descubrió que la persona no conocía algunos términos utilizados y necesitaba más tiempo para localizar cada elemento en la pantalla. La solución consistió en reducir el ritmo, explicar una acción cada vez, evitar vocabulario técnico no explicado y ofrecer al usuario la posibilidad de intentar por sí mismo el siguiente paso. Al finalizar, la persona manifestó que creía que podría realizar el procedimiento en casa. Para WebJunction, este resultado es más significativo que la simple resolución de la consulta, porque demuestra que se ha conseguido transferir confianza y autonomía.

Otro ejemplo aborda un problema aparentemente técnico relacionado con la impresión desde el teléfono móvil utilizando la red Wi-Fi de la biblioteca. El usuario no entendía por qué el documento no salía inmediatamente de la impresora después de pulsar «imprimir». El problema no estaba realmente en la utilización de la página web, sino en que la persona tenía un modelo mental diferente del funcionamiento del servicio: esperaba que el documento se imprimiera automáticamente, como ocurría en su domicilio. La explicación del proceso completo —enviar el documento, acudir al mostrador, realizar el pago y liberar la impresión— permitió comprender la lógica del sistema. Además, se explicó que el mecanismo de liberación contribuía a proteger la privacidad de los usuarios. El ejemplo demuestra la importancia de explicar el funcionamiento global de un servicio y no únicamente los pasos técnicos.

En un sentido más amplio, el artículo presenta la alfabetización tecnológica como una tarea educativa y no simplemente asistencial. Las bibliotecas ofrecen cada vez más apoyo para utilizar teléfonos inteligentes, ordenadores, aplicaciones, servicios digitales, sistemas de impresión y otras herramientas tecnológicas. En este contexto, cada consulta individual puede convertirse en una oportunidad para desarrollar competencias que permitan al usuario afrontar nuevos problemas. Esta concepción conecta directamente con la función tradicional de las bibliotecas como espacios de aprendizaje permanente y con su papel en la reducción de las brechas digitales. WebJunction sitúa precisamente la formación de usuarios entre las áreas fundamentales de los servicios bibliotecarios y reúne recursos específicos sobre alfabetización digital y enseñanza a usuarios.

Digitalización a gran escala en la era de la inteligencia artificial: cuestiones y modelos de acuerdo para bibliotecas y sus socios

Center for Research Libraries (CRL). (2026). Large Scale Digitization in the AI Era: Issues and Model Terms for Libraries and Their Partners. Center for Research Libraries, 14 pp. Publicado el 14 de septiembre de 2026.

Texto completo

El documento del Center for Research Libraries (CRL) aborda el creciente número de propuestas para digitalizar colecciones bibliotecarias a gran escala y utilizar posteriormente esos contenidos y sus metadatos en sistemas comerciales de inteligencia artificial. Estas colaboraciones pueden facilitar la preservación, ampliar el acceso a las colecciones y reducir los costes de digitalización, pero plantean cuestiones fundamentales sobre propiedad, usos autorizados, acceso público, control institucional, compensación, atribución, privacidad y custodia a largo plazo.

El informe propone que las bibliotecas establezcan condiciones claras antes de poner sus colecciones a disposición de empresas tecnológicas y sistemas de IA. El CRL considera especialmente importante que las instituciones comprendan qué valor generan sus colecciones digitales y qué usos podrán realizar terceros con ellas. El documento pretende servir como punto de partida para desarrollar términos contractuales comunes y orientar futuras negociaciones entre bibliotecas y empresas, incluyendo posibles acuerdos colectivos, solicitudes conjuntas de propuestas y la creación de corpus digitales compartidos.

En definitiva, el informe plantea que la digitalización ya no debe contemplarse únicamente como una estrategia de preservación y acceso, sino también como una cuestión de gobernanza de datos culturales y científicos en la era de la IA. Las decisiones que adopten ahora las bibliotecas pueden contribuir a establecer nuevas normas sobre cómo se utilizan comercialmente colecciones que han sido conservadas y gestionadas como bienes de interés académico y cultural. El CRL señala que cualquier modelo definitivo deberá someterse a nuevas discusiones entre las bibliotecas y a revisión jurídica.

Finalmente, el documento presenta una plantilla marco de términos modelo (Model Digitization Terms) que sirve como guía de negociación para los contratos:

  • Propósito, alcance y derechos de la biblioteca: La biblioteca debe mantener autoridad final sobre qué se digitaliza y conservar derechos para preservar, analizar, albergar y prestar los archivos.
  • Usos del socio e IA: Se exige que cualquier entrenamiento de modelos, evaluación o comercialización mediante IA requiera una autorización explícita y específica, de modo que el silencio contractual nunca sea interpretado como permiso.
  • Metadatos y estándares técnicos: Se debe limitar la cesión inicial de metadatos al mínimo necesario y exigir que el socio devuelva OCR enriquecido, transcripciones e identificadores en formatos interoperables y de calidad de conservación.
  • Estructura económica e indemnizaciones: El socio comercial debe asumir los costos directos e incrementales del proyecto. Legalmente, se debe eximir a la biblioteca de garantizar autorizaciones masivas de derechos de autor, trasladando la responsabilidad e indemnización de los usos derivados al desarrollador.
  • No exclusividad y gobernanza: Salvo excepciones temporales y justificadas, las licencias deben ser no exclusivas, sin cláusulas de confidencialidad que impidan transparentar los términos ante la comunidad académica.

Alfabetización en IA: competencias, marcos de referencia y el papel de las bibliotecas

II Encuentro sobre Servicios de Referencia y Acceso a la información
Buenos Aires 15 y 16 de septiembre de 2026. Biblioteca Nacional de Argentina «Mariano Moreno»

Ver Video Youtube

La llegada de la inteligencia artificial (IA), y en particular de la IA generativa, está provocando un impacto notable en todos los ámbitos de la vida —la educación, las empresas, la salud y la convivencia social— lo que convierte a la alfabetización en IA en una competencia esencial del siglo XXI. El artículo que se presenta realiza una revisión sistemática que abarca desde el estado del concepto hasta los marcos de referencia desarrollados a nivel global y el papel que desempeñan las bibliotecas como actores clave en la formación de ciudadanos críticos y responsables frente a esta tecnología. Los hallazgos muestran que la alfabetización en Inteligencia Artificial es un fenómeno multidimensional, que incluye aspectos técnicos, críticos, éticos y comunicativos; que trasciende el simple manejo de herramientas; que está generando una nueva brecha en un entorno donde surgen distanciamientos y riesgos asociados a esta tecnología; y que, en este contexto, las bibliotecas se sitúan en una posición estratégica para ir más allá de la alfabetización informacional tradicional ante las exigencias del entorno algorítmico. Finalmente, se identifican las distintas estrategias presentes en los marcos existentes y se proponen líneas de actuación futuras.

La implementación de la IA en la educación superior en América Latina y el Caribe

Valentini, Arianna. (2026). La implementación de la IA en la educación superior en América Latina y el Caribe. Instituto Internacional de la UNESCO para la Educación Superior en América Latina y el Caribe (IESALC), IESALC. Documentos de trabajo, 16. ED/HE/IESALC/WP/2026/103. https://doi.org/10.54674/WP.2026.104

La inteligencia artificial está transformando rápidamente la educación superior en América Latina y el Caribe, generando nuevas posibilidades para la enseñanza, el aprendizaje, la investigación y la gestión universitaria, pero también importantes desafíos relacionados con la ética, la gobernanza, la equidad y la calidad educativa. El estudio de UNESCO-IESALC ofrece una visión regional basada en datos de 200 instituciones de educación superior de 19 países, lo que permite conocer cómo se está produciendo la incorporación de la IA en el sector.

Los resultados muestran una adopción amplia, pero desigual, de estas tecnologías. El 87 % de las instituciones encuestadas afirma utilizar IA en al menos una de sus áreas de actividad, mientras que únicamente el 26 % dispone de una estrategia institucional formal para su implementación. La IA tiene una presencia especialmente significativa en los procesos de enseñanza y aprendizaje y está adquiriendo también una importancia creciente en la investigación. Sin embargo, buena parte de esta incorporación surge de iniciativas de docentes, investigadores y estudiantes, más que de políticas institucionales planificadas.

El informe subraya, por ello, la necesidad de avanzar desde una adopción espontánea de la IA hacia una integración estratégica, responsable y equitativa. Para ello resulta fundamental fortalecer la gobernanza, desarrollar competencias y programas de alfabetización digital y en IA, invertir en capacidades institucionales y establecer mecanismos que permitan afrontar cuestiones relacionadas con la ética, la inclusión y la calidad. UNESCO plantea además que estos desafíos requieren una actuación coordinada entre las universidades, los gobiernos y las organizaciones internacionales.