Archivo de la categoría: Tecnologías de la información

Recomendaciones éticas para la investigación en inteligencia artificial del Comité Español de Ética de la Investigación (CEEI)

Recomendaciones éticas para la investigación en inteligencia artificial. Comité Español de Ética de la Investigación (CEEI), 2024

Descargar

Este informe, elaborado en colaboración con la Oficina Española de Prospectiva Tecnológica, analiza los desafíos éticos que plantea el desarrollo y la aplicación de la inteligencia artificial (IA). El CEEI ofrece una serie de recomendaciones para garantizar que la investigación en IA se lleve a cabo de forma responsable y ética, teniendo en cuenta los posibles riesgos y beneficios para la sociedad.

RESPONSABILIDAD EN EL DESARROLLO Y EL USO DE SISTEMAS AUTÓNOMOS

Este conjunto de desafíos se centra en la capacidad de los sistemas de IA para tomar decisiones de manera automática, siempre bajo supervisión humana, conforme a las Directrices Éticas para una IA Fiable publicadas por la Comisión Europea en 2018 y las de la UNESCO de 2021. Aspectos específicos relacionados con la investigación en IA incluyen:

  1. Salvaguardar los derechos humanos y fundamentales: Los investigadores y las instituciones deben asegurar que los sistemas de IA respeten la dignidad, la autodeterminación y los derechos humanos y democráticos.
  2. Salvaguardar el medioambiente: Los sistemas de IA deben desarrollarse considerando su consumo energético y su impacto ambiental.
  3. Responsabilidad: Los investigadores deben proporcionar orientación sobre las decisiones y acciones de los sistemas de IA y colaborar con sus instituciones y otras partes interesadas.
  4. Inspeccionabilidad y trazabilidad: Es necesario identificar las fuentes de datos utilizadas por el sistema y la forma en que toma decisiones para garantizar su transparencia y justicia.
  5. Divulgación de la investigación: Los investigadores deben contribuir al debate público sobre los riesgos y oportunidades de la IA y presentar un balance equilibrado entre ambos.

CONSECUENCIAS SOCIALES Y RESPONSABILIDAD SOCIAL DE LA INVESTIGACIÓN

La IA tiene un gran potencial para generar cambios en diversas áreas de aplicación. En la investigación, es esencial:

  1. Reconocer la incertidumbre: Asesorar adecuadamente sobre la incertidumbre asociada con la investigación en IA y fomentar la investigación interdisciplinar.
  2. Asegurar una participación amplia: Comunicar los riesgos y oportunidades de manera transparente e involucrar a aquellos que se ven más afectados por las decisiones.
  3. Protección de datos y consideración a los individuos: Seguir los principios fundamentales de la protección de datos y asegurar el consentimiento adecuado en el uso de datos personales.

DATOS

El uso de datos, especialmente de grandes cantidades, plantea desafíos éticos en la investigación en IA. Es esencial:

  1. Asegurar la calidad de los datos: Cuestionar la calidad y relevancia de los datos, facilitar el acceso a fuentes de datos abiertas y garantizar la verificabilidad.
  2. Acceso justo a los datos: Asegurar que la investigación, los datos utilizados y los resultados obtenidos estén disponibles públicamente, evitando la evasión de los requisitos de transparencia.

Impacto económico de la inteligencia artificial generativa

The Economic Impact of Generative AI Andrew McAfee, April 25th, 2024

Texto completo


Un nuevo informe explora el impacto económico de la inteligencia artificial generativa. Hoy, se publicó un informe de Andrew McAfee, sobre los posibles impactos económicos de la inteligencia artificial generativa. Este informe es el resultado de la investigación original de McAfee sobre IA y la economía, trabajando en estrecha colaboración con expertos de Google para enfocarse en cómo el reciente aumento en la IA generativa puede impactar la productividad, los mercados laborales y las habilidades que los trabajadores necesitan para tener éxito en una economía impulsada por la IA.

La IA generativa es una de las pocas tecnologías lo suficientemente poderosas como para acelerar el crecimiento económico general, lo que los economistas llaman una «tecnología de propósito general». Estas innovaciones tienen el potencial de transformar positivamente las economías y las sociedades.

Según una estimación, cerca del 80% de los trabajos en la economía de EE. UU. podrían ver al menos el 10% de sus tareas realizadas el doble de rápido (sin pérdida de calidad) mediante el uso de IA generativa.

Tecnologías de propósito general anteriores como la máquina de vapor y la electrificación han traído sus cambios a lo largo de décadas. Sin embargo, anticipamos que los efectos de la IA generativa se sentirán más rápidamente debido a su capacidad para difundirse rápidamente a través de Internet y su facilidad de uso debido a su interfaz de lenguaje natural.

Esta tecnología ya está ofreciendo grandes ganancias de productividad, que aumentarán y se difundirán a medida que las personas y organizaciones desarrollen innovaciones complementarias que aprovechen las capacidades de la IA generativa. Como resultado, la productividad general mejorará, lo que acelerará el crecimiento económico.

Además del crecimiento más rápido, la IA generativa traerá otros cambios. Reducirá la demanda de algunas habilidades, aumentará la demanda de otras y creará demanda para habilidades completamente nuevas.

Los temores de un desempleo tecnológico a gran escala probablemente estén exagerados. La historia de las tecnologías de propósito general muestra que el crecimiento que traen va acompañado de una fuerte demanda de trabajo.

Sin embargo, esta demanda aumentada a menudo se encuentra en nuevas ocupaciones. Por ejemplo, más del 85% del crecimiento total del empleo en EE. UU. desde 1940 ha ocurrido en ocupaciones completamente nuevas.

Los cambios rápidos que trae la difusión de la IA generativa requerirán esfuerzos de capacitación rápida y efectiva. Estos esfuerzos podrán aprovechar la IA generativa misma, una herramienta con la capacidad única de ayudar a las personas a aprender cómo usarla mejor. Y debido a que la IA generativa acumula conocimiento y lo pone disponible a pedido, es particularmente efectiva para mejorar el rendimiento de los empleados de nivel de entrada, ayudando con la desigualdad salarial.

Tecnologías de propósito general anteriores han resultado en cambios en las empresas y países líderes en diferentes industrias. Creemos que la IA generativa será igualmente poderosa.

Principios Rectores de las Bibliotecas Universitarias y de Investigación para el uso de la Inteligencia Artificial de ARL

“Research Libraries Guiding Principles for Artificial Intelligence.” Association of Research Libraries, April 2024

Texto completo


La articulación de un conjunto de principios rectores para la inteligencia artificial (IA) en las bibliotecas de investigación es útil para influir en las políticas y abogar por el desarrollo y despliegue responsables de las tecnologías de IA, promover prácticas éticas y transparentes, y construir confianza entre las partes interesadas, tanto dentro de las bibliotecas de investigación como en el entorno de investigación en general.

La Asociación de Bibliotecas de Investigación (ARL, por sus siglas en inglés) ha publicado un conjunto de «Principios Rectores de las Bibliotecas de Investigación para la Inteligencia Artificial». Las tecnologías de inteligencia artificial (IA), y en particular, la IA generativa, tienen un gran potencial para mejorar el acceso a la información y promover la apertura en los resultados de investigación. Sin embargo, la IA también tiene el potencial de perturbar los paisajes de información y las comunidades que las bibliotecas de investigación apoyan y sirven. La creciente disponibilidad de modelos de IA plantea muchas posibilidades y también suscita varios consideraciones éticas, profesionales y legales.

Articular un conjunto de principios rectores para la IA en las bibliotecas de investigación es útil para influir en las políticas y abogar por el desarrollo y despliegue responsables de las tecnologías de IA, promover prácticas éticas y transparentes, y construir confianza entre las partes interesadas, tanto dentro de las bibliotecas de investigación como en el entorno de investigación en general. Estos principios servirán como un marco fundamental para el uso ético y transparente de la IA, y reflejan los valores que sostienen las bibliotecas de investigación. La ARL se apoyará en estos principios en nuestra defensa política y compromiso.

Desarrollados a través del Comité de Académicos y Academia de la ARL y el Comité de Defensa y Política Pública de la ARL, estos principios han sido creados y refinados después de múltiples reuniones del comité, una sesión de oficina abierta para todos los miembros y un período de comentarios abierto. Durante el período de comentarios abierto solo, recibimos más de 60 comentarios que han sido tenidos en cuenta en el desarrollo de estos principios.

Los principios incluyen:

  1. Las bibliotecas democratizan el acceso a herramientas y tecnología de inteligencia artificial para fomentar la alfabetización digital entre todas las personas.
  2. Las bibliotecas se comprometen a comprender dónde están presentes las distorsiones y sesgos en los modelos y aplicaciones de IA.
  3. Las bibliotecas abogan por la transparencia e integridad de la información.
  4. Las bibliotecas creen en la importancia de la participación humana en los procesos de toma de decisiones críticas relacionadas con la IA.
  5. Las bibliotecas priorizan la seguridad y privacidad de los usuarios en el uso de herramientas y tecnología de IA.
  6. Las bibliotecas consideran que la ley de derechos de autor en Estados Unidos y Canadá es lo suficientemente flexible y robusta como para responder a muchos problemas de derechos de autor que surgen de la intersección de la tecnología y la inteligencia artificial.
  7. Las bibliotecas negocian para preservar el uso académico de la información digital.

La integración de la inteligencia artificial (IA) en el ámbito educativo

Monitor Global de Educación. Ipsos. Sept. 2023

Texto completo

La integración de la inteligencia artificial (IA) en el ámbito educativo está marcando un cambio significativo en los métodos de enseñanza a nivel mundial. De acuerdo con el último Monitor Global de Educación de Ipsos, publicado recientemente, se evidencia una percepción variada sobre la importancia de capacitar a los docentes en el uso de la IA en la enseñanza, según el país.

Los datos revelan que el 65% de los encuestados en 29 países consideran que los maestros deberían recibir formación en cómo emplear la IA en sus estrategias educativas. Este porcentaje varía considerablemente de un lugar a otro. En el caso de Perú, un impresionante 84% de los encuestados considera esencial que los maestros se capaciten en el uso de la IA en sus métodos de enseñanza. Le sigue Sudáfrica de cerca, con un sólido 80%, mientras que México y Chile registran cifras de un 79% y un 78%, respectivamente. Argentina también se destaca, con un 72% de los encuestados valorando la capacitación de los maestros en este ámbito.

Sin embargo, existen diferencias significativas en otras regiones. En España, por ejemplo, el 62% de los encuestados considera esencial esta formación, seguido por India con un 59%. El Reino Unido y Japón muestran un 53% y un 51%, respectivamente, mientras que Estados Unidos y Francia presentan cifras menores, con un 48% y un 43%. Estos resultados reflejan un reconocimiento global de la importancia de formar a los educadores en el uso de la inteligencia artificial en la educación, aunque con matices regionales significativos.

Manifiesto por un marketing responsable en la era de la inteligencia artificial

«A Manifesto For Responsible Marketing In The Age Of AI And Automation | Martech Zone», 24 de abril de 2024. https://martech.zone/responsible-marketing-manifesto/.


En la actualidad, el marketing está cada vez más impulsado por la inteligencia artificial (IA) y la automatización, lo que plantea la necesidad de establecer prácticas responsables en esta área. Aunque existen herramientas para protegerse contra las comunicaciones autónomas y personalizadas, los comerciales irresponsables pueden causar un daño significativo con una inversión mínima, inundando a los clientes potenciales y actuales con mensajes no deseados.

Es fundamental que como profesionales del marketing, acordemos cerrar la brecha entre los clientes potenciales y actuales que desean que las marcas aborden sus necesidades y las empresas que pueden aprovechar y desplegar tecnologías que pueden explotar la tecnología para impulsar ventas cuestionables.

A medida que avanza la tecnología, debemos asegurar que nuestros esfuerzos de marketing prioricen el bienestar e intereses de los consumidores, manteniendo estándares éticos. Este manifiesto esboza los principios fundamentales que deben guiar el marketing responsable en un mundo moldeado por la IA y la automatización.

Transparencia y consentimiento informado: Los profesionales deben ser transparentes sobre sus prácticas de recopilación de datos y obtener el consentimiento informado de los consumidores. Esto incluye comunicar qué datos se están recopilando, cómo se utilizarán y con quién se compartirán. Los consumidores deben tener derecho a optar por no participar en la recopilación de datos y la capacidad de acceder y gestionar su información personal fácilmente.

Privacidad y seguridad de datos: Proteger los datos del consumidor debe ser una prioridad. Se deben implementar sólidas medidas de privacidad y seguridad de datos para salvaguardar la información personal contra accesos no autorizados, violaciones y mal uso. Los profesionales de la publicidad deben adherirse a las mejores prácticas de la industria y cumplir con las regulaciones de protección de datos relevantes, como el Reglamento General de Protección de Datos (GDPR) y la Ley de Privacidad del Consumidor de California (CCPA).

IA y automatización éticas: Asegurar que las tecnologías se desarrollen y desplieguen éticamente es fundamental cuando se utilizan IA y automatización en marketing. Los publicitarios deben ser vigilantes para evitar que los sistemas de IA perpetúen prejuicios, discriminación o manipulación. Los algoritmos de IA deben ser auditados regularmente en busca de imparcialidad y transparencia, y los mercadólogos deben ser responsables de cualquier consecuencia no intencionada resultante de la IA y la automatización.

Respeto a la autonomía del consumidor: Los publicistas deben respetar la autonomía de los consumidores y su derecho a tomar decisiones informadas. La IA y la automatización deben utilizarse para empoderar a los consumidores, no para manipularlos o engañarlos. Los mercadólogos deben evitar el uso de patrones oscuros, costos ocultos u otras tácticas engañosas que socaven la elección y el control del consumidor.

Personalización responsable: Si bien la personalización puede mejorar la experiencia del consumidor, debe hacerse de manera responsable. Los profesionales del marketing deben encontrar un equilibrio entre proporcionar contenido relevante y respetar la privacidad del consumidor. La personalización debe basarse en el consentimiento explícito y no debe usarse para explotar a individuos vulnerables o información personal sensible.

Responsabilidad y supervisión ética: Los publicistas deben ser responsables de sus acciones y del impacto de sus prácticas de marketing en los consumidores y la sociedad en general. Las asociaciones de la industria y los organismos reguladores deben establecer pautas éticas y mecanismos de supervisión para garantizar el cumplimiento de los principios de marketing responsable. Los mercadólogos también deben fomentar una cultura de toma de decisiones éticas dentro de sus organizaciones y proporcionar capacitación sobre prácticas de marketing responsables.

Responsabilidad social: El marketing responsable se extiende más allá de la protección del consumidor y abarca la responsabilidad social, el abastecimiento ético y la sostenibilidad. Los promotores de marca deben utilizar su influencia para promover un cambio social positivo, apoyar a sus comunidades y abordar desafíos globales. Esto incluye alinear las estrategias de marketing con organizaciones que comparten objetivos comunes y abogar por prácticas de consumo y producción responsables.

En conclusión, los profesionales del marketing, tienen el deber de mantener los principios del marketing responsable en la era de la IA y la automatización. Al priorizar la transparencia, la privacidad de los datos, la IA ética, la autonomía del consumidor, la personalización responsable, la responsabilidad y la responsabilidad social, asi es posible construir la confianza del consumidor y contribuir a un futuro más sostenible y equitativo. Esta responsabilidad colectiva es asegurar que el poder de la tecnología se aproveche en beneficio tanto de los consumidores como de la sociedad en su conjunto.

Llama 3 de Meta se ha entrenado con una cantidad récord de datos, lo que podría dar lugar a un replanteamiento de toda la industria de la IA y producir mejores modelos.

Schreiner, Maximilian. «Current LLMs “Undertrained by a Factor of Maybe 100-1000X or More” Says OpenAI Co-Founder». THE DECODER, 24 de abril de 2024. https://the-decoder.com/current-llms-undertrained-by-a-factor-of-maybe-100-1000x-or-more-says-openai-co-founder/.

El reciente lanzamiento del modelo de lenguaje Llama 3 por parte de Meta ha desencadenado una reflexión sobre el estado actual de los modelos de inteligencia artificial (IA). Este nuevo modelo, entrenado con una cantidad récord de datos, ha superado significativamente las capacidades de otros modelos en algunas áreas clave.

Según Meta, el aumento en el rendimiento se debe principalmente al considerable aumento en los datos de entrenamiento y al ajuste fino con 10 millones de ejemplos de alta calidad.

Mientras que ya se sabía que los datos de alta calidad pueden mejorar el rendimiento incluso de modelos de lenguaje más pequeños, la cantidad de datos utilizados para el preentrenamiento es sorprendente. Incluso el modelo de 8 mil millones de parámetros fue entrenado con alrededor de 15 billones de tokens. Esto no solo supera con creces la cantidad de datos utilizados para Llama 2, sino también la cantidad de datos considerada óptima según las leyes de escala de Chinchilla, desarrolladas por DeepMind.

Estas leyes establecen que, para un modelo de 8 mil millones de parámetros, alrededor de 200 mil millones de tokens de entrenamiento se consideran óptimos para utilizar eficientemente la potencia informática. Llama 3 fue entrenado con 75 veces esa cantidad de datos. A pesar de la enorme cantidad de datos de entrenamiento, Meta descubrió que los modelos de «8B y 70B de parámetros continuaron mejorando de manera logarítmica después de entrenarlos con hasta 15T de tokens», según una publicación en el blog de la compañía.

El investigador de IA Andrej Karpathy, miembro fundador de OpenAI y ex jefe de IA de Tesla, señala que esto podría sugerir que la mayoría de los modelos de lenguaje actualmente en uso «están significativamente subentrenados por un factor de tal vez 100-1000 veces o más, muy lejos de su punto de convergencia». Karpathy espera que otras empresas de IA sigan el ejemplo de Meta y lancen modelos más largos y entrenados, pero de menor tamaño.

Aunque aún no está claro hasta dónde se puede aumentar el rendimiento de un modelo de lenguaje a través de entrenamientos más largos antes de que las ganancias sean demasiado pequeñas, Meta ha demostrado que aún no se han alcanzado los límites de lo posible en este campo.

Un hackathon de alfabetización en IA de las bibliotecas amplía los recursos educativos abiertos

Carnegie Mellon University Libraries. (2024, April). AI literacy hackathon. Recuperado de https://www.library.cmu.edu/about/news/2024-04/ai-literacy-hackathon

El miércoles 3 de abril, especialistas de diversas instituciones visitaron las Bibliotecas para participar en un Hackatón de Recursos de Alfabetización en Inteligencia Artificial. El objetivo del evento fue reunir a bibliotecarios universitarios, personal y otros interesados para desarrollar materiales educativos abiertos sobre los principios emergentes de la alfabetización en inteligencia artificial.

Un hackatón es un evento colaborativo en el que personas con diversos conocimientos y habilidades se reúnen para trabajar intensivamente en proyectos de forma conjunta y creativa durante un período de tiempo determinado, por lo general de uno o varios días. Durante un hackatón, los participantes suelen formar equipos y trabajar en el desarrollo de software, aplicaciones, prototipos, soluciones tecnológicas o proyectos relacionados con la innovación, la tecnología o cualquier otro tema específico.

En esta ocasión hackatón contó con 36 participantes de 17 instituciones diferentes, incluidas la Universidad Estatal de Ohio, la Universidad de Virginia Occidental, la Universidad de Princeton y la Universidad de Binghamton. Los participantes eran principalmente bibliotecarios universitarios, aunque también participaron diseñadores instruccionales y otro personal de apoyo académico.

El evento proporcionó una forma divertida de crear un sentido de comunidad en torno a la alfabetización en inteligencia artificial. Estuvo impulsado por las voces de los participantes y se centró específicamente en su experiencia.

Después de una serie de segmentos de lluvia de ideas, los participantes fueron divididos en ocho equipos para crear materiales educativos sobre un tema designado. No hubo límite en el tipo de materiales creados, que iban desde ejercicios de ingeniería de indicaciones hasta infografías sobre sesgos en modelos y conjuntos de datos de inteligencia artificial. Los equipos tenían la libertad de determinar el público objetivo para estos materiales, creando recursos para estudiantes universitarios y de posgrado, así como para el público en general.

Todos los recursos creados en el evento están licenciados abiertamente para que otros los reutilicen y modifiquen. Una colección completa de los materiales creados se puede encontrar en el sitio del proyecto Open Science Framework del Hackatón.

AI y la ciencia: lo que piensan 1.600 investigadores

Van Noorden, Richard, y Jeffrey M. Perkel. «AI and Science: What 1,600 Researchers Think». Nature 621, n.o 7980 (27 de septiembre de 2023): 672-75. https://doi.org/10.1038/d41586-023-02980-0.

Las herramientas de inteligencia artificial (IA) están cada vez más presentes en la ciencia, y muchos científicos anticipan que pronto serán centrales en la práctica de la investigación, según una encuesta de Nature a más de 1.600 investigadores de todo el mundo.

Cuando se les preguntó qué tan útiles creían que se volverían las herramientas de IA para sus campos en la próxima década, más de la mitad esperaba que las herramientas fueran «muy importantes» o «esenciales». Sin embargo, los científicos también expresaron fuertes preocupaciones sobre cómo la IA está transformando la forma en que se realiza la investigación.

El porcentaje de documentos de investigación que mencionan términos de IA ha aumentado en todas las áreas en la última década, según un análisis para este artículo realizado por Nature.

Las técnicas estadísticas de aprendizaje automático están ahora bien establecidas, y los últimos años han visto avances rápidos en la IA generativa, incluidos los modelos de lenguaje grandes (LLMs), que pueden producir salidas fluidas como texto, imágenes y código basado en los patrones en sus datos de entrenamiento. Los científicos han estado utilizando estos modelos para ayudar a resumir y escribir documentos de investigación, generar ideas y escribir código, y algunos han estado probando la IA generativa para ayudar a producir nuevas estructuras de proteínas, mejorar los pronósticos meteorológicos y sugerir diagnósticos médicos, entre muchas otras ideas.

Al centrarse primero en el aprendizaje automático, los investigadores destacaron muchas formas en que las herramientas de IA los ayudan en su trabajo. De una lista de posibles ventajas, dos tercios señalaron que la IA proporciona formas más rápidas de procesar datos, el 58% dijo que acelera cálculos que antes no eran factibles, y el 55% mencionó que ahorra tiempo y dinero a los científicos.

«La IA me ha permitido progresar en responder preguntas biológicas donde el progreso era previamente inviable», dijo Irene Kaplow, bióloga computacional en la Universidad Duke en Durham, Carolina del Norte.

Los resultados de la encuesta también revelaron preocupaciones generalizadas sobre los impactos de la IA en la ciencia. De una lista de posibles impactos negativos, el 69% de los investigadores dijo que las herramientas de IA pueden llevar a una mayor dependencia del reconocimiento de patrones sin comprensión, el 58% dijo que los resultados pueden afianzar el sesgo o la discriminación en los datos, el 55% pensó que las herramientas podrían facilitar el fraude y el 53% señaló que el uso mal considerado puede llevar a investigaciones irreproducibles.

«El principal problema es que la IA desafía nuestros estándares existentes de prueba y verdad», dijo Jeffrey Chuang, quien estudia análisis de imágenes de cáncer en el Laboratorio Jackson en Farmington, Connecticut.

Usos esenciales Para evaluar las opiniones de los investigadores activos, Nature envió por correo electrónico a más de 40,000 científicos que habían publicado documentos en los últimos 4 meses de 2022, además de invitar a los lectores del Nature Briefing a participar en la encuesta. Dado que los investigadores interesados en la IA eran mucho más propensos a responder a la invitación, los resultados no son representativos de todos los científicos. Sin embargo, los encuestados se dividieron en 3 grupos: el 48% que desarrollaba o estudiaba directamente la IA, el 30% que había usado IA para su investigación y el 22% restante que no usaba IA en su ciencia.

Entre los que usaban IA en su investigación, más de una cuarta parte sintió que las herramientas de IA se volverían «esenciales» para su campo en la próxima década, en comparación con el 4% que pensaba que las herramientas eran esenciales ahora, y otro 47% pensó que la IA sería «muy útil». A los investigadores cuyo campo de investigación ya era la IA no se les hizo esta pregunta. Los investigadores que no usan IA eran, como era de esperar, menos entusiastas. Aun así, el 9% sintió que estas técnicas se volverían «esenciales» en la próxima década, y otro 34% dijo que serían «muy útiles».

Grandes modelos de lenguaje El chatbot ChatGPT y sus primos LLM fueron las herramientas que los investigadores mencionaron más a menudo cuando se les pidió que escribieran el ejemplo más impresionante o útil de herramientas de IA en la ciencia

Cuando se les pidió que seleccionaran de una lista de posibles impactos negativos de la IA generativa, el 68% de los investigadores se preocuparon por la proliferación de desinformación, otro 68% pensaron que facilitaría el plagio y dificultaría su detección, y el 66% estaban preocupados por la introducción de errores o inexactitudes en los documentos de investigación.

Los encuestados agregaron que estaban preocupados por estudios falsificados, información falsa y la perpetuación de sesgos si las herramientas de IA para diagnósticos médicos se entrenaran con datos históricamente sesgados.

«Claramente hay un mal uso de los grandes modelos de lenguaje, inexactitud y resultados huecos pero con un tono profesional que carecen de creatividad», dijo Isabella Degen, ingeniera de software y exemprendedora que ahora está estudiando para un doctorado en el uso de IA en medicina en la Universidad de Bristol, Reino Unido. «En mi opinión, no entendemos bien dónde está la línea entre el buen uso y el mal uso».

El beneficio más claro, pensaron los investigadores, era que los LLMs ayudaban a los investigadores cuyo primer idioma no es el inglés, al ayudar a mejorar la gramática y el estilo de sus documentos de investigación, o para resumir o traducir otro trabajo. «A pesar de un pequeño número de actores malintencionados, la comunidad académica puede demostrar cómo utilizar estas herramientas para el bien», dijo Kedar Hippalgaonkar, científico de materiales en la Universidad Tecnológica de Nanyang en Singapur.

Los investigadores que usan regularmente LLMs en el trabajo todavía son una minoría, incluso entre el grupo interesado que respondió a la encuesta de Nature. Un 28% de los que estudiaron IA dijeron que usaban productos de IA generativa como LLMs todos los días o más de una vez a la semana, un 13% de los que solo usan IA lo dijeron, y solo un 1% entre otros, aunque muchos al menos habían probado las herramientas.

Además, el uso más popular entre todos los grupos fue para la diversión creativa no relacionada con la investigación (un encuestado usó ChatGPT para sugerir recetas); una proporción menor usó las herramientas para escribir código, idear ideas de investigación y ayudar a escribir documentos de investigación.

Algunos científicos no quedaron impresionados por los resultados de los LLMs. «Siento que ChatGPT ha copiado todos los malos hábitos de escritura de los humanos: usando muchas palabras para decir muy poco», escribió un investigador que usa el LLM para ayudar a editar copias de documentos. Aunque algunos estaban emocionados por el potencial de los LLMs para resumir datos en narrativas, otros tuvieron una reacción negativa. «Si usamos IA para leer y escribir artículos, la ciencia pronto pasará de ser ‘para humanos por humanos’ a ‘para máquinas por máquinas'», escribió Johannes Niskanen, un físico de la Universidad de Turku en Finlandia.


La IA generativa frente a la publicación académica

«Hanging in the balance: Generative AI versus scholarly publishing». Accedido 24 de abril de 2024. https://spie.org/news/photonics-focus/janfeb-2024/hanging-in-the-balance#_=

Desde la invención de la imprenta por Gutenberg en 1454, el sector editorial ha enfrentado desafíos relacionados con la alfabetización, el plagio, la censura de la información y el acceso a la misma. El lanzamiento de ChatGPT-3 en noviembre de 2022 marcó un hito, ya que este modelo de lenguaje generativo ha revolucionado la capacidad de generación de ideas, lo que ha generado tanto entusiasmo como preocupación en la comunidad académica.

Uno de los aspectos más destacados del debate es la creatividad de los modelos de lenguaje generativo, que pueden generar textos e imágenes. Aunque su capacidad para inventar referencias puede ser un problema, estos modelos son útiles para la generación de nuevas ideas y para identificar lagunas en la investigación existente. Sin embargo, surge la pregunta sobre la atribución de autoría, ya que los modelos generativos no pueden ser considerados como autores de estudios científicos, según el Consejo de Ética en Publicación (COPE).

En cuanto a la revisión por pares, la falta de revisores cualificados y la sobrecarga de trabajo en los editores han llevado a considerar el uso de AI para agilizar el proceso. Aunque existen preocupaciones sobre la confidencialidad y el sesgo en los resultados generados por los modelos de lenguaje generativo, estos también pueden ser herramientas útiles para la revisión de literatura y la identificación de trabajos relevantes en un área de investigación.

Otro aspecto a considerar es el fraude en la publicación académica, que ha aumentado con la capacidad de los modelos de lenguaje generativo para producir textos con una calidad gramatical aparentemente perfecta. Sin embargo, la responsabilidad sigue recayendo en los autores humanos, quienes deben garantizar la integridad ética de sus investigaciones.

A pesar de estos desafíos, los modelos de lenguaje generativo también ofrecen oportunidades para hacer que la publicación académica sea más accesible para personas cuyo idioma nativo no es el inglés. Estas herramientas pueden ayudar a superar barreras lingüísticas y permitir que los investigadores se centren en la ciencia en lugar de en la perfección gramatical en sus manuscritos.

En última instancia, el debate sobre el papel de la AI generativa en la publicación académica aún está en curso. A medida que la tecnología avanza, es crucial abordar sus desafíos éticos y técnicos para garantizar que beneficie a la comunidad académica en su conjunto.

CANGURU: directrices éticas y de divulgación para el uso de inteligencia artificial generativa en la investigación académica

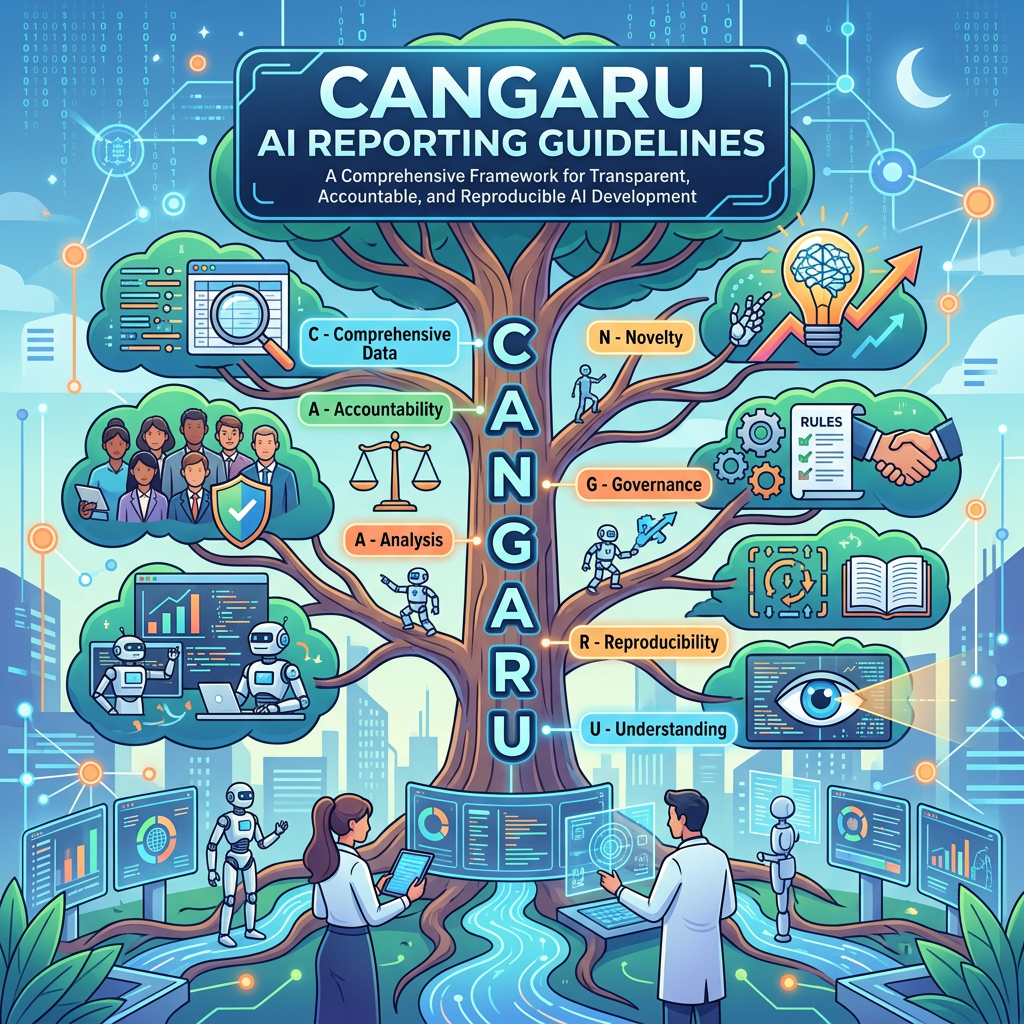
Tree diagram depicting CANGARU AI reporting guidelines: Comprehensive Data, Accountability, Analysis, Novelty, Governance, Reproducibility, Understanding
An illustrated tree diagram explaining the CANGARU AI reporting guidelines for transparent and accountable AI development.

Cacciamani, Giovanni, Michael Eppler, Conner Ganjavi, Asli Pekcan, Brett Biedermann, Gary Collins, y Inderbir Gill. «Development of the ChatGPT and generative artificial intelligence natural large language models for accountable reporting and use (cangaru) guidelines», 27 de junio de 2023. https://doi.org/10.17605/OSF.IO/9Y5NW.

Ver guidelines

CANGARU es una iniciativa interdisciplinaria que busca establecer estándares éticos y de divulgación para el uso de inteligencia artificial generativa y modelos de lenguaje natural en la investigación académica. Su objetivo es promover el uso responsable de estas tecnologías mediante la colaboración con instituciones y desarrollar directrices coherentes y universales. Se enfoca en crear criterios para prácticas éticas y transparentes en el ámbito académico.

La iniciativa ChatGPT, Inteligencia Artificial Generativa y Modelos de Lenguaje Natural para el Reporte y Uso Responsable (CANGARU) con el objetivo de establecer un consenso interdisciplinario sobre el uso responsable, divulgación y guía para el reporte del uso de GAI/GPTs/LLM en el ámbito académico. Trabajando colaborativamente con individuos, organizaciones regulatorias académicas y editoriales, se mitigará de manera efectiva la posible confusión o guías conflictivas que podrían surgir cuando varios grupos trabajan independientemente en la misma tarea. A su vez, esto asegurará que cualquier recomendación sea coherente, completa y universalmente aplicable, promoviendo el uso responsable de esta poderosa tecnología.

El objetivo general de las directrices CANGARU es establecer prácticas recomendadas comúnmente compartidas y transdisciplinares para el uso de GAI/GPTs/LLM en el ámbito académico de la siguiente manera:

a. La Lista de Criterios ‘NO HACER’: Será una guía integral que tiene como objetivo asegurar el uso ético y adecuado de GAI/GPTs/LLM en la investigación académica. Cubrirá cada paso del proceso académico, desde (pero no limitado a) la generación de hipótesis de investigación, la conducción del estudio y el análisis de datos (incluida la codificación), la creación de imágenes, la interpretación de hallazgos y la redacción, revisión, refinamiento y edición del manuscrito. Esta lista servirá como un recurso valioso para los investigadores, proporcionando orientación sobre qué evitar a lo largo de las diferentes etapas del proceso de investigación. Al identificar y resaltar posibles obstáculos y preocupaciones éticas, la Lista de Criterios ‘NO HACER’ ayudará a los investigadores a navegar el uso de GAI/GPTs/LLM de manera responsable y con integridad.

b. La Lista de Criterios de Divulgación: Proporcionará orientación para que los investigadores divulguen de manera transparente su uso de GAI/GPTs/LLM en la investigación académica, mejorando la transparencia, la responsabilidad y permitiendo una mejor evaluación de los hallazgos de investigación. Se enfatiza la importancia de qué y cómo divulgar, fomentando la responsabilidad y abordando los posibles riesgos y limitaciones asociados con esta tecnología.

c. La Lista de Criterios de Reporte: Proporcionará una lista de verificación de recomendaciones para garantizar el reporte completo y transparente de GAI/GPTs/LLM cuando se utilicen como intervenciones en estudios científicos. Considerará todos los aspectos importantes que deben reportarse en el manuscrito científico para mejorar la transparencia, mejorar la reproducibilidad, estandarizar las prácticas de reporte, reducir la interpretación errónea, apoyar los procesos de revisión por pares y editoriales, y facilitar la síntesis de investigación y la traducción del conocimiento.