Archivo de la categoría: Noticias

The Son of Wood presentan «Asfalto y Cereal». Viviendo en la era pop 2023/05/17

The Son of Wood presenta «Asfalto y Cereal»

Viviendo en la era pop 2023/05/17

ESCUCHAR EL PROGRAMA

Ir a descargar

The Son of Wood es un grupo afincado en Salamanca, con un estilo caracterizado por la fusión de folk, rock y rap entre otros géneros de influencia. Este colectivo combina instrumentos como guitarras acústicas, armónica, violín y bajo con influencias folk, rock, indie y country. Generando así una apuesta atractiva que brilla en su directo. En el programa de esta mañana presentan su tercer disco «Asfalto y Cereal» , un enfrentamiento entre el mundo rural y urbano que es a la vez punto de encuentro entre ambas realidades.

Nuevos textos manuscritos de Maimónides descubiertos en la Biblioteca de la Universidad de Cambridge

Roberts, Stuart. «New, Handwritten Maimonides Texts Discovered at Cambridge University Library». University of Cambridge, 11 de mayo de 2023. https://www.cam.ac.uk/stories/maimonides-fragments-discovered.

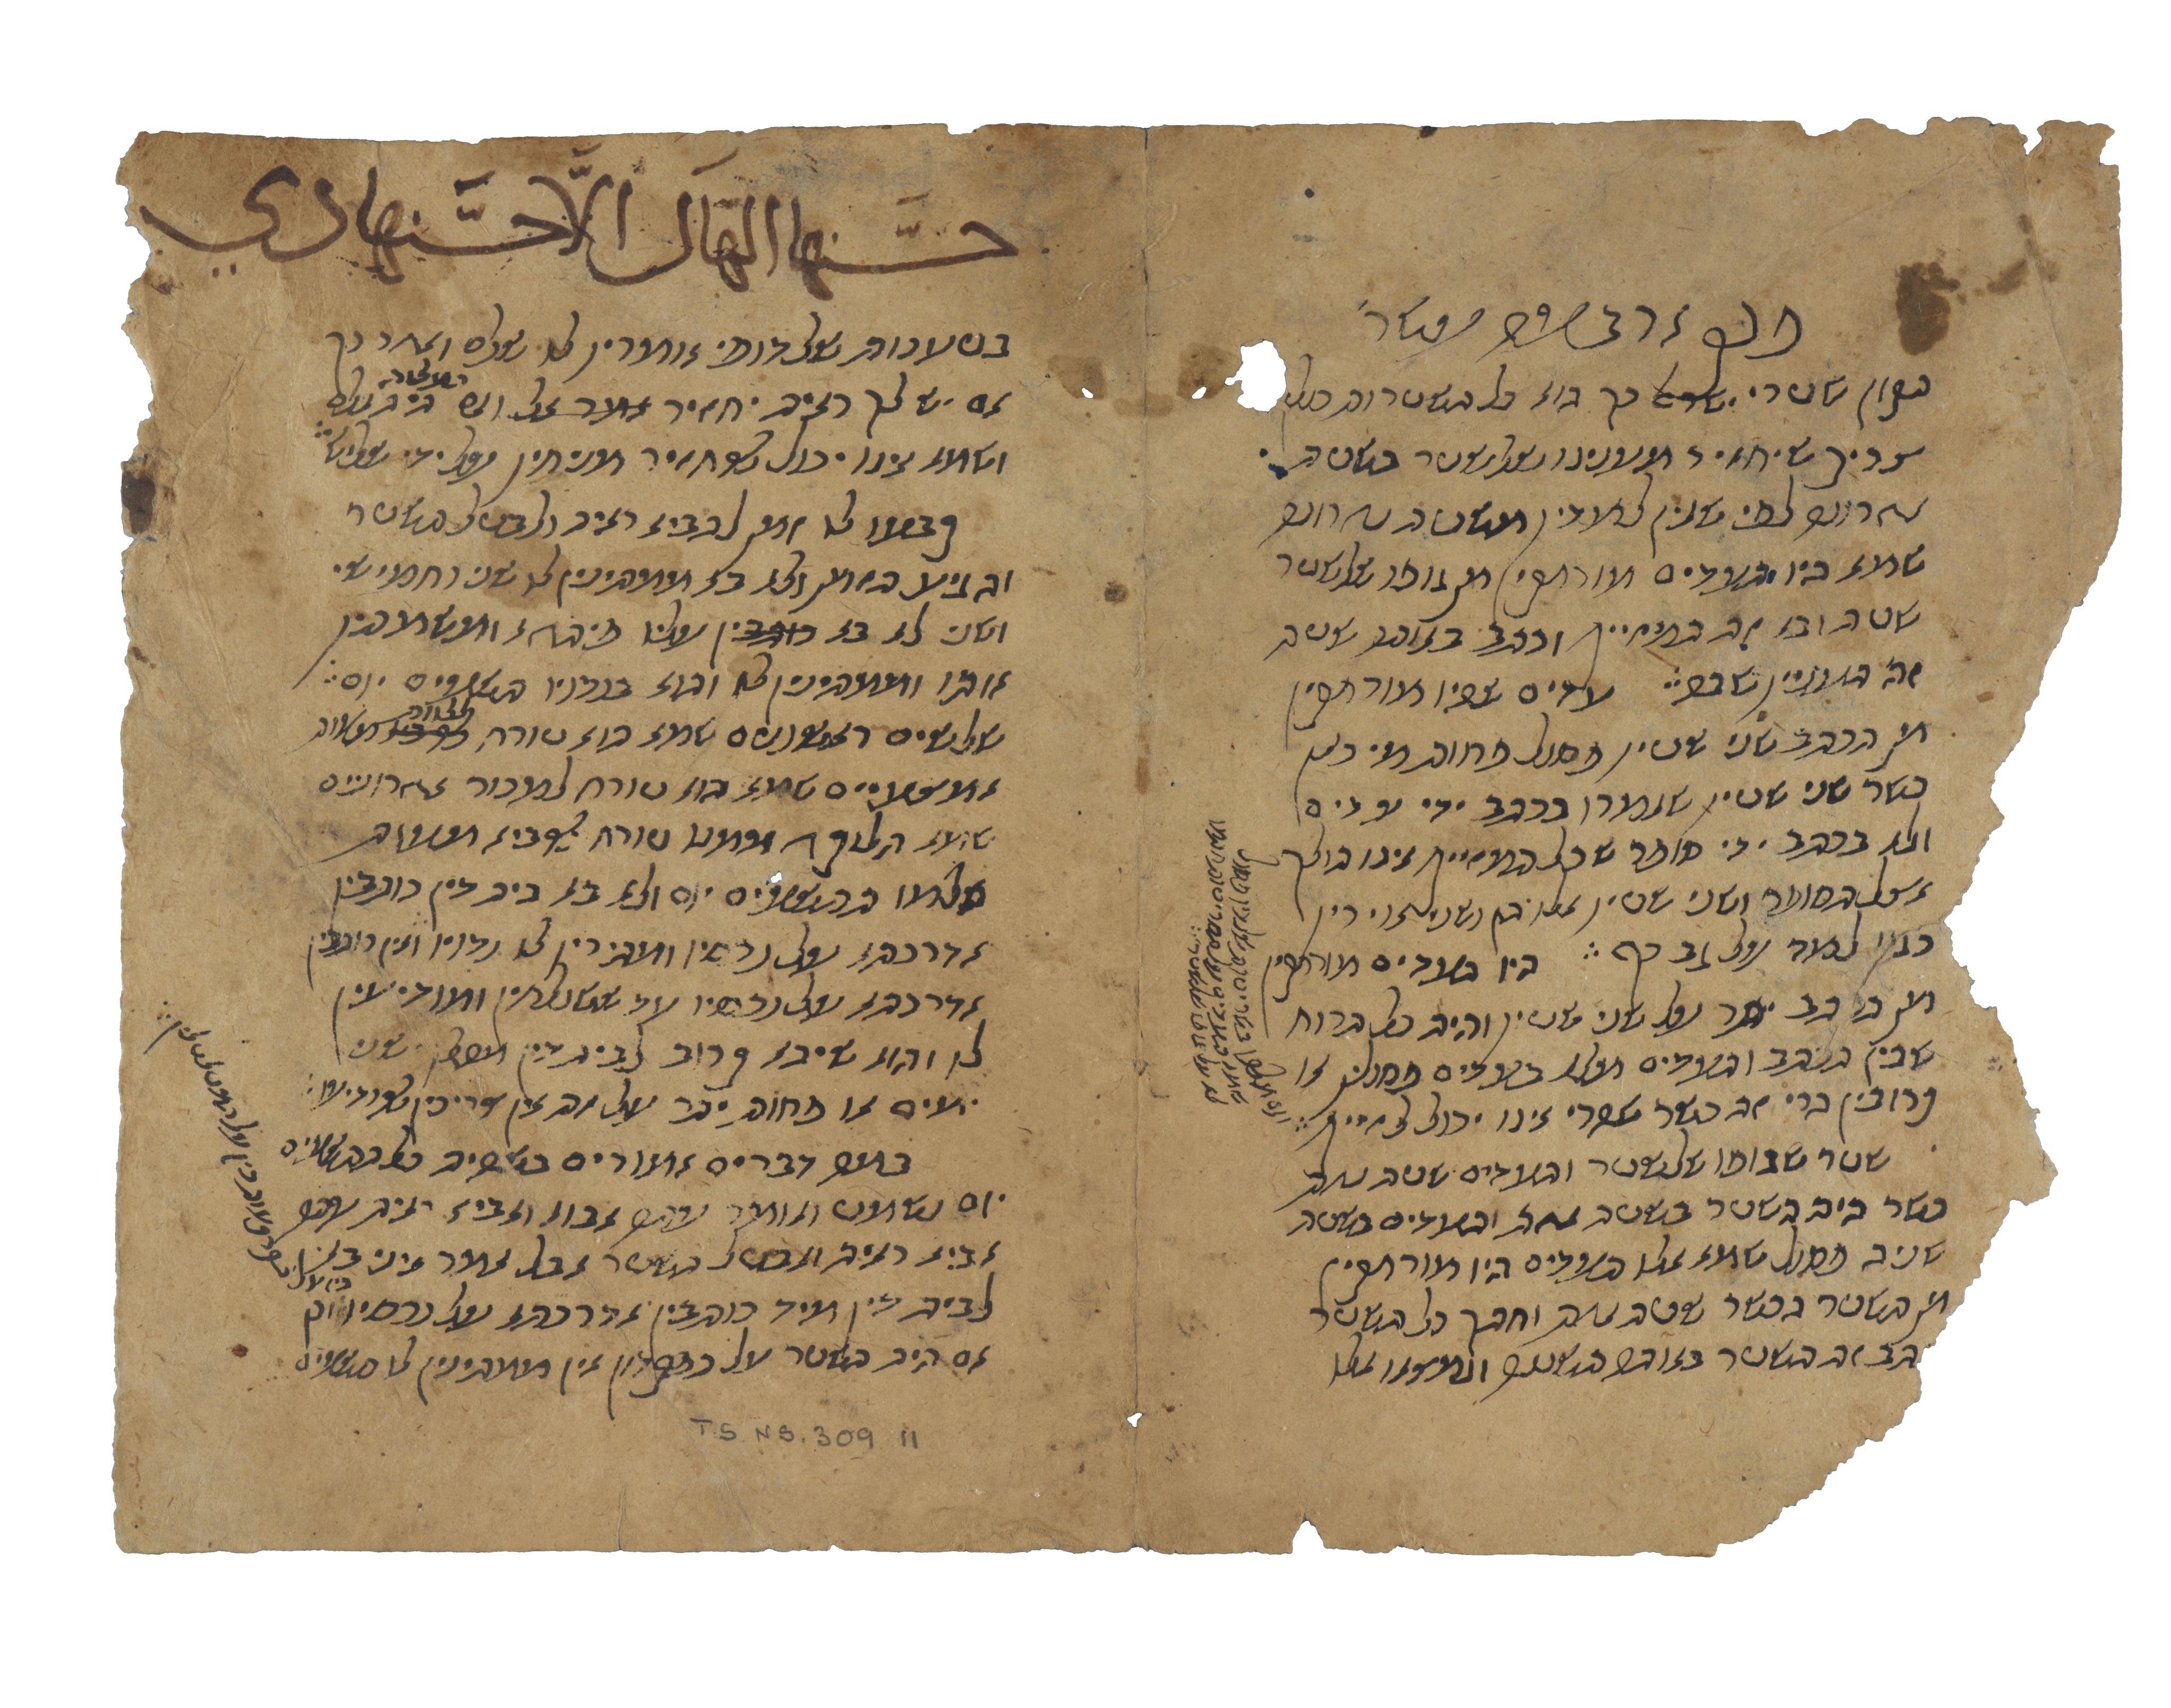
Un investigador visitante en Cambridge ha hallado pruebas desconocidas hasta ahora de que el legendario filósofo judío escribía en un dialecto romance en fragmentos de manuscritos del siglo XII.

Un trozo de papel de 900 años de antigüedad -que forma parte de la colección Cairo Genizah de Cambridge, compuesta por más de 200.000 fragmentos de escritos que relatan la vida durante más de 1.000 años en Egipto y Oriente Próximo- ha sido identificado como el manuscrito del legendario filósofo judío Moisés Maimónides.

La colección Genizah es uno de los mayores tesoros de las colecciones de categoría mundial de la Biblioteca de la Universidad de Cambridge.

Entre los siglos IX y XIX, la comunidad judía de Fustat (El Cairo Antiguo) depositó más de 200.000 escritos no deseados en un almacén construido a tal efecto en la sinagoga Ben Ezra.

Este almacén sagrado se llamaba Genizah. Una Genizah era un lugar seguro para guardar cualquier texto viejo o inservible que, por contener el nombre de Dios, se consideraba demasiado sagrado para tirarlo sin más.

La Web no sobrevivirá a la IA

Roach. «The Web Won’t Survive AI», UNREALITY 27 de abril de 2023. https://www.thisunreality.com/p/the-web-versus-ai.

«The Web versus AI» es un artículo que explora la relación entre internet y la inteligencia artificial (IA). El autor sostiene que, si bien la web ha puesto al alcance de todos grandes cantidades de información, la IA tiene el potencial de crear una eficiencia y accesibilidad aún mayores en términos de procesamiento de la información y toma de decisiones. Sin embargo, el artículo también destaca algunos riesgos y retos potenciales asociados a la adopción generalizada de la IA, como las cuestiones relacionadas con la privacidad, la parcialidad y el desplazamiento de trabajadores humanos. En conjunto, el artículo presenta una perspectiva que invita a la reflexión sobre la evolución en curso de la tecnología y su impacto en la sociedad.

Internet siempre está cambiando. Antes de Google, existía Ask Jeeves, y antes de Facebook, AOL. La mayoría de los internautas aún recuerdan una época anterior a la infestación de Login con Facebook. Y no fue hasta hace un par de años cuando los omnipotentes «fact-checking» intersticiales y las advertencias «dis-info» se adhirieron a cada post y a cada medio de comunicación con una histeria desenfrenada. Internet es diferente. Ahora está más corporativizado que nunca, con más anuncios, más cookies, más algoritmos y más guerras culturales. Internet ha sobrevivido mucho.

Pero puede que no sobreviva a la IA.

Según noticias recientes, los grandes modelos lingüísticos, o LLM, como los de ChatGPT o el nuevo módulo de chat de Bing, han superado la esquiva prueba de Turing. Es decir, que los LLM pueden hablar como nosotros, escribir como nosotros y sonar como nosotros hasta un punto tan convincente que ya no podemos distinguir al individuo sensible de la máquina no sensible. Los LLM pueden inventar opiniones o experiencias que suenan tan reales como cualquier cosa que cualquiera de nosotros pudiera escribir, hasta las faltas de ortografía y la jerga. ¿Es eso malo? Bueno, si estamos intentando pedirle a Alexa que reproduzca Story of a Girl de Nine Days, entonces no, es algo bastante útil. Pero si queremos una Internet hecha por humanos, para humanos y poblada por humanos, entonces podría ser un problema.

I.
La «teoría de la Internet muerta» existe desde hace una década o más. La tesis central de la teoría de la conspiración de la Internet muerta es que «gran parte de los contenidos supuestamente producidos por el hombre» en la web son en realidad generados artificialmente. O, dicho de forma más sencilla, que Internet es Matrix. Aunque es probable que esto sea falso, la repentina avalancha de LLM ha hecho que esta teoría no sólo sea posible, sino inevitable.

II.
La verificación obligatoria de la identidad digital es, en esencia, la muerte del anonimato. A veces se califica de teoría conspiratoria, lo cual es extraño, porque la mayoría de las teorías conspiratorias no tienen un sitio web oficial de las Naciones Unidas. En los dos últimos años, hemos visto cómo la idea de un «pasaporte vacunal» pasaba de ser un absurdo ridículo a convertirse en ley en cuestión de meses, al tiempo que nuestros datos de rastreo de contactos salían a subasta. Australia incluso presentó una propuesta para exigir la verificación de la identidad con foto en las redes sociales, supuestamente para combatir el ciberacoso.

Apenas hace falta decirlo, pero esta es la infraestructura necesaria para un sistema de crédito social. Cuando cada acción se rastrea contra una identidad digital singular, nuestras opiniones problemáticas pueden incurrir en cualquier consecuencia del mundo real decretada por la aristocracia política. Seremos despersonalizados y repersonalizados a voluntad. No es sólo la muerte del anonimato, es la muerte de la disidencia política. Es el fin de la delación y de la objeción de conciencia.

III.
Resulta que algunas empresas de alto nivel ya están pensando en ello. Twitter, bajo la nueva dirección de Elon Musk, ha presentado su renovada suscripción a Twitter Blue como una forma de combatir, en parte, los bots y los spammers a largo plazo.

Porque, francamente, alguien tiene que hacerlo.

La IA generativa, en todas sus formas, no va a desaparecer. Nos espera un Internet lleno de tonterías producidas a una escala logarítmica insondable hoy en día. Es posible que empecemos a rechazar Internet por completo, porque ya no nos resulta útil, del mismo modo que la Generación Z rechaza Facebook. Sin una forma de mantener nuestra relación señal-ruido, nos retiraremos a burbujas cada vez más pequeñas, sólo por invitación, donde los humanos responden por los humanos. El resto de la web, fuera de estos pequeños refugios antiaéreos en línea, seguirá parloteando sola, sin necesidad de información sensible para subsistir, como una gigantesca carpeta de correo basura llena de un billón de correos electrónicos parloteando entre sí. Y ese es el mejor resultado de los dos.

Bienvenidos a Internet.

Las bibliotecas de EE.UU., en primera línea en apoyo a los sin techo

Prime Focus: US libraries on the frontlines of homelessness

Más sobre  Personas sin hogar y bibliotecas 

Jaclyn Lee, de ABC News, informa de que las bibliotecas están en primera línea de la creciente crisis de los sin techo en Estados Unidos y de cómo los bibliotecarios están aprendiendo técnicas para ayudar.

Big Data en contexto: perspectivas jurídicas, sociales y tecnológicas

Hoeren, Thomas, y Barbara Kolany-Raiser, eds. Big Data in Context: Legal, Social and Technological Insights. Springer Nature, 2017. https://doi.org/10.1007/978-3-319-62461-7.

PDF

El libro ofrece una perspectiva interdisciplinar, combinando aspectos jurídicos, económicos y sociológicos. Persigue un enfoque introductorio, destacando brevemente los temas más relevantes de los big data y aborda tanto los aspectos teóricos como los prácticos

Las universidades se preparan para el impacto del ChatGPT durante la temporada de exámenes de verano

University students sitting at desks taking an exam in a large hall with an AI assistant hologram showing economic query and response
Students taking a university exam while an AI assistant displays economic concepts.

Dodd, E. (2023, abril 30). Universities bracing for impact of ChatGPT during summer exam season. Buzz.Ie. https://www.buzz.ie/news/irish-news/university-exams-essays-chatgpt-ai-29815691

El final de las clases suele marcar el comienzo de los exámenes de fin de curso y este año, con los recientes avances en los chatbots de inteligencia artificial a disposición del público, está generando tensión tanto entre los educadores tanto entre los estudiantes.

El sofisticado programa de IA puede generar respuestas escritas completas y matizadas a preguntas, incluidas redacciones, cartas de presentación e informes. ChatGPT puede incluso escribir en un estilo que imita a escritores famosos, desde poetas a periodistas. No es el único robot de inteligencia artificial que existe. Google y Microsoft han lanzado competidores, pero éste es el más conocido.

Buzz Ciara Bracken-Roche, profesora adjunta de la facultad de Derecho y Criminología de la Universidad de Maynooth. afirma «Me llama la atención la rapidez con la que los estudiantes han empezado a utilizarla», añade.

Bracken-Roche añadió que los sistemas de IA como ChatGPT no son del todo malos para la educación e incluso podrían utilizarse como herramienta de enseñanza si, por ejemplo, se pudieran utilizar para escribir cinco frases de ejemplo con una estructura gramatical determinada. «Pero cuando hay otros estudiantes que lo utilizan para escribir sus redacciones, resulta un poco problemático», explica.

Es comprensible que los estudiantes se sientan tentados a utilizar esta herramienta, sobre todo si tienen que entregar varias redacciones en el plazo de una semana. Sin embargo, Bracken-Roche afirma que donde hay tecnología, hay contra-tecnología. «Todos nuestros sistemas contra el plagio ya tienen un detector de ChatGPT. Así que los estudiantes se darán cuenta».

Sin embargo, las herramientas de inteligencia artificial como ChatGPT son cada vez más sofisticadas. «Creo que sólo vamos a ver más dilemas en torno a este tipo de cosas. Y a medida que estas tecnologías se desarrollen en la vida real», afirma Bracken-Roche.

Comparación de los 16 mejores detectores de contenidos AI y ChatGPT

Demers, T. (2023, abril 25). 16 of the best AI and ChatGPT content detectors compared. Search Engine Land. https://searchengineland.com/ai-chatgpt-content-detectors-395957

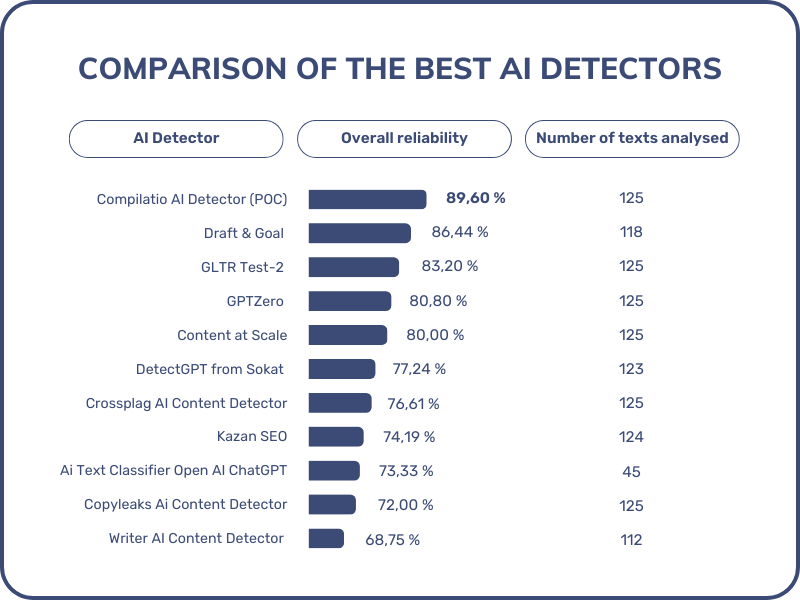
Como cada día aparecen nuevas alternativas a ChatGPT, los detectores de contenido de IA también están ganando popularidad. En este artículo, se comparan16 de estos detectores y se muestra cómo puntúan algunos párrafos de un escrito original no publicado frente a algunos párrafos sobre el mismo tema de ChatGPT.

Herramientas de detección:

La IA generativa y los contenidos ChatGPT plantean varios problemas:

  • La información generada por IA puede ser incorrecta, peligrosa, obsoleta o engañosa.
  • Los resultados de la escritura de la IA pueden ser deficientes.
  • Aunque no se penaliza explícitamente el contenido generado por IA, es posible que Google no siempre confíe en él y lo considere igual que el contenido creado por humanos.
  • El contenido de IA puede «engañar» a los editores o a las empresas que creen que están pagando por contenido creado por humanos.
  • El contenido de IA puede aprovechar el trabajo creativo de los humanos y reutilizarlo sin atribución.

Es importante señalar que los detectores de IA actuales no resuelven todos estos problemas. En su mayoría, estas herramientas no comprueban los contenidos de la IA, no mejoran ni auditan la calidad de los contenidos, ni proporcionan citas de la información extraída de otras fuentes.

Dicho esto, las áreas en las que los detectores de IA pueden ayudar incluyen:

  • Plagio: Muchas de estas herramientas llevan incorporada la detección de plagio, por lo que se puede comprobar si el contenido de la IA se ha extraído en gran medida de otra fuente.
  • Prevención de sanciones: Si te preocupa que el contenido de IA se devalúe de algún modo en los resultados de búsqueda, estas herramientas pueden ayudarte a hacerte una idea de lo fácilmente detectable que es el contenido de IA. (Por supuesto, Google tendrá sin duda herramientas y comprobaciones diferentes).
  • Auditar el uso de la IA: Si tienes una política específica o una forma de compensar a los redactores por el contenido original frente al generado por IA, estas herramientas pueden darte una idea aproximada de si un redactor utiliza IA para generar contenido.
  • Tenga en cuenta que también pueden arrojar falsos negativos y positivos).
  • Comprender los resultados de búsqueda: Algunas de estas herramientas ofrecen extensiones de Chrome, que pueden ayudarle a comprender si los competidores y otros sitios web utilizan o no contenidos generados por IA.

Cómo funciona el software de detección de IA

Cada herramienta es diferente y tiene su propio enfoque del problema. Pero, en general, las herramientas de detección de ChatGPT califican los contenidos en función de la previsibilidad de las frases elegidas.

En otras palabras, la probabilidad de que el contenido sea calificado como IA frente a humano tiene mucho que ver con si el software de detección considera que un fragmento de texto sigue el patrón probable que seguiría la IA para generar contenido.

Los dos conceptos básicos en torno a este proceso se denominan:

Ráfaga: Longitud y ritmo predecibles de la estructura de la frase.

Perplejidad: Aleatoriedad de las palabras elegidas en una frase o conjunto de frases.

Por ejemplo, en un ensayo sobre la fundación de Estados Unidos, es muy poco probable que la IA generativa incluya una anécdota aleatoria, escrita de forma irregular, sobre la primera vez que vio un pingüino, por lo que una herramienta de detección probablemente la vería como una escritura humana.

Del mismo modo que aparecieron detectores de ChatGPT para detectar la escritura de IA generativa, ya se están desarrollando herramientas para sortear los detectores. Herramientas como Undetectable o Quillbot reescribirán tu contenido, a veces haciéndolo más difícil de detectar para ciertas herramientas de detección de IA.

Comparación de los mejores detectores de escritura por IA

Si todavía estás buscando un detector de contenido IA/ChatGPT, vamos a repasar cada uno de ellos y cómo «puntuaron» en la evaluación de la copia generada por humanos frente a la copia IA frente a la copia IA que utilizó este aviso para intentar «superar la detección».

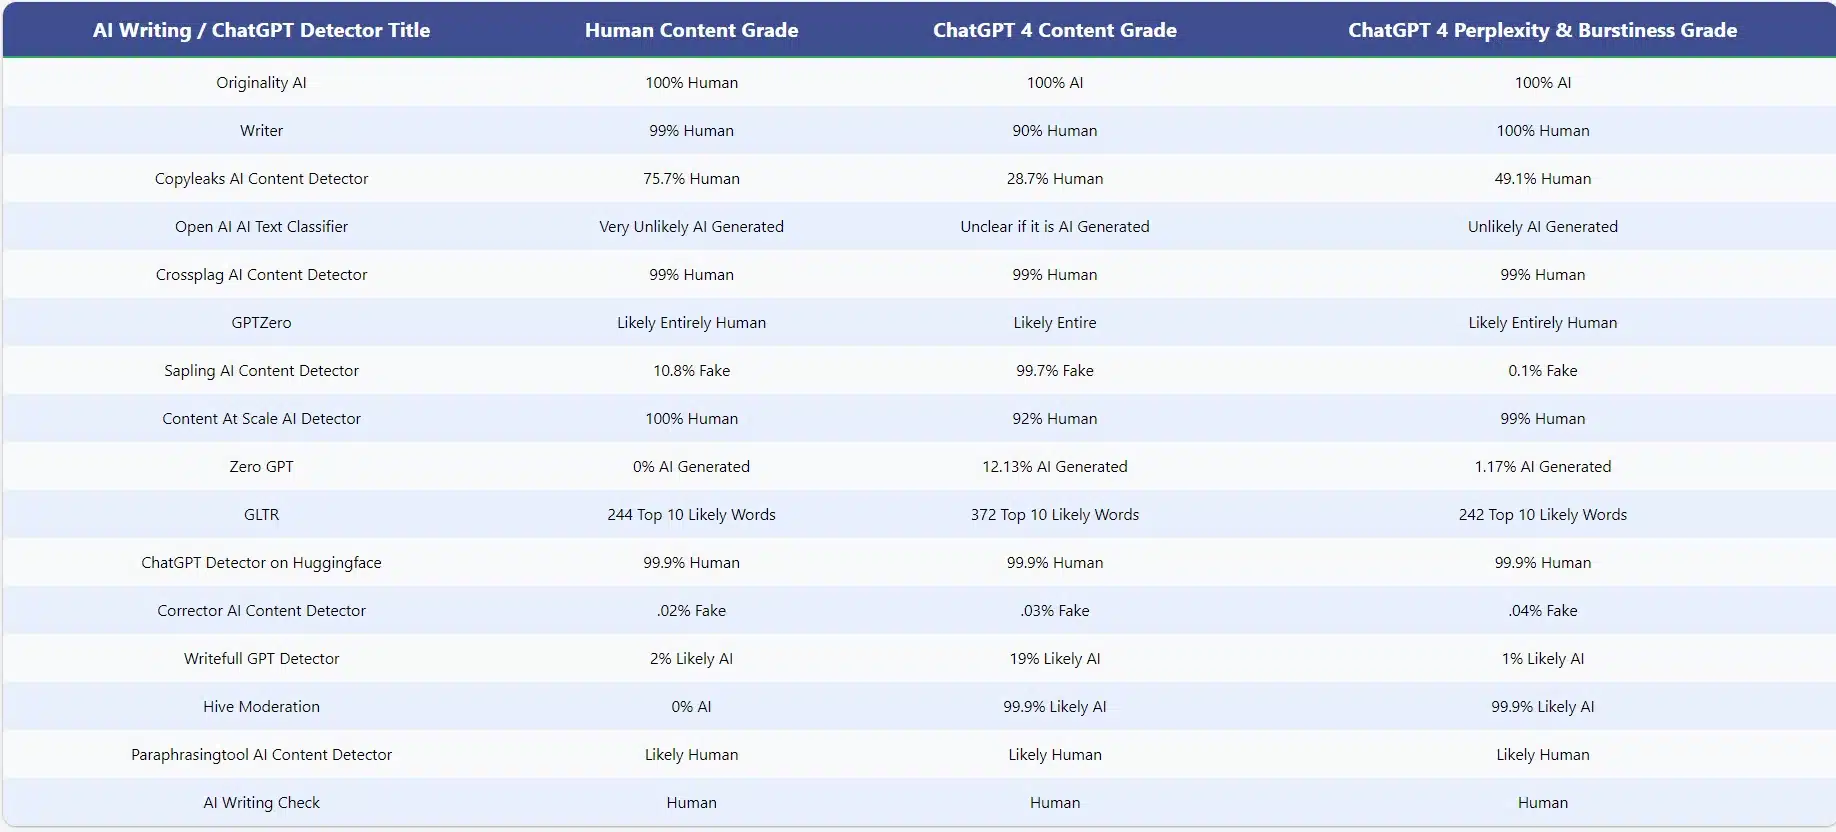
En la tabla que aparece a continuación, puedes ver cómo puntuó cada herramienta la copia escrita por un humano y el texto tomado directamente de ChatGPT sin modificar nada, y esa misma copia modificada con la pregunta «perplejidad y explosividad»:

Principales conclusiones de las pruebas realizadas con 16 verificadores de contenido AI y ChatGPT

Una vez más, es esencial advertir aquí de mis principales conclusiones, ya que tres breves muestras de escritura son muestras muy pequeñas para extraer conclusiones firmes sobre las herramientas individuales.

Dicho esto, se han encontrado algunos patrones interesantes relacionados con los detectores de escritura de IA en general:

  • Calibración: La mayoría de las herramientas encontraron muy probable o muy improbable que las tres muestras de escritura fueran humanas. Es probable que las distintas herramientas sean «más duras» o «más blandas» a la hora de calificar el contenido humano frente al de la IA, por lo que entender cómo está calibrada una herramienta puede ayudar a determinar su utilidad.
  • Características más raras: Algunas de las características menos comunes entre las herramientas son las cargas masivas, la detección de plagio, tener una extensión de Chrome y resaltar secciones específicas con probabilidad de ser IA frente a humano.
  • Gratuito o de pago: Todas las herramientas presentadas aquí excepto Originality.AI tenían al menos versiones gratuitas. Pero las herramientas con los resultados más precisos y la mayoría de las «características raras» tendían a ser las herramientas con una versión de pago.

El ritmo de la innovación en la generación, edición y detección de contenidos de IA puede hacer que tu herramienta favorita se quede obsoleta rápidamente.

Que aporta ChatGPT en su versión GPT4

Nast, C. (2023, abril 26). Llega GPT-4 32K: La versión en esteroides del modelo detrás de ChatGPT. WIRED.

Ver completo

Hace un mes OpenAI sorprendió con el lanzamiento de GPT-4, la generación más reciente de su modelo de lenguaje basado en inteligencia artificial (IA). La gran diferencia entre su antecesor y GPT-4 es que este último es multimodal y, por supuesto, más potente. GPT es el modelo a la base del famoso ChatGPT.

A decir de la empresa, estas características hacen de GPT-4 un modelo “más creativo y colaborativo que nunca”, capaz de resolver problemas más complejos con mayor precisión. Para muchos, la versión más reciente del modelo supone un hito en el desarrollo de la inteligencia artificial generativa.

“GPT-4 tiene un 82% menos de probabilidades de responder a solicitudes de contenido no permitido y un 40 % más de probabilidades de producir respuestas basadas en hechos en comparación con GPT-3.5”, según las evaluaciones internas realizadas por OpenAI.

Lo cierto es que las ambiciones de OpenAI son mayores y se materializan en una segunda versión del modelo GPT-4 conocida como GPT-4 32K, que promete ser mucho más potente.

Un nuevo preprint explora la reutilización de datos y las citas

New preprint explores tracing data reuse and citations. (2023, abril 20). Scholarly Communications Lab | ScholCommLab. https://www.scholcommlab.ca/2023/04/20/new-preprint-explores-tracing-data-reuse-and-citations/

En nuestra era digital, no cabe duda de que los científicos comparten y reutilizan datos abiertos. Sin embargo, sigue sin estar claro hasta qué punto están extendidas las prácticas de reutilización y citación de datos en las disciplinas académicas, y por qué los científicos citan -o no- datos en sus trabajos de investigación.

Las citas de datos, o citas en listas de referencias a datos, se consideran cada vez más un medio importante para rastrear la reutilización de datos e incentivar su puesta en común. Aunque las diferencias disciplinarias en las prácticas de citación de datos han sido bien documentadas mediante enfoques cienciométricos, aún no sabemos hasta qué punto son representativas dentro de las disciplinas. Tampoco conocemos aún las motivaciones de los investigadores para citar -o no citar- datos en sus trabajos académicos. Se presentan aquí los resultados de la mayor encuesta conocida (n=2.492) para investigar explícitamente las prácticas de citación de datos, preferencias y motivaciones, utilizando una muestra representativa de autores académicos por disciplina, tal y como está representada en la Web of Science (WoS). Presentamos los resultados sobre las prácticas y motivaciones actuales de los investigadores para reutilizar y citar datos y también examinamos sus preferencias sobre cómo les gustaría que se citaran sus propios datos. Concluimos analizando los patrones disciplinarios en dos grandes grupos, centrándonos en los patrones de las ciencias sociales y las humanidades, y consideramos las implicaciones de nuestros resultados para el seguimiento y la recompensa de la puesta en común y la reutilización de datos.

¿Qué motiva a los investigadores que citan datos a hacerlo? En toda la muestra, la mayoría de las razones podrían interpretarse como motivaciones que reflejan la práctica «ideal» de la investigación (por ejemplo, mostrar una deuda intelectual), ayudar a otros a encontrar datos o apoyar la validez de las afirmaciones de su investigación. Pocos encuestados indicaron que los factores externos, es decir, que las revistas o los editores les aconsejaran hacerlo, fueran un factor motivador en su decisión de citar datos.

Sin embargo, se encuentran algunas diferencias disciplinarias significativas en esta cuestión. Por ejemplo, los investigadores de ciencias sociales y humanidades (SHH) indicaron que citaban datos para reconocer la deuda intelectual con más frecuencia de lo esperado. Una posible explicación de este hecho podría estar vinculada a los fines comunes para los que nuestros encuestados de las SSH reutilizan los datos (por ejemplo, servir de base para un nuevo estudio o integrar fuentes para construir un argumento).