Archivo de la categoría: Tecnologías de la información

OpenAI lanza GPT Store, una tienda de aplicaciones para sus usuarios de ChatGPT Plus.

Ir a GPT Store

OpenAI ha lanzado GPT Store, una tienda de aplicaciones para sus usuarios de ChatGPT. Accesible para suscriptores de ChatGPT Plus (20$ al mes) y usuarios de los planes comerciales ChatGPT Team y Enterprise (que van desde 25$ hasta miles de dólares por usuario al mes), la tienda presenta GPTs (aplicaciones) a los usuarios.

OpenAI informa que más de 3 millones de usuarios han creado versiones personalizadas de ChatGPT desde noviembre. Los usuarios gratuitos de ChatGPT no tendrán acceso a las aplicaciones inicialmente. La Tienda GPT permite que cualquiera cree y publique un GPT en la web después de verificar su perfil.

El NIST identifica tipos de ciberataques que manipulan el comportamiento de los sistemas de inteligencia artificial (IA)

«NIST Identifies Types of Cyberattacks That Manipulate Behavior of AI Systems». 2024. NIST, enero. https://www.nist.gov/news-events/news/2024/01/nist-identifies-types-cyberattacks-manipulate-behavior-ai-systems.

La publicación, una colaboración entre el gobierno, la academia y la industria, tiene la intención de ayudar a los desarrolladores y usuarios de IA a comprender los tipos de ataques que podrían esperar, junto con enfoques para mitigarlos, con la comprensión de que no hay una solución única.

Los sistemas de IA han permeado la sociedad moderna, trabajando en capacidades que van desde conducir vehículos hasta ayudar a los médicos a diagnosticar enfermedades o interactuar con clientes como chatbots en línea. Para aprender a realizar estas tareas, se entrenan con vastas cantidades de datos: un vehículo autónomo podría mostrar imágenes de carreteras con señales de tráfico, por ejemplo, mientras que un chatbot basado en un modelo de lenguaje grande (LLM) podría exponerse a registros de conversaciones en línea. Estos datos ayudan a la IA a predecir cómo responder en una situación dada.

Un problema importante es que los datos en sí mismos pueden no ser confiables. Sus fuentes pueden ser sitios web e interacciones con el público. Hay muchas oportunidades para que actores malintencionados corrompan estos datos, tanto durante el período de entrenamiento de un sistema de IA como después, mientras la IA continúa refinando sus comportamientos al interactuar con el mundo físico. Esto puede hacer que la IA se comporte de manera indeseable. Por ejemplo, los chatbots pueden aprender a responder con lenguaje abusivo o racista cuando se sortean cuidadosamente las protecciones mediante indicaciones maliciosas.

«En su mayor parte, los desarrolladores de software necesitan que más personas usen su producto para que pueda mejorar con la exposición», dijo Vassilev. «Pero no hay garantía de que la exposición sea buena. Un chatbot puede generar información negativa o tóxica cuando se le indica con un lenguaje cuidadosamente diseñado».

En parte porque los conjuntos de datos utilizados para entrenar una IA son demasiado grandes para que las personas los supervisen y filtren con éxito, todavía no hay una forma infalible de proteger la IA contra el desvío. Para ayudar a la comunidad de desarrolladores, el nuevo informe ofrece una visión de los tipos de ataques que podrían sufrir sus productos de IA y enfoques correspondientes para reducir el daño.

El informe considera los cuatro principales tipos de ataques: evasión, envenenamiento, privacidad y ataques de abuso. También los clasifica según múltiples criterios, como los objetivos y metas del atacante, las capacidades y el conocimiento.

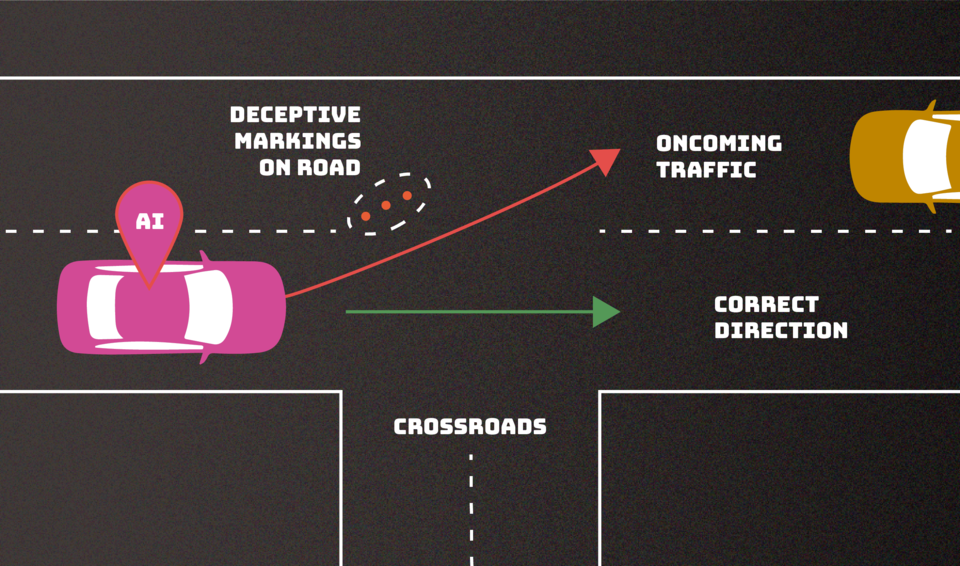
  • Los ataques de evasión, que ocurren después de que se implementa un sistema de IA, intentan alterar una entrada para cambiar cómo el sistema responde a ella. Ejemplos incluirían agregar marcas a señales de alto para hacer que un vehículo autónomo las interprete como señales de límite de velocidad o crear marcas de carril confusas para hacer que el vehículo se desvíe de la carretera.
  • Los ataques de envenenamiento ocurren en la fase de entrenamiento al introducir datos corruptos. Un ejemplo sería deslizar numerosas instancias de lenguaje inapropiado en registros de conversaciones, para que un chatbot interprete estas instancias como parloteo lo suficientemente común como para usarlo en sus propias interacciones con clientes.

Los ataques de privacidad, que ocurren durante la implementación, son intentos de aprender información sensible sobre la IA o los datos en los que se entrenó para mal usarla. Un adversario puede hacerle numerosas preguntas legítimas a un chatbot y luego utilizar las respuestas para ingeniería inversa del modelo para encontrar sus puntos débiles o adivinar sus fuentes. Agregar ejemplos indeseados a esas fuentes en línea podría hacer que la IA se comporte de manera inapropiada, y hacer que la IA olvide esos ejemplos específicos no deseados después del hecho puede ser difícil.

Los ataques de abuso implican la inserción de información incorrecta en una fuente, como una página web o un documento en línea, que una IA luego absorbe. A diferencia de los ataques de envenenamiento mencionados anteriormente, los ataques de abuso intentan darle a la IA piezas incorrectas de información de una fuente legítima pero comprometida para cambiar el uso previsto del sistema de IA.

«La mayoría de estos ataques son bastante fáciles de llevar a cabo y requieren un conocimiento mínimo del sistema de IA y capacidades adversarias limitadas», dijo la coautora Alina Oprea, profesora en la Universidad Northeastern. «Los ataques de envenenamiento, por ejemplo, pueden llevarse a cabo controlando unas pocas docenas de muestras de entrenamiento, lo que sería un porcentaje muy pequeño de todo el conjunto de entrenamiento».

Los autores, que también incluyeron a los investigadores de Robust Intelligence Inc., Alie Fordyce e Hyrum Anderson, desglosan cada una de estas clases de ataques en subcategorías y agregan enfoques para mitigarlos, aunque la publicación reconoce que las defensas que los expertos en IA han ideado contra ataques adversarios hasta ahora son incompletas.

Inteligencia artificial generativa: una introducción a la tecnología de inteligencia artificial generativa y sus implicaciones en la educación.

Generative AI : An introduction to generative artificial intelligence technology and its implications on education. JISC, 2023

Texto completo

Las herramientas de IA generativa, como ChatGPT, ya están teniendo un impacto significativo en la educación. Estas herramientas están planteando retos considerables en torno a la evaluación y la integridad académica, pero también presentan oportunidades, como el ahorro de tiempo del personal al ayudar en la creación de materiales de aprendizaje o la presentación a los estudiantes de nuevas herramientas para mejorar su forma de trabajar.

El impacto de la IA generativa se está dejando sentir mucho más allá de la educación y ya está empezando a cambiar nuestra forma de trabajar. Esto plantea más retos y oportunidades a la hora de garantizar que la educación prepara a los estudiantes para un lugar de trabajo mejorado por la IA y que las evaluaciones son auténticas pero sólidas.

Puntos clave

  • La preocupación inicial se centra en la evaluación y la integridad académica.
  • La acción inmediata es que todo el personal se comprometa con la IA generativa y la pruebe por sí mismo, aprendiendo cómo se verán afectadas sus evaluaciones.
  • La IA generativa puede utilizarse de muchas otras formas, además de para producir trabajos para la evaluación.
  • La IA generativa se utilizará cada vez más en el lugar de trabajo
  • Es probable que la IA generativa sea omnipresente, por lo que prohibirla no es una opción.

Directrices de la UNESCO para la Gobernanza de Plataformas Digitales

Guidelines for the governance of digital platforms: safeguarding freedom of expression and access to information through a multi-stakeholder approach | UNESCO. (2023).

Texto completo


La UNESCO tiene como objetivo garantizar que la libertad de expresión, el acceso a la información y la diversidad de contenido cultural estén plenamente garantizados para todos, mientras que diversos actores, incluidos los Estados miembros, abordan los problemas de desinformación, información errónea y discurso de odio en línea. Estos problemas se abordarán de manera más efectiva, de acuerdo con el derecho internacional de los derechos humanos, mediante la implementación integral y coherente de las Directrices de la UNESCO.

VideoPoet: El último gran modelo lingüístico de Google genera vídeos por Inteligencia Artificial

VideoPoet

Google ha presentado VideoPoet, un nuevo sistema generativo de inteligencia artificial que puede crear y editar videos a partir de texto y otros inputs.


Google presenta VideoPoet, un sistema de inteligencia artificial que puede generar y editar video a partir de texto y otros inputs, incluyendo texto a video, imagen a video y estilización de video. 

VideoPoet puede generar videos de longitud variable y con una variedad de movimientos y estilos, según el contenido de texto. También puede tomar una imagen de entrada y animarla con una indicación, predecir flujo óptico e información de profundidad para estilización de video, y generar audio. Por defecto, el modelo genera videos en orientación vertical para adaptar su salida a contenido de formato corto.

VideoPoet utiliza múltiples tokenizadores (MAGVIT V2 para video e imagen y SoundStream para audio) para entrenar un modelo de lenguaje autoregresivo en modalidades de video, imagen, audio y texto. También se puede controlar el movimiento de la cámara en los videos mediante indicaciones de texto que describen el movimiento de la cámara.

En el futuro, el marco podría admitir generación de cualquier tipo a cualquier tipo y ampliarse a texto a audio, audio a video y subtitulado de video para habilitar aplicaciones aún más versátiles.

Aunque la compañía no ha revelado si tiene planes de poner el modelo a disposición, la integración en un eventual Bard Advanced parece posible. También, Google ha producido un cortometraje utilizando VideoPoet, utilizando Bard como guionista.

OpenAI lanza un documento para guiar el desarrollo seguro de la inteligencia artificial

Preparedness 
Framework
(Beta)

PDF

OpenAI, empresa creadora de ChatGPT, ha lanzado un «marco preparatorio» para guiar el desarrollo seguro de sistemas de inteligencia artificial cada vez más poderosos. El marco, considerado un «documento vivo», tiene como objetivo ayudar a la empresa a «rastrear, evaluar, prever y protegerse contra riesgos catastróficos» que podrían surgir con los avances en la inteligencia artificial.

Esta iniciativa es parte del compromiso voluntario de OpenAI con la Casa Blanca y otros interesados para el desarrollo seguro y transparente de la inteligencia artificial. Según Anton Dahbura, experto en inteligencia artificial y co-director del Instituto de Autonomía Asegurada de la Universidad Johns Hopkins, este marco es un buen «primer paso en un viaje muy largo».

El marco detalla cómo la empresa evaluará sus sistemas emergentes y determinará si es seguro proceder. Incluye la creación de un Grupo Asesor de Seguridad para supervisar la evaluación de riesgos y asesorar a la dirección en decisiones de seguridad. Además, establece niveles de riesgo, como «bajo», «medio», «alto» y «crítico», con varios criterios para evaluar áreas como ciberseguridad, amenazas CBRN (químicas, biológicas, radiológicas, nucleares) y persuasión.

Solo los modelos de inteligencia artificial con una puntuación de mitigación de «medio» o menos pueden ser implementados, y solo aquellos con una puntuación de mitigación de «alto» o menos pueden seguir desarrollándose. OpenAI también se compromete a buscar constantemente «desconocidos-ignorados», explorando categorías actualmente desconocidas de riesgos catastróficos.

El CEO de OpenAI, Sam Altman, ha afirmado que los beneficios superan los riesgos para los sistemas que la empresa ha lanzado al público, pero destaca la necesidad de intervenciones regulatorias gubernamentales para mitigar los riesgos de modelos cada vez más poderosos.

Aunque la administración Biden ha propuesto una «Hoja de Ruta para una Declaración de Derechos de la IA», OpenAI, por ahora, se centra en desarrollar pautas internas, como su nuevo marco. Dahbura elogia la proactividad de OpenAI y destaca que el marco es más detallado y menos genérico que otros documentos aspiracionales de alto nivel en la industria de la inteligencia artificial.

Escritores demandan a OpenAI y Microsoft por supuesto uso no autorizado de libros en inteligencia artificial

Brittain, Blake, y Blake Brittain. 2023. «Pulitzer-Winning Authors Join OpenAI, Microsoft Copyright Lawsuit». Reuters, 21 de diciembre de 2023, sec. Legal. https://www.reuters.com/legal/pulitzer-winning-authors-join-openai-microsoft-copyright-lawsuit-2023-12-20/.

Un grupo de 11 autores de no ficción se ha unido a una demanda en la corte federal de Manhattan que acusa a OpenAI y Microsoft de utilizar indebidamente libros escritos por los autores para entrenar los modelos detrás del popular chatbot ChatGPT de OpenAI y otros programas basados en inteligencia artificial.

Los escritores, incluyendo a los ganadores del Premio Pulitzer Taylor Branch, Stacy Schiff y Kai Bird, argumentan que las compañías infringieron sus derechos de autor al usar sus obras para entrenar los modelos de lenguaje GPT de OpenAI.

Representantes de OpenAI y Microsoft no respondieron de inmediato a las solicitudes de comentarios el miércoles.

El abogado de los escritores, Rohit Nath, afirmó que «los acusados están obteniendo miles de millones de dólares de su uso no autorizado de libros de no ficción, y los autores de estos libros merecen una compensación justa y un trato adecuado por ello».

La demanda, presentada por el escritor y editor de Hollywood Reporter, Julian Sancton, alega que OpenAI «raspó» los trabajos de los autores junto con gran cantidad de otro material con derechos de autor de Internet sin permiso para enseñar a sus modelos GPT a responder a instrucciones de texto humano.

La demanda también afirma que Microsoft ha estado «profundamente involucrado» en el entrenamiento y desarrollo de los modelos y es responsable de la infracción de derechos de autor. Los autores piden daños monetarios no especificados y una orden para que las compañías dejen de infringir sus derechos de autor.

OpenAI y Axel Springer firman un acuerdo que permite que ChatGPT se entrene con datos de la editorial

Knibbs, Kate. s. f. «Journalists Had “No Idea” About OpenAI’s Deal to Use Their Stories». Wired. Accedido 22 de diciembre de 2023. https://www.wired.com/story/openai-axel-springer-news-licensing-deal-whats-in-it-for-writers/.

OpenAI y el conglomerado mediático alemán Axel Springer firmaron la semana pasada un acuerdo de licencia a largo plazo que permite a OpenAI incorporar artículos de los medios de Axel Springer, como Business Insider y Politico, en sus productos, incluido ChatGPT. Aunque el acuerdo se centra en el uso de trabajos periodísticos, los periodistas cuyas historias se compartirán como parte del acuerdo no fueron consultados previamente.

Empleados de Business Insider revelaron que se enteraron del acuerdo de inteligencia artificial al mismo tiempo que se anunció públicamente. PEN Guild, el sindicato estadounidense que representa a alrededor de 280 trabajadores de Politico y E&E News, otra publicación de Axel Springer, afirmó que «no fue consultado ni informado sobre la decisión de que los robots resumieran nuestro trabajo».

Este acuerdo destaca la tendencia emergente de empresas de inteligencia artificial que buscan acuerdos con empresas de medios en lugar de recopilar datos de entrenamiento mediante el rastreo no autorizado de contenido con derechos de autor en Internet. Mientras algunas asociaciones de escritores ven estos acuerdos como una alternativa positiva al rastreo de datos, hay dudas sobre si realmente beneficiarán a los periodistas.

El editor de Techdirt, Mike Masnick, cuestiona la efectividad de estos acuerdos y sugiere que podrían ser estrategias para evitar demandas de las editoras a cambio de cierto acceso a la tecnología. Además, se desconoce cómo afectará financieramente a los periodistas individuales el acuerdo entre OpenAI y Axel Springer.

El acuerdo, que implica que OpenAI pagará a Axel Springer millones de euros, según Bloomberg, plantea preguntas sobre si los periodistas recibirán alguna compensación. Aunque Axel Springer considera que el acuerdo beneficia a los periodistas y a la industria del periodismo, algunos críticos dudan de que el acceso indirecto a la tecnología realmente mejore las condiciones laborales de los periodistas.

En el contexto de la creciente automatización en la industria de los medios, sindicatos y líderes laborales están vigilando de cerca estos acuerdos para proteger los derechos e integridad del trabajo de los periodistas. La cuestión de si estos acuerdos serán beneficiosos a largo plazo y cómo afectarán a la industria de los medios sigue siendo objeto de debate.

El uso de la IA generativa por parte de los estudiantes: la amenaza de las alucinaciones

«Students’ Use of Generative AI: The Threat of Hallucinations». 2023. Center for Democracy and Technology (blog). 18 de diciembre de 2023. https://cdt.org/insights/students-use-of-generative-ai-the-threat-of-hallucinations/.


Los sistemas de inteligencia artificial generativa entrenados con grandes cantidades de datos existentes utilizan el aprendizaje automático para producir nuevo contenido (como texto o imágenes) en respuesta a las indicaciones de los usuarios. En educación, la inteligencia artificial generativa se menciona con mayor frecuencia en el contexto de la integridad académica, con profesores expresando temores sobre el fraude en el aula.

Sin embargo, la encuesta a profesores, padres y estudiantes muestra que el 45 por ciento de los estudiantes que dicen haber utilizado inteligencia artificial generativa informan haberlo hecho por razones personales, mientras que solo el 23 por ciento informa haberlo utilizado para la escuela. De aquellos que han utilizado la tecnología por razones personales, muchas de las aplicaciones son de gran importancia: el 29 por ciento la ha utilizado para lidiar con la ansiedad o problemas de salud mental, el 22 por ciento para lidiar con problemas con amigos y el 16 por ciento para lidiar con problemas familiares. Como resultado, incluso en el contexto de uso personal, los sistemas de inteligencia artificial generativa que producen información incorrecta pueden tener consecuencias perjudiciales significativas.

¿Qué son las alucinaciones y por qué ocurren? Por su estilo de escritura y la forma en que proporcionan información, los sistemas de inteligencia artificial generativa pueden parecer fuentes confiables y autorizadas de información. Sin embargo, estos sistemas a menudo producen texto que es factualmente incorrecto. Estos errores factuales se conocen como «alucinaciones». Las alucinaciones son una consecuencia tanto del diseño como de la estructura operativa de los sistemas de inteligencia artificial generativa.

Desde el punto de vista del diseño, los sistemas de inteligencia artificial generativa están construidos con la intención de imitar el texto producido por humanos. Para lograr esto, generalmente se entrenan con enormes conjuntos de datos de texto a partir de los cuales el sistema aprende sobre la estructura de oraciones y párrafos, y luego produce texto que parece tener sentido para los lectores humanos al predecir repetidamente la siguiente palabra más lógica. Este proceso no está diseñado para crear contenido que sea verdadero o correcto, sino que tenga sentido.

Estructuralmente, la mayoría de los sistemas de inteligencia artificial generativa operan «desconectados», lo que significa que no están obteniendo activamente datos de internet para responder a indicaciones. Por lo tanto, están limitados a los datos contenidos en sus conjuntos de datos de entrenamiento. Esto hace que los sistemas de inteligencia artificial generativa sean particularmente poco confiables cuando se trata de eventos actuales que no aparecen en sus conjuntos de datos de entrenamiento.

Los posibles impactos perjudiciales de las alucinaciones en los estudiantes La realidad de las alucinaciones de inteligencia artificial generativa, junto con los altos niveles de uso personal por parte de los estudiantes para asuntos importantes, plantea grandes preocupaciones sobre el acceso a información precisa en momentos de crisis. Por ejemplo, los estudiantes podrían estar haciendo preguntas a ChatGPT (u otra herramienta de inteligencia artificial generativa) sobre cómo lidiar con un problema de salud mental en curso, que podría ser potencialmente una situación de vida o muerte. Dado que la mayoría de los sistemas de inteligencia artificial generativa probablemente utilizados por los estudiantes se entrenan con información recopilada de internet, podrían replicar malentendidos comunes sobre problemas sensibles como desafíos de salud mental, roles de género y orientación sexual.

Además de las alucinaciones tradicionales, que son simplemente información incorrecta, la inteligencia artificial generativa también puede tener impactos emocionales significativos en los estudiantes que utilizan la herramienta por razones personales al replicar prejuicios sociales contra poblaciones marginadas, incluidas cuestiones de raza, género u orientación sexual. Los estudiantes, especialmente durante las etapas vitales de desarrollo de la educación K-12, pueden internalizar estos prejuicios, ya sea contra ellos mismos o contra otros.

Las alucinaciones también son motivo de preocupación significativa cuando los estudiantes utilizan plataformas de inteligencia artificial generativa con fines académicos. La posibilidad de que los estudiantes reciban información inexacta puede ir en contra directa del objetivo de las escuelas de proporcionar información confiable y de calidad a los estudiantes. Los estudiantes que no comprenden las posibilidades de alucinaciones de estas herramientas pueden usarlas de manera ineficaz y perder usos beneficiosos. Sin comprender las limitaciones de la inteligencia artificial generativa, los estudiantes pueden no poder aprovechar de manera efectiva su potencial como herramienta para complementar su aprendizaje y habilidades de pensamiento crítico.

¿Cómo deben abordar las escuelas el problema de las alucinaciones?

Para combatir las posibles consecuencias devastadoras de las alucinaciones de inteligencia artificial generativa tanto en contextos personales como académicos, las escuelas deben:

  • Comprender las limitaciones de la inteligencia artificial generativa y asegurarse de que los maestros estén adecuadamente capacitados. Aunque los beneficios potenciales de estas herramientas para mejorar el aprendizaje pueden ser emocionantes, es imperativo que los funcionarios escolares estén completamente familiarizados con las deficiencias tecnológicas e impartan ese conocimiento a los educadores. Los maestros desempeñan un papel crucial para garantizar que la inteligencia artificial generativa se utilice de manera responsable y apropiada en el aula. Pero para hacerlo, necesitan acceso a recursos y capacitación.
  • Continuar invirtiendo en consejeros y otros apoyos de salud mental. Las escuelas deben tener cuidado de no dirigir a los estudiantes hacia el uso de inteligencia artificial generativa como recurso sobre temas tan sensibles como su salud mental. Los problemas de salud mental en curso requieren empatía y experiencia humanas, por lo que las escuelas no deben adquirir herramientas de inteligencia artificial generativa para reemplazar o incluso triar el cuidado que de otro modo proporcionaría un ser humano. Si las escuelas van a adquirir una herramienta para complementar a los consejeros y apoyos de salud mental ya existentes, deberían hacer referencia a nuestra guía sobre principios de adquisición responsables, ya que incluso como herramienta complementaria, los sistemas de inteligencia artificial generativa pueden causar daño si no se prueban y regulan adecuadamente.
  • Brindar educación a los estudiantes sobre qué es la inteligencia artificial generativa, cómo funciona y por qué ocurren las alucinaciones. Para combatir la exageración no controlada del público en torno a la inteligencia artificial generativa, las escuelas deben dotar a los estudiantes con conocimientos básicos sobre la tecnología, sus capacidades y limitaciones, y cómo puede salir mal tanto en usos académicos como personales.
  • Brindar educación a los estudiantes sobre la alfabetización mediática y las habilidades de investigación. El lanzamiento de ChatGPT en noviembre pasado subrayó la necesidad de que los estudiantes comprendan cómo ser consumidores responsables y efectivos del conocimiento a través de nuevas herramientas tecnológicas. El uso de la inteligencia artificial generativa es cada vez más inevitable de la misma manera que el uso de internet, por lo que es vital que las escuelas proporcionen a los estudiantes capacitación y recursos sobre cómo evaluar la precisión y confiabilidad de la información obtenida a través de ChatGPT y otras plataformas de inteligencia artificial generativa.
  • Asegurarse de que maestros y estudiantes comprendan cuándo es apropiado usar la inteligencia artificial generativa. La inteligencia artificial generativa no está destinada a reemplazar la enseñanza y el aprendizaje tradicionales en ningún caso; no es un reemplazo del conocimiento y no es un terapeuta o consejero efectivo para problemas personales. Sin embargo, puede usarse, por ejemplo, como una herramienta de apoyo para mejorar la escritura o como una herramienta novedosa para la investigación al explorar un nuevo tema. Las escuelas deben proporcionar orientación y capacitación tanto a maestros como a estudiantes sobre cómo hacer un uso efectivo de la inteligencia artificial generativa.

El índice de transparencia de los principales modelos de Inteligencia Artificial revela que la gran mayoría son opacos

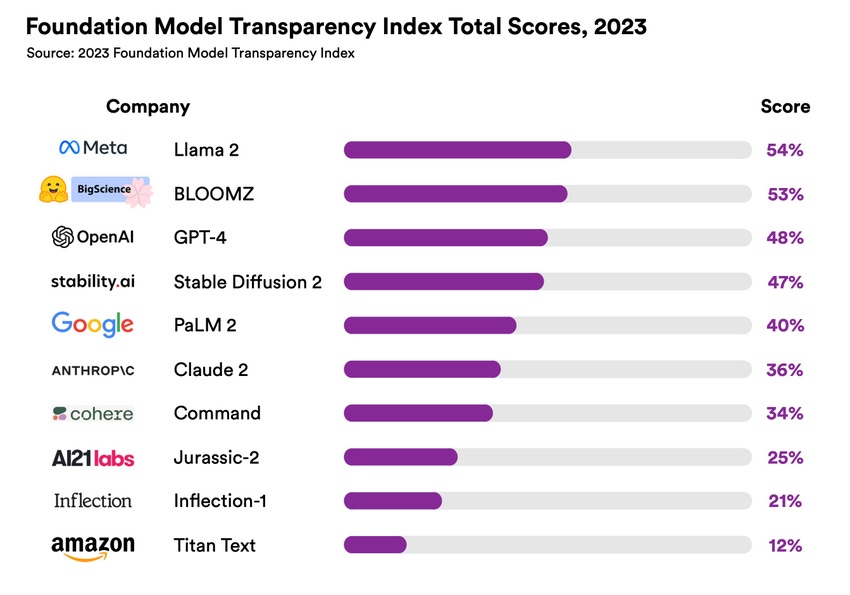
Índice de Transparencia de Modelos Fundamentales

«New Index Finds AI Models Are Murky, Not Transparent At All». 2023. Accedido 21 de diciembre de 2023. https://www.darkreading.com/cyber-risk/new-index-finds-ai-models-are-murky-not-transparent-at-all.


El Índice de Transparencia de Modelos Fundamentales de la Inteligencia Artificial es una evaluación que se realiza a los principales modelos de IA para medir la transparencia en su desarrollo y funcionamiento. Cuando se menciona que la gran mayoría de estos modelos son opacos, significa que existe una falta significativa de claridad y divulgación sobre cómo se entrenan, las fuentes de datos que utilizan, y cómo toman decisiones.


La nueva orden ejecutiva sobre inteligencia artificial (IA) firmada por el presidente de Estados Unidos, Joe Biden, detalla cómo la industria debe asegurarse de que la IA sea confiable y útil. La orden sigue a discusiones destacadas en julio y septiembre entre empresas de IA y la Casa Blanca, que resultaron en promesas sobre cómo las empresas de IA serán más transparentes acerca de las capacidades y limitaciones de la tecnología.

Hacer promesas de transparencia es un paso positivo, pero es necesario contar con un método para medir cuán bien se están cumpliendo esas promesas. Un método podría ser el Model Transparency Index desarrollado por el Centro de Investigación sobre Modelos Fundamentales de la Universidad de Stanford. El índice calificó 10 modelos de IA en función de 100 métricas diferentes, incluyendo cómo se entrenan los modelos, información sobre las propiedades y funciones del modelo, y cómo se distribuyen y utilizan los modelos. Las puntuaciones se calcularon en base a datos disponibles públicamente, aunque las empresas tuvieron la oportunidad de proporcionar información adicional para cambiar la puntuación.

¿Cómo se ve la transparencia al hablar de algunos de los modelos fundamentales más utilizados? No es buena. «Ningún desarrollador importante de modelos fundamentales se acerca a proporcionar transparencia adecuada, revelando una falta fundamental de transparencia en la industria de la IA», escribieron los investigadores de Stanford en el resumen de sus hallazgos.

Llama 2 de Meta recibió la puntuación total más alta en el índice, con 54 sobre 100.

El GPT-4 de OpenAI obtuvo 48, lo cual no es sorprendente, ya que OpenAI decidió retener detalles «sobre la arquitectura (incluido el tamaño del modelo), hardware, ordenador de entrenamiento, construcción del conjunto de datos [y] método de entrenamiento» al pasar de GPT-3 a GPT-4 a principios de este año.

En su mayor parte, los sistemas de IA potentes, como el GPT-4 de OpenAI y el PaLM2 de Google, son sistemas de caja negra. Estos modelos se entrenan con grandes volúmenes de datos y se pueden adaptar para su uso en una amplia variedad de aplicaciones. Pero para un creciente grupo de personas preocupadas por cómo se utiliza la IA y cómo podría afectar a las personas, el hecho de que haya poca información disponible sobre cómo se entrenan y utilizan estos modelos es un problema.

Según los investigadores, hay un poco más de transparencia en torno a la protección de datos de usuario y la funcionalidad básica del modelo. Los modelos de IA obtuvieron buenos resultados en indicadores relacionados con la protección de datos de usuario (67%), detalles básicos sobre cómo se desarrollan sus modelos fundamentales (63%), las capacidades de sus modelos (62%) y sus limitaciones (60%).

La nueva orden ejecutiva describe varias cosas que deben suceder para mejorar la transparencia. Los desarrolladores de IA deberán compartir los resultados de las pruebas de seguridad y otra información con el gobierno. El Instituto Nacional de Estándares y Tecnología tiene la tarea de crear estándares para garantizar que las herramientas de IA sean seguras y seguras antes de su lanzamiento público.

Las empresas que desarrollen modelos que representen riesgos serios para la salud y seguridad públicas, la economía o la seguridad nacional deberán notificar al gobierno federal cuando estén entrenando el modelo y compartir los resultados de las pruebas de seguridad antes de hacer públicos los modelos.