Archivo de la categoría: Tecnologías de la información

Uso de la inteligencia artificial (IA) en el ecosistema de la publicación académica y científica

NISO. 2025. Advancing Artificial Intelligence Interoperability in STM Content Through Standards: Report of NISO AI Publishing Workshops, June 2025.

Texto completo

En junio de 2025, la Organización Nacional de Estándares de Información (NISO) publicó el informe preliminar de una serie de talleres dedicados al uso de la inteligencia artificial (IA) en el ecosistema de la publicación académica y científica. Estos talleres, realizados a principios de año, reunieron a profesionales de bibliotecas, editoriales, instituciones académicas y desarrolladores de tecnología con el fin de identificar desafíos comunes y proponer soluciones colaborativas. El documento está actualmente abierto a comentarios públicos hasta el 15 de julio de 2025, como parte de un proceso participativo para refinar futuras recomendaciones normativas.

Uno de los aspectos centrales del informe es la necesidad urgente de establecer estándares para garantizar la interoperabilidad entre plataformas y herramientas que incorporan IA. Esta interoperabilidad no solo permitiría una mayor eficiencia en los procesos editoriales, sino también una mayor transparencia y confianza en los resultados generados por algoritmos. Se subraya la importancia de metadatos detallados y estructurados, así como la documentación clara del funcionamiento de las IA utilizadas.

También se abordaron consideraciones éticas clave, como la protección de datos, la privacidad de autores y revisores, y la necesidad de mitigar sesgos algorítmicos. Los participantes coincidieron en que cualquier uso de IA en entornos académicos debe respetar los principios de equidad, trazabilidad y responsabilidad. Además, se propone la creación de grupos de trabajo interinstitucionales y la elaboración de guías técnicas que orienten a las organizaciones en la adopción segura y eficaz de estas tecnologías.

El informe representa un paso importante para posicionar a la comunidad académica como agente activo en la definición de normas que regulen el uso de la IA en la publicación científica. Con este enfoque colaborativo, NISO busca fomentar el desarrollo de herramientas más confiables, interoperables y éticas, al tiempo que impulsa una cultura de transparencia y mejora continua en la investigación académica.

Las empresas tecnológicas están recurriendo a bibliotecas y archivos históricos para enriquecer los datos de entrenamiento de inteligencia artificial

O’Brien, Matt. “AI Chatbots Need More Books to Learn From. These Libraries Are Opening Their Stacks.” Associated Press, 12 junio 2025.

Las empresas tecnológicas están recurriendo ahora a bibliotecas y archivos históricos para enriquecer los datos de entrenamiento de inteligencia artificial (IA). La riqueza histórica, lingüística y cultural de estos textos —que abarcan desde literatura y derecho hasta ciencias— ofrece a los chatbots una base más sólida y precisa, en contraste con los datos actuales, a menudo superficiales o generados artificialmente

Con el apoyo de «donaciones sin restricciones» de Microsoft y del fabricante de ChatGPT OpenAI, Institutional Data Initiative con sede en Harvard está trabajando con bibliotecas y museos de todo el mundo sobre cómo hacer que sus colecciones históricas estén preparadas para la IA de una manera que también beneficie a las comunidades a las que sirven.

Harvard ha puesto a disposición casi un millón de libros digitalizados (desde el siglo XV en adelante, en más de 250 idiomas), sumando 394  millones de páginas —aproximadamente 242 000 millones de “tokens”— para desarrolladores de IA. El nuevo conjunto de datos de Harvard, Institutional Books 1.0, contiene más de 394 millones de páginas de papel escaneadas. Una de las primeras obras es del siglo XIV: las reflexiones manuscritas de un pintor coreano sobre el cultivo de flores y árboles. La mayor concentración de obras es del siglo XIX, sobre temas como literatura, filosofía, derecho y agricultura, todo ello meticulosamente conservado y organizado por generaciones de bibliotecarios.

Bibliotecas como la Pública de Boston y la Bodleian de Oxford también digitalizan periódicos antiguos y manuscritos, con fondos de Microsoft y OpenAI, integrándose en la Iniciativa de Datos Institucionales (IDI). El objetivo es utilizar principalmente obras en dominio público, evitando problemas legales por derechos de autor.

Se espera que este enfoque democratice el acceso a datos de calidad para investigación en IA, fomentando una ética en el uso de información histórica. No obstante, también plantea desafíos: el contenido puede incluir teorías anticuadas o prejuicios racistas, por lo que se requieren filtros y guías para su uso responsable

OpenAI, que también está luchando contra una serie de demandas por derechos de autor, donó este año 50 millones de dólares a un grupo de instituciones de investigación, entre ellas la Biblioteca Bodleian de la Universidad de Oxford, de 400 años de antigüedad, que está digitalizando textos raros y utilizando IA para ayudar a transcribirlos. Los fondos también ayudan a las propias bibliotecas a financiar proyectos de digitalización, beneficiando estudios culturales y lingüísticos. La colección ya está disponible en plataformas como Hugging Face, potenciando modelos más diversos en idiomas (menos de la mitad están en inglés)

Este movimiento impulsa el acceso equitativo a datos históricos, mejora la fiabilidad de la IA y promueve el rol activo de las bibliotecas como custodias del conocimiento.

¿Es la alfabetización en IA el caballo de Troya de la alfabetización informacional?

Chen, Zhuo, Nathan Kelber y Ruby MacDougall. 2025. “Is AI Literacy the Trojan Horse to Information Literacy? Insights from our AI Literacy Cohort Workshops.” Ithaka S+R, 10 de junio de 2025. https://sr.ithaka.org/blog/is-ai-literacy-the-trojan-horse-to-information-literacy/

El texto explora cómo la alfabetización en inteligencia artificial (IA) puede transformarse en una vía estratégica para enriquecer la alfabetización informacional tradicional dentro del ámbito académico

Un marco de alfabetización (Literacy Framework) es un conjunto estructurado de conceptos, habilidades, competencias y valores que sirven como guía para enseñar y desarrollar una forma específica de alfabetización. Aunque el término «alfabetización» solía referirse solo a la capacidad de leer y escribir, hoy se aplica a muchos otros ámbitos, como la alfabetización digital, informacional, mediática, científica… o, como en este caso, la alfabetización en inteligencia artificial (AI Literacy).

El estudio se basa en talleres realizados en abril de 2025, donde participaron bibliotecarios y docentes de 45 instituciones de educación superior, como parte del proyecto “Integrating AI Literacy into the Curricula”

Durante las sesiones, se confrontaron marcos conceptuales existentes: el ACRL (Association of College & Research Libraries) centrado en la alfabetización informacional, y varios marcos de alfabetización en IA más pragmáticos (UNESCO, Choice 360, Educause, Digital Education Council). Se observó que los marcos tradicionales son más conceptuales y modulados, mientras que los de IA adoptan enfoques secuenciales y aplicados, lo que facilita su integración curricular

Los distintos marcos de alfabetización en IA coinciden en la necesidad de dotar a los ciudadanos —especialmente a estudiantes y profesionales del ámbito educativo— de competencias que les permitan comprender, usar, evaluar y reflexionar críticamente sobre la inteligencia artificial. Aunque cada marco responde a su contexto institucional y geográfico, comparten una estructura organizada en torno a dimensiones o competencias clave.

En primer lugar, muchos marcos giran en torno a tres grandes ejes: la comprensión técnica (cómo funciona la IA), la dimensión ética y crítica (identificación de sesgos, impactos sociales, privacidad), y la aplicación práctica (uso responsable y efectivo de herramientas de IA). Por ejemplo, tanto el marco de la Universidad de Adelaida como el de Educause y el de la UNESCO incluyen estas tres dimensiones, si bien con distintos niveles de profundidad y enfoque. El marco de la UNESCO es particularmente exhaustivo, al dividir las competencias en cuatro dimensiones (ética, técnica, diseño de sistemas y mentalidad humanista) y establecer niveles progresivos: comprender, aplicar y crear.

El marco de ACRL (Association of College and Research Libraries), aunque no está centrado específicamente en IA, ofrece una estructura conceptual sobre la alfabetización informacional que ha influido en otros marcos como el de Choice360. Este último adapta los principios de ACRL para entornos donde la IA ya forma parte del proceso de búsqueda, evaluación y producción de información académica.

Por su parte, marcos como el del Digital Education Council y el del World Economic Forum adoptan una visión más global y orientada al desarrollo de ciudadanía digital, el pensamiento computacional y las habilidades para el siglo XXI, incorporando la IA como herramienta clave en el desarrollo económico y social. En este sentido, coinciden con el enfoque de Educause, que además integra competencias para distintos actores de la educación superior: estudiantes, docentes y personal técnico.

Los marcos centrados en bibliotecas, como AI Literacy: A Guide for Academic Libraries (Lo, 2023) y el de la Universidad de Adelaida, tienen un enfoque más operativo y cercano a la práctica profesional, diseñados para ayudar a bibliotecarios a enseñar o guiar en el uso de IA en contextos académicos. Estos marcos suelen ser más concisos, pero incluyen ejemplos, buenas prácticas y estrategias de implementación.

Las principales diferencias entre estos marcos se relacionan con el nivel de detalle, el público destinatario (desde estudiantes de primaria hasta personal universitario), y la orientación institucional (educativa, bibliotecaria o política). Algunos, como el de la UNESCO o Educause, son más prescriptivos y completos; otros, como el de ACRL o el de Lo, permiten una mayor flexibilidad e interpretación local.

Todos estos marcos ofrecen una base sólida y complementaria para abordar la alfabetización en inteligencia artificial. Todos reconocen la importancia de desarrollar una comprensión profunda y crítica de la IA, más allá del simple uso técnico de las herramientas, fomentando una ciudadanía digital ética, inclusiva y preparada para los desafíos del presente y del futuro. La combinación de elementos de estos marcos puede ser especialmente útil para diseñar programas educativos o bibliotecarios adaptados a diferentes contextos.

Uno de los hallazgos más relevantes surgió cuando un participante definió la alfabetización en IA como “un cubo bajo el paraguas de la alfabetización informacional”. Este concepto propone que la IA no solo está contenida dentro de la alfabetización informacional, sino que moldea y modifica su paradigma, recordando que detrás de toda tecnología hay supuestos culturales, técnicos y éticos que requieren una evaluación crítica.

Los participantes destacaron que ambos marcos comparten el énfasis en el pensamiento crítico sobre la información. No obstante, las prácticas de alfabetización en IA demandan además una capacidad técnica mínima y una comprensión ética más profunda: es necesario comprender cómo los sistemas generan información, reconocer sus sesgos y limitaciones, y evaluar fuentes con conciencia tecnológica .

También se identificaron brechas en los marcos: la alfabetización en IA suele centrarse únicamente en la IA generativa, ignorando otros tipos de IA; además, se utilizan términos como “ética” de manera vaga sin esclarecer a quién se aplican los principios. El ritmo acelerado del desarrollo tecnológico exige marcos educativos más dinámicos y actualizables .

De este modo, el artículo concluye que la alfabetización en IA podría actuar como una especie de “caballo de Troya” dentro de la alfabetización informacional: aporta una capa adicional que exige un enfoque más técnico, crítico y contextualizado. Esto representa una oportunidad para modernizar los programas curriculares, impulsar colaboraciones entre bibliotecas, centros educativos y docentes, y preparar a estudiantes y académicos para abordar la complejidad actual de la cultura informativa .

Integración de la AI en los planes de estudios

Chen, Zhuo, Nathan Kelber y Ruby MacDougall. 2025. “Applying AI Literacy to Student and Faculty Persons.” Ithaka S+R Blog, 10 de junio de 2025. https://sr.ithaka.org/blog/applying-ai-literacy-to-student-and-faculty-personas/.

En mayo de 2025, Ithaka S+R organizó los primeros talleres del proyecto “Integrating AI Literacy in the Curricula”, en colaboración con bibliotecarios y docentes de 45 instituciones educativas de nivel superior. El objetivo fue vincular la alfabetización en inteligencia artificial (IA) con los marcos tradicionales de alfabetización informacional y generar herramientas prácticas para su implementación académica

Durante la primera sesión, los participantes analizaron marcos teóricos y definiciones existentes sobre IA y alfabetización informacional. En la segunda, se formaron grupos que trabajaron a partir de uno de seis personas predefinidos (tres perfiles de estudiantes: universitario, posgrado y adulto; y tres perfiles docentes: humanista, científico social y natural), para explorar sus riesgos, beneficios y necesidades específicas relacionadas con la IA

Dos ejemplos representativos surgieron:

  • Callie, estudiante de 38 años de fisioterapia en línea, necesita acceso a herramientas de IA relevantes, formación práctica y certificaciones para destacar en el ámbito laboral de la salud. Sin embargo, su falta de experiencia con IA implica riesgos como el uso inapropiado de datos o el incumplimiento de normativas de privacidad (HIPAA). Los participantes definieron su alfabetización en IA como “comprender la IA, reconocer casos adecuados de uso y evaluar su repercusión en la preparación profesional”
  • Sue, profesora de sociología reacia al uso de IA frente a la presión institucional, podría centrarse únicamente en detectar trampas estudiantiles. Los participantes la instaron a reorientar su enfoque: en lugar de buscar mecanismos de detección, desarrollar ejemplos positivos de uso docente, construir políticas institucionales y comprender las limitaciones de las herramientas. Su definición se formuló como “tener acceso a modelos de IA bien integrados en el aula y conocer los límites de los detectores”

Al final, los facilitadores sintetizaron las ideas en común y alentaron a las instituciones a profundizar en las prioridades identificadas para impulsar la alfabetización en IA. Ithaka S+R continuará diseñando instrumentos cualitativos para recoger experiencias de estudiantes y docentes, con el fin de desarrollar soluciones tangibles adaptadas a sus necesidades.

Este enfoque centrado en personas evidencia una necesidad de diseñar definiciones flexibles y relevantes de alfabetización en IA, que respondan a disciplinas, niveles de experiencia y roles institucionales. El proyecto reconoce el potencial transformador de integrar la IA de forma ética y contextualizada en entornos educativos reales.

¿Por qué aceptamos o rechazamos la inteligencia artificial?

Lu, Jackson. 2025. “How We Really Judge AI.” MIT News, 10 de junio de 2025. https://news.mit.edu/2025/how-we-really-judge-ai-0610.

El estudio del Instituto de Tecnología de Massachusetts (MIT) revela que las personas no se dividen simplemente entre optimistas y detractores de la inteligencia artificial (IA), sino que evalúan su uso según dos factores clave: la percepción de la capacidad de la IA y la necesidad de personalización en el contexto de la decisión.

Un estudio reciente realizado por investigadores del Instituto de Tecnología de Massachusetts (MIT) ha revelado nuevas perspectivas sobre cómo las personas evalúan y perciben la inteligencia artificial (IA) en distintos contextos. Contrario a la idea simplista de que las opiniones sobre la IA se dividen únicamente entre quienes la apoyan y quienes la rechazan, este estudio propone un modelo más complejo y matizado que explica por qué aceptamos o resistimos su uso dependiendo de dos factores fundamentales: la capacidad percibida de la IA para realizar una tarea específica y la necesidad de personalización o atención individual en la toma de decisiones.

El estudio, dirigido por el profesor Jackson Lu, presenta el “Marco de Capacidad–Personalización”, que sostiene que las personas tienden a valorar más positivamente la IA cuando consideran que ésta tiene una capacidad superior a la humana en ciertas tareas y cuando dichas tareas no requieren una adaptación personalizada basada en circunstancias individuales. En estos casos, la IA es vista como una herramienta eficiente, confiable y útil para apoyar la toma de decisiones o automatizar procesos.

Por ejemplo, en actividades como la detección de fraudes financieros, la revisión masiva de datos, o el análisis estadístico, la IA sobresale porque puede procesar grandes cantidades de información con rapidez y precisión, superando claramente el rendimiento humano. Además, estas tareas suelen ser rutinarias y no necesitan un enfoque personalizado, lo que facilita la confianza en las respuestas generadas por la IA.

Sin embargo, el estudio también señala que existe una notable resistencia hacia el uso de la inteligencia artificial en contextos donde la personalización es fundamental y la comprensión de las circunstancias particulares es clave para una buena decisión. Áreas como la atención médica, la terapia psicológica, las entrevistas laborales o los diagnósticos médicos son ejemplos donde las personas prefieren la intervención humana porque valoran la empatía, la experiencia subjetiva y la capacidad de interpretar matices que las máquinas aún no pueden replicar adecuadamente.

Esta investigación se basa en un meta-análisis exhaustivo que abarca 163 estudios previos, analizando más de 82.000 respuestas de participantes en 93 contextos diferentes relacionados con decisiones apoyadas por IA. Gracias a esta amplia muestra, el estudio proporciona una comprensión sólida y generalizable sobre los patrones de aceptación y rechazo de la IA en la sociedad.

El modelo de Capacidad–Personalización no solo ayuda a explicar por qué ciertas aplicaciones de IA son bien recibidas mientras que otras generan dudas o rechazo, sino que también ofrece una guía útil para desarrolladores, diseñadores y responsables de políticas. Comprender estas percepciones puede facilitar la creación de tecnologías que respondan mejor a las expectativas y necesidades humanas, equilibrando la eficiencia tecnológica con la sensibilidad social.

En definitiva, este trabajo académico aporta un marco conceptual valioso para entender que la aceptación de la inteligencia artificial no es un fenómeno binario, sino un proceso complejo que depende del contexto específico de uso, las capacidades percibidas de la tecnología y el grado en que se requiere una atención personalizada en la toma de decisiones. Este conocimiento es fundamental para avanzar hacia una integración ética, efectiva y confiable de la IA en nuestra vida cotidiana.

GLAT: herramienta para evaluar la alfabetización en inteligencia artificial generativa

Yueqiao Jin, Roberto Martinez-Maldonado, Dragan Gašević, Lixiang Yan, GLAT: The generative AI literacy assessment test, Computers and Education: Artificial Intelligence,
Volume 9, 2025, 10 de junio de 2025. https://www.sciencedirect.com/science/article/pii/S2666920X25000761

Se presenta «GLAT: The Generative AI Literacy Assessment Test» una herramienta para el desarrollo y validación del rendimiento para medir la alfabetización en inteligencia artificial generativa (GenAI).

Esta prueba, denominada GLAT, fue diseñada para evaluar la capacidad de los individuos para utilizar herramientas de GenAI de manera efectiva y ética, abordando la creciente necesidad de evaluar habilidades en un entorno digital cada vez más automatizado.

La investigación destaca que, a pesar del aumento en el uso de tecnologías de GenAI, existe una falta de herramientas estandarizadas para medir la competencia en este ámbito. GLAT se diferencia de las evaluaciones tradicionales al centrarse en tareas prácticas que simulan escenarios reales donde los usuarios deben interactuar con sistemas de GenAI, evaluando su capacidad para generar, analizar y aplicar contenido de manera crítica.

Además, el estudio valida la fiabilidad y validez del GLAT a través de pruebas empíricas, demostrando que la herramienta es efectiva para medir la alfabetización en GenAI en diversos grupos demográficos. Los resultados sugieren que el GLAT puede ser una herramienta valiosa para instituciones educativas, organizaciones y gobiernos que buscan evaluar y mejorar las competencias digitales relacionadas con la inteligencia artificial generativa.

GLAT es una solución innovadora para abordar la necesidad urgente de evaluar la alfabetización en GenAI, proporcionando una base para el desarrollo de políticas educativas y formativas que promuevan el uso responsable y competente de las tecnologías de inteligencia artificial generativa

Las herramientas de inteligencia artificial están afectando negativamente al numero de visitas web y a los ingresos por publicidad

Axios. «Other News Sites Are Getting Crushed by Google’s New AI Tools.» Axios, 10 de marzo de 2025. https://www.axios.com/2025/03/17/alden-newspapers-openai-google-copyright

Las herramientas de inteligencia artificial (IA) de Google están afectando negativamente a los medios de comunicación tradicionales. Estas herramientas, como los resúmenes automáticos y las respuestas generadas por IA, están desplazando el contenido original de los sitios de noticias en los resultados de búsqueda, lo que reduce el tráfico web y los ingresos publicitarios de los editores.

Además, Google ha implementado resúmenes (Overview) de IA en sus resultados de búsqueda, lo que eleva el contenido generado por IA por encima del contenido original de los editores. Esta tendencia está alterando el ecosistema digital y generando preocupaciones sobre el futuro del periodismo en línea.

En respuesta, algunos editores están tomando medidas legales para proteger sus derechos de autor y asegurar que se les compense por el uso de su contenido por parte de las herramientas de IA. Por ejemplo, Alden Global Capital, propietario de varios periódicos, ha demandado a OpenAI y Google por infracción de derechos de autor y ha instado al gobierno de EE. UU. a rechazar propuestas que permitirían a las empresas de tecnología utilizar datos públicos para entrenar modelos de IA sin el consentimiento de los editores.

Este conflicto resalta la creciente lucha por el control y la monetización de la información en la era de la IA, donde los editores buscan proteger sus intereses frente al uso no autorizado de su contenido por parte de las herramientas de IA de las grandes empresas tecnológicas.

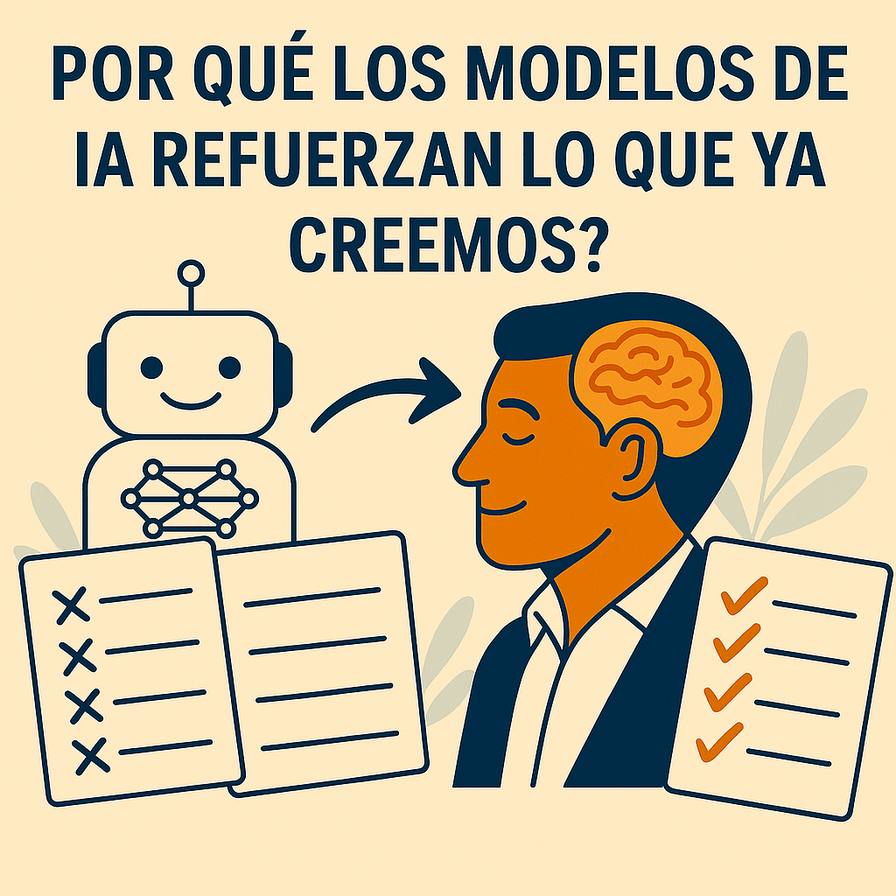
¿Por que los modelos de IA nos conducen a reforzar lo que ya creemos?

Eugina Leung, “The Scientific Reason Why ChatGPT Leads You Down Rabbit Holes,” CNET, 10 de junio de 2025, https://www.cnet.com/tech/services-and-software/the-scientific-reason-why-chatgpt-leads-you-down-rabbit-holes/

El artículo cuenta por qué herramientas como ChatGPT pueden llevar a los usuarios a profundizar en líneas de pensamiento cada vez más específicas, a veces hasta puntos extremos o sesgados, en lo que comúnmente se conoce como “caer en un sesgo o bucle de confirmación” digital.

El sesgo de confirmación (también llamado sesgo confirmatorio) es una tendencia psicológica que lleva a las personas a buscar, interpretar y recordar información de manera que confirme sus propias creencias y expectativas preexistentes, mientras ignoran o desestiman información que las contradiga.

Según Leung, este comportamiento no se debe únicamente al diseño del modelo de lenguaje, sino a un patrón compartido con los motores de búsqueda y otras herramientas digitales: las personas tienden a confirmar sus creencias iniciales. Esto se traduce en que, cuando un usuario realiza una consulta a ChatGPT, lo hace ya desde una postura determinada. Por ejemplo, si alguien sospecha que cierto alimento es dañino, probablemente formulará su pregunta de forma que ya presupone esa posibilidad. El sistema, a su vez, genera respuestas que encajan con esa narrativa, confirmando la suposición en lugar de cuestionarla.

Esta interacción desencadena un bucle de retroalimentación. Cuanto más pregunta el usuario en esa dirección, más contenido relacionado obtiene, lo que le lleva a profundizar aún más en esa perspectiva. Este proceso es lo que se conoce como “cascada de profundidad” y puede dar lugar a una especie de efecto túnel, donde se van perdiendo matices, dudas o puntos de vista alternativos. En el caso de temas sensibles como la política, la salud, las creencias personales o las teorías de la conspiración, este efecto puede ser especialmente problemático, ya que facilita la consolidación de ideas erróneas o distorsionadas.

Uno de los elementos clave de este fenómeno es la forma en que los modelos responden a las preguntas: su diseño se basa en ofrecer respuestas que parezcan relevantes, coherentes y satisfactorias según el contexto de la conversación. Sin embargo, esto no siempre equivale a una respuesta imparcial o equilibrada. En muchos casos, el sistema simplemente sigue la lógica del usuario y refuerza su hipótesis, en lugar de introducir elementos de contraste o una visión crítica.

Aunque el artículo no presenta una solución definitiva, sí deja entrever algunas estrategias útiles para contrarrestar este efecto. En primer lugar, es esencial que los usuarios sean conscientes de sus propios sesgos y del modo en que estos influyen en la formulación de preguntas. También se sugiere que se practique la variación intencional de las consultas, explorando diferentes formas de abordar un mismo tema. Finalmente, se menciona la posibilidad de diseñar modelos que incluyan mecanismos para ofrecer perspectivas alternativas o advertencias sobre posibles sesgos presentes en la conversación.

En conclusión, ChatGPT tiene una base científica y psicológica sólida. La tendencia humana a buscar confirmación de nuestras ideas, unida al diseño de las respuestas generadas por IA, puede llevarnos a reforzar creencias sin darnos cuenta. Este descubrimiento invita tanto a usuarios como a desarrolladores a promover un uso más consciente, crítico y equilibrado de estas herramientas.

Guía inicial de la IFLA sobre inteligencia artificial en bibliotecas: oportunidades, riesgos y recomendaciones

International Federation of Library Associations and Institutions (IFLA). 2025. IFLA Entry Point to Libraries and AI. The Hague: IFLA, June 10, 2025.

Texto completo

«IFLA Entry Point to Libraries and AI», publicada el 10 de junio de 2025, es una guía breve y práctica diseñada para ayudar a profesionales de bibliotecas a reflexionar sobre las oportunidades, beneficios y riesgos éticos que plantea la inteligencia artificial (IA) en sus servicios. No pretende reemplazar un instrumento de decisión, sino ser una herramienta introductoria: ofrece preguntas —no respuestas— para promover el debate y la evaluación contextuada.

La Inteligencia Artificial (IA) ofrece un potencial significativo para apoyar los valores fundamentales de las bibliotecas, como el acceso equitativo a la información y la creación de conocimiento. Sin embargo, también es una tecnología controvertida, con desarrollos actuales que plantean preocupaciones éticas y sociales.

La IFLA utiliza el término IA en sentido amplio, abarcando desde tecnologías conocidas (como OCR, traducción automática, análisis de datos) hasta modelos generativos recientes. La guía reconoce que, si bien muchas ya forman parte del ecosistema bibliotecario, el público y los debates suelen centrarse en herramientas más novedosas como los grandes modelos de lenguaje.

La guía forma parte de una serie temática (2025‑2026), alineada con el Código de Ética de la IFLA y otros documentos. La organización se compromete a actualizarla regularmente, reflejando los rápidos cambios en el ámbito de la IA . En la misma, IFLA enfatiza el deber profesional de garantizar que los beneficios de la IA —por ejemplo, en términos de acceso al conocimiento y eficiencia operativa— se obtengan de forma responsable, equitativa y sostenible. Asimismo, alerta sobre el potencial generador de daños, evitando que la “hiperexcitación tecnológica” opaque soluciones más simples, justas y asequibles.

Identifica múltiples aplicaciones útiles para las bibliotecas, entre ellas:

  • Digitalización masiva (textos, archivos visuales, grabados).
  • Creación de metadatos a escala.
  • Sistemas de recomendación y personalización.
  • Resúmenes automatizados, análisis de datos, traducciones y chatbots.
  • Soporte en tareas profesionales internas (p. ej., redacción de informes)

Aunque el documento alerta también sobre 14 riesgos clave, como:

  • Concentración de poder en empresas tecnológicas y carreras de IA desreguladas
  • Sobrehype y casos de uso poco relevantes o ineficaces.
  • Información inexacta o desactualizada, con invención de fuentes.
  • Sesgos heredados de datos de entrenamiento.
  • Pérdida de diversidad cultural y lingüística.
  • Desinformación y censura.
  • Brecha digital y acceso desigual.
  • Opacidad, falta de explicabilidad y responsabilidad.
  • Privacidad y seguridad de los datos de usuarios.
  • Propiedad intelectual y derechos de autor, especialmente por el scraping de datos.
  • Falta de consulta a las partes interesadas.
  • Reducción de autonomía humana y dependencia tecnológica.
  • Desplazamiento laboral y explotación de trabajadores precarios.
  • Impacto ambiental por consumo energético y agua en centros de datos.

Además, Incluye 14 preguntas orientadoras (por ejemplo: ¿son los beneficios justificables?, ¿es equitativo el acceso?, ¿se protege la privacidad?, ¿quién es responsable ante errores?, ¿cómo se involucra a la comunidad?). Están concebidas para estructurar debates, talleres o análisis internos

Se presentan escenarios prácticos para ilustrar cómo aplicar estas preguntas en situaciones reales: uso interno por parte del personal, apoyo a la creación de metadatos, elección de proveedores externos, entre otros. Estos ayudan a traducir preguntas abstractas en decisiones tangibles.

Y propone diferentes niveles de acción

La IFLA propone seis niveles de acción:

  1. Desarrollar o licenciar herramientas de IA.
  2. Contribuir a la creación y entrenamiento de modelos en interés público.
  3. Guiar a usuarios en el uso responsable de IA.
  4. Incluir alfabetización en IA dentro de la alfabetización digital.
  5. Asesorar internamente respecto a políticas de IA.
  6. Abogar por un uso ético y regulado de la IA en la sociedad

Desafíos y desigualdades que enfrenta la alfabetización en inteligencia artificial (IA) en el ámbito universitario

Chen, Zhuo; Nathan Kelber; y Ruby MacDougall. “The Divided State of AI in Higher Education.” Ithaka S+R (blog), 9 de junio de 2025. https://sr.ithaka.org/blog/the-divided-state-of-ai-in-higher-education/

El artículo expone cómo la alfabetización en inteligencia artificial en la educación superior está fragmentada entre disciplinas, generaciones y políticas institucionales. Muchas universidades carecen de estrategias coherentes, con recursos distribuidos de forma desigual y enfoques que priorizan al profesorado sobre el estudiantado. Ante esta división, el proyecto “Integrating AI Literacy into the Curricula” busca desarrollar un marco común que unifique criterios y fomente una implementación equitativa.

Se analiza los desafíos y desigualdades que enfrenta la alfabetización en inteligencia artificial (IA) en el ámbito universitario. Señalan que esta alfabetización no sigue un patrón uniforme: mientras algunas instituciones ofrecen programas e iniciativas formales, otras no cuentan con talleres ni formación sistemática. Además, existen marcadas diferencias según el campo académico—las ramas de ciencias y negocios adoptan la IA con mayor rapidez, mientras que las humanidades mantienen una postura más reservada—y según la generación docente, donde el profesorado joven se muestra más receptivo frente al escepticismo del profesorado con mayor trayectoria

Otra división clave es la disparidad entre los enfoques institucionales: no hay una política común sobre qué implica la alfabetización en IA ni cómo integrarla en los planes de estudio. En muchas universidades, los recursos y los programas relacionados con IA están aislados entre bibliotecas, centros de enseñanza e informática, sin una estrategia cohesiva a nivel campus . Esto contrasta con la presión comercial, pues muchos centros tienen acceso a herramientas IA antes incluso de formar al personal o establecer estándares.

El informe destaca también que las formaciones en IA están más orientadas al profesorado que al estudiantado. En algunas universidades, los profesores pueden utilizar IA libremente en su labor, mientras que los estudiantes apenas tienen permiso para hacerlo, y cuando lo tienen, depende del criterio individual del docente. Además, no existen buenas prácticas estandarizadas para guiar su integración en la enseñanza .

Como respuesta, Ithaka S+R ha lanzado el proyecto “Integrating AI Literacy into the Curricula”, que ha convocado a 45 instituciones para abordar estas divisiones colaborativamente. En la reunión inicial (abril de 2025), participantes identificaron las brechas existentes y comenzaron a compartir soluciones, aunque todavía no existe un modelo unificado. El objetivo es construir un marco compartido de alfabetización en IA que supere las diferencias disciplinarias, generacionales y organizativas