Archivo de la categoría: Noticias

Hacia un Archivo Común de Libros para una IA Ética y de Interés Público


Authors Alliance. «Developing a Public-Interest Training Commons of Books.» Authors Alliance, December 5, 2024. https://www.authorsalliance.org/2024/12/05/developing-a-public-interest-training-commons-of-books/.

Este proyecto busca equilibrar el desarrollo de IA con principios éticos y sociales, aprovechando la riqueza cultural de los libros mientras se promueve la equidad en el acceso al conocimiento y en la representación de los datos utilizados.

La Authors Alliance, con el apoyo de la Fundación Mellon, ha lanzado un proyecto para planificar un archivo de libros orientado al interés público en el desarrollo de inteligencia artificial (IA). Northeastern University Library colabora en la coordinación de esta iniciativa.

Los modelos de lenguaje de IA (LLMs) requieren grandes volúmenes de texto para su entrenamiento, y los libros representan un recurso valioso. Sin embargo, el desarrollo de IA hasta ahora ha estado dominado por empresas privadas que priorizan la competencia sin atender suficientemente a la diversidad, la veracidad, el sesgo o el impacto social de sus datos.

El proyecto busca crear un plan para establecer una organización o alianza que gestione un archivo de libros con fines de interés público, impulsado por bibliotecas sin fines de lucro. Este archivo estará diseñado para considerar las perspectivas de autores, editoriales, investigadores y tecnólogos, asegurando que la IA se desarrolle de manera ética e inclusiva.

El proyecto aborda varios desafíos esenciales:

  • Misión y objetivos: Definir metas a corto y largo plazo.
  • Aspectos técnicos y logísticos: Diseñar estrategias distintas a las iniciativas actuales lideradas por bibliotecas.
  • Diversidad del corpus: Garantizar un archivo amplio y diverso que ofrezca alternativas viables a los datos actuales.
  • Gobernanza: Crear estructuras que equilibren los intereses de todos los actores involucrados.
  • Sostenibilidad: Diseñar un modelo de financiación a largo plazo para el mantenimiento y crecimiento del archivo.
  • Legalidad y derechos de autor: Asegurar que los libros se adquieran legalmente y que se respete a autores y titulares de derechos mediante compensaciones y créditos adecuados.
  • Segmentación de usuarios: Reconocer y satisfacer las diferentes necesidades de investigadores sin fines de lucro, nuevas empresas y grandes actores comerciales.

Uso sospechoso no declarado de la inteligencia artificial en la literatura académica

Glynn, Alex. «Suspected Undeclared Use of Artificial Intelligence in the Academic Literature: An Analysis of the Academ-AI Dataset.» arXiv, November 2024. https://arxiv.org/abs/2411.15218.

Desde que las herramientas de inteligencia artificial generativa (IA), como ChatGPT de OpenAI, se hicieron ampliamente disponibles, los investigadores han comenzado a utilizarlas en el proceso de escritura. El consenso de la comunidad editorial académica es que dicho uso debe ser declarado en el artículo publicado. Academ-AI documenta ejemplos de uso sospechoso de IA no declarado en la literatura académica, lo cual se puede discernir principalmente debido a la aparición en los artículos de investigación de un lenguaje característico de los chatbots basados en modelos de lenguaje grande (LLM).

Este análisis de los primeros 500 ejemplos recopilados revela que el problema es generalizado, afectando a revistas y actas de conferencias de editores altamente respetados. La IA no declarada parece aparecer en revistas con métricas de citación más altas y mayores cargos por procesamiento de artículos (APC), precisamente en esas publicaciones que, teóricamente, deberían tener los recursos y la experiencia para evitar tales descuidos. Una pequeña minoría de casos son corregidos después de la publicación, y las correcciones a menudo son insuficientes para rectificar el problema.

Los 500 ejemplos analizados aquí probablemente representen solo una pequeña fracción de la IA no declarada presente en la literatura académica, gran parte de la cual podría ser indetectable. Los editores deben hacer cumplir sus políticas contra el uso no declarado de la IA en los casos detectables; esta es la mejor defensa disponible actualmente para la comunidad editorial académica contra la proliferación de IA no divulgada.

El conjunto de datos utilizado para esta investigación se compuso de fragmentos de 500 documentos publicados: 449 artículos de revistas y 51 ponencias de conferencias. El 93,2% de estos artículos fueron publicados en 2022 o después, mientras que el 6,8% fueron publicados antes de la liberación pública de ChatGPT en noviembre de 2022. Los artículos fueron publicados en 345 revistas diferentes, la mayoría de las cuales (86%) publicó solo uno de los artículos. Las revistas más representadas en el conjunto de datos fueron International Journal of Open Publication and Exploration (18 artículos) y International Research Journal of Modernization in Engineering Technology and Science (11 artículos).

Las ponencias fueron presentadas en 45 conferencias diferentes, con un 91% de las conferencias presentando solo una ponencia. La conferencia más representada fue la International Conference on Electronics, Communication and Aerospace Technology (4 ponencias). Solo el 13,1% de los artículos de revistas fueron publicados en revistas producidas por grandes editores académicos, como Elsevier (5,1%), Springer (2,2%) o MDPI (1,1%). En contraste, la gran mayoría de las ponencias de conferencias (88,2%) fueron publicadas por editores académicos importantes, principalmente IEEE (80,4%). En general, los grandes editores produjeron el 20,8% de los documentos en el conjunto de datos. Todos los editores importantes representados en el conjunto de datos requieren la declaración del uso de IA en sus políticas editoriales, excepto Wolters Kluwer. Solo dos publicaciones de Wolters Kluwer, Medicine y Annals of Medicine & Surgery, aparecen en el conjunto de datos, y ambas requieren la declaración de uso de IA en sus guías para autores.

Un total de 62 artículos (13,8%) fueron publicados en revistas sin un ISSN confirmado o que afirmaban estar registrados con el ISSN de otra revista.

Es imperativo identificar y abordar los casos de IA no declarada que podemos detectar. En tales casos, las revistas y editores deben hacer cumplir sus políticas mediante correcciones o retractaciones, según la gravedad de la violación de políticas. No hacer esto establece un precedente de violaciones de políticas sin abordar, sugiriendo a los autores que la declaración del uso de IA no es necesaria. Por el contrario, un precedente de hacer cumplir estas políticas incentiva la declaración entre los autores descuidados e incluso sin escrúpulos, por el temor de que el uso de IA sea detectable en su caso.

Ética y Derechos humanos para bibliotecas y archivos


López López, Pedro, con la colaboración de Josep Vives i Gracia. Ética y Derechos Humanos para Bibliotecas y Archivos. Madrid: Ediciones del Ministerio de Cultura y Deporte, 2013. ISBN 978-84-88716-50-7 (edición en papel); 978-84-88716-51-4 (edición en CD-ROM).

Texto completo

Este libro, escrito por Pedro López López con la colaboración de Josep Vives i Gracia, explora la relación entre derechos humanos, ética y el papel de bibliotecas y archivos en su promoción y protección. Publicado en 2013, está organizado en dos partes principales: Derechos Humanos y Ética y Deontología. Su objetivo es fomentar una gestión ética y profesional en estas instituciones, abordando temas históricos, legales y prácticos.

636 participantes en Jornada Transfronteriza “Bibliotecas en Comunidad” = “As Bibliotecas na Comunidade”

Ver VIDEOS de la Jornada

La Jornada Transfronteriza #Coopera es más que un evento; es un punto de convergencia para actores clave que trabajan en la construcción de un futuro más conectado y colaborativo. Su capacidad para atraer a una audiencia diversa, tanto geográfica como institucionalmente, la posiciona como un referente en la promoción del trabajo en red y la cooperación internacional.

La Jornada Transfronteriza #Coopera es un espacio clave para fomentar la colaboración internacional, la innovación educativa y el intercambio de experiencias entre instituciones de diversos países. Su enfoque transnacional y su capacidad de atraer a participantes de múltiples regiones reflejan un compromiso con la construcción de redes que trascienden las fronteras geográficas y culturales.

Con una participación destacada de España (275 asistentes), seguida de Argentina (112) y Portugal (63), el evento reafirmó su papel como un puente para la conexión iberoamericana. Países como Ecuador, México, Colombia, Perú y Uruguay también estuvieron representados de manera significativa, lo que pone de manifiesto la relevancia del encuentro como espacio de intercambio para profesionales de diversos contextos. Este alcance geográfico subraya la capacidad de las jornadas para reunir a personas de distintas culturas, favoreciendo un diálogo plural y enriquecedor que potencia el aprendizaje mutuo y la colaboración transnacional.

La marcada preferencia por la modalidad online (89.7%) destaca el impacto de las tecnologías digitales en la organización de eventos en la era postpandemia. La flexibilidad que ofrece esta modalidad permite la participación de asistentes desde lugares remotos, reduciendo las barreras económicas y logísticas. Sin embargo, el componente presencial, aunque menor (10.3%), sigue siendo valioso para fomentar relaciones más cercanas y fortalecer las conexiones interpersonales, especialmente en actividades transfronterizas.

Las universidades y centros educativos desempeñaron un papel destacado en la jornada, liderados por instituciones como la Universidad de Salamanca, la Universidad de La Laguna y otras entidades iberoamericanas. Esto refleja el interés académico en temas relacionados con la cooperación transfronteriza y el fortalecimiento de redes educativas. La alta participación de estas instituciones también subraya la relevancia del evento como espacio de aprendizaje y creación de alianzas estratégicas.

Impacto y oportunidades

El evento constituye una plataforma crucial para abordar desafíos comunes en áreas como la educación, la sostenibilidad, y el desarrollo regional. Además, fomenta el diálogo sobre prácticas colaborativas y modelos innovadores que pueden adaptarse a las necesidades locales de los distintos participantes.

El amplio interés de los asistentes también refleja una oportunidad para el crecimiento del evento en futuras ediciones, explorando nuevas temáticas y ampliando su alcance hacia regiones menos representadas.

Resultados del análisis

1. Distribución por país

  • España lidera la participación con 252 asistentes, seguida por Argentina (112) y Portugal (63) y . Otros países como Ecuador, Colombia y México también están representados, pero con menos participantes.

2. Modalidad de asistencia

  • La mayoría de los participantes prefieren la modalidad Online (548 personas, 89.7%), mientras que solo 63 asistieron presencialmente (10.3%). + 24 ponentes

3. Top 10 entidades representadas

  • Las entidades más representadas incluyen la Universidad de Salamanca con 38 asistentes, seguida de la Universidad de La Laguna (7) y otras universidades y organizaciones.

Observaciones gráficas:

  • Los gráficos muestran una clara predominancia de participantes de España y en modalidad virtual, junto con la concentración de representación institucional en universidades españolas.

Para concluir decir, que él evento fue un éxito tanto en términos de participación como de contenido, ofreciendo nuevas perspectivas sobre cómo las bibliotecas pueden seguir siendo relevantes en un mundo en constante cambio. Más detalles pueden consultarse en Universo Abierto​

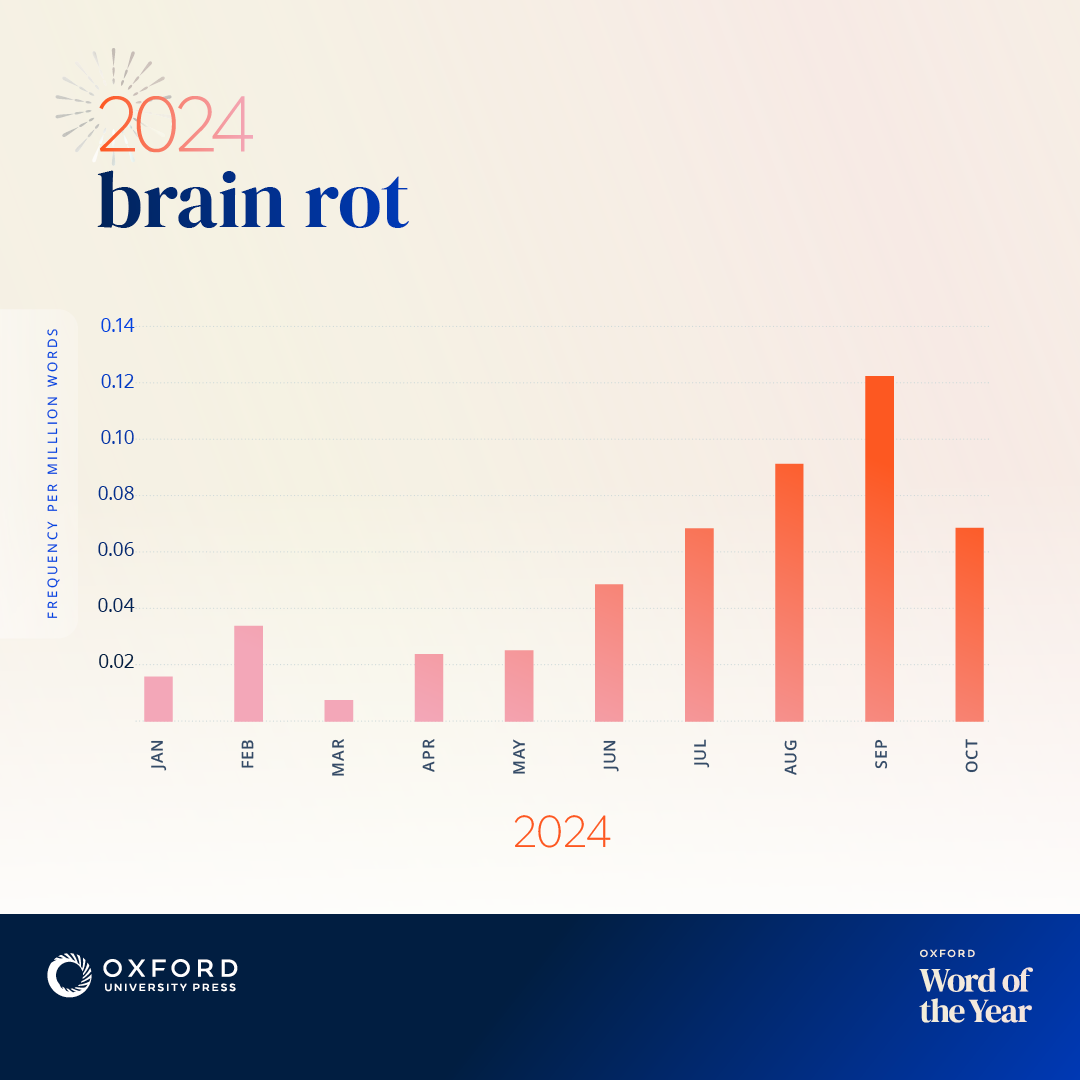
«Brain rot» (deterioro cerebral) elegida como la Palabra del Año 2024 por Oxford University Press

Oxford University Press (OUP) ha anunciado que «brain rot» (traducido como «podredumbre cerebral» o «deterioro mental») ha sido elegido como la Palabra del Año 2024, tras una votación pública en la que participaron más de 37.000 personas de todo el mundo. Este término, seleccionado entre seis candidatos propuestos por los expertos en lenguaje de OUP, refleja las preocupaciones actuales sobre el impacto del consumo excesivo de contenido digital de baja calidad, especialmente en las redes sociales.


«Brain rot» se define como el «supuesto deterioro del estado mental o intelectual de una persona, especialmente visto como resultado del consumo excesivo de material trivial o poco estimulante, ahora particularmente en línea». Este término experimentó un notable aumento del 230% en su frecuencia de uso entre 2023 y 2024, según el análisis de los datos lingüísticos de OUP.

Aunque su origen se remonta a 1854, cuando fue utilizado por el escritor Henry David Thoreau en su obra Walden, el término ha adquirido un nuevo significado en la era digital. En 2024, «brain rot» se consolidó como una forma de describir tanto la causa como el efecto: por un lado, hace referencia al contenido de baja calidad disponible en internet, y por otro, al impacto negativo percibido en la mente individual y en la sociedad. Su popularidad inicial se dio en plataformas como TikTok, especialmente entre las generaciones Z y Alfa, pero pronto se extendió al periodismo y a debates más amplios sobre los efectos nocivos del exceso de consumo digital.

La elección de «brain rot» como Palabra del Año subraya una creciente preocupación global por el efecto de las redes sociales y el contenido digital en nuestra capacidad de concentración, aprendizaje y bienestar mental. En un mundo donde el acceso a información es casi ilimitado, la sobreexposición a contenido trivial ha generado discusiones sobre cómo afecta esto a la salud cognitiva y al tejido social.

Casper Grathwohl, presidente de Oxford Languages, expresó que este proceso de selección ha sido «perspicaz y profundamente conmovedor», destacando el papel activo de los amantes del lenguaje en todo el mundo para elegir una palabra que refleja las conversaciones más importantes del año.

La elección de «brain rot» no solo captura una preocupación actual, sino que también sirve como una llamada a reflexionar sobre cómo usamos las plataformas digitales y el impacto que tienen en nuestras vidas cotidianas y en nuestra sociedad.

Sarah Evil Acoustic y Doctor Pólvora. Viviendo en la era pop 2024/11/29

Sarah Evil Acoustic y Doctor Pólvora.

Viviendo en la era pop 2024/11/29

ESCUCHAR

Descargar

Sarah Evil Acoustic y Doctor Pólvora nos presentan sus nuevas canciones Descripción: Sarah Evil y Jorge Chamorro son dos salmantinos veteranos de la música rock, que colaboran en el dúo Sarah Evil Acoustic, una versión más íntima de la música rok, que actuarán este viernes en el Ágora del DA2. Jorge lidera la banda Doctor Pólvora, un grupo de rock urbano que esta a punto de publicar su nuevo disco. Sarah es también la cantante del grupo de trash punk metal ZAS, que compartirá escenario con Doctor Pólvora en el IV Festival Rock Reunión.

En la nueva era de la información, los medios de comunicación se asocian con bibliotecas públicas

Texas Standard. «In a New Information Age, News Outlets Are Partnering with Public Libraries.» Texas Standard, November 21, 2024. Accessed November 24, 2024. https://www.texasstandard.org/stories/news-library-partnerships-dallas-tx/

El panorama de los medios de comunicación ha experimentado una transformación radical en las últimas décadas, influenciado en gran medida por la omnipresencia de Internet y las redes sociales. Hoy en día, el modo en que las personas consumen información ha cambiado de forma significativa, desplazándose de los medios tradicionales a plataformas digitales. Este cambio ha obligado a los medios de comunicación a reconsiderar cómo y dónde interactúan con su audiencia. Ante estos desafíos, algunas organizaciones de noticias están adoptando un enfoque innovador: asociarse con bibliotecas públicas.

Un ejemplo reciente de esta tendencia ocurrió durante la temporada electoral de este año, cuando The Dallas Morning News aprovechó su colaboración con la Biblioteca Central J. Erik Jonsson de Dallas. Los periodistas del periódico organizaron mesas informativas en parques, campus universitarios y bibliotecas públicas, lo que les permitió conectar directamente con los residentes de la ciudad, fomentar la participación ciudadana y proporcionar información relevante en espacios accesibles.

Este tipo de asociaciones se están extendiendo cada vez más en todo Estados Unidos, con muchas bibliotecas colaborando con medios locales y nacionales. Dallas ha sido un centro importante de estas iniciativas, destacándose como un ejemplo de cómo las bibliotecas y los medios pueden trabajar juntos para abordar los desafíos contemporáneos de la información. La colaboración entre estas dos instituciones tiene como objetivo no solo acercar las noticias a un público más amplio, sino también promover la alfabetización mediática, un tema crucial en la era digital.

Jo Giudice, quien recientemente se retiró como directora de la Biblioteca Pública de Dallas, destacó la importancia de estas asociaciones. Según Giudice, tanto los bibliotecarios como los periodistas comparten un objetivo fundamental: elevar los hechos y enseñar a las personas a distinguir entre la verdad y la desinformación. En un mundo donde la abundancia de información puede ser tanto una ventaja como una desventaja, la alfabetización mediática se ha convertido en una prioridad para ambas profesiones. Esta colaboración tiene un impacto positivo al ofrecer a las comunidades acceso a fuentes confiables de información y habilidades para navegar en un entorno mediático saturado de contenido digital.

Además de su papel en la educación sobre la información, estas asociaciones también permiten que las bibliotecas se mantengan relevantes en la era digital, ofreciendo servicios que van más allá de los tradicionales y ampliando su rol como centros comunitarios de acceso a la información. En este sentido, las bibliotecas públicas se están adaptando a las necesidades contemporáneas de los usuarios, utilizando su infraestructura y recursos para apoyar a los medios en su misión de conectar con el público de manera más efectiva y accesible.

Este enfoque colaborativo también tiene un impacto directo en la comunidad, ya que las bibliotecas se convierten en lugares donde los ciudadanos pueden participar activamente en el proceso informativo, obtener noticias de fuentes confiables y recibir formación sobre cómo identificar noticias falsas y desinformación. A medida que más bibliotecas y medios adoptan este modelo de colaboración, se espera que surjan nuevos proyectos y soluciones innovadoras para abordar los desafíos de la desinformación y la brecha de acceso a información de calidad.

Google Scholar celebra 20 años desde su lanzamiento

«20 Things You Didn’t Know about Google Scholar». 2024. Google. 18 de noviembre de 2024. https://blog.google/outreach-initiatives/education/google-scholar-20-years/.

Google Scholar, la herramienta de búsqueda académica de Google, celebra 20 años desde su lanzamiento el 17 de noviembre de 2004. Desde entonces, se ha convertido en una plataforma esencial para investigadores, estudiantes y académicos, facilitando el acceso a artículos científicos, tesis, libros y otros recursos académicos en una amplia variedad de disciplinas. Este aniversario no solo celebra su longevidad, sino también su impacto significativo en la forma en que se realiza y se comparte la investigación académica en todo el mundo.

El origen de Google Scholar se remonta al deseo de Google de organizar la información del mundo y hacerla accesible para todos. Scholar se diseñó específicamente para satisfacer las necesidades de la comunidad académica, permitiendo a los usuarios buscar literatura científica de manera sencilla y eficiente. Desde su lanzamiento, su objetivo ha sido democratizar el acceso al conocimiento, facilitando que estudiantes y académicos, independientemente de su ubicación geográfica o recursos económicos, puedan acceder a investigaciones de calidad.

Una de las innovaciones más importantes de Google Scholar es su capacidad para ofrecer citas automáticas en diferentes formatos, como APA, MLA o Chicago, lo que simplifica enormemente el trabajo de los investigadores. También incluye herramientas como el índice h y el índice i10, que permiten medir el impacto de un investigador basado en las citas que reciben sus trabajos, lo que ha cambiado significativamente cómo se evalúa la influencia académica. Además, Google Scholar proporciona enlaces a versiones de texto completo de los documentos, cuando están disponibles, y a veces incluye acceso a copias gratuitas alojadas en repositorios institucionales o páginas personales de los autores.

Desde su creación, la base de datos de Google Scholar ha crecido de manera exponencial. Inicialmente, incluía principalmente artículos de revistas científicas, pero con el tiempo ha ampliado su alcance para abarcar capítulos de libros, actas de congresos, patentes y otros documentos académicos. Este crecimiento se ha logrado gracias a la colaboración con editoriales, universidades y bibliotecas, que trabajan con Google para indexar sus contenidos y mejorar su visibilidad en línea.

Google Scholar ha tenido un impacto profundo en la forma en que se realiza la investigación académica. En regiones con menos recursos, donde las suscripciones a revistas científicas suelen ser prohibitivamente caras, ofreciendo una alternativa accesible, permitiendo que investigadores y estudiantes accedan a información clave. Esto ha contribuido a nivelar el campo de juego en la producción y el acceso al conocimiento, algo especialmente relevante en países en desarrollo.

A pesar de sus logros, Google Scholar también enfrenta críticas y desafíos. Algunos expertos han señalado problemas en la calidad de los resultados indexados, como la inclusión de trabajos de baja calidad o predatorios. Además, su modelo de indexación no siempre es completamente transparente, lo que ha generado debates sobre su funcionamiento. Sin embargo, estos retos también destacan la necesidad de seguir innovando en el ámbito de las herramientas académicas digitales.

Con dos décadas de servicio, Google Scholar sigue siendo una herramienta vital para la comunidad académica. Su impacto ha trascendido fronteras y disciplinas, haciendo que la búsqueda y el acceso al conocimiento sean más rápidos, efectivos y democráticos. Este aniversario es un recordatorio de cómo las tecnologías digitales pueden transformar la investigación y la educación, y promete que Google Scholar continuará desempeñando un papel clave en el futuro del conocimiento global.

HarperCollins confirma que tiene un acuerdo para vender las obras de sus autores a una empresa de IA

Cole ·, Samantha. 2024. «HarperCollins Confirms It Has a Deal to Sell Authors’ Work to AI Company». 404 Media. 18 de noviembre de 2024. https://www.404media.co/harpercollins-ai-deal/.

HarperCollins, una de las editoriales más grandes del mundo, ha confirmado un acuerdo con una empresa de tecnología de inteligencia artificial (IA) para permitir el uso limitado de ciertos títulos de no ficción de su catálogo para entrenar modelos de IA. La participación de los autores en este acuerdo es opcional; ellos pueden decidir si aceptan o rechazan la propuesta.

Según un portavoz de HarperCollins, este convenio busca mejorar la calidad y el rendimiento de los modelos de IA y cuenta con restricciones claras para respetar los derechos de los autores. La editorial enfatiza que su objetivo es proteger el valor inherente de las obras de sus autores y garantizar el flujo compartido de ingresos y regalías. Además, destaca su larga tradición de innovación y exploración de nuevos modelos de negocio.

El acuerdo contempla el pago de 2.500$ por título a los autores que opten por participar, una cantidad que no es negociable. Este ofrecimiento ha generado debate, especialmente en relación con el uso de materiales protegidos por derechos de autor en el entrenamiento de modelos de IA.

Daniel Kibblesmith, autor del libro infantil Santa’s Husband, compartió en la red social Bluesky un correo de su agente que describe la propuesta de HarperCollins. En el mensaje, su agente menciona las controversias alrededor del uso de materiales con derechos de autor para entrenar IA, destacando que muchas empresas lo hacen sin reconocer ni compensar a los creadores originales. También se alude al temor de que estos modelos puedan hacer obsoletos a los autores en el futuro.

Kibblesmith criticó la decisión de HarperCollins, calificándola como una búsqueda desesperada de ganancias a corto plazo. Señaló que este desarrollo podría dividir el mercado en dos tipos de lectores: aquellos que buscan una conexión humana auténtica a través de los libros y aquellos que prefieren contenido personalizado y generado por IA, diseñado para evitar cualquier desafío intelectual.

El uso de obras protegidas por derechos de autor para entrenar IA ha sido un tema polémico. Numerosas empresas han sido acusadas de aprovecharse de materiales sin compensar a sus creadores. Este acuerdo de HarperCollins es una de las primeras instancias donde una gran editorial propone explícitamente un trato transparente y compensatorio, aunque limitado, para el uso de este tipo de contenido.

En general, el tema pone de relieve las tensiones entre la innovación tecnológica y la preservación del valor del trabajo creativo humano, planteando preguntas sobre el futuro de los derechos de autor y la sostenibilidad de las profesiones creativas en la era de la IA.

The New York Times exige a Perplexity cesar el uso no autorizado de su contenido para IA

Davis, Wes. «The New York Times Warns AI Search Engine Perplexity to Stop Using Its Content». The Verge, 15 de octubre de 2024. https://www.theverge.com/2024/10/15/24270774/new-york-times-cease-and-desist-letter-perplexity-ai-search-engine.

New York Times ha enviado una carta de cesación y desista a la empresa emergente de motores de búsqueda Perplexity, exigiendo que dejen de utilizar su contenido, según informó The Wall Street Journal el 15 de octubre de 2024.

La demanda se produce en el contexto de una disputa legal más amplia, ya que el Times está demandando a OpenAI y Microsoft por presuntamente usar su contenido sin permiso para entrenar sus modelos de inteligencia artificial. En este caso, el periódico acusa a Perplexity de haber estado utilizando su contenido sin autorización, algo que también había sido señalado previamente por otras empresas como Forbes y Condé Nast.

La carta enviada por el Times, de acuerdo con The Wall Street Journal, incluye el siguiente pasaje:

«Perplexity y sus socios comerciales se han enriquecido injustamente al utilizar, sin autorización, el periodismo expresivo, cuidadosamente redactado, investigado y editado del Times sin licencia.»

El New York Times tiene una política clara que prohíbe el uso de su contenido para entrenar modelos de inteligencia artificial. En este sentido, han bloqueado explícitamente varios rastreadores de IA, incluido el de Perplexity, mediante el archivo robots.txt, que indica a los motores de búsqueda qué URLs pueden indexar.

Por su parte, Perplexity ha respondido a las acusaciones a través de un comunicado de su portavoz, Sara Platnick, en el que afirman no estar «robando» contenido para el entrenamiento de modelos de IA. En cambio, defiende que se dedica a «indexar páginas web y mostrar contenido factual» como citas para informar las respuestas a las preguntas de los usuarios. Además, Perplexity sostiene que «ninguna organización posee los derechos de autor sobre los hechos», argumentando que este principio permite un ecosistema de información abierto y libre, lo que también beneficia a los medios de comunicación al poder informar sobre temas previamente cubiertos por otros.

En respuesta a la carta de cesación, Perplexity tiene plazo hasta el 30 de octubre de 2024 para presentar su respuesta. La empresa, sin embargo, ha intentado suavizar la situación, enfatizando su interés en colaborar con los editores de contenido. Aravind Srinivas, CEO de Perplexity, expresó NYT que la compañía «no tiene interés en ser el antagonista de nadie» y que está dispuesta a trabajar con todos los editores, incluido el New York Times.

Este conflicto ocurre en medio de las crecientes tensiones sobre el uso de contenido protegido por derechos de autor por parte de modelos de IA. Durante el verano, Perplexity ya había sido acusada de plagio, lo que la llevó a cerrar acuerdos con varios editores, ofreciendo ingresos por publicidad y suscripciones gratuitas a socios como Fortune, Time, y The Texas Tribune. Sin embargo, la disputa con el New York Times pone de manifiesto el creciente choque entre las empresas tecnológicas emergentes y los medios de comunicación tradicionales en cuanto al uso y la compensación por su contenido digital.