Archivo de la categoría: Tecnologías de la información

Privacidad de los usuarios de bibliotecas en la era de la inteligencia artificial

Lucie Daignault, Samuel Lim and Catherine Ferri. Library Patron Privacy in the Age of Artificial Intelligence. EveryLibrary Institute, 2026.

Texto completo

El EveryLibrary Institute ha dado a conocer un informe de gran relevancia titulado Library Patron Privacy in the Age of Artificial Intelligence, centrado en uno de los debates más urgentes para las bibliotecas contemporáneas: cómo proteger la privacidad de los usuarios en un contexto marcado por la expansión acelerada de la inteligencia artificial y de los servicios digitales.

Durante décadas, la confidencialidad de los hábitos de lectura, consulta e investigación ha sido uno de los principios fundamentales de las bibliotecas, especialmente en Estados Unidos, donde la defensa de la libertad intelectual ha estado estrechamente vinculada al derecho a la privacidad. Sin embargo, la llegada de nuevas herramientas basadas en IA está poniendo a prueba estos marcos tradicionales, generando interrogantes legales, éticos y tecnológicos que requieren respuestas actualizadas.

El estudio ha sido elaborado por Lucie Daignault, Samuel Lim y Catherine Ferri, integrantes de la Georgetown University Communications and Technology Law Clinic, en colaboración con EveryLibrary Institute. Su principal aportación consiste en ofrecer una revisión exhaustiva de las leyes de privacidad bibliotecaria vigentes en los cincuenta estados de EE. UU. y en el Distrito de Columbia, con el fin de determinar hasta qué punto estas normativas siguen siendo eficaces frente a los desafíos actuales. El informe analiza si las leyes estatales existentes contemplan adecuadamente cuestiones como la recopilación masiva de datos, el almacenamiento prolongado de información personal, la intervención de proveedores externos y el uso de sistemas automatizados capaces de perfilar comportamientos de lectura o búsqueda.

Uno de los aspectos más novedosos del documento es su atención específica a la inteligencia artificial generativa y a las nuevas formas de tratamiento de datos que esta implica. Muchas plataformas digitales utilizadas por bibliotecas incorporan tecnologías desarrolladas por terceros, capaces de registrar consultas, recomendaciones, patrones de navegación o interacciones textuales de los usuarios. Esto plantea un conflicto entre la mejora de servicios mediante herramientas inteligentes y la obligación histórica de las bibliotecas de garantizar anonimato, neutralidad y libertad de acceso a la información. El informe advierte que, sin controles adecuados, podrían abrirse vías de vigilancia indirecta o explotación comercial de datos tradicionalmente protegidos.

Asimismo, el trabajo examina la creciente dependencia de las bibliotecas respecto a proveedores tecnológicos externos. Los sistemas de préstamo digital, bases de datos académicas, plataformas de descubrimiento o asistentes automatizados suelen operar bajo contratos con empresas privadas que gestionan infraestructuras y datos sensibles. El informe invita a revisar cuidadosamente estas relaciones contractuales, reclamando mayor transparencia sobre qué datos se recogen, cómo se almacenan, durante cuánto tiempo se conservan y si pueden reutilizarse para entrenar modelos de inteligencia artificial u otros fines comerciales.

El valor práctico del informe reside también en su enfoque comparativo y aplicado. Al ofrecer un panorama actualizado estado por estado, se convierte en una herramienta útil para bibliotecarios, responsables institucionales, legisladores, investigadores y defensores de los derechos civiles. No se limita a diagnosticar problemas, sino que pretende impulsar conversaciones más profundas entre los sectores bibliotecario, jurídico y tecnológico. En este sentido, propone pensar la privacidad no como un obstáculo para la innovación, sino como un elemento esencial del diseño de cualquier servicio digital bibliotecario.

En última instancia, el documento subraya que la rápida evolución de la inteligencia artificial obliga a redefinir el papel de las bibliotecas como instituciones públicas de confianza en una sociedad gobernada cada vez más por datos. Si históricamente las bibliotecas han protegido la libertad de leer sin vigilancia, hoy deben extender esa misión al entorno digital. La cuestión no es solo tecnológica, sino democrática: preservar espacios donde las personas puedan informarse, aprender e investigar sin temor a ser monitorizadas o perfiladas. Por ello, este informe se perfila como una referencia clave para el futuro de la ética bibliotecaria y de la gobernanza de la IA.
Guía de evaluación de sistemas de IA en entornos bibliotecarios

Cox, Andrew, y Maria De Brasdefer. IFLA Entry Point to Libraries and AI. International Federation of Library Associations and Institutions (IFLA), 2025. https://repository.ifla.org/items/f197f327-dc49-4743-bb57-0a373505da8b

Entry Point for Libraries and AI

Licensing an AI service from a publisher

La Inteligencia Artificial (IA) ofrece un gran potencial para apoyar los valores fundamentales de las bibliotecas, como el acceso equitativo a la información y la creación de conocimiento. Sin embargo, también es una tecnología controvertida, cuyos avances actuales suscitan inquietudes éticas y sociales. Las bibliotecas desempeñan un papel clave en la promoción de usos responsables, inclusivos y sostenibles de la IA. Sus valores —libertad de expresión, privacidad, transparencia y rendición de cuentas— proporcionan una perspectiva ética para interactuar con las herramientas y prácticas de la IA. Este documento define la IA en un sentido amplio y ofrece un conjunto práctico de preguntas para la reflexión que ayudan a los profesionales de las bibliotecas a evaluar las oportunidades y los riesgos.

El texto plantea un escenario de reflexión sobre la incorporación de herramientas de inteligencia artificial en los servicios de bibliotecas, concretamente en el caso de la posible licitación de un sistema de búsqueda potenciado por IA ofrecido por una editorial científica. Este sistema promete mejorar significativamente la recuperación de información mediante resúmenes automáticos de publicaciones, lo que obliga a los profesionales de la biblioteca a evaluar críticamente su pertinencia, utilidad y riesgos antes de su adopción.

Para ello, se propone la creación de un equipo interdisciplinar formado por especialistas en sistemas bibliotecarios, biblioteconomía, alfabetización informacional y derechos de autor. Este grupo debe elaborar una lista de preguntas clave para analizar la herramienta desde múltiples perspectivas: ética, funcionalidad, impacto institucional, fiabilidad, transparencia y adecuación a las necesidades reales de los usuarios. El objetivo no es solo valorar la innovación tecnológica, sino determinar si realmente aporta beneficios significativos frente a otras soluciones existentes y si su coste está justificado dentro de las prioridades de la biblioteca.

El documento se estructura a partir de un marco de 14 preguntas que sirven como guía de evaluación de sistemas de IA en entornos bibliotecarios. Estas cuestiones abordan aspectos como la calidad y precisión de la información generada por la IA, los posibles sesgos, la protección de la diversidad cultural y lingüística, la equidad en el acceso, la privacidad de los datos de los usuarios y la transparencia del funcionamiento del sistema. También se examina quién es responsable de los posibles errores del sistema y cómo se comunican sus limitaciones a los usuarios.

Asimismo, se subraya la importancia de garantizar que los datos utilizados por la IA no provengan de fuentes obtenidas de manera ilegítima y que se respeten los derechos de autor y la soberanía de los datos culturales. Otro eje central es la necesidad de mantener la agencia del usuario, es decir, que las personas puedan seguir controlando su interacción con la tecnología sin que esta sustituya sus habilidades críticas o de aprendizaje.

Las 14 preguntas funcionan como un marco de evaluación crítica para que las bibliotecas analicen la incorporación de sistemas de inteligencia artificial, especialmente en servicios de información y descubrimiento. No son un checklist técnico cerrado, sino una guía amplia que permite valorar tanto el impacto funcional como las implicaciones éticas, sociales y organizativas de estas herramientas.

  1. Valor y pertinencia del servicio. La pregunta inicial obliga a la biblioteca a identificar qué tipo de beneficio real aporta la IA en términos de acceso al conocimiento y creación de información. No se trata solo de si la herramienta es innovadora, sino de si mejora de forma significativa la experiencia del usuario frente a alternativas más simples o económicas. Aquí se introduce también el concepto de “coste de oportunidad”: invertir en IA implica renunciar a otros posibles servicios o mejoras.

2, Calidad de la información generada por la IA, especialmente su precisión, actualización e imparcialidad. En entornos bibliotecarios esto es crucial, ya que los sistemas de IA pueden generar resúmenes o síntesis que parecen fiables pero contienen errores, sesgos o simplificaciones. Además, se plantea la necesidad de monitorización continua, ya que estos sistemas pueden cambiar su rendimiento con el tiempo.

3. Sesgos . Se evalúa si la IA reproduce estereotipos o excluye perspectivas culturales y lingüísticas. Esto es especialmente relevante en bibliotecas, cuyo objetivo tradicional es garantizar el acceso equitativo a la información.

4. Diversidad del conocimiento. También se analiza si el sistema favorece únicamente contenido en inglés o si integra fuentes multilingües y diversas.

5. Mal uso del sistema, especialmente en relación con la desinformación o la censura. Aunque menos desarrollada en el texto, apunta a un problema creciente: la posibilidad de que herramientas avanzadas de IA sean utilizadas para manipular o distorsionar información académica o científica.

6. Equidad y accesibilidad, considerando si todos los usuarios pueden beneficiarse del sistema en igualdad de condiciones. Aquí se incluyen aspectos como la accesibilidad digital (cumplimiento de estándares como WCAG), la brecha tecnológica y la posible exclusión de determinados colectivos.

7. Transparencia, uno de los más complejos en IA. Se analiza hasta qué punto el usuario entiende qué está haciendo el sistema, cómo genera los resultados y cuáles son sus límites. También se plantea la cuestión de la responsabilidad: quién responde cuando la IA comete errores, la empresa, la biblioteca o el usuario.

8. Privacidad y gestión de datos, un tema crítico en entornos académicos. Se evalúa cómo se recogen, almacenan y utilizan los datos de los usuarios, incluyendo sus consultas, patrones de búsqueda y posibles datos personales, así como el cumplimiento de normativas como el GDPR.

9. Legalidad y ética de los datos utilizados para entrenar la IA, así como en el respeto a los derechos de autor. También introduce una preocupación emergente: la carga que la IA puede generar sobre repositorios abiertos y sistemas de acceso libre.

10. Participación social y la soberanía de los datos, es decir, si las comunidades afectadas han sido tenidas en cuenta en el desarrollo del sistema y si mantienen control sobre su información cultural.

11. Agencia del usuario y el impacto en el aprendizaje. Se analiza si la IA fortalece las competencias del usuario o si, por el contrario, fomenta la dependencia y la pérdida de habilidades críticas. También se considera la necesidad de formación para un uso responsable.

12. Empleo y la estructura laboral, tanto en bibliotecas como en el ecosistema editorial y tecnológico. Se plantea si la IA sustituye funciones humanas o si reconfigura los roles profesionales.

13. Impacto ambiental, un aspecto cada vez más relevante. El uso de modelos de IA implica consumo energético, infraestructura de servidores y uso de agua, lo que obliga a considerar la sostenibilidad del servicio en su ciclo completo.

14. Modelo de negocio y la gobernanza del proveedor, es decir, quién desarrolla la herramienta, bajo qué principios opera y si su estrategia es sostenible y alineada con valores públicos. También se abre la reflexión sobre posibles vínculos con intereses comerciales o incluso militares.

En conjunto, estas 14 preguntas no buscan una respuesta única, sino fomentar una evaluación crítica y multidimensional de la inteligencia artificial en bibliotecas, equilibrando innovación tecnológica con responsabilidad ética, social y profesional.

El texto también amplía la reflexión hacia dimensiones sociales más amplias, como el impacto laboral de estas tecnologías, su huella ambiental y el modelo de negocio de las empresas proveedoras. En conjunto, se propone una evaluación integral que no se limite a lo técnico, sino que integre criterios éticos, educativos, sociales y sostenibles, con el fin de orientar la toma de decisiones en las bibliotecas ante la creciente incorporación de la inteligencia artificial.

Uno de cada 277 artículos indexados en PubMed en 2026 muestra referencias fabricadas por una IA

Retraction Watch. “One in 277 PubMed-indexed Papers in 2026 Shows Fabricated References, Says Analysis.” Retraction Watch, 7 de mayo de 2026. https://retractionwatch.com/2026/05/07/one-in-277-pubmed-indexed-papers-in-2026-shows-fabricated-references-says-analysis/

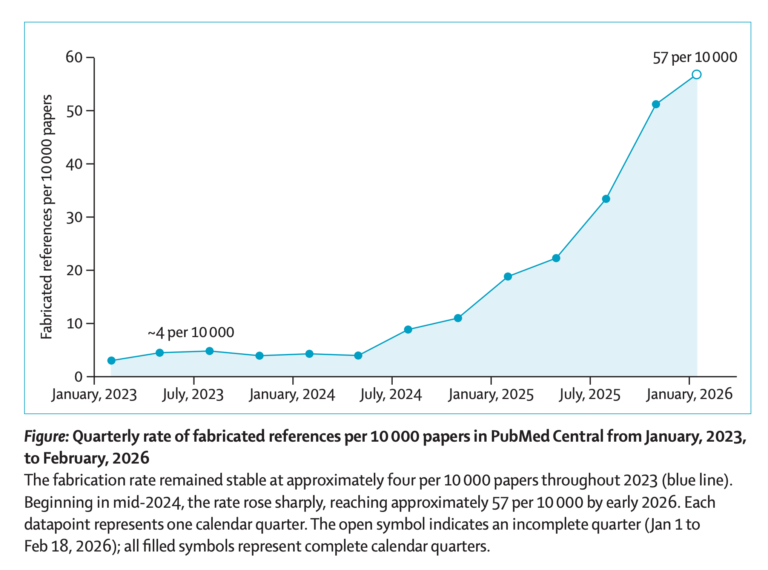
Un análisis reciente difundido por Retraction Watch advierte de un crecimiento muy acusado de las referencias bibliográficas falsas dentro de la literatura biomédica indexada en PubMed. El estudio, presentado en forma de carta en The Lancet, examinó cerca de 2,5 millones de artículos científicos y concluyó que las citas inventadas se han multiplicado por doce en apenas dos años.

Los investigadores detectaron que aproximadamente uno de cada 277 artículos publicados en las primeras siete semanas de 2026 incluía al menos una referencia a un trabajo inexistente. La comparación histórica muestra una escalada preocupante: en 2025 la proporción era de uno entre 458, mientras que en 2023 era de uno entre 2.828. Esto sugiere que el fenómeno no es marginal, sino creciente y sistemático.

El equipo estuvo liderado por Maxim Topaz, del Data Science Institute de la Universidad de Columbia. Para separar errores tipográficos o abreviaturas irregulares de verdaderas invenciones bibliográficas, los autores emplearon herramientas de inteligencia artificial capaces de contrastar títulos y registros reales. Esto permitió identificar con mayor precisión qué citas eran simplemente incorrectas y cuáles correspondían a documentos inexistentes.

Según el informe, el aumento más brusco comenzó a mediados de 2024, coincidiendo con la expansión masiva de herramientas de escritura asistida por IA generativa. El artículo relaciona este crecimiento con el uso inadecuado de modelos de lenguaje capaces de producir referencias aparentemente verosímiles, aunque inexistentes, si no se supervisan correctamente.

Las implicaciones son profundas para la comunicación científica. Las referencias falsas contaminan revisiones bibliográficas, dificultan la verificación de fuentes y erosionan la confianza en el sistema académico. El caso refuerza la necesidad de controles editoriales más estrictos, verificadores automáticos de citas y formación ética en el uso de IA para la redacción científica.

Opiniones del profesorado sobre la IA

The Chronicle of Higher Education. “Faculty Views on AI.” The Chronicle of Higher Education, consultado el 7 de mayo de 2026. The Chronicle of Higher Education

Texto completo

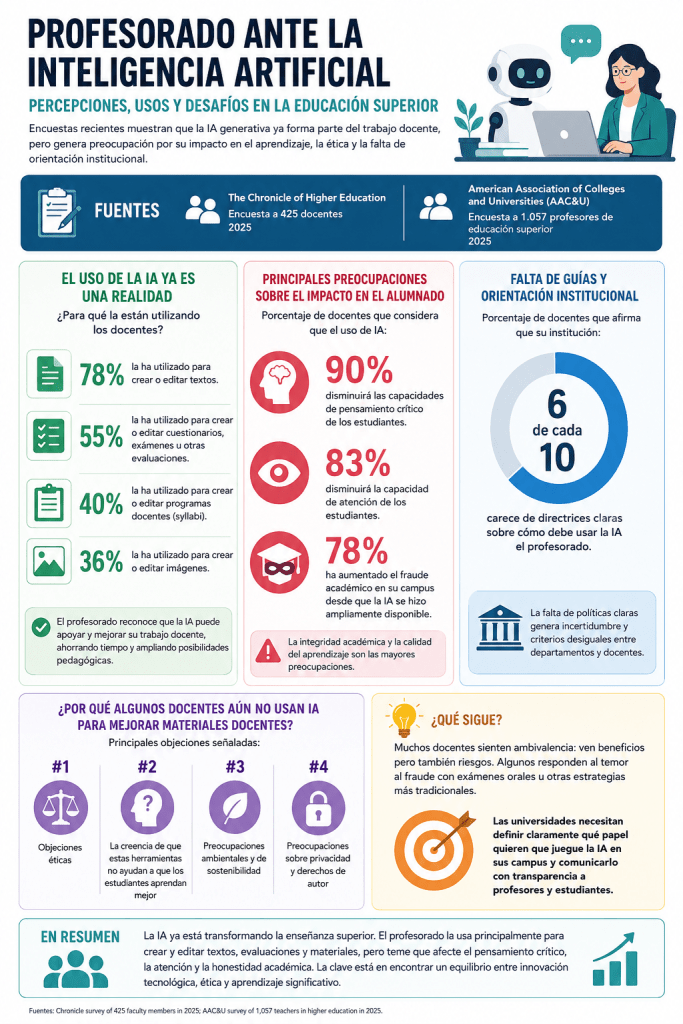
El informe presenta un panorama claro: la IA ya está transformando la enseñanza superior, pero su adopción está marcada por la tensión entre utilidad práctica y riesgo pedagógico. Los docentes valoran su capacidad para ahorrar tiempo, generar materiales y apoyar tareas rutinarias, pero temen que debilite el esfuerzo intelectual, favorezca el engaño y erosione competencias fundamentales. La conclusión implícita es que el problema no es solo tecnológico, sino estratégico: las universidades deberán decidir si la IA será un simple atajo operativo o una herramienta integrada críticamente dentro de un nuevo modelo educativo.

El informe Faculty Views on AI refleja una posición profundamente ambivalente del profesorado universitario ante la inteligencia artificial generativa. Por un lado, una mayoría reconoce que estas herramientas ya están siendo útiles para mejorar ciertos aspectos de la docencia; por otro, existe una preocupación muy fuerte por su impacto negativo en el aprendizaje, la ética académica y la falta de regulación institucional. El estudio combina datos de una encuesta de The Chronicle of Higher Education a 425 docentes en 2025 y otra de la American Association of Colleges and Universities (AAC&U) a 1.057 profesores de educación superior en 2025, lo que permite observar tendencias consolidadas en el ámbito universitario.

Uno de los datos más significativos es que el profesorado ya está incorporando la IA a su trabajo cotidiano. El 78 % afirma haber utilizado herramientas de IA para crear o editar textos, lo que indica que estas aplicaciones se están convirtiendo en asistentes habituales para redactar materiales, instrucciones o contenidos académicos. Además, el 55 % las ha empleado para crear o revisar cuestionarios, exámenes u otras evaluaciones, mientras que el 40 % dice haberlas usado para elaborar o modificar programas docentes (syllabi). También el 36 % las ha utilizado para crear o editar imágenes, señal de que la IA comienza a desempeñar un papel relevante en la producción de recursos visuales para las clases. Estos porcentajes muestran que, lejos de ser una novedad marginal, la IA ya forma parte de las prácticas docentes en muchas instituciones.

Sin embargo, junto a este uso creciente aparecen temores muy marcados sobre sus consecuencias educativas. El 90 % del profesorado considera que el uso de IA reducirá las capacidades de pensamiento crítico del alumnado, lo que revela una inquietud central: que los estudiantes deleguen procesos intelectuales complejos en la máquina y pierdan autonomía analítica. Asimismo, el 83 % cree que la IA disminuirá la capacidad de atención, reforzando la idea de que el acceso inmediato a respuestas puede fomentar hábitos de concentración superficial. Otro dato especialmente revelador es que el 78 % sostiene que el fraude académico o las trampas en el campus han aumentado desde que la IA se popularizó, lo que sitúa la integridad académica como una de las grandes preocupaciones actuales.

A estos temores se suma un problema institucional importante: la ausencia de normas claras. Más de seis de cada diez profesores afirman que sus universidades carecen de directrices claras sobre cómo debe usarse la IA por parte del profesorado. Esto genera incertidumbre y respuestas desiguales entre departamentos o facultades. En muchos casos, cada docente decide por su cuenta si la permite, la restringe o la integra, lo que produce incoherencia pedagógica y desconcierto entre los estudiantes. El informe subraya que las universidades necesitan definir con mayor claridad qué papel desean otorgar a estas tecnologías y comunicarlo de forma transparente a toda la comunidad académica.

Entre quienes todavía no utilizan IA para mejorar materiales docentes, las razones principales también resultan reveladoras. La objeción más citada son los problemas éticos, seguida de las dudas sobre si realmente ayuda a aprender mejor, las preocupaciones medioambientales y de sostenibilidad, y finalmente los temores relacionados con privacidad y derechos de autor. Esto demuestra que la resistencia no se debe únicamente a desconocimiento tecnológico, sino también a debates legítimos sobre valores, impacto social y calidad educativa.

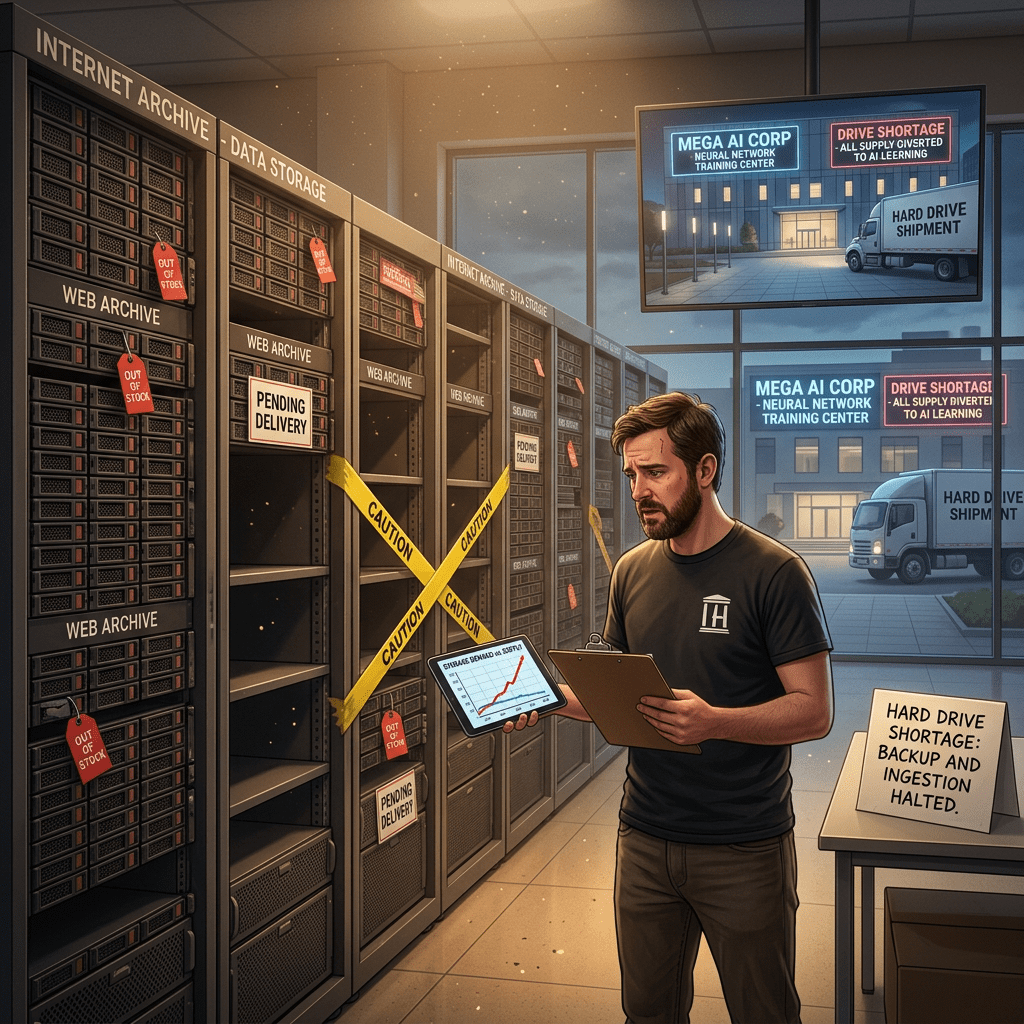
La escasez de discos duros para IA está haciendo que archivar Internet sea más caro y difícil.

Technician in data storage room with empty racks and out-of-stock signs showing hard drive shortage
A technician monitors critically low hard drive supplies affecting AI data storage and backup.

Culpepper, Sophie. “The AI Hard Drive Shortage Is Making It More Expensive and Harder to Archive the Internet.” Nieman Journalism Lab, 5 de mayo de 2026. https://www.niemanlab.org/reading/the-ai-hard-drive-shortage-is-making-it-more-expensive-and-harder-to-archive-the-internet/

Se recoge una investigación original de 404 Media, analiza una consecuencia poco visible del auge de la inteligencia artificial: la creciente escasez y encarecimiento de discos duros y sistemas de almacenamiento. La expansión de centros de datos dedicados a IA está absorbiendo enormes cantidades de hardware, lo que reduce la disponibilidad para otros sectores y eleva los precios. Esta situación afecta especialmente a instituciones cuya misión depende de almacenar grandes volúmenes de información, como archivos digitales, universidades, Wikipedia o coleccionistas de datos.

Uno de los principales perjudicados es Internet Archive, organización responsable de la Wayback Machine. Su fundador, Brewster Kahle, explicó que los discos de alta capacidad que suelen utilizar —de 28 a 30 TB— están agotados o se venden a precios muy elevados. La institución incorpora más de 100 terabytes diarios de nuevos materiales y mantiene más de 210 petabytes archivados, por lo que necesita renovar constantemente infraestructura. El incremento de costes supone una presión directa sobre su sostenibilidad financiera y operativa.

El problema también alcanza a la Wikimedia Foundation, que gestiona Wikipedia y otros proyectos abiertos. La fundación reconoce aumentos en memoria, discos y plazos de entrega de servidores, lo que obliga a replantear inversiones y extender la vida útil del equipamiento existente. Para organizaciones sin ánimo de lucro, estos cambios tienen un impacto especialmente grave, ya que cada decisión tecnológica compite con recursos destinados a contenidos, comunidad o desarrollo.

El reportaje señala además que varios fabricantes están priorizando a clientes corporativos vinculados a centros de datos. Western Digital habría comprometido gran parte de su inventario de 2026 con grandes compradores empresariales, mientras Micron decidió abandonar parte del mercado de consumo para concentrarse en segmentos más rentables relacionados con IA. Esto significa que usuarios comunes, pequeñas instituciones y archivistas independientes compiten en desventaja frente a gigantes tecnológicos con gran capacidad de compra.

Las comunidades de archivistas y usuarios especializados reflejan esta preocupación. En foros como Reddit, muchos participantes afirman haber detenido proyectos de respaldo o archivo debido a los precios disparados, mientras otros recurren a unidades usadas, discos antiguos o estrategias improvisadas de almacenamiento. Algunos incluso sugieren volver a tecnologías como cintas LTO, aunque estas presentan problemas de acceso rápido y latencia para servicios públicos en línea.

Más allá del coste económico, el artículo plantea una cuestión de fondo: la misma industria de IA que consume enormes cantidades de datos para entrenar modelos está dificultando materialmente la preservación de la memoria digital. Archivar internet requiere capacidad de almacenamiento constante, y si esa capacidad se vuelve inaccesible, parte del patrimonio digital contemporáneo corre riesgo de perderse. La paradoja es evidente: tecnologías que dependen del pasado digital pueden contribuir a borrar la posibilidad de conservarlo.

Library Technology Guides publica el Informe sobre sistemas bibliotecarios de 2026

Breeding, Marshall. “2026 Library Systems Briefing.” American Libraries Magazine, 5 de mayo de 2026. https://americanlibrariesmagazine.org/2026/05/05/2026-library-systems-briefing/

El Informe sobre sistemas bibliotecarios de 2026 muestra a unas bibliotecas inmersas en una transformación profunda. El desafío ya no consiste únicamente en informatizar procesos, sino en construir infraestructuras flexibles, seguras e inteligentes capaces de responder a nuevas formas de acceso al conocimiento. La tecnología se convierte así en una pieza estratégica para garantizar la relevancia futura de las bibliotecas en un entorno digital cada vez más exigente.

Library Technology Guides ha publicado el Informe sobre sistemas bibliotecarios de 2026, una de las referencias más relevantes para conocer la evolución tecnológica del sector bibliotecario internacional. El documento ofrece una panorámica detallada del mercado de software y plataformas utilizadas por bibliotecas públicas, universitarias, escolares y especializadas, analizando tendencias, movimientos empresariales, implantaciones y prioridades estratégicas. Más que un simple catálogo de productos, el informe actúa como termómetro del momento que atraviesan las bibliotecas en su proceso de transformación digital.

Uno de los aspectos centrales del informe es la constatación de que las bibliotecas continúan avanzando hacia entornos basados en la nube. Cada vez más instituciones sustituyen antiguos sistemas instalados en servidores locales por plataformas SaaS (Software as a Service), gestionadas por proveedores externos. Esta transición responde a varias razones: reducción de costes de mantenimiento, actualizaciones automáticas, mayor escalabilidad y mejora de la seguridad. Para muchas organizaciones, mantener infraestructuras propias resulta ya complejo y costoso, especialmente en un contexto de presupuestos ajustados y escasez de personal técnico especializado.

El informe también destaca la creciente influencia de la inteligencia artificial en el ecosistema bibliotecario. Los nuevos sistemas comienzan a incorporar herramientas de automatización para catalogación, generación de metadatos, análisis de colecciones, asistentes virtuales y mejora de los sistemas de descubrimiento. La IA se presenta como una oportunidad para aumentar la eficiencia operativa y mejorar la experiencia de usuario, aunque también surgen interrogantes relacionados con la transparencia algorítmica, la privacidad de los datos y la necesidad de supervisión profesional. Las bibliotecas valoran estas innovaciones, pero buscan aplicarlas con prudencia y criterios éticos.

Otro eje importante es la evolución de los sistemas integrados de gestión bibliotecaria (ILS) hacia plataformas de servicios bibliotecarios más amplias. Ya no basta con gestionar préstamos, catalogación o adquisiciones de manera aislada. Las bibliotecas necesitan soluciones capaces de integrar recursos impresos, colecciones electrónicas, repositorios institucionales, analíticas de uso, autenticación remota y servicios móviles. El informe muestra que la tendencia dominante es hacia ecosistemas unificados, donde diferentes módulos se comunican entre sí y permiten una administración más eficiente.

En el plano empresarial, el estudio refleja un mercado concentrado en grandes proveedores internacionales, pero con presencia significativa de proyectos de código abierto. Empresas consolidadas como Ex Libris, OCLC, EBSCO o Innovative mantienen posiciones fuertes, especialmente en grandes redes y universidades. Paralelamente, alternativas como Koha, Evergreen o FOLIO siguen creciendo entre instituciones que buscan flexibilidad, independencia tecnológica y control sobre sus desarrollos. Esto demuestra que el mercado no está cerrado y que existen modelos diversos según tamaño, presupuesto y estrategia institucional.

La experiencia del usuario aparece como una prioridad creciente. Los catálogos tradicionales resultan insuficientes frente a los estándares de usabilidad impuestos por buscadores y plataformas comerciales. Por ello, las bibliotecas demandan interfaces más intuitivas, búsquedas inteligentes, recomendaciones personalizadas, diseño adaptado a móviles y acceso simplificado a contenidos digitales. El informe subraya que el éxito de un sistema ya no depende solo de sus funciones internas, sino de la calidad de la interacción que ofrece al público.

Asimismo, el documento señala la importancia de la interoperabilidad y de los estándares abiertos. Las bibliotecas trabajan con múltiples herramientas simultáneamente —repositorios, plataformas de préstamo digital, gestores de aprendizaje, bases de datos académicas o sistemas de autenticación—, por lo que necesitan soluciones capaces de integrarse sin fricciones. Los proveedores que facilitan APIs robustas y compatibilidad con estándares internacionales parten con ventaja en las decisiones de contratación.

Los modelos de IA más inteligentes en 2026

Voronoi. “Ranked: The Smartest AI Models in 2026.” Voronoi, 25 de abril de 2026. https://www.voronoiapp.com/technology/Ranked-The-Smartest-AI-Models-in-2026-8123

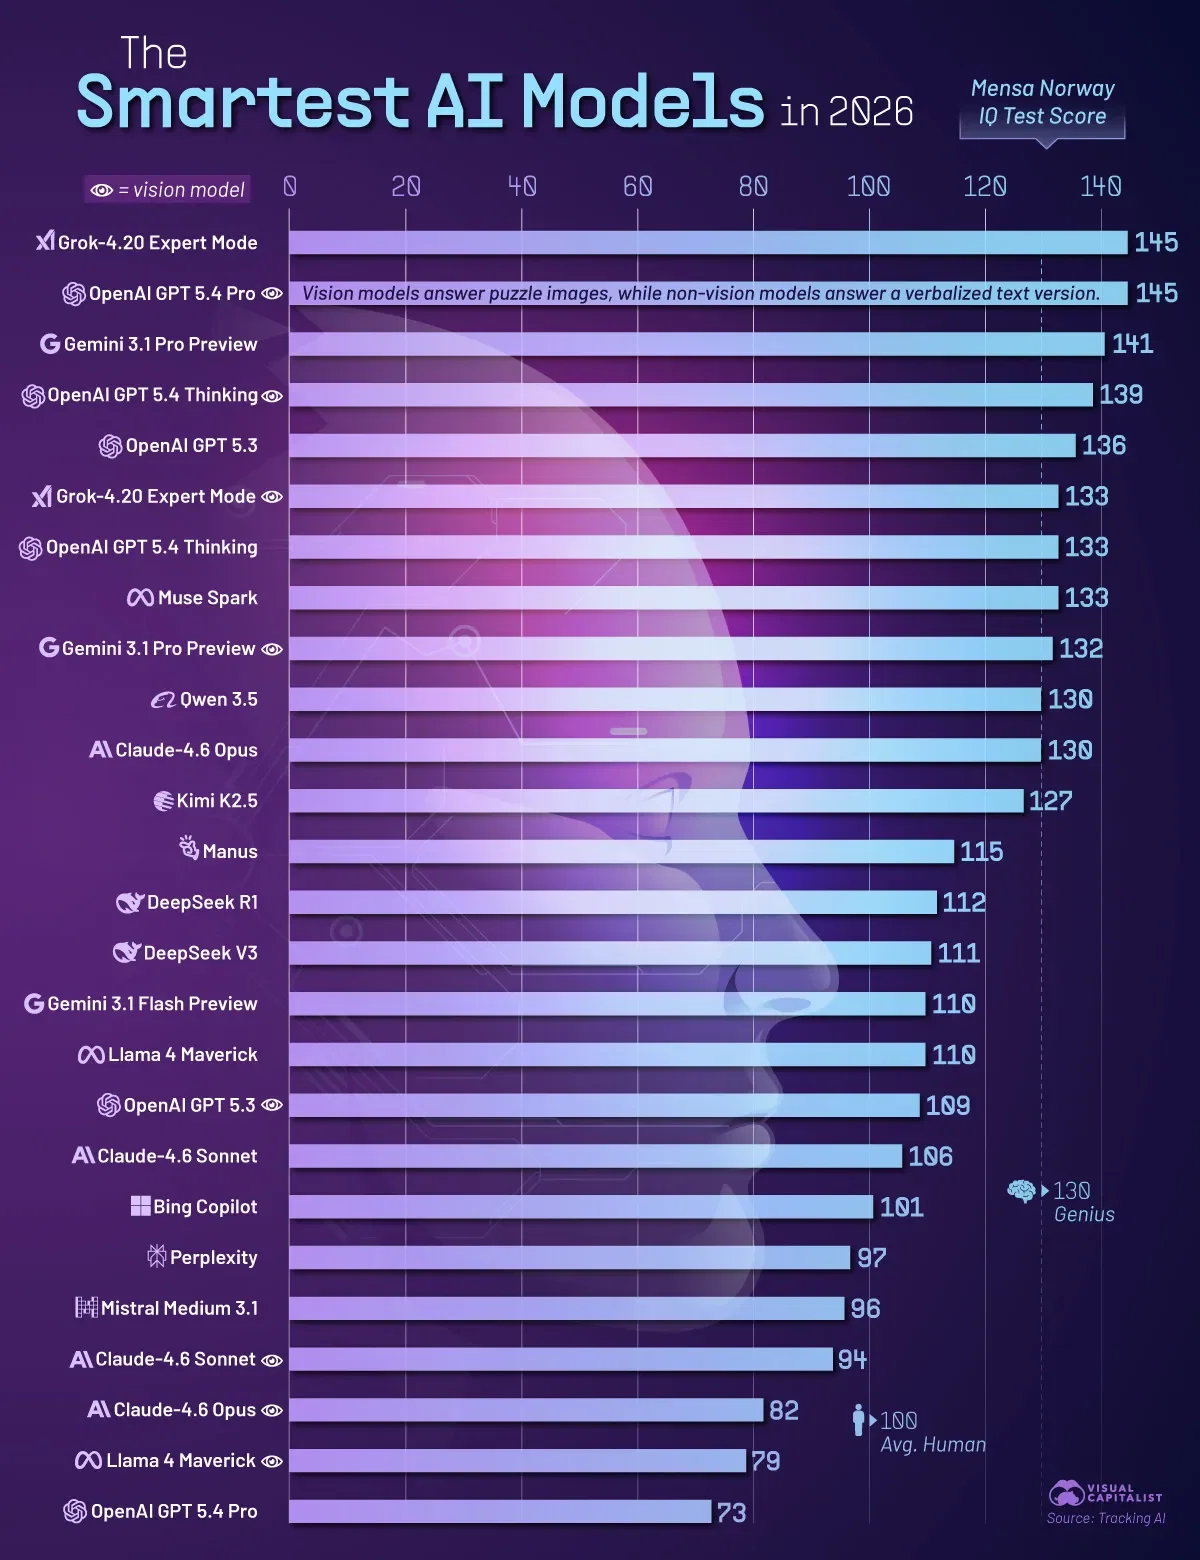
La tabla revela una realidad clara: en 2026 ya no existe un líder indiscutible. La ventaja entre los mejores modelos es mínima, la competencia es global y la inteligencia artificial entra en una fase de madurez donde importarán tanto la integración, el precio y la confianza como la potencia bruta. La “guerra de benchmarks” continúa, pero el mercado probablemente se decidirá por ecosistemas completos más que por unos pocos puntos de diferencia.

El artículo de Voronoi presenta una clasificación de los modelos de inteligencia artificial considerados más avanzados de 2026, utilizando como base los resultados del benchmark de Mensa Norway elaborado por TrackingAI. Lo primero que destaca el informe es que la competencia entre los líderes del sector se ha estrechado enormemente. A diferencia de años anteriores, donde uno o dos modelos dominaban con claridad, en 2026 las puntuaciones se concentran en la parte alta de la tabla, con diferencias mínimas entre los primeros puestos. Esto indica que la industria ha alcanzado una fase de madurez en la que varias compañías han logrado niveles similares de rendimiento avanzado.

En la cima del ranking aparecen empatados Grok-4.20 Expert Mode y OpenAI GPT 5.4 Pro (Vision), ambos con una puntuación de 145. Este empate refleja no solo la capacidad técnica de ambos sistemas, sino también la diversificación de enfoques dentro del mercado de IA. Grok, desarrollado por xAI, ha apostado por una integración fuerte con información en tiempo real y un estilo de respuesta más directo, mientras que GPT 5.4 Pro incorpora una sólida capacidad multimodal, especialmente en visión artificial, razonamiento y productividad profesional. Que ambos compartan la primera posición simboliza que no existe ya un único camino hacia la excelencia algorítmica.

Otro aspecto relevante del informe es la comparación histórica con 2025. Según los datos citados, el modelo más destacado del año anterior fue OpenAI o3, con una puntuación de 135, mientras que GPT-4o Vision apenas alcanzó 63. El salto hasta 145 puntos en solo un año evidencia la velocidad vertiginosa del progreso en IA. En términos prácticos, significa mejoras drásticas en razonamiento complejo, comprensión multimodal, precisión y adaptabilidad a tareas especializadas. También confirma que los benchmarks existentes se quedan obsoletos cada vez más rápido, algo que ya señalan otros estudios como el AI Index de Stanford.

El ranking también sugiere una creciente pluralidad geopolítica en la innovación tecnológica. Ya no son únicamente OpenAI o Anthropic quienes marcan el paso. Empresas como xAI, Google, Moonshot AI o nuevos laboratorios emergentes participan activamente en la carrera por liderar la inteligencia artificial generalista. Esto apunta a una descentralización del poder tecnológico y a un ecosistema más competitivo, donde la innovación depende tanto del talento científico como del acceso a datos, chips y capital.

Desde una perspectiva económica y social, esta evolución tiene profundas implicaciones. La cercanía entre modelos significa que la ventaja competitiva puede desplazarse desde la inteligencia “bruta” hacia otros factores: precio, integración con herramientas empresariales, privacidad, velocidad de respuesta, consumo energético o facilidad de uso. En otras palabras, la próxima fase del mercado podría decidirse menos por quién tiene el modelo “más inteligente” y más por quién ofrece el ecosistema más útil y sostenible para usuarios y organizaciones.

El artículo retrata un momento decisivo: 2026 no es solo el año de los modelos más potentes, sino también el año en que la supremacía tecnológica deja de estar concentrada en un solo actor. La inteligencia artificial entra así en una etapa de competencia madura, multipolar y extremadamente dinámica, donde pequeñas mejoras técnicas pueden traducirse en enormes consecuencias económicas y estratégicas.

Deepfakes al asalto de tu cuenta bancaria: la nueva frontera del fraude con imágenes

The Atlantic. “Deepfakes Are Coming for Your Bank Account.” The Atlantic, mayo de 2026. https://www.theatlantic.com/technology/2026/05/chatgpt-images-deepfakes-fraud/687023/

El artículo analiza cómo los nuevos modelos de generación de imágenes mediante inteligencia artificial están transformando el fraude digital. Según The Atlantic, la amenaza ya no se limita a los tradicionales deepfakes de celebridades o líderes políticos, sino que se desplaza hacia falsificaciones mucho más cotidianas y peligrosas: alertas bancarias falsas, transferencias simuladas, documentos médicos, recetas, identificaciones oficiales, facturas o capturas de pantalla aparentemente auténticas. Estas imágenes resultan especialmente convincentes porque las herramientas actuales han mejorado notablemente en la reproducción de texto legible y diseño visual realista.

El reportaje pone el foco en la facilidad con la que un usuario puede generar material fraudulento. El autor explica que logró producir más de cien imágenes engañosas con poco esfuerzo, demostrando que la barrera técnica para cometer este tipo de delitos se ha reducido drásticamente. Antes, elaborar falsificaciones sofisticadas requería conocimientos avanzados de edición gráfica; ahora basta con introducir instrucciones en lenguaje natural. Esto democratiza el fraude y multiplica los riesgos para particulares, empresas e instituciones.

Uno de los aspectos más preocupantes es el uso de estas imágenes en estafas personalizadas. Una persona podría recibir un supuesto recibo de Uber, una alerta de Chase Bank o una confirmación de transferencia inexistente acompañada de un enlace malicioso. Al tratarse de documentos visualmente creíbles, la víctima puede reaccionar con rapidez y caer en ataques de phishing. El problema no es solo la calidad técnica de la imagen, sino la capacidad de combinarla con ingeniería social para manipular emociones como la urgencia, el miedo o la confusión.

El texto también cuestiona la eficacia de las salvaguardas implantadas por las empresas tecnológicas. Aunque OpenAI y Google incorporan políticas de uso, marcas de agua o metadatos para identificar imágenes generadas por IA, estas medidas pueden eliminarse fácilmente mediante capturas de pantalla, recortes o nuevas conversiones de archivo. En la práctica, los mecanismos de seguridad van por detrás de la rapidez con la que evolucionan las herramientas de generación visual.

Para concluir, el artículo sostiene que el mayor peligro no reside en los grandes engaños mediáticos, sino en los “microdeepfakes”: falsificaciones dirigidas a personas concretas para vaciar cuentas, obtener datos personales o engañar a familiares. En lugar de alterar elecciones o provocar crisis geopolíticas, estos fraudes erosionan la confianza diaria en mensajes, imágenes y comunicaciones digitales. La conclusión es clara: el desafío ya no es futurista, sino inmediato, y exige respuestas coordinadas entre tecnológicas, bancos, reguladores y ciudadanía.

En una prueba en el mundo real, un modelo de IA tuvo un mejor desempeño que los médicos al diagnosticar pacientes.

Noguchi, Yuki. “In Real-World Test, an AI Model Did Better Than ER Doctors at Diagnosing Patients.” NPR, April 30, 2026. https://www.npr.org/2026/04/30/nx-s1-5804474/ai-doctors-openai-patient-care-diagnosis

Un reportaje de NPR analiza un estudio reciente en el que un modelo avanzado de inteligencia artificial obtuvo mejores resultados que médicos de urgencias en determinadas tareas clínicas, especialmente en diagnóstico inicial y toma de decisiones sobre atención al paciente. La investigación evaluó casos reales en entornos hospitalarios y comparó el rendimiento del sistema con profesionales humanos. Según los resultados, la IA mostró una notable capacidad para identificar patologías y sugerir cursos de actuación con alto nivel de precisión.

El hallazgo más llamativo es que la IA no fue probada en un laboratorio abstracto, sino en un contexto clínico cercano a la práctica cotidiana. Esto supone un cambio importante respecto a estudios anteriores basados en preguntas de examen o escenarios simulados. El modelo fue capaz de analizar síntomas, antecedentes y datos clínicos para ofrecer hipótesis diagnósticas competitivas, lo que sugiere que estas herramientas están entrando en una nueva fase de madurez aplicada.

Sin embargo, el propio reportaje insiste en que estos resultados no significan que los médicos vayan a ser sustituidos. El trabajo clínico real incluye dimensiones que exceden el diagnóstico algorítmico: exploración física, comunicación empática, interpretación contextual, toma de decisiones éticas, coordinación con otros especialistas y responsabilidad legal. La medicina no consiste solo en acertar una respuesta, sino en acompañar a una persona concreta en situaciones complejas e inciertas.

Los investigadores señalan que el papel más prometedor de la IA sería el de asistente clínico. Podría ayudar a detectar errores, priorizar pacientes, sugerir diagnósticos poco frecuentes, resumir historiales médicos o alertar sobre riesgos que un profesional saturado podría pasar por alto. En servicios de urgencias, donde el tiempo y la presión asistencial son extremos, estas capacidades podrían traducirse en decisiones más rápidas y seguras.

Aun así, persisten preocupaciones relevantes. Los modelos pueden generar respuestas incorrectas con aparente seguridad, reproducir sesgos presentes en los datos de entrenamiento o fallar en casos atípicos. También surgen dudas sobre privacidad, responsabilidad jurídica y transparencia: si una IA recomienda una decisión errónea, ¿quién responde? Por ello, muchos expertos sostienen que la supervisión humana seguirá siendo imprescindible.

El artículo de NPR refleja además una tensión creciente en la profesión médica. Algunos facultativos ven estas herramientas como apoyo valioso frente al agotamiento laboral y la escasez de personal; otros temen una dependencia excesiva o una presión institucional para reemplazar criterio profesional por automatización barata. El debate no es meramente tecnológico, sino organizativo y ético.

El estudio apunta a una transformación profunda del sistema sanitario. La pregunta ya no parece ser si la inteligencia artificial participará en la medicina, sino cómo se integrará. Si se usa con prudencia, transparencia y supervisión, puede mejorar diagnósticos y eficiencia. Si se adopta sin controles, puede aumentar errores y deshumanización. El futuro más probable no es “IA contra médicos”, sino médicos potenciados por IA.

Guía de la ALA sobre el Uso de Inteligencia Artificial en Bibliotecas

Association of College and Research Libraries (ACRL). “ALA Draft Guidance of the Use of Artificial Intelligence in Libraries Comments Due May 8.” ACRL Insider, 2026. Accedido el 4 de mayo de 2026. https://www.ala.org/tools/standards-and-guidelines/guidance-use-artificial-intelligence-libraries?utm_source=substack&utm_medium=email

American Library Association (ALA), a través de su AI Policy Working Group, ha difundido para consulta pública un borrador titulado Guidance of the Use of Artificial Intelligence in Libraries, concebido como un documento marco para orientar a los profesionales de las bibliotecas ante el crecimiento acelerado de la inteligencia artificial.

La iniciativa refleja el reconocimiento institucional de que la IA ya no es una cuestión futura o periférica, sino una realidad que está transformando servicios, procesos, expectativas de los usuarios y el propio papel social de las bibliotecas. El plazo de comentarios fijado hasta el 8 de mayo de 2026 indica además la voluntad de incorporar la voz de la comunidad profesional antes de su posible debate y aprobación formal en la Annual Conference de la ALA en Chicago.

El borrador nace con una finalidad eminentemente práctica: ayudar a las bibliotecas a navegar oportunidades y desafíos. La formulación es significativa, porque evita una postura tecnofílica o tecnofóbica. La ALA no presenta la IA únicamente como amenaza ni como solución automática, sino como un fenómeno complejo que exige análisis crítico. Entre las oportunidades pueden situarse la mejora de búsquedas documentales, automatización de tareas repetitivas, apoyo a catalogación, generación de resúmenes, accesibilidad lingüística, atención básica al usuario o análisis de grandes volúmenes de datos. Entre los desafíos aparecen cuestiones como privacidad, sesgos algorítmicos, dependencia de proveedores privados, opacidad técnica, desinformación generada automáticamente y posibles impactos laborales.

Propósito y Contexto

La Asociación Americana de Bibliotecas (ALA) ha elaborado este documento a través de su Grupo de Trabajo de Política en Inteligencia Artificial con un doble objetivo: recomendar a las bibliotecas que desarrollen sus propias políticas locales de IA y ofrecerles un marco de referencia sólido para hacerlo. El documento surge en un momento en que la inteligencia artificial, incluyendo sus variantes generativa y agéntica, está transformando profundamente la manera en que la información se crea, accede y evalúa. La ALA reconoce que la IA puede ampliar la capacidad de las bibliotecas en áreas como la instrucción, las operaciones y la accesibilidad, pero advierte que esto solo es posible cuando la tecnología apoya la experiencia profesional existente, el compromiso comunitario y el juicio crítico del personal bibliotecario. En ese sentido, esta guía no busca reemplazar las políticas existentes de la ALA, sino construir sobre ellas.

Bien Público y Rol Humano

El primer gran pilar de la guía es el concepto de bien público, entendido como el compromiso de las bibliotecas de mejorar la sociedad y proteger derechos fundamentales como la educación, la alfabetización y la libertad intelectual. El documento reconoce que la IA ofrece oportunidades reales para abordar desafíos sociales y ambientales, pero también advierte sobre sus riesgos: puede erosionar la autodeterminación humana, profundizar la desigualdad social y contribuir al cambio climático. Por ello, la guía establece con claridad que la IA debe complementar y nunca reemplazar la inteligencia, el razonamiento y el pensamiento crítico humano. Las tareas que requieren empatía, juicio y conocimiento especializado no deben automatizarse, y todos los usuarios tienen derecho a recibir asistencia humana en cualquier servicio bibliotecario. Además, se subraya que cualquier ganancia de eficiencia generada por la IA debe traducirse en mejoras para el personal y las comunidades, y no en justificación para reducir puestos de trabajo.

Libertad Intelectual y Transparencia

La libertad intelectual es uno de los valores más arraigados en la tradición bibliotecaria, y la guía dedica especial atención a cómo la IA puede amenazarla. Los sistemas automatizados pueden, de manera opaca, sesgar los resultados de búsqueda, priorizar ciertos contenidos sobre otros o suprimir materiales relacionados con comunidades marginalizadas o temas controvertidos, todo ello sin que los usuarios lo perciban. Frente a esto, el documento exige que cualquier sistema automatizado cuente con documentación clara y accesible que explique su funcionamiento, propósito y posible influencia en los resultados. Las salidas de la IA deben tratarse siempre como borradores sujetos a revisión humana, especialmente en temas complejos o sensibles. Asimismo, las bibliotecas deben oponerse activamente a herramientas de IA que señalen materiales para su eliminación o despriorización de formas que socaven la diversidad de puntos de vista, y deben ofrecer a los usuarios la posibilidad de optar por servicios sin intervención algorítmica.

Privacidad y Protección de Datos

La privacidad de los usuarios es un valor central en la ética bibliotecaria, y la guía lo refuerza en el contexto de la IA con directrices muy concretas. Las bibliotecas tienen la responsabilidad de comprender cómo funcionan las herramientas de IA, cómo gestionan la información personal y qué riesgos pueden generar para los usuarios. Se insta a evitar el ingreso de información de identificación personal, temas sensibles o registros no públicos en herramientas cuyas prácticas de datos sean poco claras, y a limitar el uso a herramientas institucionales previamente verificadas. Al trabajar con proveedores externos, las bibliotecas deben preguntar explícitamente si los datos de los usuarios se utilizan para entrenar modelos de IA, qué salvaguardas existen y si las funciones de IA son opcionales. Toda esta información debe comunicarse a los usuarios en lenguaje claro y sencillo, explicando sus derechos de acceso, corrección y eliminación de datos. La formación del personal en privacidad y uso responsable de la IA se considera parte esencial del desarrollo profesional.

Sostenibilidad Ambiental e Institucional

La guía aborda la sostenibilidad desde dos dimensiones que se complementan. Por un lado, la dimensión ambiental: la IA consume grandes cantidades de energía y agua, genera emisiones de gases de efecto invernadero y produce residuos electrónicos. Las bibliotecas deben evaluar el ciclo de vida ambiental completo de los sistemas de IA que adoptan, solicitar a los proveedores información transparente sobre su huella de carbono e intensidad energética, y priorizar herramientas de código abierto, modelos más pequeños y soluciones con menor impacto ecológico. Por otro lado, la sostenibilidad institucional también es crucial: la sobreautomatización puede erosionar las competencias del personal, debilitar la confianza comunitaria y generar dependencia excesiva de sistemas controlados por proveedores comerciales. La guía advierte que las ganancias de eficiencia a corto plazo no justifican comprometer la flexibilidad institucional, el conocimiento profesional acumulado ni la capacidad de las bibliotecas para adaptarse de forma autónoma en el futuro.

Diversidad, Equidad, Inclusión y Acceso

El documento cierra su análisis de valores con un apartado dedicado a la diversidad, la equidad, la inclusión y el acceso, reconociendo que los sistemas de IA con frecuencia reproducen y amplifican las desigualdades existentes. Los conjuntos de datos sobre los que se entrenan estos sistemas suelen subrepresentar lenguas no anglófonas, dialectos y comunidades históricamente marginalizadas, lo que puede traducirse en servicios menos precisos o directamente discriminatorios para estos grupos. Ante esto, la guía exige que las bibliotecas auditen los sistemas de IA antes y durante su uso, colaboren con comunidades multilingües para probar sus resultados y garanticen que los servicios habilitados por IA sean accesibles en términos de idioma, nivel de alfabetización, discapacidad y capacidad tecnológica. También se plantea una reflexión importante sobre los datos de los usuarios como una forma de trabajo no remunerado, y se insta a minimizar las prácticas extractivas de datos en los contratos con proveedores. Finalmente, se enfatiza que los beneficios de la automatización deben distribuirse de manera justa entre trabajadores y comunidades, preservando trayectorias profesionales y oportunidades de desarrollo para los bibliotecarios del futuro.

En conjunto, este documento representa una postura institucional clara y fundamentada: la inteligencia artificial puede ser una herramienta valiosa para las bibliotecas, pero solo si su adopción está guiada por valores humanos, éticos y democráticos. No basta con que una herramienta sea eficiente o innovadora; debe ser justa, transparente, respetuosa de la privacidad, sostenible y verdaderamente al servicio de todas las personas, especialmente de las más vulnerables. La ALA concibe esta guía como un documento vivo, destinado a evolucionar junto con la tecnología y las necesidades de las comunidades a las que las bibliotecas sirven.