Archivo de la categoría: Noticias

Inteligencia artificial generativa: Informe sobre el panorama de las patentes

Patent Landscape Report – Generative Artificial Intelligence (GenAI) WIPO, 2024

Texto completo

La Inteligencia Artificial Generativa (GenAI) está en auge y se perfila como una tecnología de vanguardia que puede transformar diversos sectores económicos, sociales y culturales, y va más allá de la simple generación de texto similar al humano mediante chatbots. Basado en un análisis original de datos de patentes y científicos, el Informe de Paisaje de Patentes de la OMPI sobre GenAI ofrece una visión general de la situación actual de las patentes en este campo.

En el informe se destacan las últimas tendencias de patentes relacionadas con GenAI, proporcionando una comprensión integral y actualizada del panorama de patentes. También se ofrecen perspectivas sobre sus futuras aplicaciones y el impacto potencial que esta tecnología puede tener. El informe explora patentes relacionadas con diferentes modos, modelos y áreas de aplicación industrial de la GenAI, mostrando cómo esta tecnología emergente podría influir en múltiples industrias.

Contenidos:

Conceptos Principales de la GenAI Este capítulo ofrece un resumen de los principios técnicos fundamentales de la GenAI, incluyendo sus orígenes y antecedentes históricos. Las redes neuronales profundas pueden adaptarse para tareas discriminativas o generativas, lo que ha llevado al desarrollo de varios tipos de modelos GenAI, capaces de manejar diferentes tipos de datos de entrada y salida (modos).

Patentes Globales e Investigación en GenAI Los avances en técnicas de aprendizaje profundo y el aumento de la potencia de cómputo han impulsado el desarrollo de la GenAI en los últimos años. El análisis de patentes y publicaciones científicas muestra un auge global de la GenAI, destacando a los principales propietarios de patentes, ubicaciones clave de inventores y regiones donde se busca protección de patentes para GenAI.

Tendencias de Patentes en Modelos de GenAI Los grandes modelos de lenguaje (LLM), las redes generativas adversariales (GAN), los autoencoders variacionales (VAE) y los modelos de difusión son distintos tipos de modelos de GenAI. Este capítulo resume las principales tendencias de patentes en torno a estos diferentes modelos.

Tendencias de Patentes en Modos de GenAI Los modelos de GenAI son efectivos para una variedad de aplicaciones, y pueden manejar diversos tipos de datos de entrada y salida, no limitándose solo a texto e imágenes. Este capítulo explora las tendencias de patentes en diferentes modos de GenAI, incluyendo imágenes, videos, moléculas, genes y proteínas.

Tendencias de Patentes en Aplicaciones de GenAI La GenAI tendrá un impacto significativo en una amplia gama de industrias, al integrarse en productos, servicios y procesos, y convertirse en un habilitador tecnológico para la creación de contenido y la mejora de la productividad. Este capítulo identifica 21 áreas de aplicación en el paisaje de patentes de GenAI y explora las diferentes tendencias en estas áreas.

Consideraciones Adicionales La aparición de la GenAI tendrá un impacto considerable en varias industrias, proporcionando capacidades sin precedentes para crear, sintetizar y manipular datos. No obstante, también existen preocupaciones sobre el uso creciente de modelos y herramientas de GenAI, que abarcan desde la infracción de derechos de autor y el potencial de uso indebido, hasta el riesgo de desplazamiento de empleos.

Apéndices Se proporciona información sobre la metodología utilizada, el enfoque para la búsqueda de patentes de GenAI mediante técnicas tradicionales de búsqueda de patentes junto con nuevas herramientas de búsqueda de IA, y se exploran ejemplos de patentes en diferentes áreas de aplicación de la GenAI.

Algunos investigadores ‘sorprendidos’ de que Taylor & Francis haya vendido el acceso a sus investigaciones a Microsoft AI

Researchers with shocked expressions looking at phone and papers around a table with AI research documents
Four researchers gathered around a table looking shocked while reviewing documents and a phone.

Battersby, Matilda. «Academic Authors “shocked” after Taylor & Francis Sells Access to Their Research to Microsoft AI». The Bookseller. Accedido 23 de julio de 2024. https://www.thebookseller.com/news/academic-authors-shocked-after-taylor–francis-sells-access-to-their-research-to-microsoft-ai.

Autores académicos han expresado su sorpresa al enterarse de que la editorial Taylor & Francis, propietaria de Routledge, vendió acceso a las investigaciones de sus autores como parte de una colaboración con Microsoft en inteligencia artificial (IA), en un acuerdo valorado en casi 8 millones de libras (10 millones de $) en su primer año. La sociedad de autores ha mostrado preocupación por esta situación y destacó la falta de consulta con los autores antes de firmar el acuerdo.

La Dra. Ruth Alison Clemens, una académica publicada por Taylor & Francis y Routledge, dijo que los autores no fueron informados sobre el acuerdo de IA y no tuvieron la oportunidad de optar por no participar. Clemens se enteró del trato por casualidad y expresó su sorpresa por la falta de comunicación al respecto.

Un portavoz de Taylor & Francis confirmó el acuerdo, indicando que proporciona a Microsoft acceso no exclusivo a contenido avanzado y datos para mejorar los sistemas de IA. El acuerdo, detallado por Informa, la empresa matriz de Taylor & Francis, en una actualización comercial en mayo, estipula un pago inicial de $10 millones por acceso a los datos, con pagos recurrentes no especificados en los tres años siguientes.

Taylor & Francis afirmó que protege la integridad del trabajo de los autores y los derechos de recibir pagos de regalías conforme a los contratos de autor. Sin embargo, no quedó claro si existe una política de exclusión para los autores en este acuerdo.

La comunidad académica ha mostrado una fuerte preocupación, destacando la necesidad de considerar cuestiones de derechos de autor, derechos morales y protección de datos. The Society of Authors (SoA) instó a los autores que descubran que su trabajo ha sido utilizado sin su consentimiento a contactarlos para recibir orientación.

Barbara Hayes, directora ejecutiva de ALCS, enfatizó la importancia de representar plenamente los intereses y derechos de los autores en estas negociaciones, una etapa que a menudo falta en los acuerdos actuales.

A principios de esta semana, el Copyright Clearance Centre anunció la disponibilidad de los derechos de reutilización de la IA dentro de su  Annual Copyright License (ACL), que, según afirma, es «la primera solución colectiva de concesión de licencias para el uso interno de materiales protegidos por derechos de autor en sistemas de IA». La licencia proporcionará a los titulares derechos y remuneración por los nuevos usos de sus contenidos.

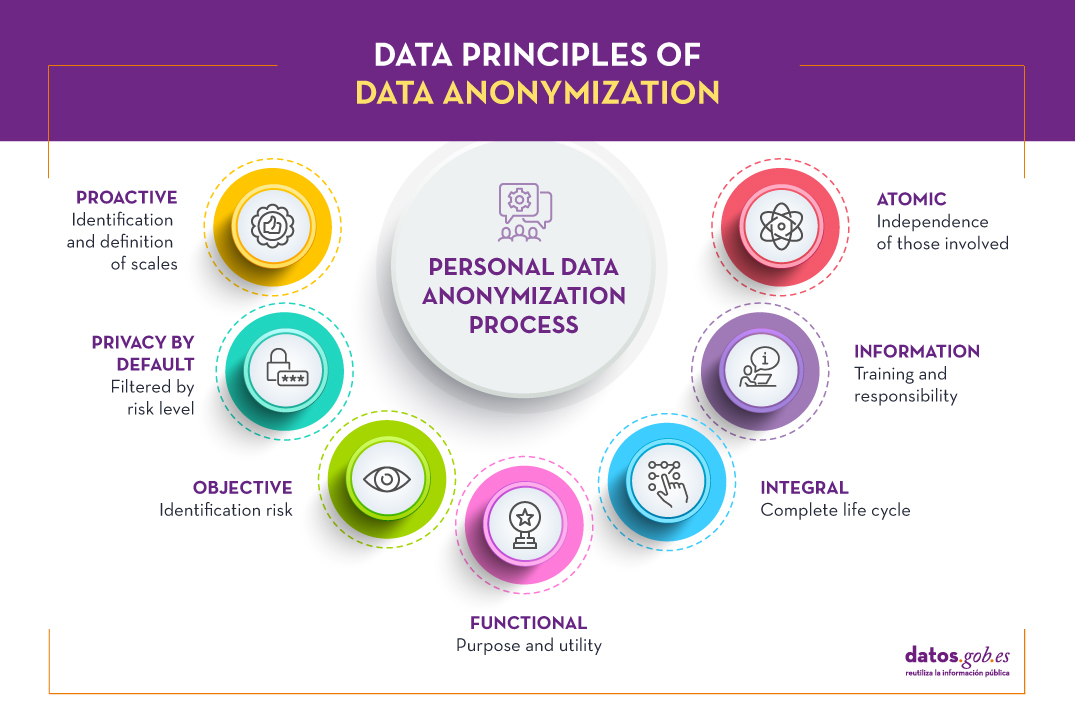
Anonimización: La ciencia imperfecta de utilizar los datos preservando la privacidad

Gadotti, Andrea, Luc Rocher, Florimond Houssiau, Ana-Maria Creţu, y Yves-Alexandre de Montjoye. «Anonymization: The imperfect science of using data while preserving privacy». Science Advances 10, n.o 29 (17 de julio de 2024): eadn7053. https://doi.org/10.1126/sciadv.adn7053.

La información sobre nosotros, nuestras acciones y nuestras preferencias se crea a escala a través de encuestas o estudios científicos o como resultado de nuestra interacción con dispositivos digitales como teléfonos inteligentes y rastreadores de fitness. La capacidad de compartir y analizar estos datos de forma segura es clave para el progreso científico y social. La anonimización es considerada por científicos y responsables políticos como una de las principales formas de compartir datos minimizando los riesgos para la privacidad. En esta revisión, ofrecemos una perspectiva pragmática de la literatura moderna sobre ataques a la privacidad y técnicas de anonimización. Analizamos las técnicas tradicionales de desidentificación y sus grandes limitaciones en la era de los macrodatos. A continuación, centramos nuestra atención en los enfoques modernos para compartir datos agregados anónimos, como los sistemas de consulta de datos, los datos sintéticos y la privacidad diferencial. Llegamos a la conclusión de que, aunque no existe una solución perfecta, la aplicación de técnicas modernas al tiempo que se auditan sus garantías contra los ataques es el mejor enfoque para utilizar y compartir datos de forma segura hoy en día.

Características deseables de los identificadores persistentes (PIDs)

Chodacki, John, y Todd Carpenter. «Desirable Characteristics of Persistent Identifiers». Upstream, 19 de marzo de 2024. https://doi.org/10.54900/c3hdq-0ev76.

Los identificadores persistentes (PIDs) en las comunicaciones académicas y la infraestructura de investigación han atraído una creciente atención en los últimos años, especialmente de los gobiernos que reconocen su papel vital en la creación de un ecosistema de investigación más eficiente y confiable. Este resumen destaca las características clave deseables de las infraestructuras PID basadas en principios orientadores e iniciativas globales.

Antecedentes

Varios países, incluidos Australia, Canadá, Finlandia, Corea y el Reino Unido, están desarrollando estrategias nacionales de PID para apoyar la beca abierta y la innovación. En los EE. UU., se crearon recomendaciones para una Estrategia Nacional de PID por la Research Data Alliance (RDA) en colaboración con la Higher Education Leadership Initiative for Open Scholarship (HELIOS) y el Open Research Funders Group (ORFG). Estas recomendaciones guían a los interesados nacionales en la investigación sobre el uso y adopción de PIDs.

Principios generales y orientadores

La adopción y el éxito de cualquier PID dependen de la confianza en la infraestructura subyacente, los datos y los servicios asociados. Esta confianza se desarrolla mejor alineándose con marcos existentes para infraestructura abierta y principios orientadores correspondientes, como FAIR y POSI.

Principios FAIR

Los principios FAIR (Findable, Accessible, Interoperable y Reusable) proporcionan un marco fundamental para comprender la función de los PIDs como habilitadores de la investigación abierta.

  • Findability: Los PIDs hacen que los objetos digitales sean localizables a través de referencias únicas y persistentes, junto con metadatos ricos, mejorando la capacidad de descubrimiento.
  • Accessibility: Los PIDs aseguran que los objetos digitales sean identificables, con metadatos accesibles incluso si el objeto en sí está restringido.
  • Interoperability: Los PIDs utilizan sistemas y esquemas estandarizados, facilitando la integración e interacción sin problemas entre diferentes sistemas de datos.
  • Reusability: Los PIDs proporcionan enlaces persistentes al contexto y la procedencia, respaldados por metadatos claros que detallan las condiciones de reutilización.

Principios POSI

Los Principios de Infraestructura Académica Abierta (POSI) ofrecen directrices para una infraestructura abierta, sostenible y impulsada por la comunidad.

  • Cobertura: Los PIDs deben ser inclusivos en todas las disciplinas, geografías e instituciones.
  • Gobernanza de los Interesados: Los PIDs deben ser gobernados por consenso comunitario para asegurar una toma de decisiones equilibrada.
  • Transparencia: La gobernanza abierta construye y mantiene la confianza de la comunidad.
  • Cumplimiento de la Misión: Las revisiones regulares aseguran que los PIDs cumplan con las necesidades de la comunidad.

Otras consideraciones de POSI incluyen la infraestructura de código abierto y datos accesibles, asegurando un uso equitativo en varios sectores.

Orientación de UNESCO y HELIOS

El Toolkit de Ciencia Abierta de la UNESCO y el Grupo de Trabajo de Infraestructura Compartida de HELIOS enfatizan la transparencia, colaboración y capacidades técnicas. Estos incluyen:

  • Transparencia: Estructuras claras de costos y beneficios.
  • Interoperabilidad: Estándares para mejorar la reutilización de datos.
  • Cocreación: Desarrollo cooperativo con la participación de la comunidad.
  • Cumplimiento del Acceso Público: Asegurar que la infraestructura cumpla con los requisitos de las agencias financiadoras.

Memorándum Presidencial de Seguridad Nacional 33 (NSPM-33)

Las directrices federales de EE. UU. sobre PIDs indican que deben ser proporcionados por plataformas abiertas, no propietarias y dirigidas por investigadores, interoperables con estándares internacionales.

Características deseables de la infraestructura PID

Combinando los principios de FAIR, POSI, UNESCO y HELIOS, se recomiendan las siguientes características para las infraestructuras PID:

  • Disponibilidad de Metadatos Abiertos: Los metadatos básicos deben estar disponibles gratuitamente y con licencia abierta para la integración y reutilización.
  • Servicios de Resolución Estandarizados: Servicios confiables como doi.org aseguran conexiones estables con los objetos referenciados.
  • Políticas de Identificación Documentadas: Políticas claras sobre la gestión de identificadores, versionado y persistencia mejoran la transparencia.
  • Monitoreo y Reporte: El monitoreo activo asegura PIDs funcionales, con mecanismos para abordar URIs no funcionales.
  • Asignación y Curación Amigable para el Usuario: Procesos simplificados para la asignación de PIDs y la gestión de metadatos facilitan la adopción.
  • Estandarización y Participación Comunitaria: Estructuras consistentes y procesos impulsados por la comunidad aseguran robustez e inclusividad.
  • Extensibilidad: Los sistemas PID deben adaptarse a nuevos casos de uso y demandas.
  • Gobernanza Comunitaria: La infraestructura debe ser responsable ante la comunidad de usuarios, con una amplia participación en la gobernanza.

Conclusión

Los PIDs son cruciales para avanzar en la beca abierta, asegurando que los resultados de la investigación sean descubribles, atribuibles e impactantes. Alineándose con marcos como FAIR y POSI, e incorporando conocimientos globales, podemos crear infraestructuras PID inclusivas y equitativas. La colaboración entre académicos, financiadores y responsables de políticas es esencial para promover la adopción generalizada de PIDs, mejorando la transparencia y coherencia del ecosistema de investigación.

Evaluación de la cobertura de citas en 59 bases de datos: más allá de Google Scholar, Scopus y Web of Science

Gusenbauer, Michael. «Beyond Google Scholar, Scopus, and Web of Science: An Evaluation of the Backward and Forward Citation Coverage of 59 Databases’ Citation Indices». Research Synthesis Methods n/a, n.o n/a. Accedido 11 de julio de 2024. https://doi.org/10.1002/jrsm.1729.

El estudio «Beyond Google Scholar, Scopus, and Web of Science: An evaluation of the backward and forward citation coverage of 59 databases’ citation indices» de Michael Gusenbauer, publicado el 14 de junio de 2024, evalúa la cobertura de citas de los índices de 59 bases de datos, incluyendo Google Scholar, Scopus y Web of Science, además de otras menos analizadas como Lens, Scite, Dimensions, OpenAlex, PubMed y JSTOR.

El análisis abarca 259 artículos de revistas de diversas disciplinas, con el objetivo de guiar a los académicos en la selección de índices con una cobertura documental más amplia y enlaces de citas hacia atrás (BWC) y hacia adelante (FWC) más precisos y completos.

Hallazgos clave:

  • FWC (Forward Citation Coverage): Google Scholar, ResearchGate, Semantic Scholar y Lens destacan como las mejores opciones, con Lens sobresaliendo en capacidades de descarga.
  • BWC (Backward Citation Coverage): Web of Science Core Collection se recomienda sobre Scopus por su precisión. Las bases de datos de editores como IEEE Xplore o ScienceDirect son las más precisas en BWC, aunque solo para un número limitado de artículos.

Los resultados muestran que los 259 artículos utilizados para calcular las puntuaciones de BWC (citas hacia atrás) y FWC (citas hacia adelante) fueron accesibles de manera desigual en las bases de datos. En general, las bases de datos más grandes también cubrían más artículos, una relación visible en una correlación de Pearson de r = 0.84. Google Scholar y OpenAlex fueron las únicas bases de datos que cubrieron todos los artículos, mientras que PLOS y Econstor tuvieron la menor cobertura, identificando solo nueve artículos.

La mitad de las bases de datos proporcionaron información de FWC para todos o casi todos (96%) los artículos que cubrían, de los cuales dos tercios lo hicieron para todos los artículos. La otra mitad proporcionó solo información fragmentada, siendo Ingenta Connect la que menos información ofreció, con solo un artículo (6%) que tenía información de FWC. Se encontró una correlación notable entre el tamaño de la base de datos y la cobertura de FWC (r = 0.63), lo que significa que las bases de datos más grandes tienen índices de FWC más completos. Existen múltiples razones por las cuales esta correlación es menor que la cobertura de artículos (r = 0.84): primero, problemas en la provisión y enlace de datos significan que algunos artículos cubiertos no aparecen en las BWCs o FWCs. Por ejemplo, ScienceOpen, SciTech Premium Collection (a través de ProQuest) y Academic Search Premier (a través de EBSCOhost) tienen bases de datos comparativamente grandes, pero la información de citas que proporcionan es débil. Otra razón es que ciertos proveedores limitan artificialmente la cobertura; por ejemplo, Ebsco ofrece diferente cobertura de citas en sus productos. Además, las bases de datos más pequeñas tienen una amplia cobertura de FWC o BWC debido al uso de proveedores de datos externos que extienden sus índices de citas mucho más allá de la cobertura de artículos de sus propias bases de datos (por ejemplo, IEEEXplore, PLOS, ScienceDirect, Sage). Todos estos hallazgos significan que el tamaño de la base de datos por sí solo no es un indicador perfecto de la cobertura de citas.

El número de BWCs en todos los campos científicos en 2018 fue una mediana de 54.5 y una media de 93.9. Ninguna base de datos proporcionó información de BWC para todos los artículos; las más cercanas a la cobertura total fueron Scopus, OpenAlex, Lens y ScienceOpen. Entre los artículos que fueron cubiertos, alrededor del 36% de todas las bases de datos proporcionaron información completa de BWC, mientras que otro 17% lo hizo para más del 90% de los artículos. Las bases de datos restantes proporcionaron información más fragmentada, siendo Academic Search Premier (a través de EBSCOhost) la que menos proporcionó, con solo el 7% de sus artículos con información de BWC. El análisis muestra que tanto las grandes bases de datos multidisciplinarias como las bases de datos de editoriales más pequeñas pueden proporcionar información de BWC completa y precisa. En esta línea, se encontró que el tamaño de la base de datos estaba débilmente correlacionado con la precisión de la información de BWC (r = 0.16). Una razón probable puede ser que las bases de datos de editoriales más pequeñas, en particular, tenían información de BWC comparativamente buena. En comparación, las bases de datos más grandes no siempre eran precisas, a menudo sobreestimando el número de BWCs que tenía un artículo.

Estos hallazgos ayudarán a los académicos en la realización de revisiones sistemáticas, meta-análisis y análisis bibliométricos a seleccionar las bases de datos más adecuadas para la búsqueda de citas.

Google lanza las métricas de Google Scholar 2024

Las métricas de Scholar ofrecen una forma sencilla para que los autores evalúen rápidamente la visibilidad e influencia de artículos recientes en publicaciones académicas. Hoy lanzamos la 2024 version of Scholar Metrics. Esta versión abarca artículos publicados entre 2019 y 2023 e incluye citas de todos los artículos indexados en Google Scholar hasta julio de 2024.

Puedes explorar publicaciones en categorías como Ingeniería Oceánica y Marina, Artes Dramáticas y de Teatro, o Bosques y Silvicultura. Verás las 20 principales publicaciones ordenadas por sus métricas de h-index y h-median de cinco años. También puedes explorar las 100 principales publicaciones en varios idiomas, por ejemplo, portugués y español. Para cada publicación, puedes ver los artículos principales haciendo clic en el h5-index.

Las métricas de Scholar incluyen una gran cantidad de publicaciones más allá de las listadas en las páginas por categoría y por idioma. Puedes encontrarlas escribiendo palabras del título en el cuadro de búsqueda, por ejemplo, [sostenibilidad], [logística], [salud pública].

Conjunto de herramientas de narración historias personales para bibliotecarios

Project Helps Librarians Use Data Storytelling to Advocate For Public Libraries, University of Illinois Urbana-Champaign News Bureau, 2024

Texto completo

El «Data Storytelling for Librarians Toolkit», desarrollado por profesores de ciencias de la información de la Universidad de Illinois Urbana-Champaign, ayuda a los bibliotecarios a usar datos para comunicar el valor de sus servicios y justificar sus necesidades de financiamiento. Liderado por la profesora Kate McDowell, junto con Matthew Turk y Jill Naiman, el proyecto se centra en presentar datos en forma de narrativa.

El toolkit se creó después de varios años de entrevistas, encuestas y grupos focales con personal de bibliotecas en todo el país. Aunque se esperaban problemas relacionados con presupuestos y personal, los bibliotecarios expresaron una mayor necesidad de defender mejor sus bibliotecas. Los tipos de historias que querían contar incluían compartir logros, comparar el progreso de la biblioteca con el tiempo o con otras similares, y justificar inversiones.

El toolkit permite a las bibliotecas utilizar la gran cantidad de datos que recopilan sobre sus funciones, como el número de titulares de tarjetas, libros prestados, visitas a la biblioteca y asistencia a programas. También incluye datos demográficos de las comunidades a las que sirven, como el número de niños en edad escolar y personas mayores, y los idiomas hablados por los residentes.

El toolkit incluye una herramienta de visualización de datos desarrollada por Turk y Naiman, con un tutorial para nuevos usuarios y un tablero configurable para usuarios más experimentados. Esta herramienta permite a los bibliotecarios probarla con sus propios datos.

Durante el último año, McDowell ha hablado sobre la narrativa de datos y el toolkit en grupos de bibliotecas locales, nacionales e internacionales, y ha presentado una serie de seminarios web sobre el proyecto. El último seminario web gratuito será el 17 de julio, y este otoño publicará un libro que ampliará la información presentada en el toolkit.

Hacia una edición responsable: conclusiones de una consulta mundial a las partes interesadas

Chiarelli, A., Cox, E., Johnson, R., Waltman, L., Kaltenbrunner, W., Brasil, A., Reyes Elizondo, A., & Pinfield, S. (2024). «Towards Responsible Publishing»: Findings from a global stakeholder consultation. Zenodo. https://doi.org/10.5281/zenodo.11243942

Este informe detalla los resultados de una consulta global con la comunidad investigadora sobre la propuesta de “Towards Responsible Publishing” (TRP) («Hacia una Publicación Responsable»). La consulta, realizada por Research Consulting y el Centro de Estudios de Ciencia y Tecnología de la Universidad de Leiden (CWTS), involucró a más de 11,600 participantes de todo el mundo entre noviembre de 2023 y mayo de 2024. Los resultados muestran un amplio apoyo a los principios del TRP, como la publicación de preprints, la revisión por pares abierta y las licencias abiertas. Además, se destaca la necesidad de colaboración global para cambiar los mecanismos de reconocimiento y recompensa en la investigación y redirigir el gasto hacia prácticas más responsables.

Las fabricas de artículos contamina la ciencia: ¿qué pueden hacer los bibliotecarios al respecto?»

Brundy, C., & Thornton, J. B. (2024). The paper mill crisis is a five-alarm fire for science: What can librarians do about it? Insights, 37(1). https://doi.org/10.1629/uksg.659


La crisis de las fábricas de artículos, que está contaminando la literatura académica con artículos falsos, ha llevado a un número récord de retracciones de artículos y continúa erosionando la confianza en la ciencia. Aunque los editores y otros interesados en la publicación académica se han movilizado para abordar esta grave amenaza a la integridad de la investigación y la publicación, la acción de la comunidad bibliotecaria ha sido insuficiente. Este artículo explora el impacto continuo de la crisis de las fábricas de artículos y sus causas. También revisa las medidas que se están tomando en todo el sector para abordarla. Esto incluye acciones emprendidas por editores, investigadores de integridad y organizaciones como Retraction Watch, NISO y STM. Basándose en la gravedad de la crisis y la respuesta actual, este artículo recomienda acciones que las bibliotecas pueden tomar para ayudar a abordar la crisis y limpiar el desorden que las fábricas de artículos han creado en la literatura académica. En un momento de creciente desconfianza y amenazas crecientes para la sociedad, es crucial que todos los interesados en la publicación académica, incluidos los bibliotecarios, ayuden a mantener la integridad de la publicación y restaurar la confianza en la ciencia.

Presentación del libro: «Las bibliotecas en el imaginario colectivo»

Presentación del libro de Julio Alonso Arévalo y Marlene Beatriz Quinde Cordero. Coordinación: Adrián Mendez

LAS BIBLIOTECAS EN EL IMAGINARIO COLECTIVO

por Julio Alonso Arévalo Marlene Beatriz Quinde Cordero

Buenos Aires: Alfagrama, 2024

ISBN 978-987-4458-23-0

A lo largo de la historia, las bibliotecas han sido consideradas como templos del conocimiento, refugios para la imaginación y centros de cultura. Este imaginario se ha construido a partir de diversas influencias, incluyendo la literatura, el cine, la educación y las experiencias personales. El libro realiza un exhaustivo análisis de estas percepciones, las cuales han moldeado el concepto actual de biblioteca con sus acepciones, generalmente positivas, y otras no tanto. En general, estos lugares son vistos como espacios democráticos, accesibles para todos, donde se promueve la igualdad de oportunidades y el acceso al conocimiento. En conclusión, el imaginario social de las bibliotecas refleja la importancia cultural, educativa y comunitaria que estas instituciones han tenido a lo largo de la historia. Aunque estas percepciones pueden variar según el contexto cultural y las experiencias individuales, en su núcleo siempre está presente la idea de que las bibliotecas son guardianes del conocimiento y lugares de encuentro entre personas y conocimientos, que contribuyen a la comprensión, la convivencia y al empoderamiento individual y colectivo de las comunidades.

INDICE

  1. Imagen profesional y bibliotecas
  2. Bibliotecas imaginadas
  3. Bibliotecas de este mundo
  4. Un espacio sagrado
  5. La mujer y la biblioteca
  6. Un espacio seguro y acogedor
  7. Bibliotecas personales
  8. Espacios para la democracia y el empoderamiento ciudadano
  9. Ordenar y catalogar bibliotecas
  10. Llevar los libros al mundo
  11. El nuevo rol de las bibliotecas en el siglo XXI

JULIO ALONSO ARÉVALO

Julio Alonso Arévalo es bibliotecario de la Universidad de Salamanca, responsable de la Biblioteca de Traducción y Documentación, que ha contribuido significativamente al campo de las bibliotecas y la información a través de sus proyectos y publicaciones. Es editor del repositorio E-LIS, coordinador de la lista InfoDoc, creador del blog «Universo abierto», autor de más de un centenar artículos en revistas especializadas y ha publicado una docena de libros sobre temas como acceso abierto, libros electrónicos y gestores de referencias. Además, dirige y presenta el programa de radio «Planeta Biblioteca» y ha recibido premios por su labor en proyectos digitales y redes sociales.

MARLENE QUINDE CORDERO

Marlene Quinde Cordero es licenciada en Lengua y Literatura Española, así como en Bellas Artes, y posee un Máster en Artes Visuales. Actualmente desempeña funciones como investigadora predoctoral en la Universidad de Salamanca. Además, ha ejercido como docente y bibliotecaria en la Universidad de Cuenca (Ecuador), donde ha destacado por su labor en proyectos como Makerspaces en bibliotecas y por el desarrollo de su programa de recogida de historias personales (Storytelling). Asimismo, ha contribuido con la publicación de diversos artículos y un libro “Guía del Software Libre en Bibliotecas”. Esta es su segunda obra.